

 16
 分享
引言Introduction
GSEA是论文验证里最常见的富集分析方法之一,但很多人卡在数据格式、排序文件和结果解读。只要一步错,结果就可能和原文不一致。 对医学生、医生和科研人员来说,真正难的是把分析做对、做快、做得能复现。

1. 为什么GSEA适合论文验证
1.1 GSEA解决的不是“有无差异”,而是“通路是否整体偏移”
传统差异分析更关注单基因。GSEA关注的是一组基因是否在排序列表的前端或后端成簇出现 。这对论文验证特别重要,因为很多通路变化并不依赖单个强信号基因,而是多个中等变化基因共同驱动。
GSEA的核心是排序后的基因列表。常见做法是使用log2FoldChange、t值或其他统计量作为rank。当功能基因集中的基因在排序前端富集时,ES为正,提示通路上调倾向。 反之则提示下调倾向。
1.2 论文验证中最常见的痛点
论文验证场景里,问题往往不在算法本身,而在操作细节。
常见难点包括:
- 基因ID转换不一致,导致映射丢失。
- 排序文件方向搞反,影响ES方向。
- GMT注释版本不同,结果无法和原文完全对齐。
- 结果图能跑出来,但解释不清NES、P值和FDR。
如果目标是复现论文图,规范的数据预处理比“多跑几次”更重要。 这是WorkBuddy平台GSEA富集分析的价值所在。
2. WorkBuddy平台做GSEA的核心流程
2.1 输入数据要先标准化
根据课程中的实操逻辑,GSEA通常需要两类关键输入。
第一类是差异分析结果。常见字段包括:
- 基因ID,尤其要明确是ENSEMBL还是ENTREZID。
- 排序指标,如log2FoldChange。
- 显著性信息,便于后续筛选和解释。
第二类是基因集注释文件。常见为.gmt格式。GSEA分析对注释文件版本非常敏感,同一通路在不同数据库版本中,基因成员数量可能不同。 这也是论文验证时必须记录数据库来源的原因。
2.2 从排序到富集,关键步骤不能省
课程里的GSEA流程体现了标准化分析逻辑。
典型步骤包括:
- 将ENSEMBL等ID转换为ENTREZID。
- 生成按log2FoldChange排序的基因列表。
- 读取.gmt文件。
- 运行GSEA并导出结果表。
在R环境中,常用的是clusterProfiler的GSEA函数。结果中重点看:
- NES,标准化富集分数。
- P.adjust,多重检验后的显著性。
- qvalue,控制假发现率的参考指标。
NES比ES更适合横向比较不同基因集,因为它对基因集大小进行了标准化。
2.3 WorkBuddy更适合论文验证的原因
论文验证不是单纯跑通结果,而是要追求稳定、清晰、可复用。WorkBuddy平台的优势在于把常见流程封装为更直观的分析路径,减少环境配置和重复操作带来的误差。
对于需要快速比对文献图、补充机制分析、整理文章结果的场景,平台化流程能帮助用户把时间更多放在生物学解释上,而不是反复处理代码和文件格式。
3. 如何正确解读GSEA结果
3.1 先看NES,再看FDR
GSEA结果里最常见的误区,是只盯着P值。实际上,在论文验证中,NES和FDR往往比单一P值更关键。
一般解读顺序建议如下:
- 先看NES方向,判断通路上调还是下调。
- 再看P.adjust或qvalue,判断统计学稳健性。
- 最后结合leading edge和通路生物学背景,判断是否符合机制。
课程中也提到,GSEA报告里FDR小于25%的基因集,通常可作为进一步研究的候选通路。对于更严格的文章分析,很多研究会优先选择FDR更低的条目。
3.2 富集曲线图怎么看
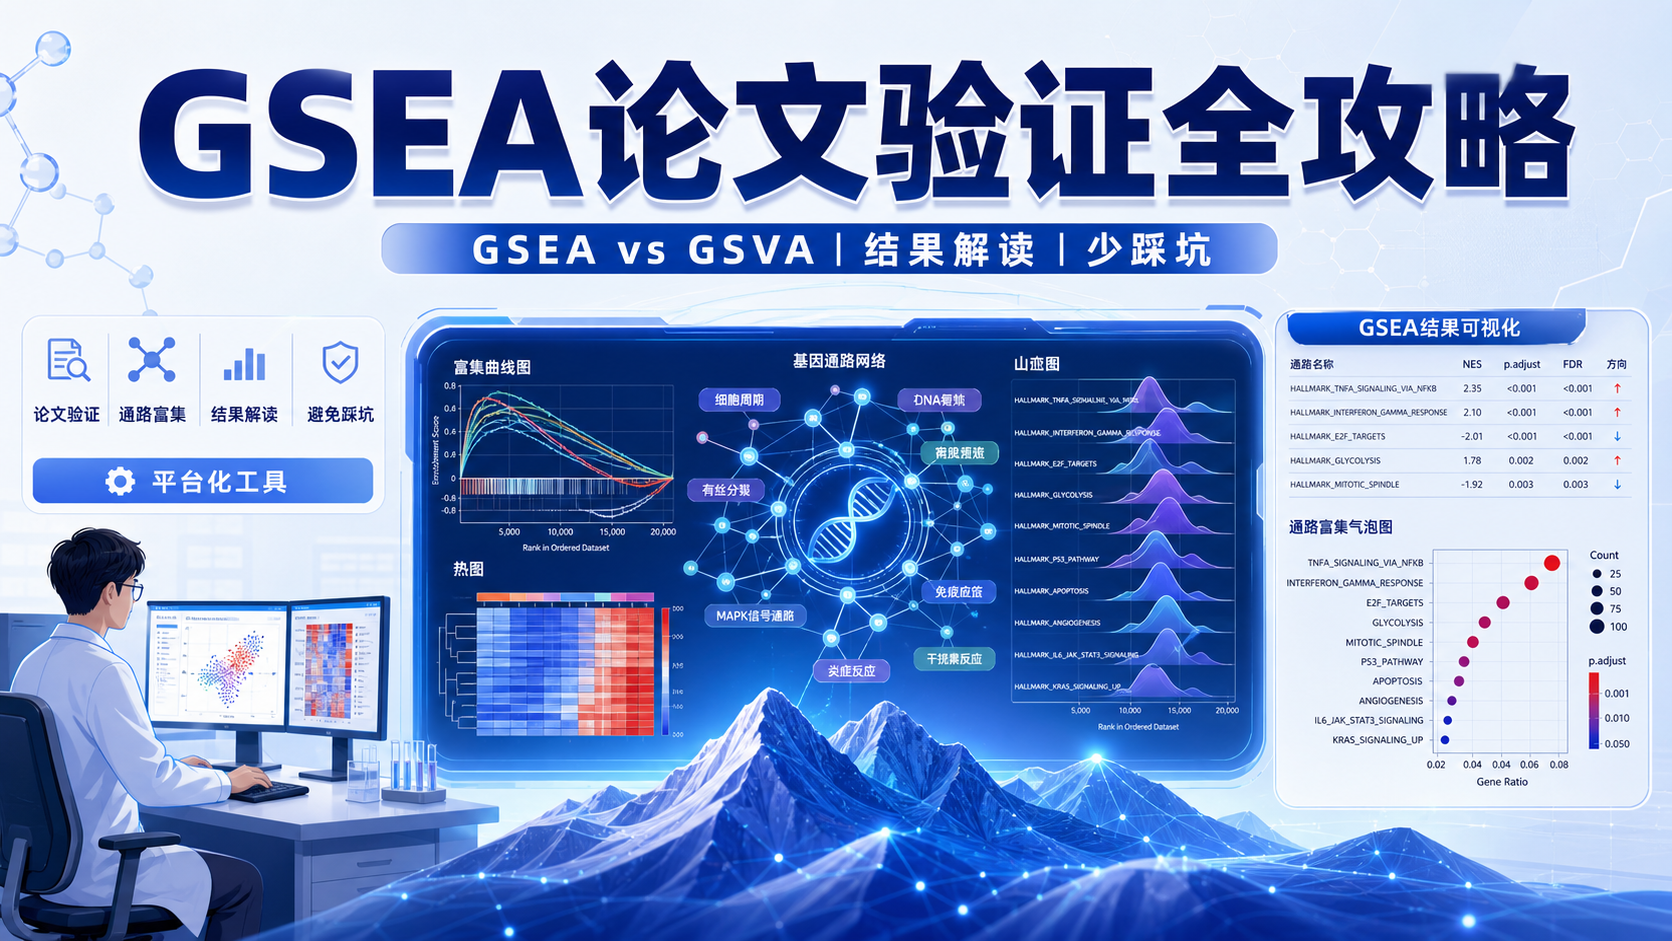
富集曲线图是论文最常用的展示形式之一。它通常包含三部分:
- 上方是所有基因的排序分布。
- 中间是运行富集分数的变化曲线。
- 下方是命中基因在排序中的位置。
曲线峰值对应ES最大偏离点。 峰值前的基因通常构成leading edge,也就是对富集贡献最大的核心基因集合。对机制论文来说,这部分信息非常有价值,因为它能帮助你从“通路显著”进一步追到“哪些基因驱动了通路”。
3.3 山峦图和热图帮助提升可读性
除了经典富集曲线,山峦图和热图也很适合展示多个通路的整体趋势。
山峦图的优势是能同时展示多个基因集的分布差异,适合比较top通路。热图则更适合展示GSVA或差异通路评分在样本间的变化。对于病例对照、分组比较或临床分层研究,热图往往比单张曲线图更直观。
4. GSVA与GSEA的区别,什么时候更适合用
4.1 GSEA更适合“排序后验证”,GSVA更适合“样本级比较”
GSEA依赖全局排序,更适合回答“某个通路是否整体富集”。GSVA则会把通路活性转换成每个样本的分数,更适合做组间差异分析和可视化。
课程中的GSVA流程包括:
- 过滤表达矩阵。
- 进行log2转换。
- 读取基因集。
- 计算每个样本的通路得分。
- 进一步用limma做差异分析。
如果你的目标是论文验证中的机制补充,GSEA偏向通路发现,GSVA偏向样本层面的验证。 两者配合使用,往往能让结果更完整。
4.2 GSVA适合哪些研究场景
GSVA特别适合以下场景:
- 肿瘤高低表达分组比较。
- 生存分组后的通路活性差异分析。
- 单中心队列与外部验证队列的通路一致性检查。
- 临床分层后的机制展示。
在这些场景里,GSVA生成的热图、箱线图和分组比较图,往往比单纯差异基因列表更适合写入结果部分。
5. 论文验证中如何减少踩坑
5.1 先统一ID和数据库版本
这是最容易被忽视的一步。不同数据库版本、不同注释源、不同ID体系,都会影响最终结果。
建议在分析前明确记录:
- 基因ID类型。
- 转换工具和数据库。
- GMT文件版本。
- 富集分析参数,如pvalueCutoff、pAdjustMethod、seed。
论文复现最怕“流程相同,但输入不一致”。 这也是为什么标准化平台更有价值。
5.2 结果不一致时,不要只怀疑算法
如果你和原文结果不一致,通常要先检查以下几点:
- 排序文件方向是否一致。
- 是否用了同一版本的gmt文件。
- 表达矩阵是否经过相同过滤。
- 分组标签是否和原文完全一致。
- 统计阈值是否一致。
很多“复现失败”并不是算法错误,而是输入文件细节差异造成的。把这些步骤前置检查,往往比后期解释更省时间。
5.3 用平台化工具提高验证效率
对于需要快速完成论文验证、课程作业、课题组汇报或投稿补图的用户,WorkBuddy平台可以把复杂流程变成更稳定的操作路径。你不必每次从零配置环境,也不必反复排查包冲突和版本差异。
当GSEA分析被标准化后,科研人员能更快得到可解释、可展示、可复现的结果。 这正是解螺旋希望通过WorkBuddy帮助用户解决的核心问题。
总结Conclusion
GSEA是论文验证中非常实用的富集分析方法。它不仅能回答通路是否整体改变,还能帮助你定位核心驱动基因和机制方向。对于医学生、医生和科研人员来说,真正重要的不是“跑出图”,而是拿到能复现、能解释、能写进论文的结果。
如果你正在做论文验证、机制补充或富集分析结果整理,可以借助 WorkBuddy 提升流程稳定性。想把GSEA分析做得更快、更规范、更接近论文发表标准,欢迎使用 ** 解螺旋** 的相关工具与服务。
- 引言Introduction
- 1. 为什么GSEA适合论文验证
- 2. WorkBuddy平台做GSEA的核心流程
- 3. 如何正确解读GSEA结果
- 4. GSVA与GSEA的区别,什么时候更适合用
- 5. 论文验证中如何减少踩坑
- 总结Conclusion