

 21
 分享
引言Introduction
时序差异表达分析常被认为门槛高。真正难的不是跑图,而是选对数据、理清分组、判断分析流程是否适合研究问题 。对医学生、医生和科研人员来说,若没有稳定的知识库和清晰的技能调用机制,很容易在文献梳理、结果解释和写作上反复返工。
1.WorkBuddy为何适合时序差异表达分析
1.1 从“能不能做”到“装了什么技能就做什么”
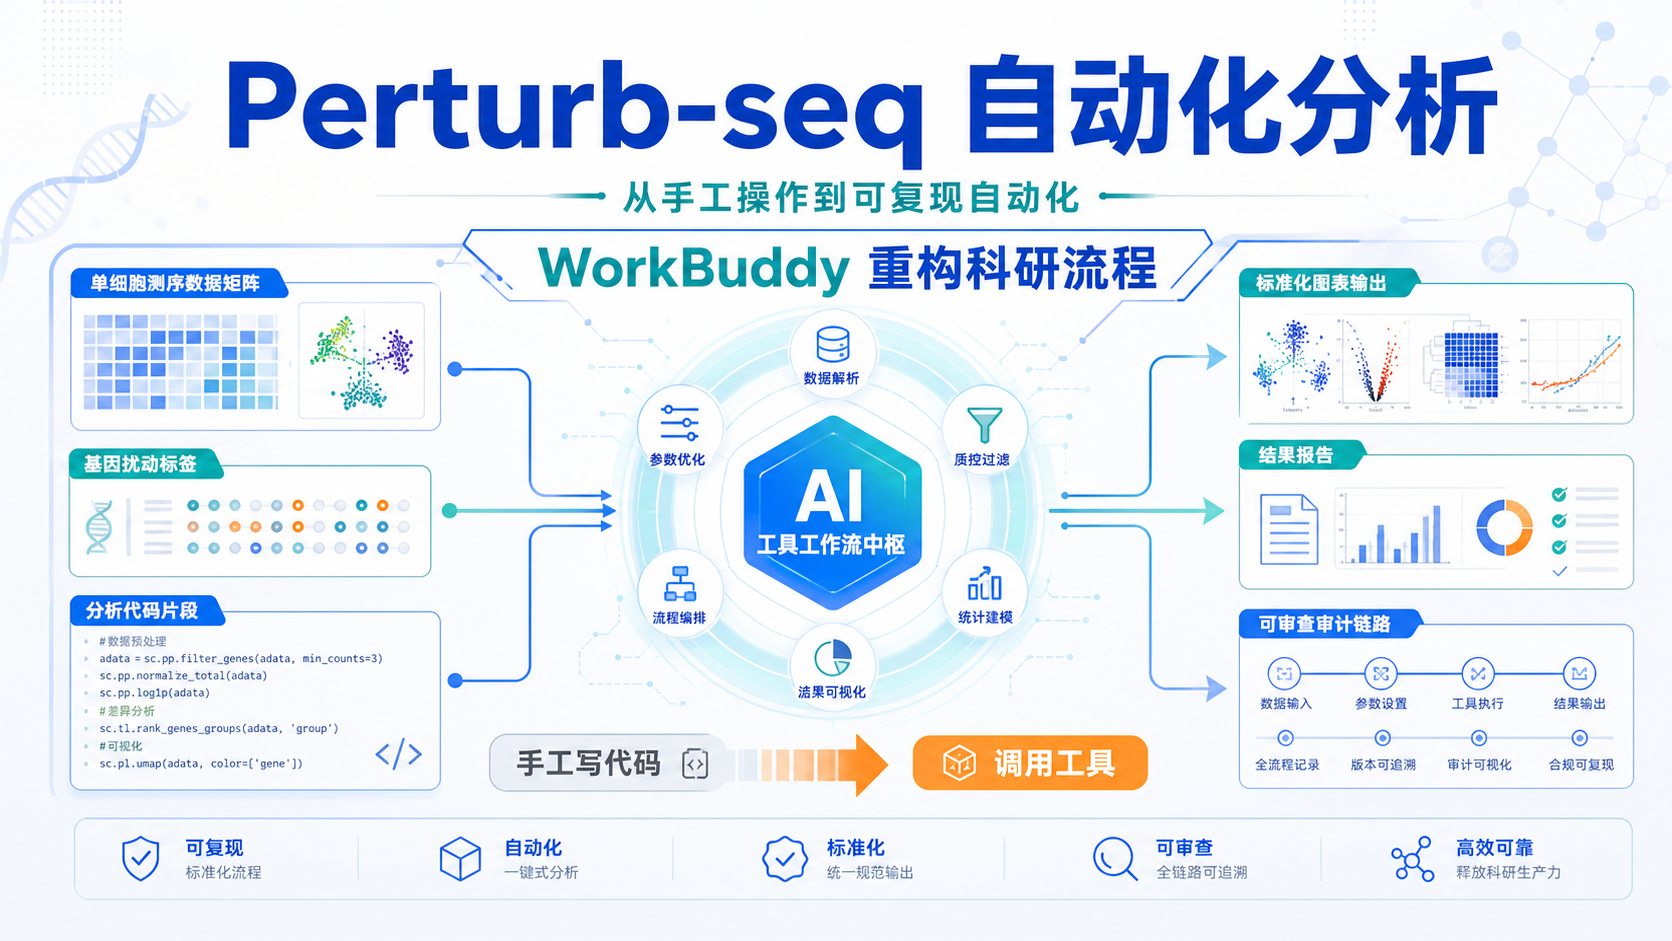
WorkBuddy的核心逻辑很清楚。不是默认什么都能做,而是装了对应技能,才调用对应能力。 这对时序差异表达分析尤其重要,因为这类任务通常涉及数据整理、分组设计、差异分析、可视化和结果解释,不能只靠单一工具完成。
上游知识库提到,WorkBuddy目前更偏向“按技能执行”的体系。也就是说,当你已经装好相关skill后,它就能按流程调用;如果没有对应技能,就不能假设它自动完成公共数据库下载或复杂分析。这一点必须先讲明白。理解能力边界,才能避免错误预期。
1.2 时序差异表达分析真正考验什么
时序分析不是简单比较A组和B组。它看的是多个时间点上的表达变化轨迹。常见问题包括:
- 时间点是否连续,是否可比较。
- 每个时间点样本量是否足够。
- 是否存在批次效应。
- 差异基因是“阶段特异”还是“持续变化”。
- 结果能否回到生物学机制。
时序差异表达分析的关键,不是图做得多,而是分析逻辑要严谨。 如果前期分组不稳,后续火山图、趋势图、聚类图都会失去解释力。
2.WorkBuddy时序差异表达分析的标准流程
2.1 第一步,先明确研究问题和时间结构
做任何时序差异表达分析之前,先回答三个问题:
- 研究对象是什么疾病或处理条件。
- 有几个时间点,每个时间点的含义是什么。
- 你想找的是早期响应基因,还是持续变化基因。
这一步决定后续所有操作。比如,急性炎症模型和肿瘤治疗响应模型,时间结构完全不同。如果时间点定义不清,分析结果很可能无法发表。
2.2 第二步,整理输入数据和分组信息
知识库强调,做生信分析前必须重视数据来源和元信息。对于时序差异表达分析,至少要整理:
- 样本编号。
- 时间点。
- 处理组或对照组。
- 平台信息。
- 是否有特殊预处理。
- 是否存在重复测量设计。
如果数据来自公共数据库,还要特别留意平台注释和GPL信息。这些信息决定你后面能否正确匹配样本和表达矩阵。
2.3 第三步,按照时间点做差异比较
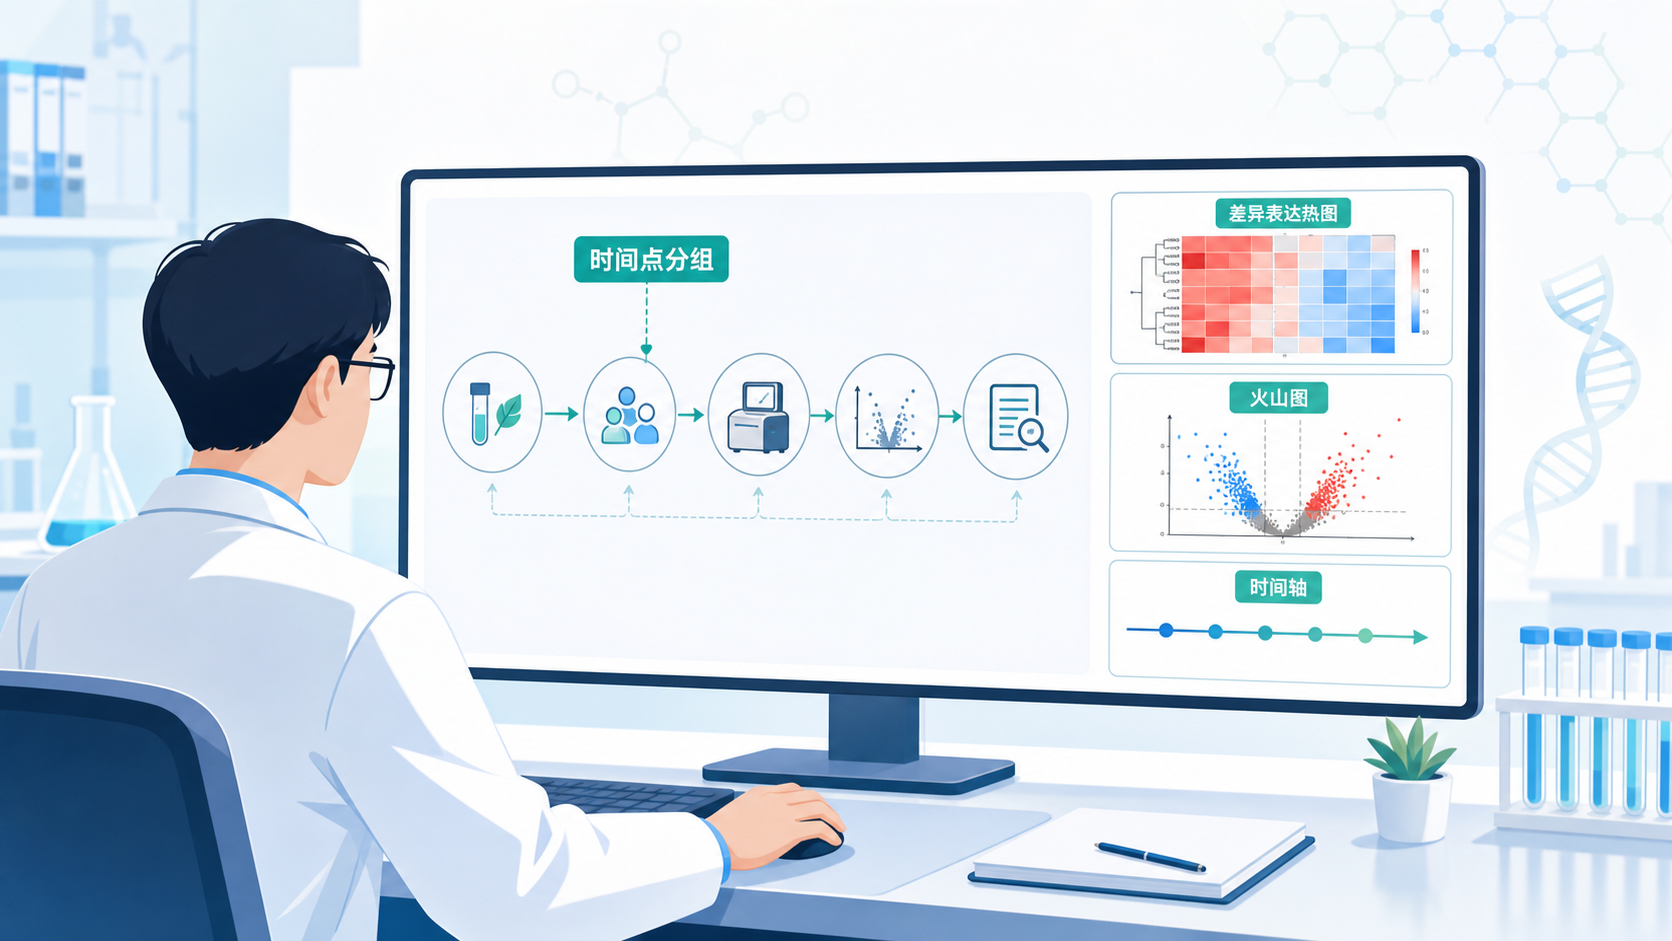
时序差异表达分析通常不是一次性完成,而是按时间点逐步比较。常见做法包括:
- 每个时间点与基线比较。
- 相邻时间点比较。
- 处理组与对照组在各时间点分别比较。
- 结合趋势分析筛选动态变化基因。
在WorkBuddy的知识库思路下,这一步属于标准化流程。核心是先得到可信的差异基因集合,再谈趋势和机制。
2.4 第四步,做动态模式识别
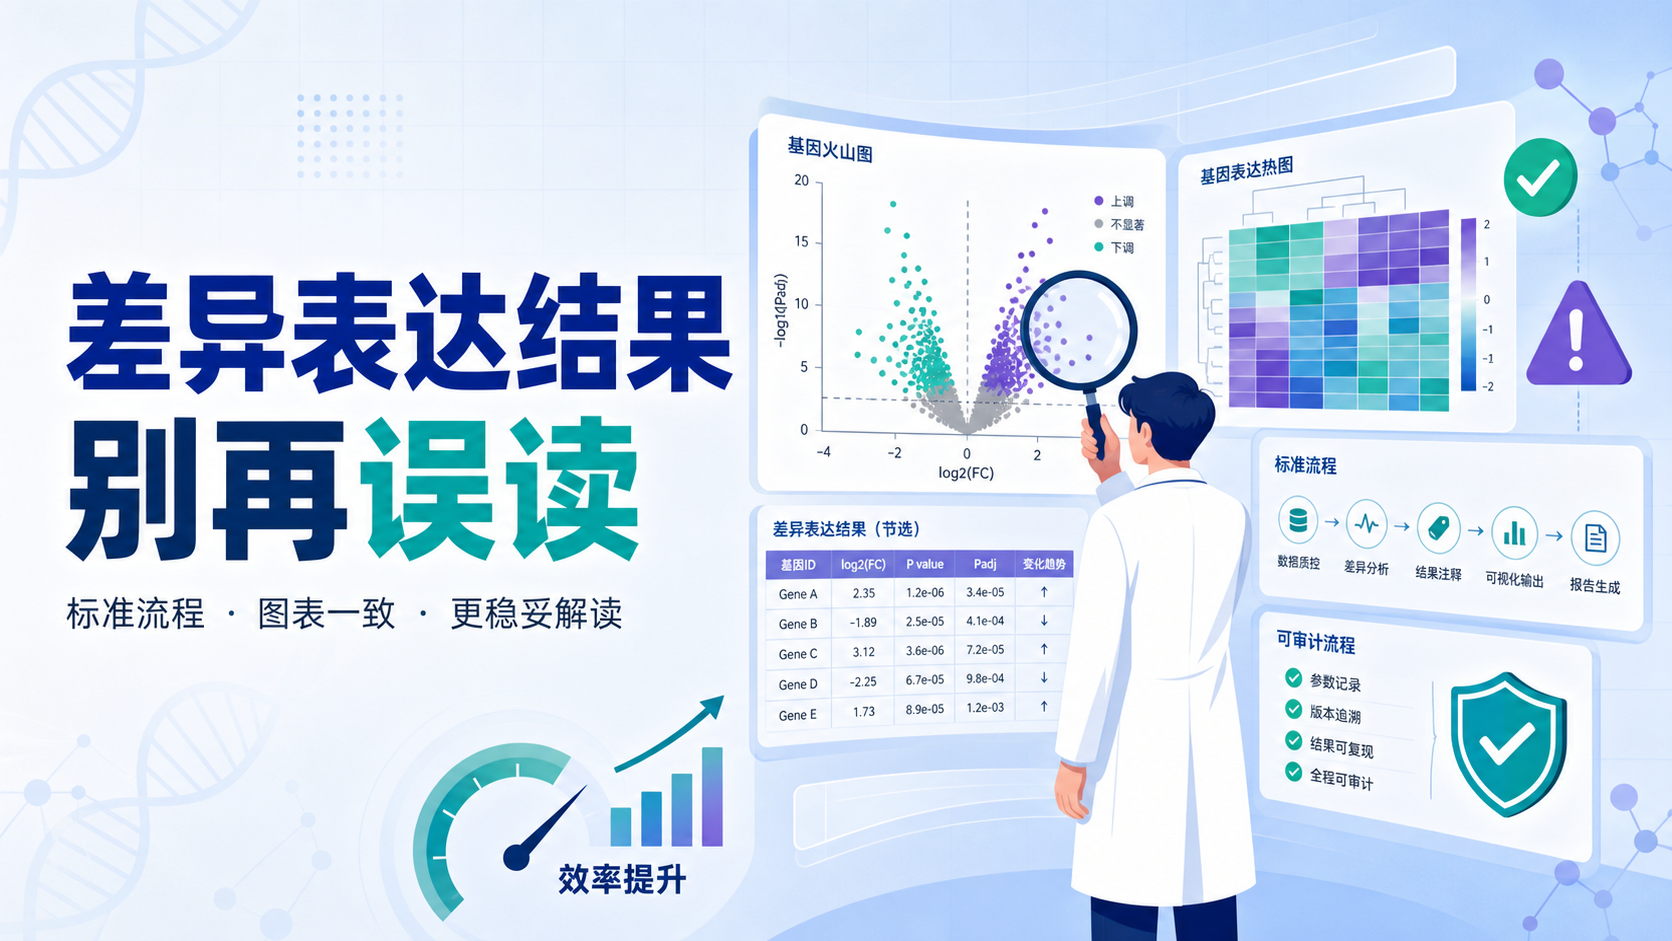
时序数据的价值在于“变化”。因此,分析不能止步于差异列表。还要看基因轨迹。
常见的结果表达包括:
- 趋势聚类。
- 时间序列表达热图。
- 动态上调和下调模块。
- 关键基因随时间的变化曲线。
这些图的作用不是装饰。它们直接服务于论文叙事。能否把时间维度讲清楚,往往决定文章的完整度。
3.如何用WorkBuddy提升时序差异表达分析效率
3.1 用技能化流程替代重复劳动
上游内容提到,WorkBuddy的优势在于把原本需要手动完成的步骤,尽可能沉淀成skill。对于时序差异表达分析,这意味着你不用每次都从零开始搭建分析框架。
你可以把工作拆成几个固定动作:
- 文献检索和研究问题拆解。
- 数据整理和分组确认。
- 差异分析与结果汇总。
- 图表生成与结果描述。
- 论文初稿撰写。
把流程标准化,比临时拼接工具更稳定。 这也是科研效率提升的关键。
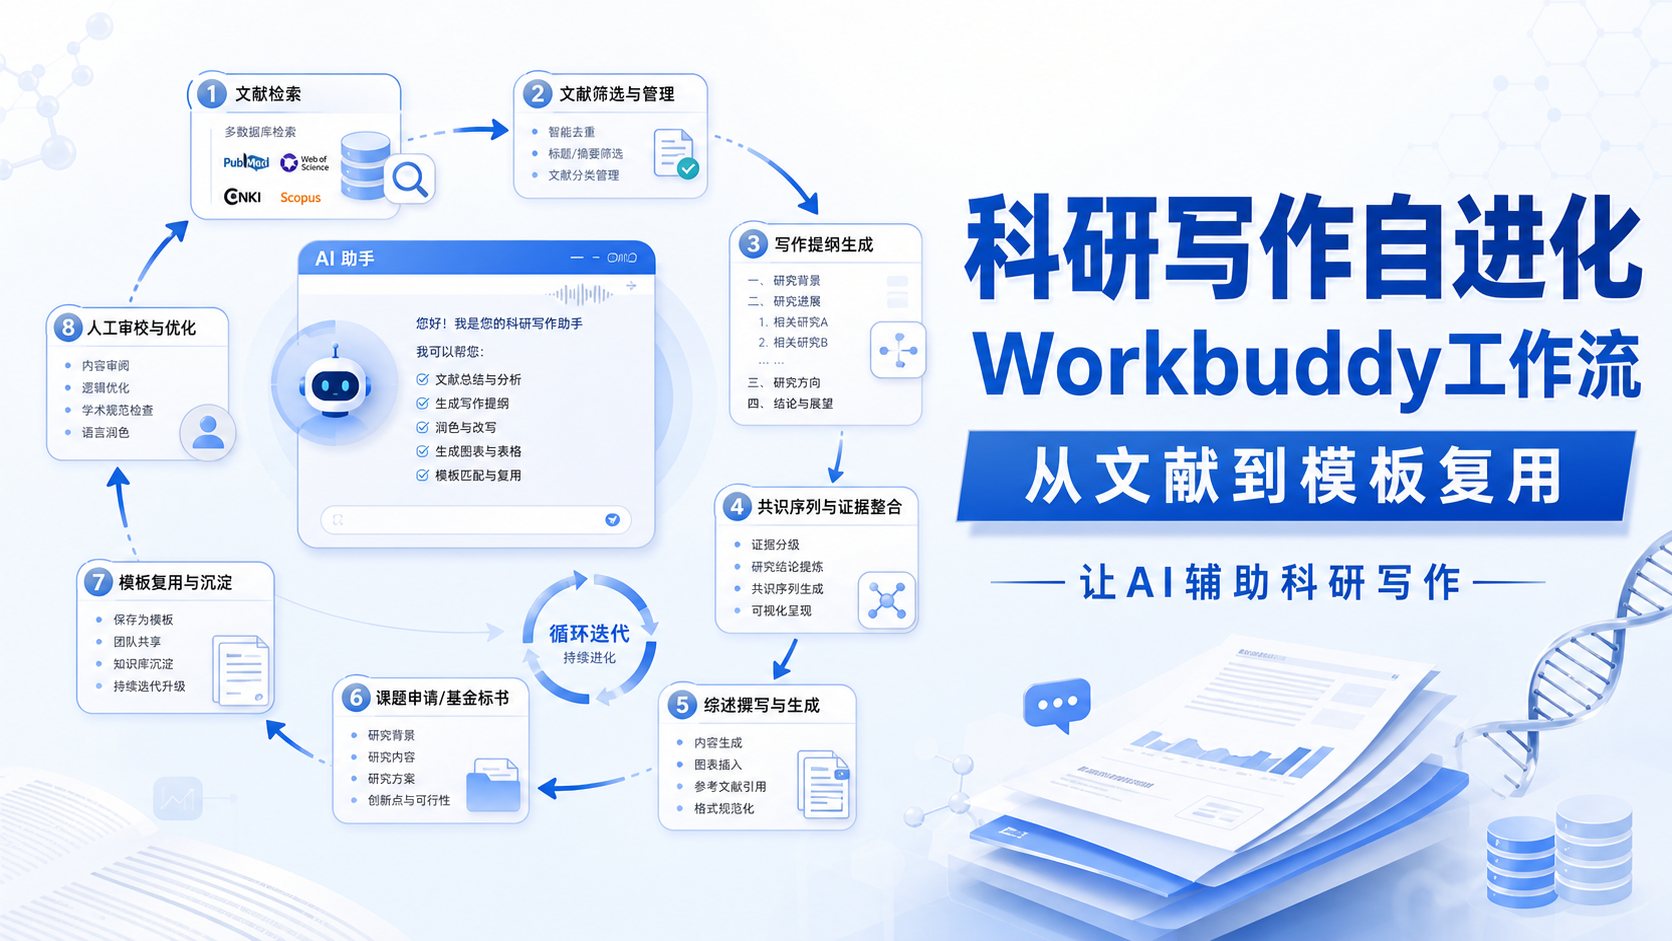
3.2 结合知识库做文献复现
高质量时序分析通常不是凭空设计出来的,而是先复现成熟套路,再做小幅创新。知识库的价值就在这里。
根据上游知识库,系统训练强调:
- 调研文献。
- 拆解研究套路。
- 把新文章中的方法持续迭代进模板。
- 形成可复用的分析范式。
这对时序差异表达分析非常重要。因为不同疾病、不同模型的时间设计不一样,但很多分析骨架是相通的。先复现,再优化,成功率最高。
3.3 用规范化写作承接分析结果
很多人卡在结果之后,不知道怎么写。实际上,时序差异表达分析的写作有固定顺序:
- 交代研究背景和时间设计。
- 描述样本与分组。
- 报告差异基因数量和变化方向。
- 展示趋势模式和关键通路。
- 回到机制和临床意义。
分析不是终点,写清楚才是论文的终点。 如果表达混乱,再好的结果也会削弱说服力。
4.时序差异表达分析中最容易出错的地方
4.1 把“相关”误写成“因果”
时间序列能提示先后关系,但不能直接证明因果。比如某个基因在早期升高,并不等于它就是致病因子。这类表述必须谨慎。
更稳妥的写法是:
- “提示可能参与早期响应。”
- “与疾病进展呈时间相关变化。”
- “可能是潜在调控因子。”
这样更符合科研写作规范,也更容易通过审稿。
4.2 只看差异,不看样本设计
时序分析最怕忽视设计问题。若样本量小、时间点不均、重复不足,统计稳定性会明显下降。尤其在公共数据库中,数据往往不是为你的问题而设计的。
因此要先评估:
- 是否适合时序比较。
- 是否存在明显缺失。
- 是否需要合并相邻时间点。
- 是否要降维后再分析。
设计不稳,后续所有图表都会受影响。
4.3 图做得多,但没有主线
不少文章图很多,但读起来很散。原因在于没有主线。时序差异表达分析最好围绕一条线展开:
- 时间变化。
- 关键基因。
- 核心通路。
- 生物学解释。
只要主线清晰,图表就不是堆砌,而是证据链。这正是高质量论文和普通汇报的区别。
5.把时序差异表达分析做成可发表结果
5.1 结果要服务于研究目标
时序分析不是为了展示“我做了很多图”,而是为了回答具体问题。例如:
- 疾病早期和晚期是否存在不同分子特征。
- 干预后哪类基因最先响应。
- 哪些通路随时间持续激活。
- 哪些基因可作为分层标志物。
越具体的问题,越容易形成可发表结果。
5.2 让分析和写作同步推进
很多科研项目失败,不是因为不会分析,而是分析和写作脱节。更有效的方法是边分析边记录:
- 每一步的输入。
- 每一步的输出。
- 每张图对应的结论。
- 每个结论能支撑哪一段结果。
这样最后写文章时,素材是完整的,逻辑也是连贯的。这比事后补写高效得多。
5.3 用解螺旋的WorkBuddy减少返工
如果你已经有明确的数据来源、时间点设计和分析目标,WorkBuddy这类技能化体系就能把前期重复操作压缩掉。结合解螺旋的知识库、科研技能和写作支持,可以更快把时序差异表达分析落到实际结果上。对需要快速推进课题的人来说,这种“按技能执行”的方式,能显著减少从头摸索的时间成本。
总结Conclusion
时序差异表达分析的难点,不在于单个步骤,而在于把时间结构、分组逻辑、差异比较、动态模式和论文写作串成一条线。WorkBuddy的价值,在于把这些步骤技能化、流程化、标准化。 对医学生、医生和科研人员来说,真正重要的是先建立正确的方法框架,再用稳定工具提升效率。
如果你正在做时序差异表达分析,想减少试错、提高复现效率,并把结果更快转化为可发表内容,可以进一步了解解螺旋的WorkBuddy体系。
- 引言Introduction
- 1.WorkBuddy为何适合时序差异表达分析
- 2.WorkBuddy时序差异表达分析的标准流程
- 3.如何用WorkBuddy提升时序差异表达分析效率
- 4.时序差异表达分析中最容易出错的地方
- 5.把时序差异表达分析做成可发表结果
- 总结Conclusion