

 28
 分享
引言Introduction
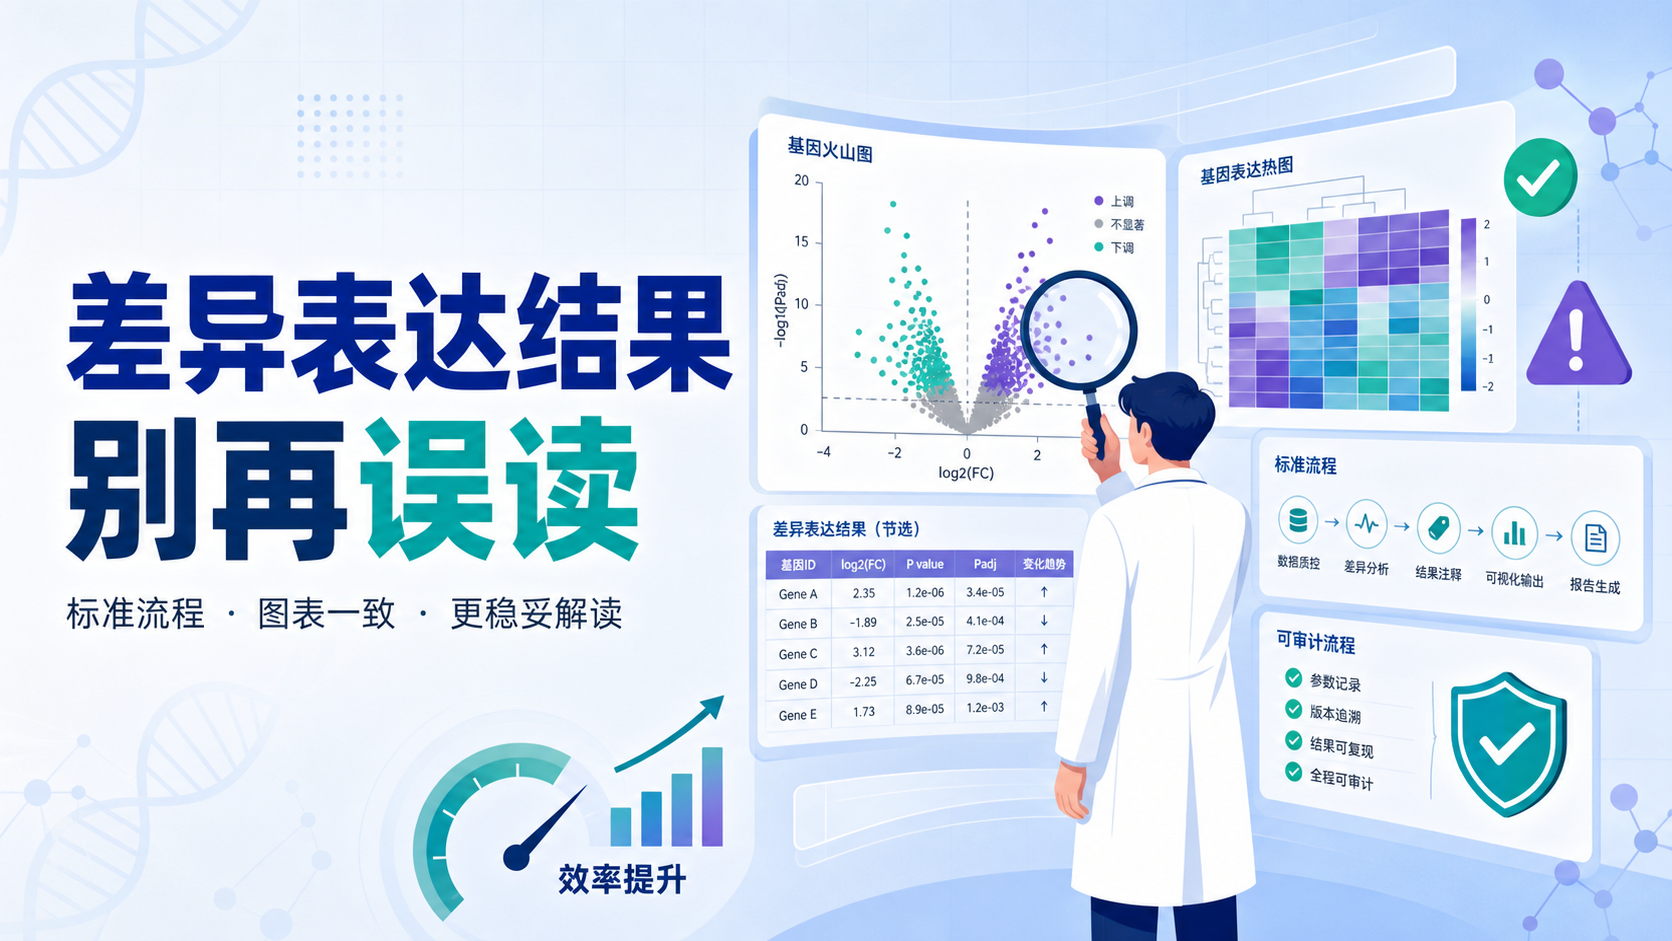
差异表达分析做完后,很多人卡在最后一步。结果表格、P值、logFC、星号标注看起来都对,但一到解释和落地,就容易出错。问题不在于不会分析,而在于结果解读流程不够标准化。
1. 差异表达结果为什么容易解读偏差
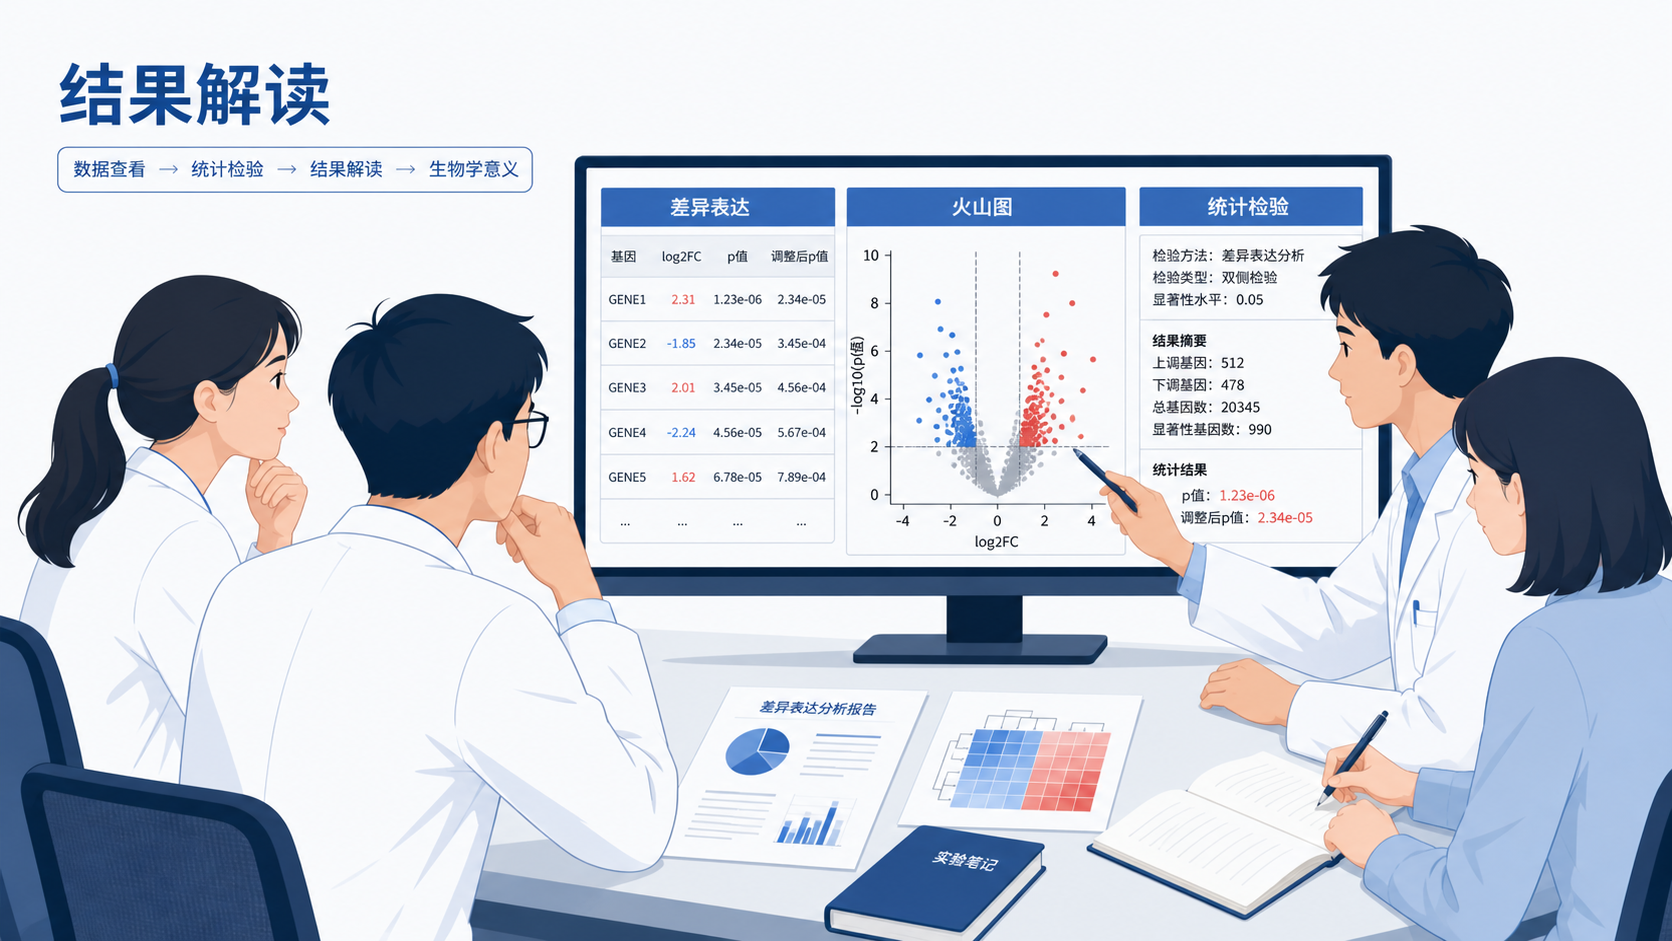
1.1 只看显著性,忽略数据前提
差异表达结果不是“P值小就能直接下结论”。在正式比较前,至少要确认几件事。
- 分组是否明确。
- 数据是否做过合适的标准化。
- 检验方法是否和数据类型匹配。
- 是否存在样本量过小、方差不齐、偏态分布等问题。
如果连续变量本身不服从正态分布,却直接用参数检验,结果就可能偏离真实情况。正确的做法,是先看数据属性,再决定统计方法。
对于两组独立样本,常见路径是先做正态性检验,再判断用 t 检验,还是 Mann-Whitney 检验这类非参数方法。
1.2 结果多,不等于结论稳
很多差异表达项目里,结果表格会列出上千个基因。数量多,不代表结论更可靠。
真正影响解读质量的,往往是下面几点:
- 统计阈值是否一致。
- 是否区分了“统计学显著”和“生物学有意义”。
- 是否核对了对比组方向。
- 是否保留了可复现的分析记录。
如果流程不固定,同一批数据在不同人手里,结果可能完全不一样。 这也是结果解读最常见的偏差来源。
1.3 WorkBuddy的价值在于把流程标准化
WorkBuddy+差异表达结果处理的核心,不是替代人工判断,而是减少“人为漏步”和“解释不一致”。
它更适合做三件事:
- 按固定规则整理结果。
- 统一图表和统计输出。
- 保留可复查的分析路径。
这对临床研究和生信分析都很重要。因为可复现性,本身就是结果可信度的一部分。
2. 差异表达结果解读的标准流程
2.1 先确认比较对象,再看统计量
结果解读的第一步,不是看基因名,而是先看比较关系。
例如:
- 正常组织 vs 肿瘤组织。
- 处理组 vs 对照组。
- 高表达组 vs 低表达组。
如果比较方向弄反,logFC 的正负号也会跟着反转,后续图表标注和生物学解释都会出问题。先确认分组,再解释结果,是最基础也最容易被忽略的一步。
2.2 根据数据分布选择检验方法
对于两组连续变量,常见判断逻辑如下:
- 两组都近似正态,且方差齐,用非配对 t 检验。
- 两组都近似正态,但方差不齐,用校正后的 t 检验。
- 至少一组不服从正态分布,用 Mann-Whitney 检验或 KS 检验。
这里的重点是,分析方法取决于数据属性,而不是图长什么样。
在一些软件中,可以先做正态性检验,再进入差异比较。这样比“直接上图、直接出星号”更稳妥。
2.3 用一致规则整理统计结果
差异表达结果处理时,建议固定几个字段:
- 基因或特征名称。
- logFC 或 fold change。
- P值。
- 校正后的 P值,若有。
- 分组方向。
- 是否通过预设阈值。
这样做的好处很直接。后续不管是画火山图、做热图,还是写论文结果段,都能直接复用同一套表格。
结果表先统一,图和结论才不会散。
3. 图表输出阶段最容易出错的地方
3.1 统计结果和图形标注要一致
很多人会在图上标两个星号、三个星号,但图注却没写清楚阈值。
标准做法是:
- 在图上标明比较组别。
- 在图注里写明检验方法。
- 说明星号对应的 P 值阈值。
- 如果使用了方差校正,也要注明。
例如,p < 0.01 才标记为“**”,这类规则必须前后一致。否则读者看到图,无法判断结论是否可靠。
3.2 输出格式要兼顾论文和复现
科研图像输出通常要考虑两件事:
- 投稿需要高清。
- 后续修改需要保留可编辑性。
因此,建议保留原始分析文件,同时导出高分辨率图片。
在很多项目里,TIFF 是常用格式,分辨率也要足够高,才能满足期刊排版要求。图像只是展示层,真正重要的是背后的数据和流程能否复现。
3.3 不要把“展示图”当成“分析图”
火山图、柱状图、箱线图都属于展示图。
真正的分析图,应该先基于原始结果完成统计判断,再进入视觉呈现。
也就是说,流程顺序应当是:
- 数据整理。
- 统计检验。
- 阈值筛选。
- 图表展示。
- 结果注释。
如果顺序反过来,容易出现“图上看起来很漂亮,但统计基础不成立”的问题。
4. WorkBuddy如何提升差异表达结果处理效率
4.1 把重复操作变成可复用流程
差异表达结果处理里,很多步骤是重复性的。比如筛选、排序、标注、导出、生成结果摘要。
WorkBuddy的优势在于,它可以把这些步骤做成相对稳定的流程,减少每次手工重复设置。
对研究人员来说,这意味着:
- 少掉大量机械操作。
- 降低参数漏填的概率。
- 结果输出更统一。
- 适合团队协作和交叉检查。
重复步骤越少,出错概率越低。
4.2 让结果解读更接近“可审计”
科研场景里,结果不是“看着像对”就够了。最好能回答三个问题:
- 这一步怎么来的。
- 用了什么规则。
- 为什么得到这个结论。
WorkBuddy优化差异表达结果解读流程的意义,就在于把这些信息尽量保留下来。
这样一来,导师、同事、审稿人都能更快理解你的分析依据。对于临床研究和基础生物学研究,这种可审计性非常重要。
4.3 适合从初学者到进阶用户的过渡
对医学生和刚入门的科研人员来说,最难的往往不是“有没有结果”,而是“结果怎么解释才不出错”。
WorkBuddy可以帮助用户先建立标准模板,再逐步理解背后的统计逻辑。
这比只记几个按钮更有价值,因为真正能迁移到别的项目里的,是流程思维,不是单次操作。
5. 实操建议:一套更稳妥的结果解读顺序
5.1 建议按这5步走
你可以把差异表达结果处理固定为以下顺序:
- 先确认分组定义。
- 再检查数据分布和方差情况。
- 选择合适的统计检验。
- 用统一阈值筛选结果。
- 最后再做图表和文字解读。
这套顺序的优点是清晰。每一步都能单独复核。
只要前一步不成立,后一步就不要急着下结论。
5.2 重点关注三个常见误区
- 误区一,直接按图形类型选统计方法。
- 误区二,只看P值,不看效应量。
- 误区三,结果表和图注不一致。
这三个问题在差异表达项目里非常常见。
尤其是在多组比较时,如果对比矩阵和分组顺序没有写清,后面所有结果都可能需要重做。
因此,标准化流程不是“多此一举”,而是减少返工。
5.3 让结果能直接服务论文和报告
高质量的差异表达结果,不只用于“看一眼”。它还要能继续服务下游工作:
- 论文结果段撰写。
- 图表补充材料整理。
- 后续验证实验筛选。
- 临床相关性分析。
如果一套流程从一开始就规范,后面所有输出都会更顺。
这也是为什么解螺旋更强调流程化支持,而不是只给零散结论。
总结Conclusion
差异表达结果处理的关键,不是得到一张表,而是建立一套稳定、可复核、可复用的解读流程。先看数据属性,再选统计方法,随后统一阈值、规范图注、保留记录,才能让结果真正可信。
对于医学生、医生和科研人员来说,WorkBuddy+差异表达结果处理更重要的价值,是把重复劳动变成标准流程,把模糊解读变成可审计结果。如果你希望差异表达分析更高效、更规范,可以尝试借助解螺旋的工具体系,把结果处理流程真正跑顺。
- 引言Introduction
- 1. 差异表达结果为什么容易解读偏差
- 2. 差异表达结果解读的标准流程
- 3. 图表输出阶段最容易出错的地方
- 4. WorkBuddy如何提升差异表达结果处理效率
- 5. 实操建议:一套更稳妥的结果解读顺序
- 总结Conclusion