67
 分享
引言Introduction
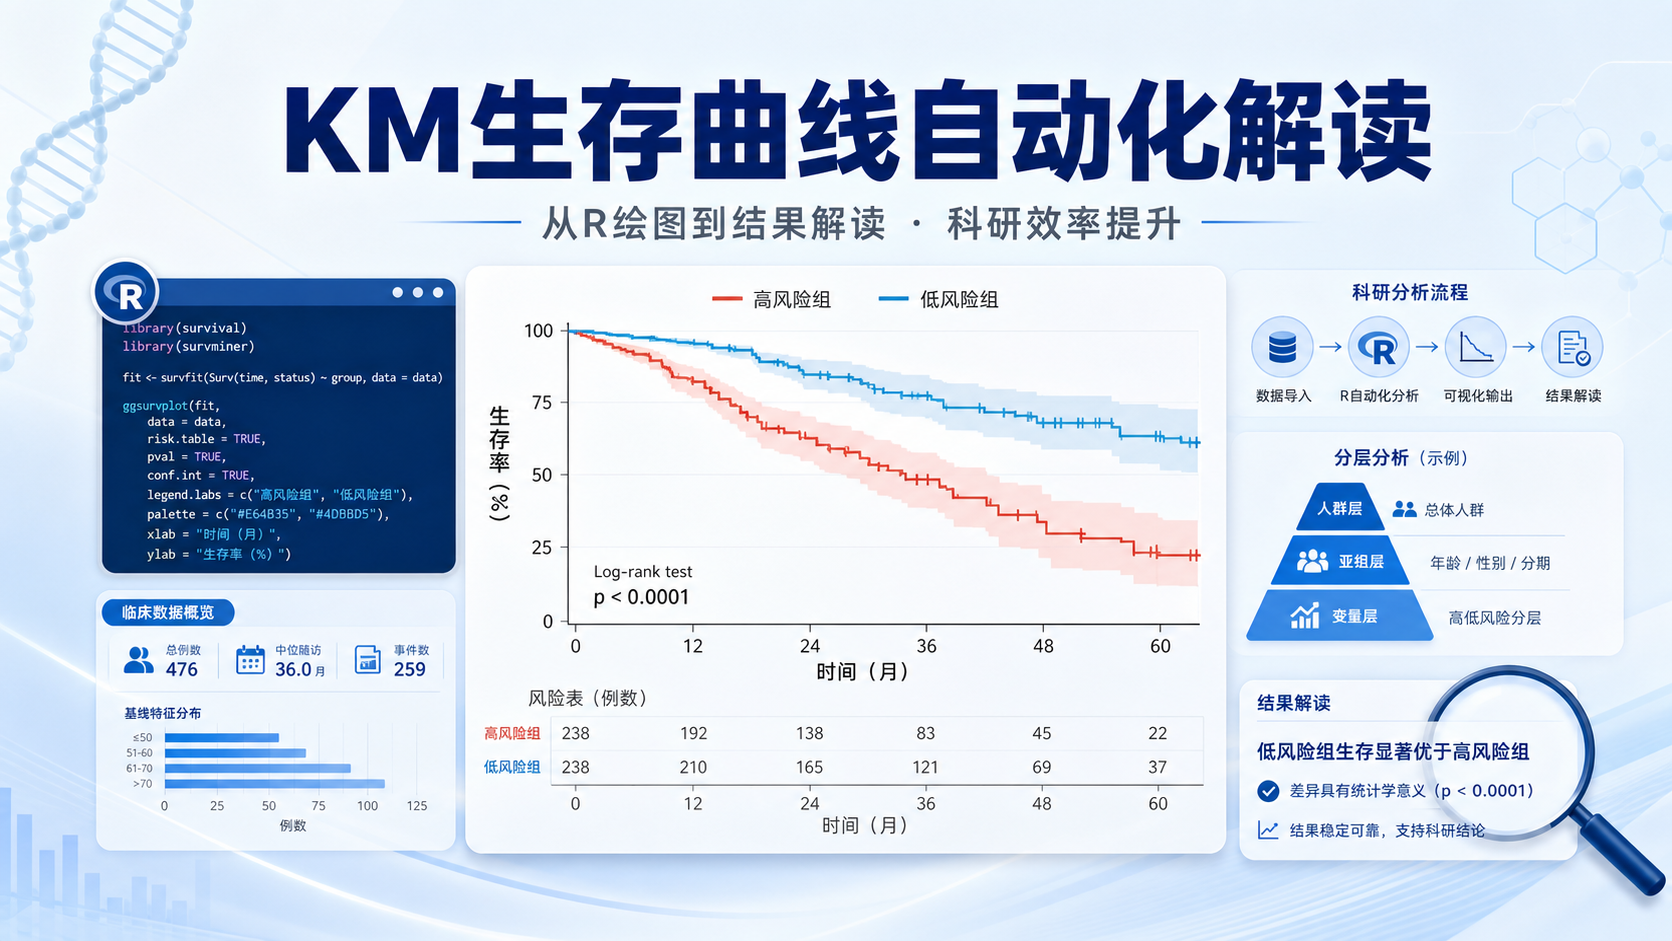
KM生存曲线常被用于预后分析,但手工整理数据、逐步绘图、再解释P值,耗时且易出错。对医学生、医生和科研人员来说,真正的难点不只是“画出来”,而是“画对、解对、写对”。掌握自动化生成流程,能显著提高分析效率和结果可信度。
1.KM生存曲线是什么,为什么必须会解读
1.1 KM曲线的核心定义
KM生存曲线,本质上是以时间t为横轴,以生存率为纵轴 的曲线,用来描述随访过程中事件发生前的生存概率变化。它的价值在于,把抽象的时间结局变成可视化结果,便于比较不同分组的预后差异。
在临床研究中,KM曲线常用于观察以下问题:
- 不同治疗组的生存差异。
- 不同性别、分期、基因分型的预后差异。
- 某一时间点的累计生存概率。
- 由生存概率反推随访时间趋势。
KM曲线不是单纯的图片,它是生存数据分析的入口。 如果底层数据定义错误,后续图形和结论都会偏。
1.2 生存率是如何逐步估计的
KM法的核心思想,是把每个时间点的生存概率连乘起来。若在第k个时间点的条件生存概率为p,则累计生存率可写为:
S(tk)=p1×p2×…×pk
这意味着,曲线会随着事件发生逐步下降,而不是线性变化。临床上常见的阶梯状下降,就是这一机制的直接体现。
需要注意的是,KM曲线默认事件独立,且对删失数据有较强处理能力。也就是说,失访或随访截止并不会直接被当作事件,前提是数据编码正确。
2.自动化生成KM生存曲线的标准流程
2.1 先定义结局变量和分组变量
做KM分析前,最重要的是明确变量定义。通常需要三个核心要素:
- 生存时间 ,例如days、months、OS time。
- 结局事件 ,例如死亡、复发、进展。
- 分组变量 ,例如性别、治疗方案、分子分型。
在黑色素瘤示例中,时间变量是days,结局变量是status,自变量是sex。这里的关键点是,status==1代表事件发生 ,例如死于恶性黑色素瘤。若事件编码错了,曲线方向和P值都可能失真。
2.2 用R完成KM拟合与绘图
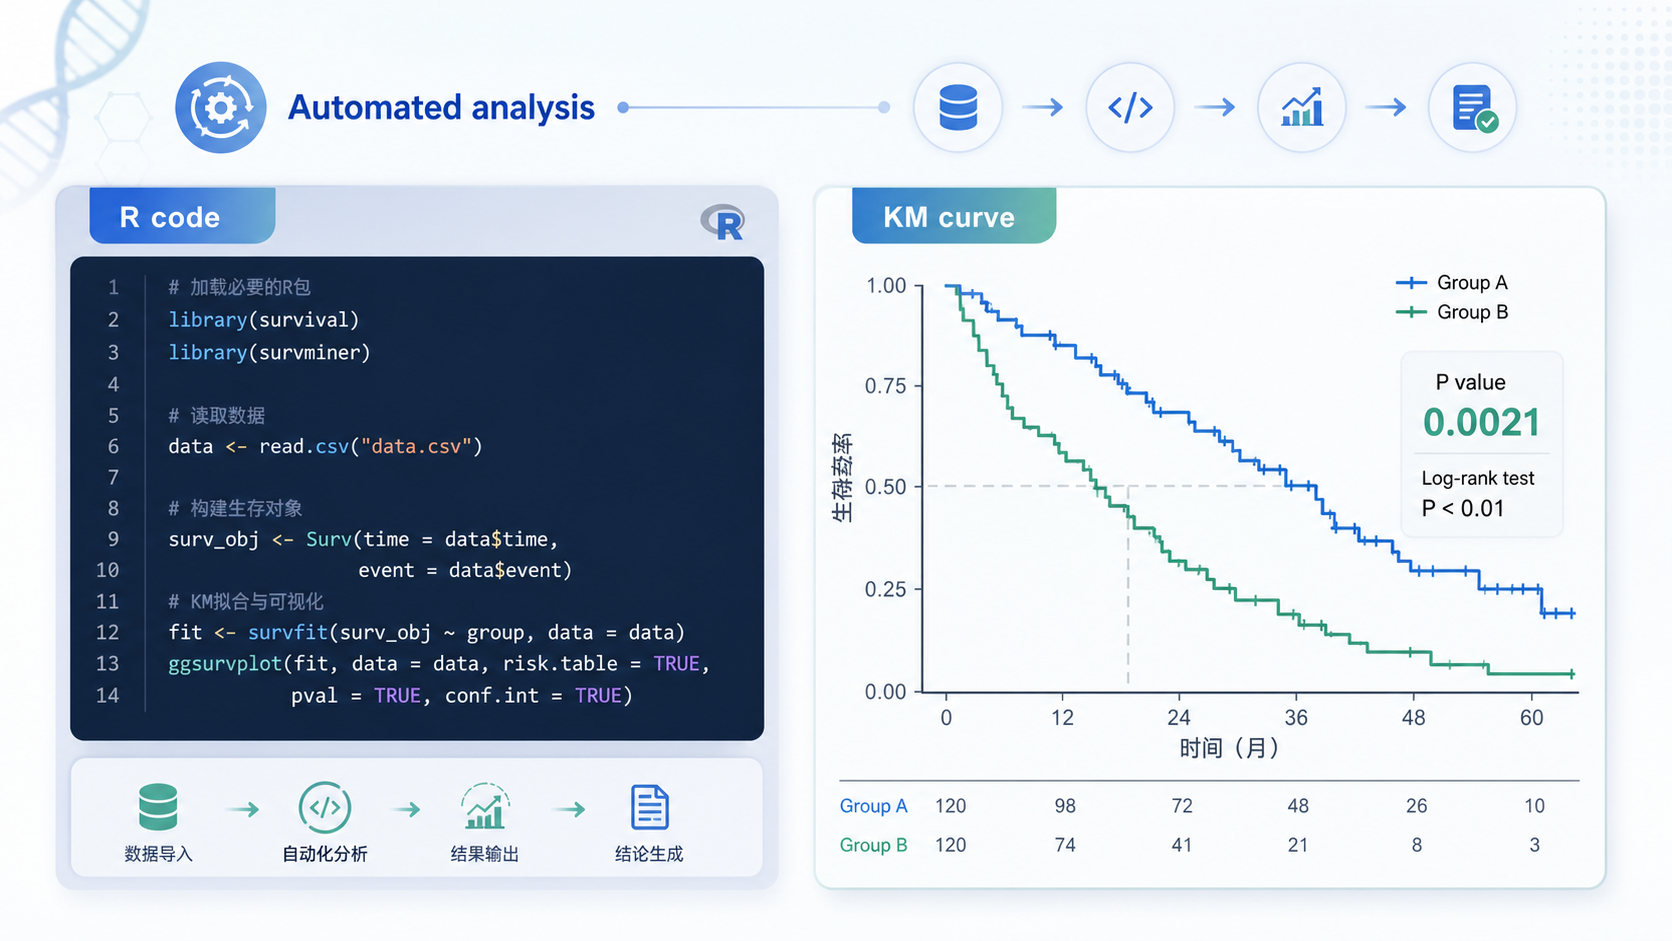
在R中,KM曲线通常通过 survfit 完成拟合,生存对象由 surv 函数组装。一个标准思路是:
- 用
surv()把时间和结局合并。 - 用
survfit()按分组变量拟合生存曲线。 - 用
plot()绘图。 - 用
legend()添加图例。 - 若需要,关闭置信区间显示以提高图面清晰度。
例如,在性别分组的分析中,模型形式可理解为:
- 时间:days。
- 结局:status==1。
- 分组:sex。
自动化的价值在于,模型设定完成后,图和结果可以重复生成,减少人工绘图误差。
2.3 图形输出要重点检查什么
KM曲线画出来后,不要只看“有没有图”。建议至少检查以下5点:
- 横轴和纵轴名称是否正确。
- 分组颜色是否与图例一致。
- 曲线是否出现异常陡降。
- 删失点是否展示合理。
- 组间样本量是否过小。
如果某组样本量太少,曲线会非常不稳定。此时视觉差异可能很大,但统计学意义未必成立。
3.结果解读不能只看曲线高低
3.1 先看曲线,再看统计学检验
很多初学者会直接根据曲线“谁高谁低”下结论,这是不够严谨的。KM曲线只能提示趋势,真正判断组间差异是否成立,需要log-rank检验。
Log-rank检验,也叫对数秩检验,原假设是:
不同组的生存曲线没有统计学差异。
如果P<0.05,通常认为组间生存差异有统计学意义。若P≥0.05,则不能拒绝原假设。
在黑色素瘤案例中,性别分组的log-rank检验结果显示卡方值约为6.5,P=0.01,提示男性与女性生存率存在统计学差异。但这不等于因果关系成立,只能说明两组预后分布不同。
3.2 分层分析能帮助你控制混杂
单纯比较两组生存曲线,容易受混杂因素影响。比如性别差异可能与分期、肿瘤负荷、病理类型有关。此时可以做分层log-rank检验。
在该示例中,可按是否溃疡型进行分层,再比较性别的生存差异。分层后结果显示P=0.07,不再具有统计学意义。这个变化说明,原始差异可能部分受到分层变量影响。
这也是KM分析的重要价值。它不仅告诉你“有没有差异”,还提示你“差异是否稳定”。
3.3 解读KM结果时最容易犯的3个错误
-
把相关性当因果性。
KM曲线只能说明生存差异,不证明病因。 -
只看P值,不看曲线形态。
如果曲线交叉,log-rank检验的解释要更谨慎。 -
忽视删失与随访长度。
末端样本数过少时,尾部曲线不稳定,不能过度解读。
一个合格的结果解读,应该同时包含曲线趋势、P值、临床背景和潜在混杂因素。
4.从自动化到可复用,科研效率才真正提升
4.1 规范化流程能减少重复劳动
对临床研究人员来说,KM生存曲线最耗时的环节,往往不是建模,而是反复调图、改标签、换分组、补图例。自动化流程可以把这些步骤标准化。
建议建立以下模板:
- 数据预处理模板。
- 变量编码检查模板。
- KM拟合模板。
- Log-rank检验模板。
- 出图模板。
- 结果描述模板。
这样做的好处很明确。同一套分析逻辑可以应用于不同队列,既节省时间,也提高可追溯性。
4.2 结果写作要贴近临床语言
KM结果写作时,建议采用简洁、可审查的表达方式。例如:
- 某组生存率高于另一组。
- 差异是否具有统计学意义。
- 是否经过分层分析验证。
- 是否存在潜在混杂。
不要只写“有差异”或“无差异”。最好补充P值、分层条件和事件定义。这样更符合科研论文和学位论文的要求。
4.3 如果想更快落地,可以借助专业工具
对于需要频繁做预后分析的人群,推荐使用像解螺旋 这样的专业科研工具和方法支持平台,把KM曲线绘制、分组比较、结果整理做成更稳定的流程。这样能减少手工操作带来的错误,也更适合批量分析和规范化汇报。
当你把数据、分组和检验流程标准化后,KM生存曲线就不再是“手绘负担”,而是可重复、可审计、可发表的科研工具。
总结Conclusion
KM生存曲线的核心,不只是画图,而是完整理解时间、结局、分组和统计检验之间的关系。自动化生成能提升效率,规范解读才能保证结论可靠。 对医学生、医生和科研人员而言,真正高质量的KM分析,必须同时做到变量定义准确、绘图规范、log-rank检验合理、分层分析严谨。
如果你希望把KM生存曲线分析做得更快、更稳、更适合科研产出,可以进一步使用解螺旋 的专业支持,减少重复劳动,提升结果质量与可复用性。
- 引言Introduction
- 1.KM生存曲线是什么,为什么必须会解读
- 2.自动化生成KM生存曲线的标准流程
- 3.结果解读不能只看曲线高低
- 4.从自动化到可复用,科研效率才真正提升
- 总结Conclusion