55
 分享
引言Introduction
传统KM曲线分析,往往卡在数据整理、分组、绘图和结果解释四个环节。对医学生、医生和科研人员来说,耗时的不是模型本身,而是重复操作和代码调试。如果能用自然语言直接完成生存分析,效率会明显提升。
1. 为什么KM曲线仍是生存分析的核心工具
1.1 KM曲线回答的是最基础、也最关键的问题
KM曲线,也就是Kaplan-Meier生存曲线,主要用于比较不同组别的生存概率随时间变化的差异。它常见于肿瘤研究、预后标志物分析、药物疗效评估和临床分层研究。
它的价值在于把“风险差异”转化为“时间维度上的生存差异”。 例如,同一基因高低表达组,是否在1年、3年、5年时出现不同的生存结局。这个问题,KM曲线可以直观回答。
1.2 传统流程的痛点很明确
经典生存分析通常包含以下步骤。
- 整理表达矩阵和临床结局数据。
- 根据阈值或分组规则划分高低组。
- 运行
survfit和survdiff。 - 绘制KM曲线、风险表和置信区间。
- 解释P值、HR和曲线分离趋势。
问题在于,这套流程对初学者并不友好。样本ID对齐、缺失值处理、重复样本去重、分组逻辑校验,任何一步出错都会影响结果可靠性。
1.3 AI介入的意义不是替代统计,而是压缩操作成本
AI赋能的重点,不是让分析“自动化到失去控制”,而是把繁琐的工程步骤交给系统,把专业判断保留给研究者。
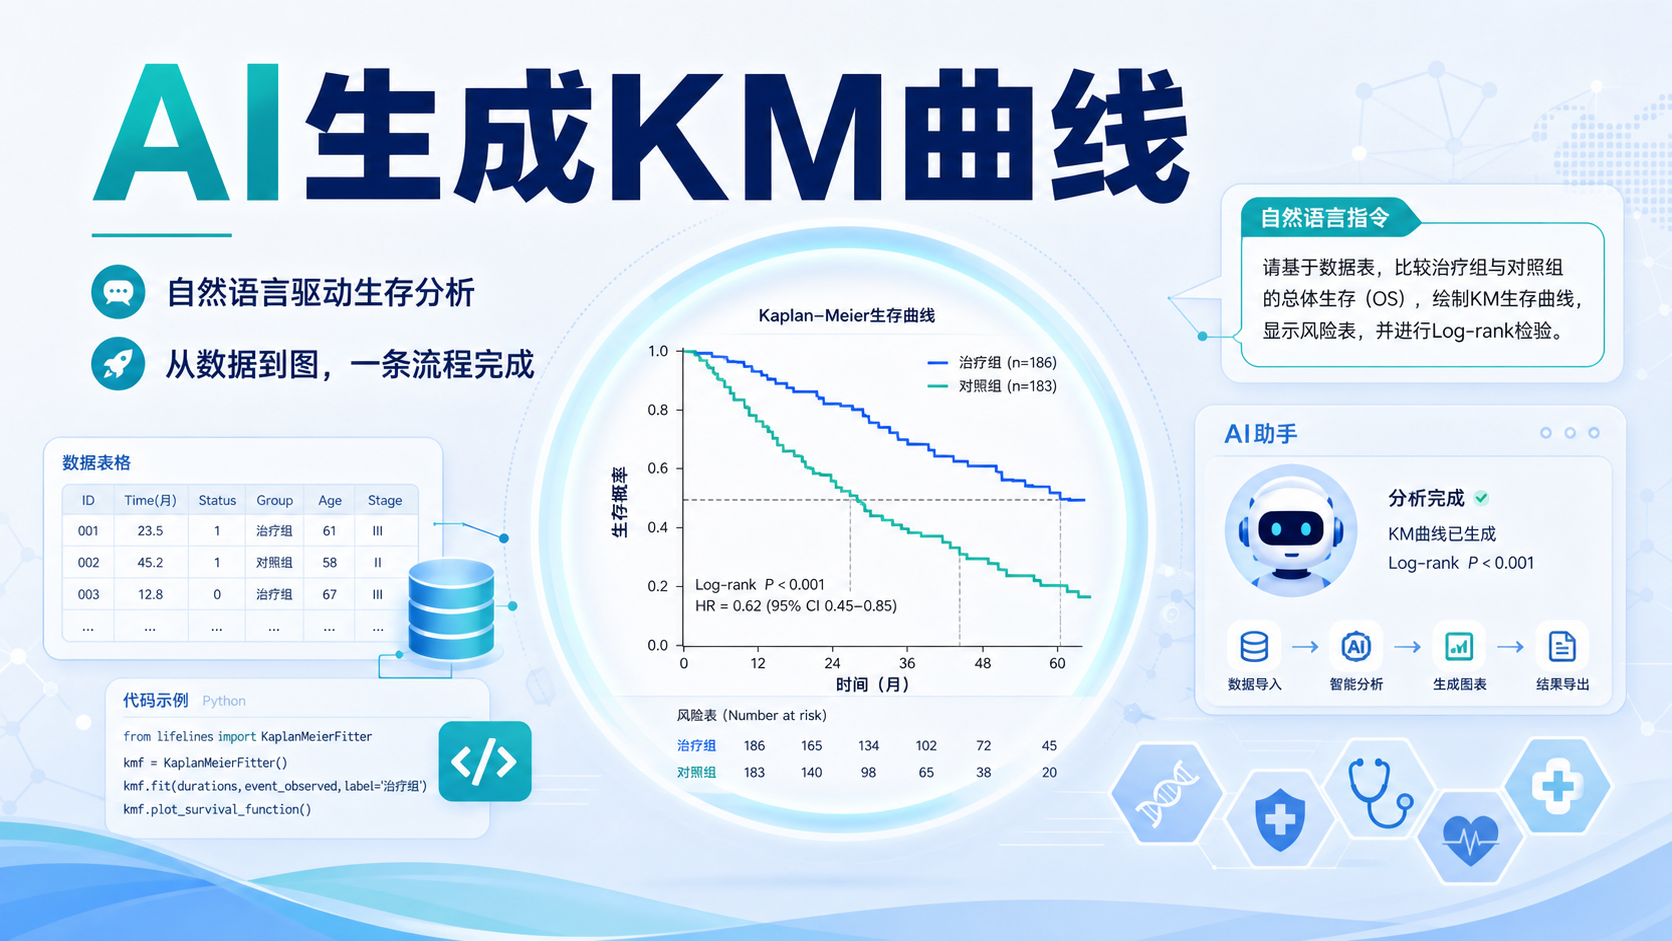
在实际场景中,研究者只需描述需求,例如“对某基因按高低表达分组并生成KM曲线”,系统就可以拆解任务,完成数据读取、分组、生存拟合和可视化输出。这类自然语言驱动流程,特别适合探索性研究和多基因批量筛查。
2. 自然语言驱动KM曲线生成的工作流程
2.1 从“写代码”变成“下指令”
在AI coding模式下,用户输入的不是R脚本,而是任务目标。比如:
- 按基因表达量分组。
- 生成KM生存曲线。
- 输出P值、置信区间和风险表。
- 保存结果图和结果文件。
系统会自动拆分步骤,执行分析,并把结果写入指定文件夹。对科研人员来说,这意味着分析门槛从“会不会写代码”变成“能不能提出准确问题”。
2.2 一个标准的生存分析流程应该包含什么
一个可靠的自然语言驱动KM流程,通常应覆盖以下环节。
2.2.1 数据准备
需要同时具备结局信息和时间信息。常见字段包括:
- 生存状态,通常为0/1。
- 生存时间,单位需统一。
- 分组变量,例如高表达组和低表达组。
- 样本ID,必须严格匹配。
样本对齐是最容易被忽略的步骤,也是最容易引入偏差的步骤。
2.2.2 生存建模
在R语言中,常用 survival 包完成 Surv(os_time, status) 与 survfit() 拟合。随后用 survdiff() 进行组间差异检验。
这一步决定了曲线是否具有统计学差异。
2.2.3 可视化输出
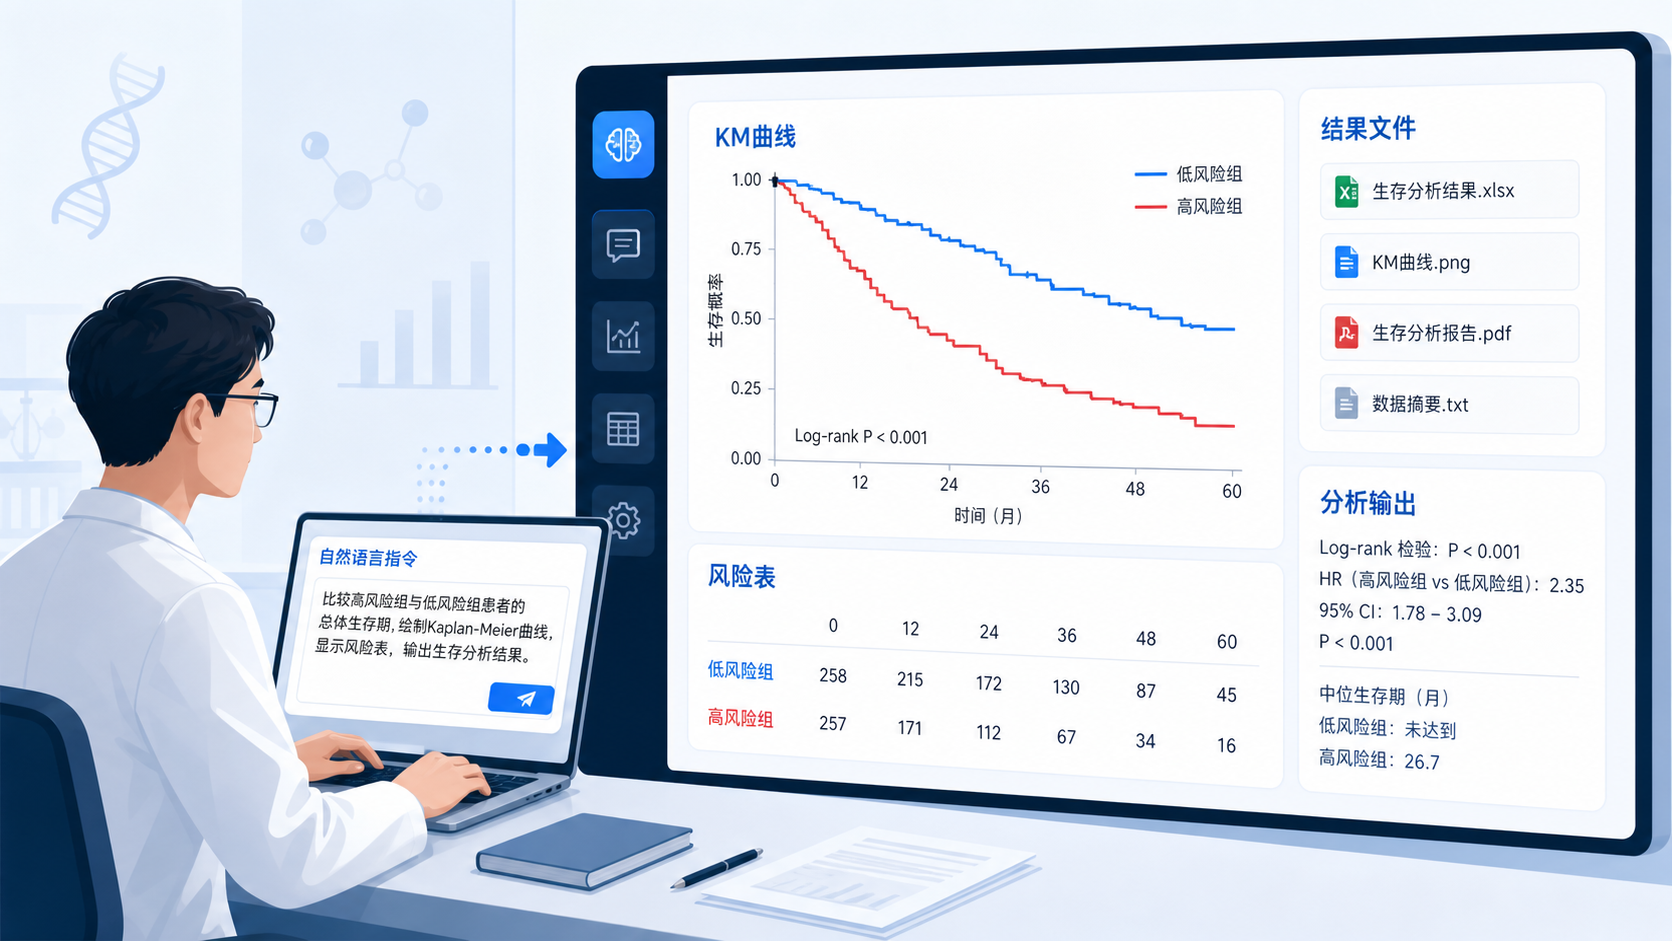
高质量KM图通常应包含:
- 生存曲线。
- 置信区间。
- 风险表。
- P值。
- 图例和分组标签。
对论文和汇报场景而言,风险表和置信区间几乎是必备元素。
2.3 AI工具如何提升分析稳定性
以集成化分析平台为例,系统可以在可视化IDE里完成以下任务:
- 自动读取数据。
- 自动分组并去重。
- 自动拟合生存模型。
- 自动生成结果图。
- 自动保存差异列表和可视化文件。
这类模式的优势不只是“快”,而是减少了人为操作中的遗漏和格式错误。 对多组样本、多轮验证和批量基因筛选尤其有价值。
3. 生存曲线分析中,最容易出错的环节
3.1 样本ID不统一,会直接影响结果
临床样本和表达矩阵经常来自不同表格。样本ID格式可能不一致,例如一个是完整条码,一个是前12位患者编号。
如果不先统一ID,再做交集筛选,就可能出现错配。
常见处理包括:
- 截取统一长度的患者编号。
- 删除重复样本。
- 仅保留表达数据和临床数据都存在的样本。
任何KM曲线的前提,都不是画图,而是数据匹配正确。
3.2 分组规则不清晰,会导致结论不稳
基因高低表达分组并非越简单越好。常见方法包括中位数分组、最佳截点分组和预设阈值分组。不同策略会影响曲线分离程度,也会影响P值。
在科研写作中,建议明确说明:
- 采用的分组规则。
- 是否排除了缺失值。
- 是否做了重复样本去重。
- 是否进行了多重比较控制。
这样才能保证结果可复现。可复现性,是生存分析能否被同行接受的关键。
3.3 只看P值,不看曲线形态,是常见误区
KM曲线的解释不能只盯着P值。还要同时看:
- 两组曲线是否持续分离。
- 风险表中各时间点剩余样本数是否足够。
- 置信区间是否过宽。
- 曲线末端是否因样本减少而不稳定。
如果曲线末端样本量过少,即使P值显著,也不能过度解读。 这是临床研究中必须保持的谨慎。
4. 自然语言分析为什么适合医学生、医生和科研人员
4.1 适合早期探索和快速验证
在课题前期,研究者常常需要快速判断某个基因、通路或临床变量是否与生存结局相关。此时最重要的是速度和可重复性。
自然语言驱动分析可以帮助你在较短时间内完成:
- 单基因生存分析。
- 分组比较。
- KM曲线绘制。
- 初步结论筛选。
这对课题筛选、文章选题和预实验设计非常实用。
4.2 适合教学和方法学习
对医学生和年轻研究者而言,KM曲线不仅是图,更是理解删失数据和时间依赖结局的重要入口。
如果分析平台能把“输入指令、拆解步骤、生成结果”完整展示出来,学习者更容易理解每一步的统计逻辑。
例如,系统可同时展示:
- 分组后的样本信息。
survfit拟合结果。survdiff的P值计算。- 最终KM图和风险表。
这比单纯看教程更接近真实科研场景。
4.3 适合标准化输出
论文投稿、课题汇报和组会展示,对图形规范要求很高。KM曲线需要统一字体、颜色、图例和输出格式。
AI工具如果能自动生成标准图,并同步保存原始结果文件,就能减少返工。
对实验室来说,这种流程还有一个好处:团队成员之间的分析风格更统一,结果更容易复核。
5. 解螺旋如何帮助你更高效完成生存分析
5.1 从数据到KM图,一条流程完成
在实际使用中,解螺旋可将分组比较、生存分析和可视化整合到同一流程中。你可以通过自然语言描述需求,系统自动完成:
- 数据读取与整理。
- 样本匹配与去重。
- KM曲线生成。
- 风险表和P值输出。
- 结果文件保存。
你不需要先写完整脚本,再逐行调试。 这对时间紧、任务重的科研场景非常重要。
5.2 不只是画图,更是提高分析可追溯性
解螺旋这类平台的价值,在于把分析过程和结果文件保留下来。
当你需要复现某次分析时,可以快速回到结果目录,检查差异基因列表、可视化图表和参数设置。
这对论文返修、课题答辩和组内复核都很有帮助。分析留痕,意味着结果更可信。
5.3 对科研团队更友好的工作方式
如果一个平台未来继续整合更多AI agent能力,就可以进一步把“自然语言提问”扩展到更多数据分析场景。
比如从单个基因的生存分析,拓展到批量筛选、分组比较和多种图形输出。
这正是解螺旋这类工具的方向。它让生存曲线分析更标准,也更高效。
总结Conclusion
KM曲线仍然是临床研究和转化医学中最常用的生存分析工具之一。它能清楚展示不同组别的生存差异,也能帮助研究者快速判断变量是否具有预后价值。
但传统流程依赖代码、步骤多、易出错。自然语言驱动的AI分析模式,正在把生存曲线生成从“手工操作”变成“任务式执行”。
对于医学生、医生和科研人员来说,这种方式既能减少重复劳动,也能提升结果规范性和可复现性。若你希望更高效地完成KM曲线、生存分析和结果输出,可以进一步了解解螺旋 ,把时间留给更重要的科学问题。
- 引言Introduction
- 1. 为什么KM曲线仍是生存分析的核心工具
- 2. 自然语言驱动KM曲线生成的工作流程
- 3. 生存曲线分析中,最容易出错的环节
- 4. 自然语言分析为什么适合医学生、医生和科研人员
- 5. 解螺旋如何帮助你更高效完成生存分析
- 总结Conclusion