115
 分享

引言Introduction
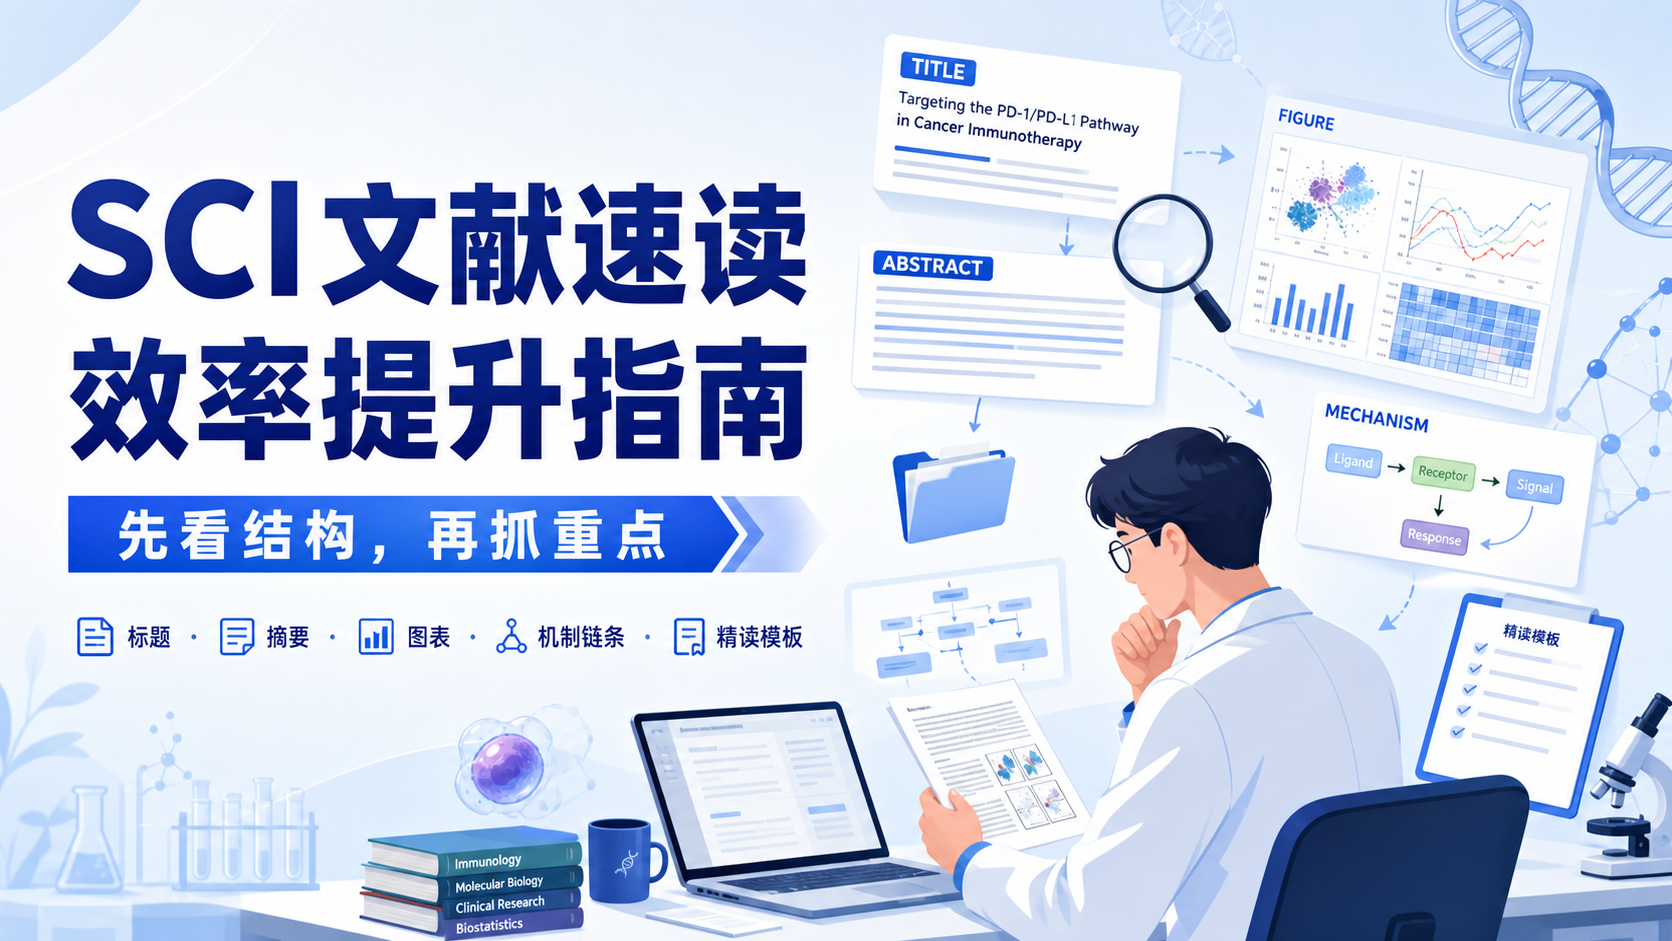
很多人读文献时,常见问题不是“读得少”,而是“读得乱”。标题看不懂,摘要抓不住,图表越看越模糊,最后只能停在“知道这篇文章存在”,却无法真正迁移到自己的课题中。AI可以帮你提速,但前提是用对方法。 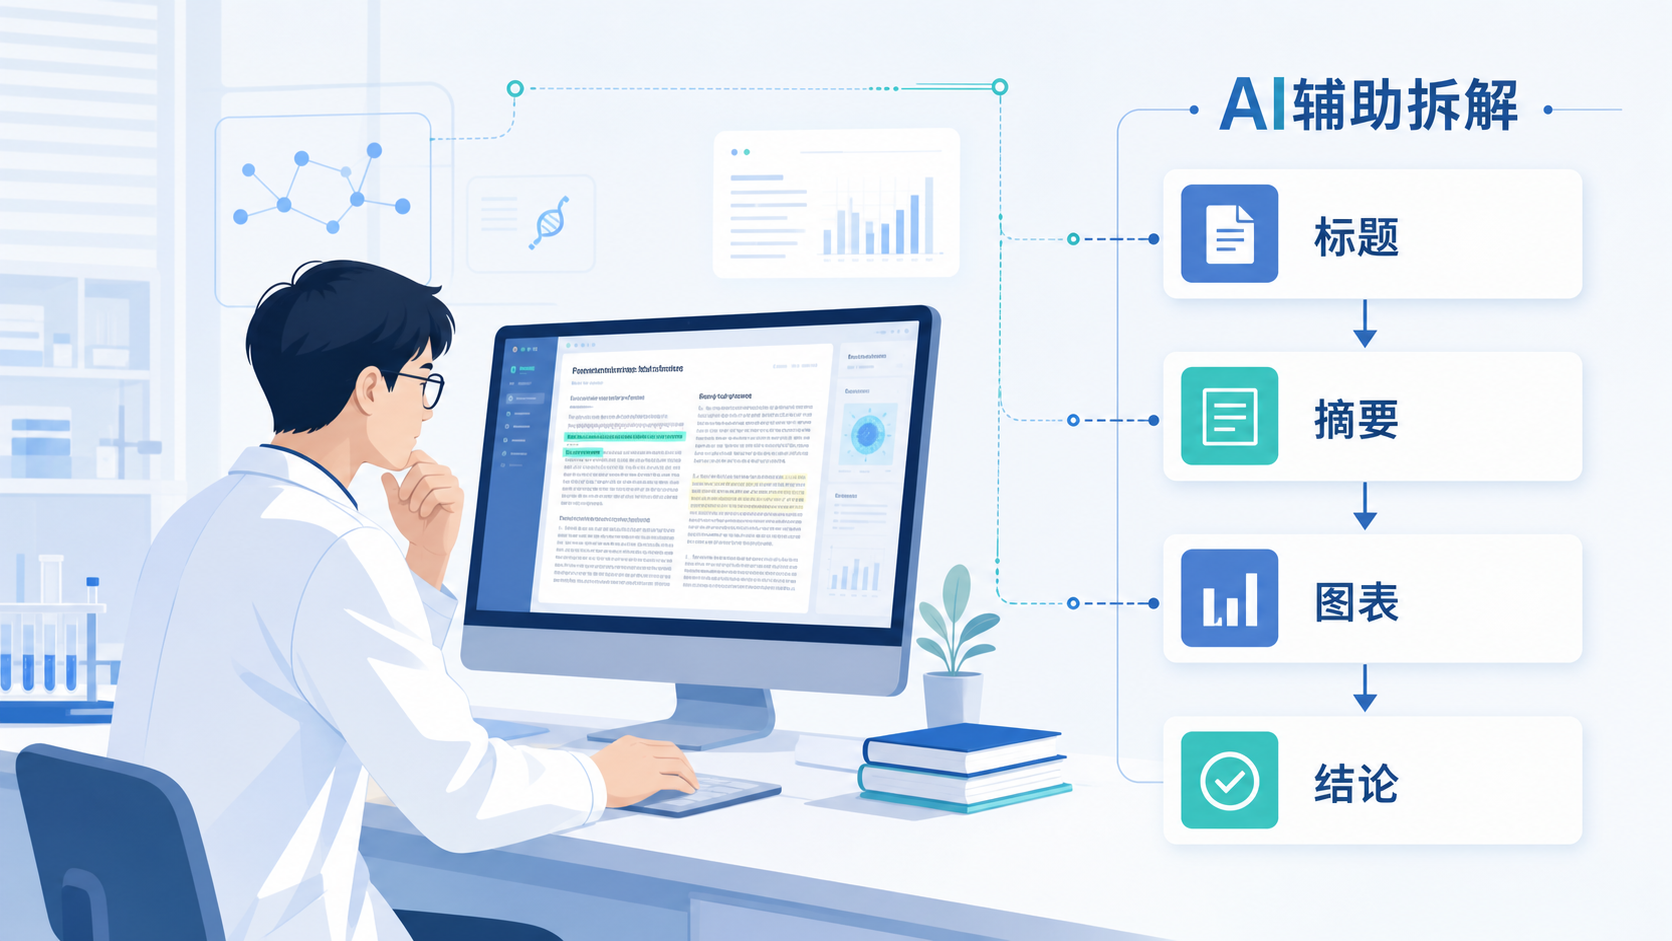
1. 文献泛读为什么是精读的前提
1.1 泛读的目标,不是逐字读完
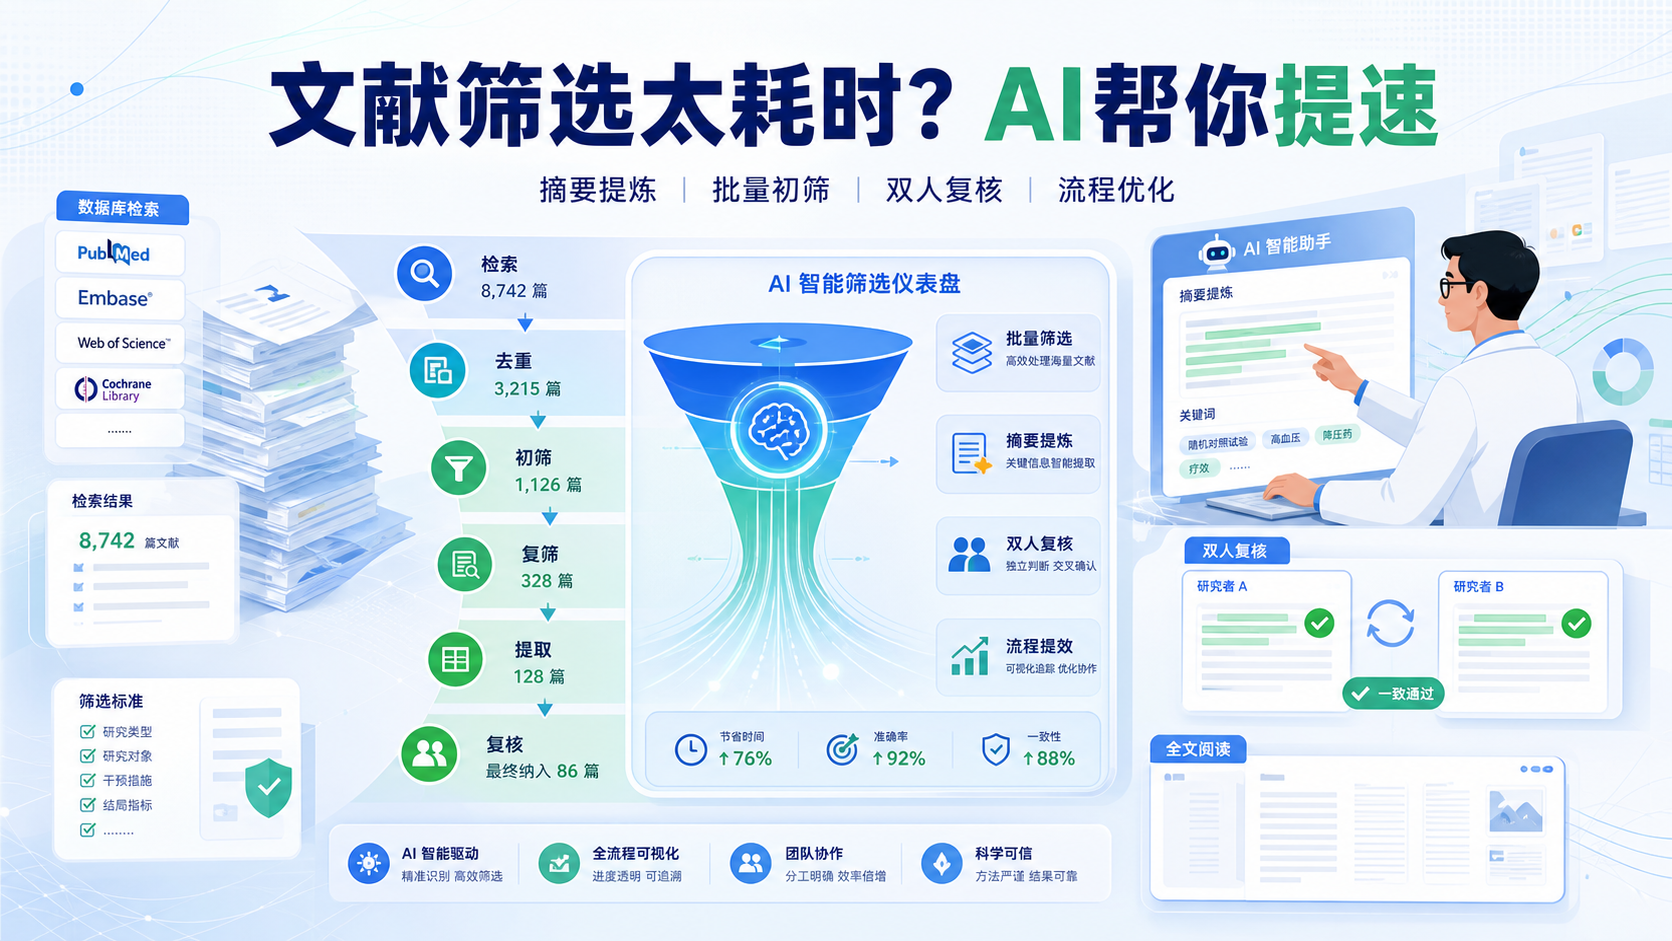
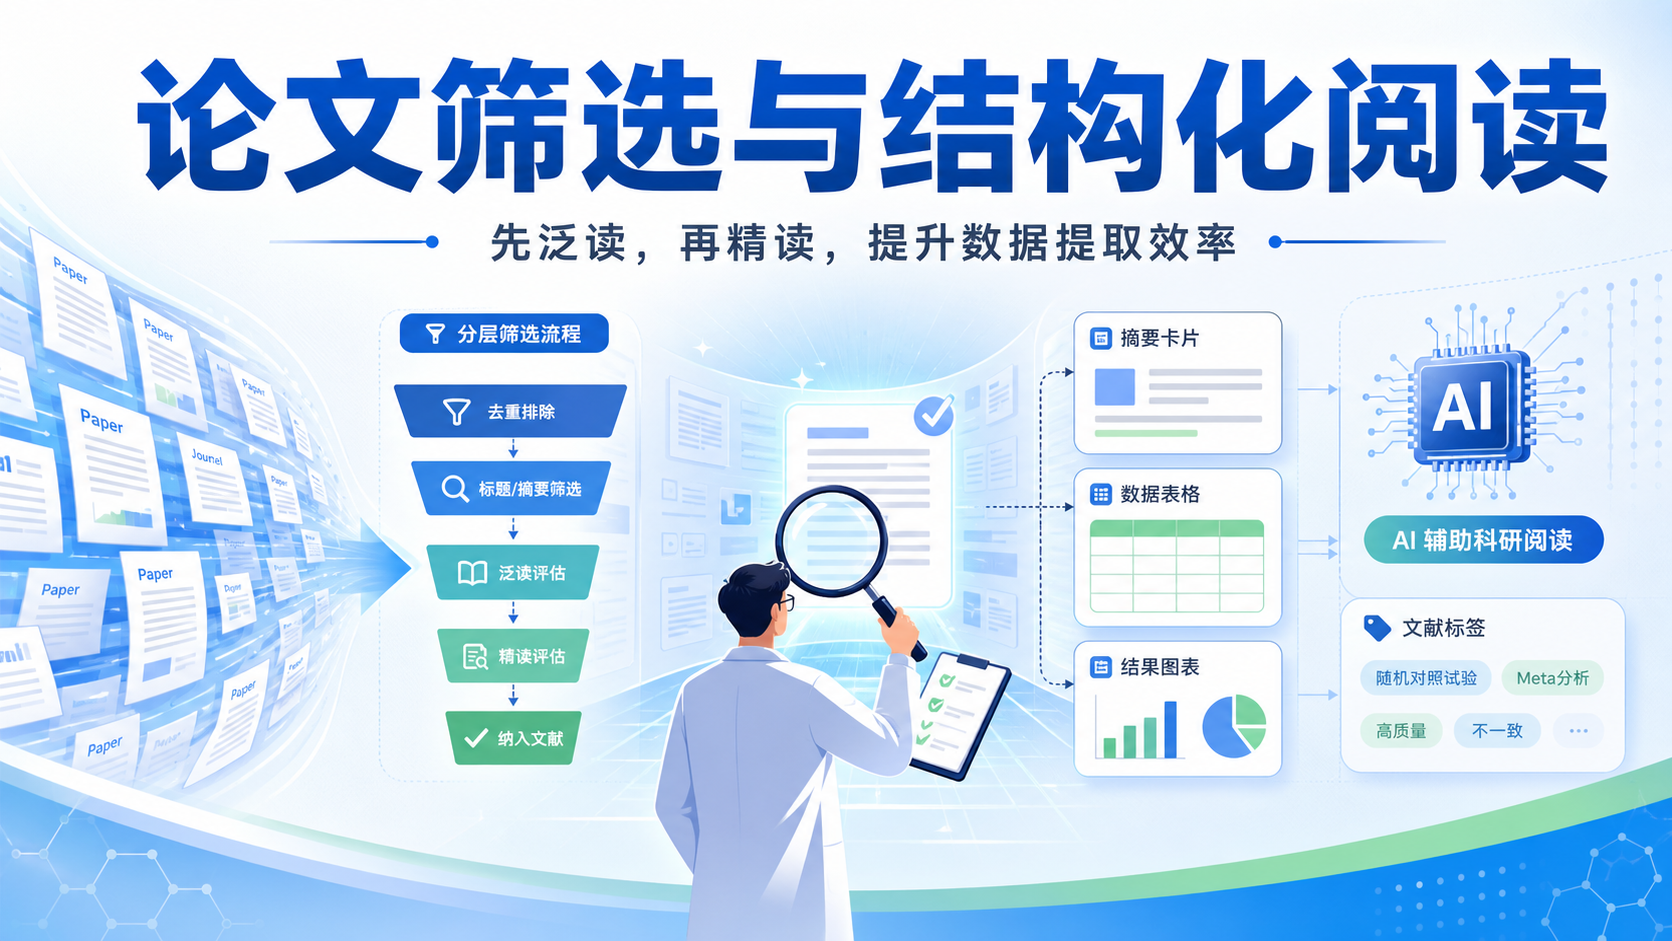
文献泛读的核心,不是把全文每一句都吃透,而是快速判断这篇文章值不值得精读。对医学生、医生和科研人员来说,时间成本很高,泛读的任务是建立筛选机制。
一篇文章只要完成3件事,就算泛读有效。
- 看懂研究问题。
- 判断研究设计。
- 找到是否和自己的课题相关。
如果这3步都做不到,直接进入精读,往往只会增加认知负担。
1.2 AI能提升泛读效率,但不能替代判断
AI适合做信息提取和初步归纳。它能帮助你把标题、摘要、结果小标题、图注等内容拆开,形成结构化信息。但AI输出不是结论本身,人的判断仍然是最后一步。
知识库中提到,一次性上传整篇文献,效果通常不理想。原因很简单。模型容易漏掉细节,也容易把不同部分混在一起。更稳妥的方法是分段输入,按标题、摘要、引言、结果、讨论、图注和方法逐步处理。这样更接近真实的文献阅读流程。
1.3 泛读到精读的切换点
泛读不是终点。它的价值在于筛选。
当你发现以下情况,就应该进入精读:
- 研究问题和你的课题高度相关。
- 核心机制有可迁移价值。
- 实验设计或统计方法值得借鉴。
- 结论可能影响你的研究假设。
能否进入精读,取决于文章是否有“复用价值”。
这一步做对了,后面的阅读效率会明显提升。
2. AI辅助拆解文献的核心框架
2.1 先拆关键要素,再谈全文理解
文献拆解的第一步,是抓关键要素。知识库中把它分为疾病、表型、主变量、交互变量、效应变量和机制模式。这个顺序非常重要,因为它决定了你能否快速建立文章的主线。
例如,若文献中涉及A分子、B分子和C分子,就要先判断:
- 谁是研究对象。
- 谁是干预变量。
- 谁是结果变量。
- 是否存在直接交互或间接交互。
先识别变量关系,再理解机制叙事,阅读速度会快很多。
2.2 用“二元、三元关系”理解机制链条
很多新手看机制图时,容易被分子名淹没。其实可以用关系结构去读。
常见结构包括:
- 二元关系:A影响B。
- 三元关系:A通过C影响B。
- 直接交互:分子之间存在结合或直接作用。
- 间接交互:通过中介分子或信号通路实现。
这种拆法的优势是,你不需要先背住所有名词。你只要先确认“谁影响谁”,再确认“如何影响”,文章逻辑就会逐层展开。
2.3 结构化输入,比整篇喂给AI更有效
知识库明确指出,语言模型的表现,取决于输入质量。输入越清晰,一一对应关系越强,输出越稳定。
因此,建议采用分步输入法:
- 先输入标题和摘要。
- 再输入引言。
- 然后输入结果小标题和图注。
- 最后输入方法与讨论。
不要指望一次输入整篇文章就获得高质量拆解。
更好的方式是把文献拆成模块,再让AI分别处理。
3. 从泛读到精读的标准流程
3.1 第一步,翻译并提取标题和摘要
标题和摘要是泛读入口。它们决定这篇文章是否值得继续读。AI在这里最适合做两件事:翻译和提炼。
你可以要求AI输出:
- 研究对象。
- 研究目的。
- 主要方法。
- 核心结果。
- 结论指向。
这样做的目的,不是得到完整复述,而是迅速建立文章轮廓。摘要不是全文的替代品,但它是精读决策的第一道筛选器。
3.2 第二步,拆引言,找知识背景和科学假设
引言部分通常回答两个问题:为什么做,想证明什么。
对于精读来说,引言的价值在于提取知识背景和科学假设。
建议重点看:
- 该领域当前缺口是什么。
- 作者为什么选择这个问题。
- 文章假设是否清楚。
- 研究设计是否能支撑假设。
如果引言逻辑不清,后面的结果和讨论再丰富,也可能只是“数据堆积”,不一定是真正有力的论证。
3.3 第三步,按结果和图注读证据链
结果部分是精读的核心。知识库中特别强调,数据解读要抓住图注原文、图注小标题、结果小标题、大图和小图之间的对应关系。
这一点非常关键,因为很多信息并不写在正文里,而是藏在图和图注中。
建议按以下顺序拆:
- 结果小标题。
- 对应图的标题。
- 每个小图展示了什么。
- 这些数据支持了哪一步结论。
- 这一步是否真的排除了替代解释。
一篇文章是否站得住,关键看证据链是否闭合。
4. 精读时要重点关注的8个维度
4.1 关键要素是否完整
一篇拆解好的文献,通常可归纳为8个部分。知识库给出的框架很适合科研训练:
- 关键要素。
- 科学假设。
- 逻辑关系。
- 知识背景。
- 研究流程。
- 数据解读。
- 论证规范。
- 套路归纳。
这8项不是机械模板,而是帮助你从“看懂字面”升级到“看懂研究逻辑”。
4.2 研究流程是否可复制
对科研人员而言,最重要的是方法是否可复制。
精读时要关注:
- 样本量是否合理。
- 分组是否清晰。
- 对照是否充分。
- 统计方法是否匹配。
- 实验步骤是否能落地。
如果流程描述过于粗略,或者关键参数缺失,文章的可复用性就会下降。
4.3 论证是否规范
知识库提到,论证规范包括分子和表型相关性论证、单变量论证、二元和三元交互论证、位点鉴定论证等。
这部分非常适合训练批判性思维。
你要问的是:
- 作者是否只做了相关性,没有做因果推断。
- 是否存在样本偏倚。
- 是否有多重比较问题。
- 结论是否超出了数据支持范围。
能提出这些问题,说明你已经从“读内容”进入“读证据”。
5. 如何把AI真正用在文献阅读方法上
5.1 分段输入,降低信息噪音
AI最怕的不是问题难,而是输入乱。
如果一次性给它整篇文献,常常会出现漏译、乱序、概括过度等问题。更稳妥的做法是把文献拆成小块,让每次输入只对应一个任务。
推荐顺序是:
- 标题。
- 摘要。
- 引言。
- 结果。
- 讨论。
- 图注。
- 方法。
这样做的好处是,输出更稳定,也更便于你做笔记和二次整合。
5.2 让AI做“辅助拆解”,不是“替代理解”
AI可以帮你快速完成翻译、摘要压缩、结构提取和关键词归类。但真正的学术判断,必须由人完成。
尤其是涉及研究创新性、证据强度和方法学漏洞时,不能只看AI总结。
你可以把AI当成:
- 初级整理员。
- 结构归纳器。
- 术语翻译助手。
- 阅读提速工具。
但不要把它当成唯一答案来源。
5.3 用解螺旋做系统化训练
如果你希望把这种拆解方法变成稳定能力,而不是偶尔灵感,解螺旋可以提供更系统的训练路径。它更适合用来做文献拆解模板、模块化精读和AI辅助学习的流程化实践。
把方法学训练做成固定动作,才能真正从新手走向熟手。
总结Conclusion
文献阅读方法的核心,不是“看得多”,而是“拆得准”。泛读负责筛选,精读负责验证。AI可以显著提高文献拆解效率,但前提是分段输入、结构化提问、逐层判断。对于医学生、医生和科研人员来说,最有效的路线不是一次读完,而是先建立关键要素,再进入证据链和论证规范。如果你想把文献阅读从低效重复,升级为可复制的学术能力,建议借助解螺旋建立标准化拆解流程。
- 引言Introduction
- 1. 文献泛读为什么是精读的前提
- 2. AI辅助拆解文献的核心框架
- 3. 从泛读到精读的标准流程
- 4. 精读时要重点关注的8个维度
- 5. 如何把AI真正用在文献阅读方法上
- 总结Conclusion