165
 分享
引言Introduction
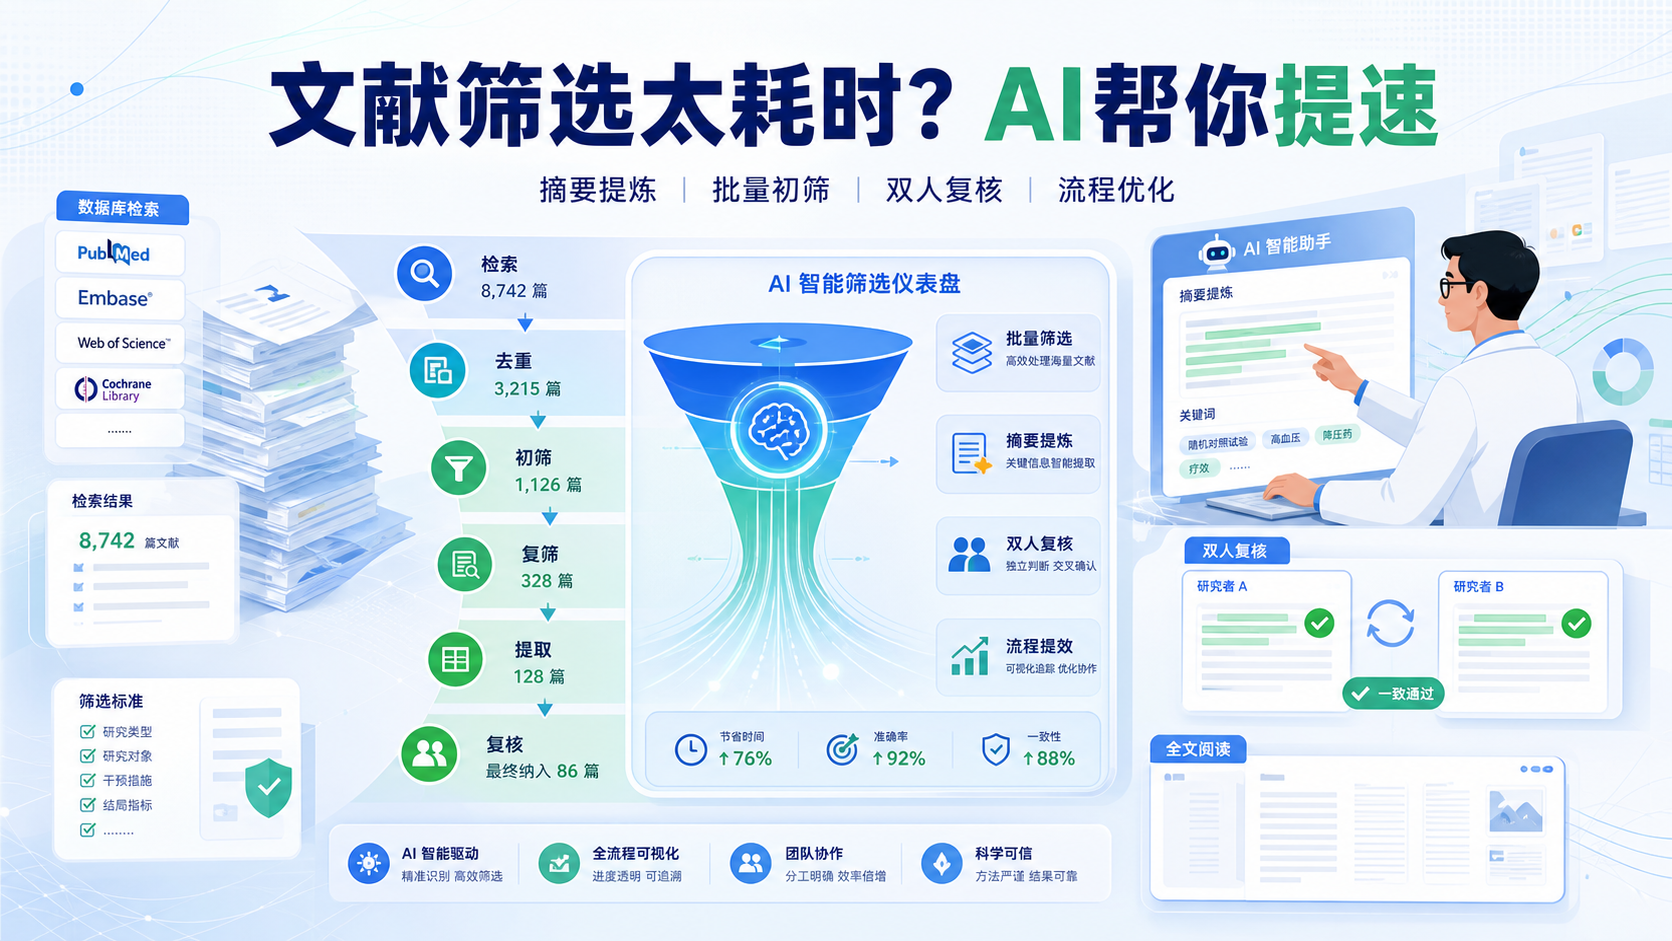
文献越查越多,筛选却越做越慢。标题、摘要、全文反复切换,双人独立筛选、冲突处理、数据提取,往往把综述和Meta分析的时间耗在最前面。AI辅助筛选的价值,不是替代研究者,而是把重复劳动压缩到可控范围。
1. 文献筛选为什么最耗时
1.1 从检索到纳入,步骤天然冗长
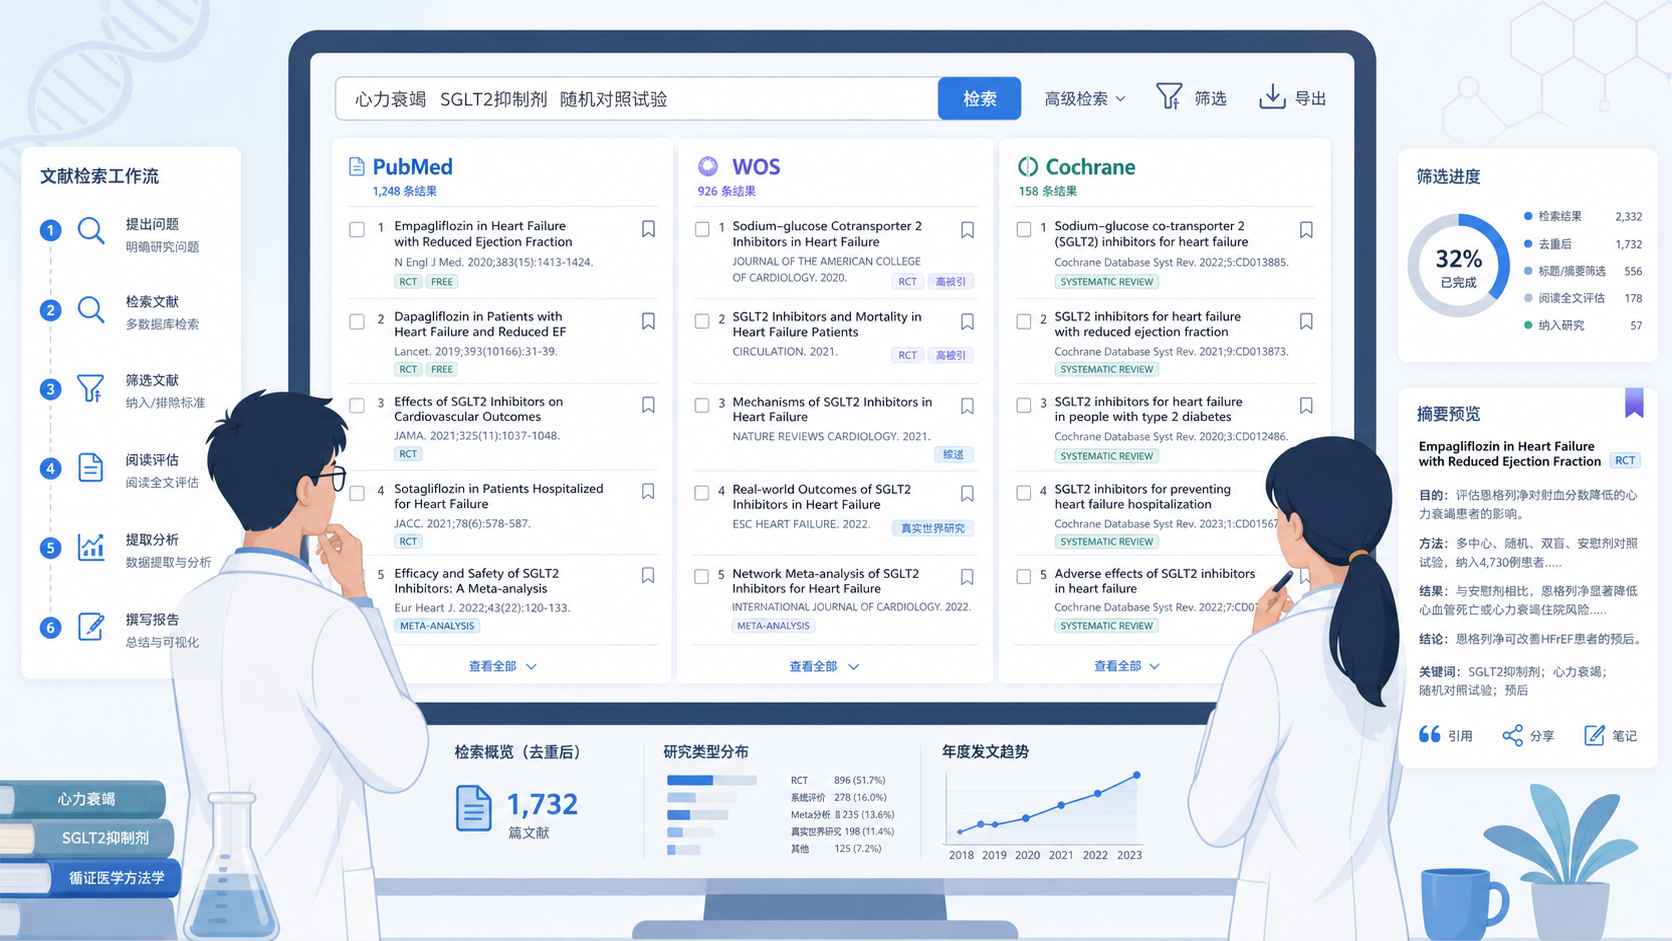
系统综述通常先检索多个数据库,如 PubMed、WOS、Cochrane Library。
这些来源合并后会出现大量重复文献。随后还要按纳排标准做初筛和精筛。
传统流程的核心问题,是信息密度低,但判断次数极多。
研究者需要在标题、摘要、全文之间来回切换。每一步都要记录理由,保证可追溯。
1.2 双人独立筛选是质量要求,也是时间成本
规范流程通常要求双人独立筛选,并记录冲突解决过程。
这能减少遗漏和主观偏差,但也意味着同一批文献要被重复阅读至少两遍。
在实际工作中,最耗时的环节往往不是写结果,而是筛文献。
尤其在纳入文献较多时,人工初筛很容易成为项目瓶颈。
2. AI如何提升批量筛选效率
2.1 先做摘要级信息提炼
AI最适合先处理“高重复、低创造”的步骤。
在综述写作中,可以把每篇文章摘要交给模型,要求它用固定格式输出核心信息。
常见做法是让 AI 严格生成三句话。
分别概括以下内容。
- 核心贡献。
- 研究方法。
- 主要结论。
这种方式本质上是把摘要阅读技巧标准化。
它不替代判断,但能帮助研究者快速把握文章是否值得进入下一轮全文筛查。
2.2 批量提取比逐篇阅读更适合初筛前置
经验丰富的研究者提取一篇文章的关键信息,可能需要接近 1 小时。
AI 可以同时处理多篇文献,大幅减少前期人工耗时。
但这里有一个原则必须坚持。
AI负责提速,人工负责复核。
尤其是研究结局、干预方式、样本量、随访时间、统计指标这类信息,不能直接跳过人工核对。
否则很容易把摘要中的表述误当作全文结论。
2.3 适合批量提取的内容有哪些
对综述和 Meta 分析来说,AI最适合先抽取结构化信息。
例如:
- 研究类型。
- 研究对象。
- 干预措施。
- 对照组设置。
- 主要结局指标。
- 随访时长。
- 样本量。
- 主要结果方向。
先把信息做成表格,再进入精筛,效率通常更高。
这样可以快速判断哪些研究与纳入标准一致,哪些明显不相关。
3. 高效筛选的实战流程
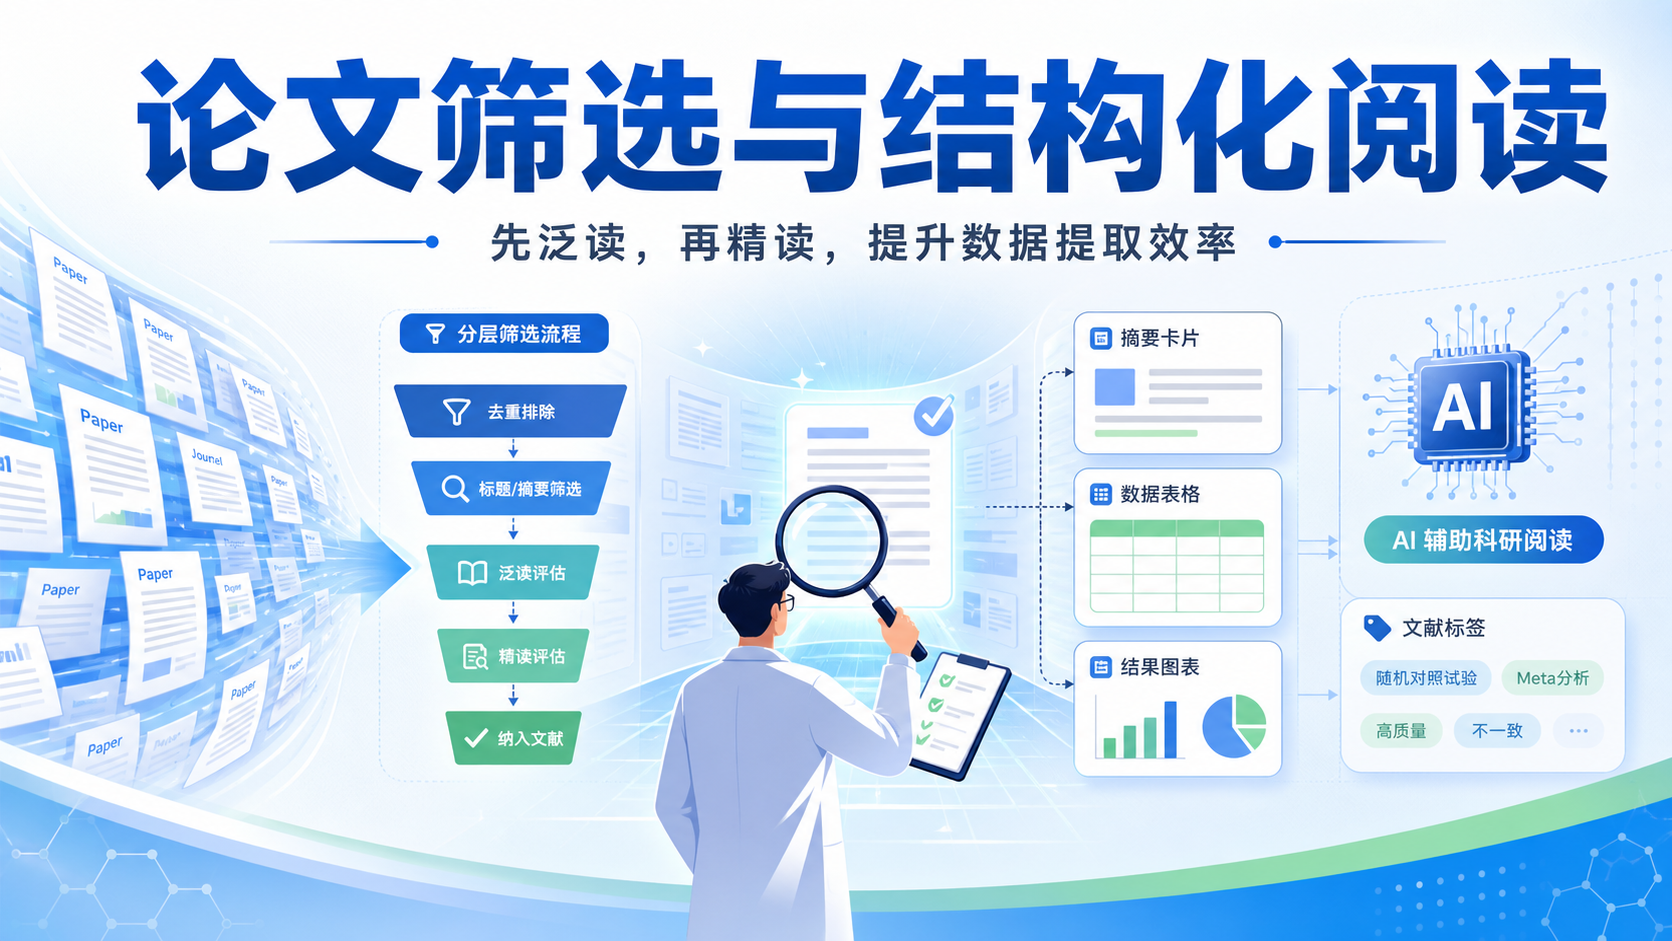
3.1 第一步,先去重,再初筛
多数据库检索后,第一步应先合并并去重。
否则同一篇文章会反复出现在结果列表里,徒增工作量。
随后进入标题和摘要初筛。
这一阶段的目标不是“做结论”,而是“快速排除明显不相关文献”。
3.2 第二步,按纳排标准做全文复筛
初筛通过后,再进入全文阅读。
此时重点不再是主题相关,而是是否满足纳入标准。
常见判断点包括:
- 研究设计是否符合要求。
- 结局指标是否可提取。
- 是否存在重复样本。
- 是否为真实发表的研究。
- 数据是否足够用于后续分析。
全文复筛才是最终质量控制环节。
AI可以帮助定位关键信息,但不能替代研究者对纳排标准的最终判断。
3.3 第三步,双人独立提取并复核
数据提取同样耗时。
从全文中摘出所有关注的 outcomes,并整理成标准表格,往往比预想更费力。
因此更合理的做法是先由 AI 批量提取,再由两名研究者独立核对。
发现冲突后再讨论解决。
这种流程兼顾效率和可靠性。
对医学生、医生和科研人员来说,尤其适合需要在限定时间内完成高质量综述的场景。
4. 让AI真正可用的关键设置
4.1 输出格式要固定
如果没有统一格式,AI提取结果很容易失真。
建议在提示词中明确要求固定字段,比如研究设计、样本量、干预、结局、结论。
格式越固定,越利于后续建表和人工复核。
对于大批量文献,这一点非常重要。
4.2 先看摘要,再看全文
很多人想直接让 AI 总结全文,但这不一定最高效。
更稳妥的策略是先用标题和摘要做第一轮判断,再把保留文献上传全文复筛。
原因很简单。
摘要适合快速判断相关性,全文适合核对细节。
两者分工不同,混在一起反而容易浪费时间。
4.3 不能把AI当作最终证据
AI 可以帮助你更快找到线索。
但它不是证据本身。
在文献筛选中,最终依据仍然是原始论文、纳排标准和人工复核。
尤其是涉及医学结论时,任何自动化结果都必须回到原文验证。
5. 常见误区与纠正方法
5.1 误区一,摘要看懂了就等于全文合格
摘要通常只呈现作者想强调的重点。
它不一定包含所有排除信息。
所以,摘要只能用于初筛,不应直接代替全文判断。
这是系统综述和Meta分析里最常见的误区之一。
5.2 误区二,AI提取结果可以直接入表
AI输出看起来整齐,不代表完全准确。
它可能漏掉次要结局,也可能把对照组或样本量识别错。
因此应建立一个简单的复核习惯。
先看是否与全文一致,再决定是否纳入正式数据库。
5.3 误区三,筛选越快越好
效率重要,但不能牺牲规范性。
文献筛选的目标是“快且准”,不是单纯求快。
真正高质量的流程,是用AI减少重复劳动,把人力集中到关键判断上。
这才符合科研工作的基本逻辑。
6. 解螺旋如何帮助你把流程跑顺
如果你希望把上述流程真正落地,关键不只是工具本身,而是工具是否贴合综述工作流。
解螺旋可以支持先按标题摘要进行初筛,再上传全文进行复筛,帮助研究者把筛选流程拆成更清晰的两步。
同时,围绕文献摘要提炼、批量信息整理、全文复核,解螺旋更适合用来承接“先提速、再复核”的工作模式。
这能减少重复阅读,提高筛选一致性,也更方便后续做数据提取和表格整理。
总结Conclusion
AI辅助文献筛选的核心,不是替代研究者,而是把最耗时的重复工作前置处理。
对于系统综述和 Meta 分析,最实用的策略是先做去重,再用标题摘要初筛,之后进入全文复筛,并坚持双人独立核对。
把摘要阅读技巧标准化,把关键信息批量提取出来,才能真正提升效率,同时守住科研质量。
如果你正在处理大量文献,想让筛选、提取、复核更高效,可以尝试用解螺旋把流程标准化。
让AI做重复劳动,让研究者做最终判断。
- 引言Introduction
- 1. 文献筛选为什么最耗时
- 2. AI如何提升批量筛选效率
- 3. 高效筛选的实战流程
- 4. 让AI真正可用的关键设置
- 5. 常见误区与纠正方法
- 6. 解螺旋如何帮助你把流程跑顺
- 总结Conclusion