134
 分享

引言Introduction
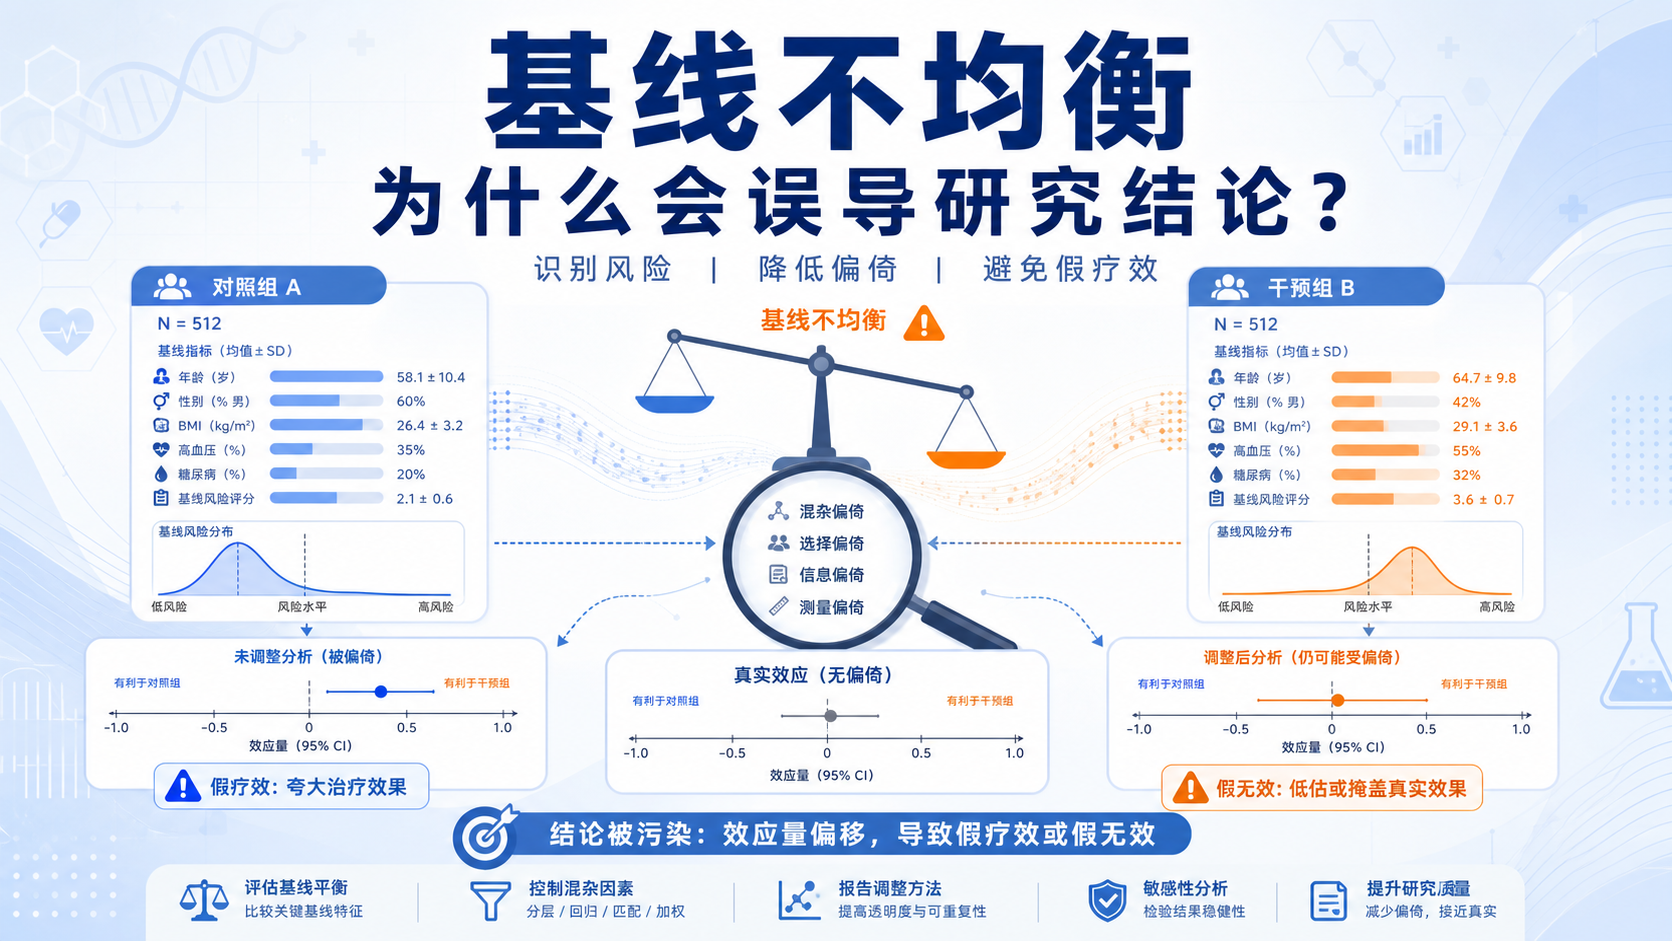
基线不均衡案例是临床研究中最常见、也最容易被忽视的问题之一。它会直接影响组间可比性,进而干扰疗效判断、偏倚结论,甚至影响论文发表。如果你正在写临床研究论文,或整理随机/观察性研究结果,先看懂基线不均衡案例,往往比后续补救更重要。

1. 为什么要重视基线不均衡案例
1.1 基线是什么,为什么它决定可比性
在临床研究语境中,基线通常指研究对象在接受干预前的“0”时刻状态。它是随访的起点,也是判断两组是否可比的基础。基线信息不只是人口学变量,还包括临床特征、实验室指标、疾病史和用药史。
如果基线已经偏斜,后续观察到的结局差异,就未必真由干预导致。对医学生、医生和科研人员来说,理解这一点非常关键。因为很多“有效”或“无效”的结论,问题并不在终点,而在起点。
1.2 基线不均衡案例常见于哪些研究
基线信息通常需要在入组后、干预前进行描述和比较。常见场景包括:
- 干预性研究,按试验组和对照组分组。
- 观察性研究,按暴露因素分组。
- 回顾性研究,按结局分病例组和对照组。
不同设计的分组逻辑不同,但核心目标一致,都是先判断研究对象在起点是否均衡。 这也是基线不均衡案例必须被单独讨论的原因。
2. 3类基线不均衡案例,分别怎么识别
2.1 第一类:连续变量不均衡
连续变量最常见,比如年龄、BMI、血压、实验室指标等。描述时通常用均数±标准差,或中位数和四分位数间距。两组比较时,可用 t 检验或 Wilcoxon 秩和检验;三组及以上可用方差分析或 Kruskal-Wallis 检验。
如果一组均值明显更高,或分布偏态差异大,就属于典型的连续变量基线不均衡案例。 例如高龄组本身合并症更多,结局风险也更高,这类差异会直接放大混杂。
2.2 第二类:分类变量不均衡
分类变量包括性别、吸烟史、糖尿病史、分期、用药情况等。通常用频数和百分比描述,组间比较多用卡方检验。
这类基线不均衡案例常出现在小样本研究中。比如某组男性占比远高于另一组,或者某组既往合并症明显更多。看似只是比例差异,实际会改变事件发生率和治疗反应。
如果分类变量分布严重偏斜,后续结局差异就不能直接归因于干预。
2.3 第三类:多变量联合不均衡
临床上最棘手的,往往不是单一变量不平衡,而是多个变量同时偏斜。比如某组年龄更大、合并症更多、病情更重,另一组则基础状态更好。单看每个变量,差异可能都不极端,但联合起来就会形成系统性偏倚。
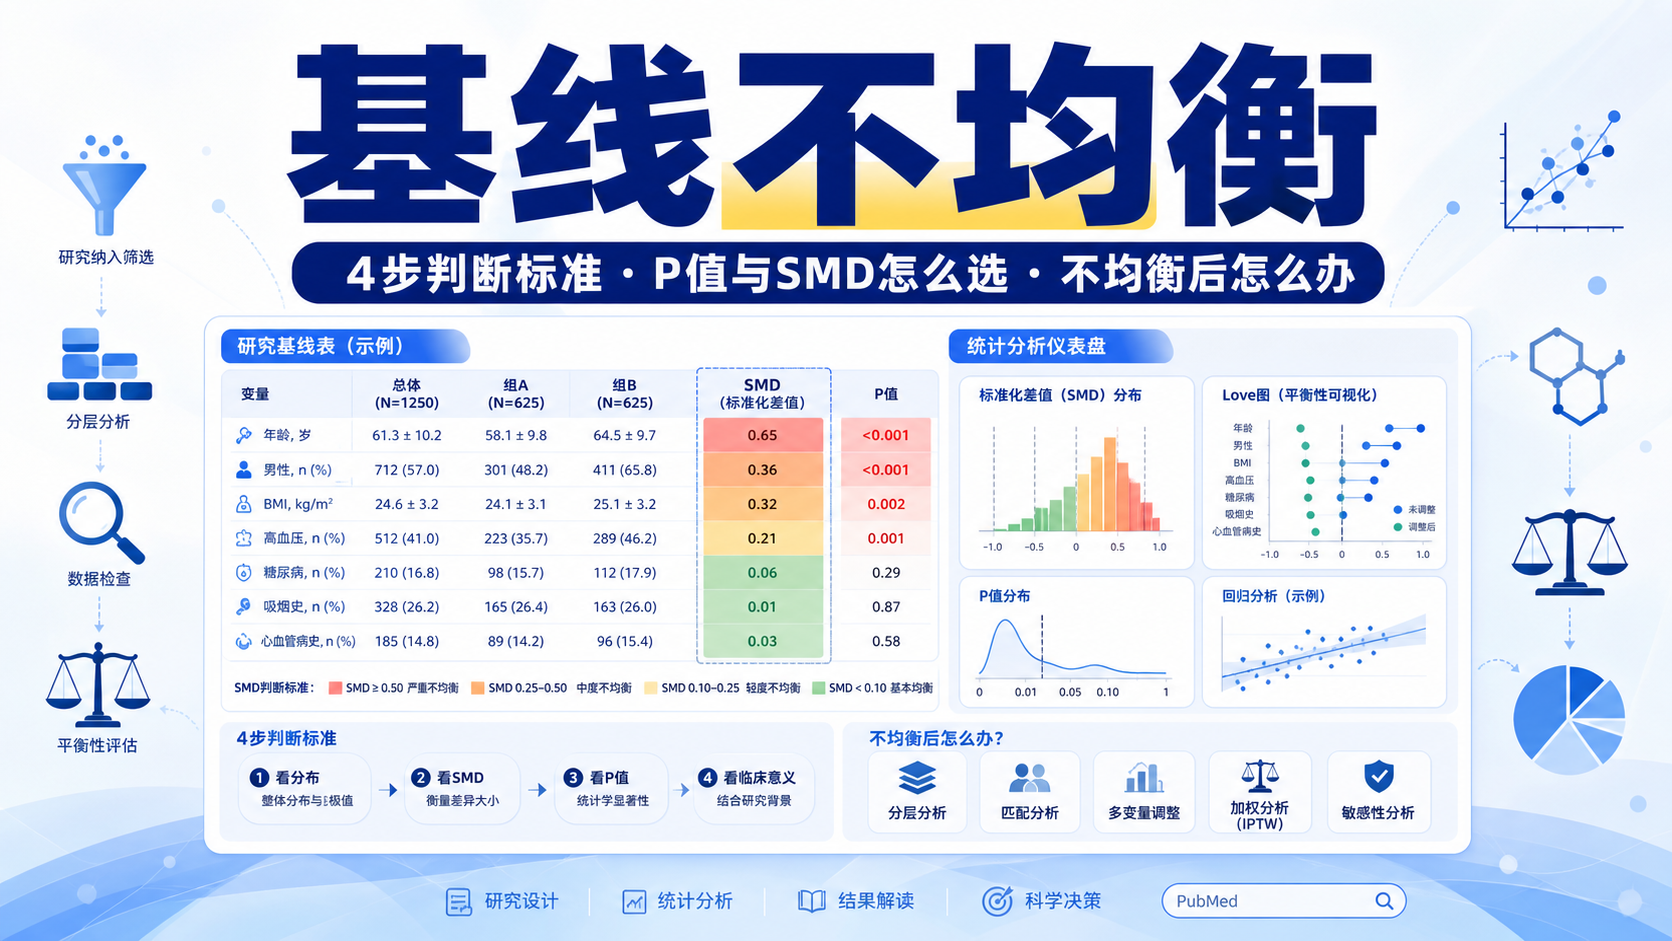
这类基线不均衡案例最容易误导结论。 因为它不只影响一个指标,而是影响整个风险结构。传统 P 值有时会在大样本下出现“显著”,但真正需要关注的是差异方向和幅度,而不是只看是否超过 0.05。
3. 发现基线不均衡案例后,临床如何应对
3.1 先判断:是随机误差,还是结构性偏倚
面对基线不均衡案例,第一步不是急着下结论,而是先判断差异来源。随机对照研究中,小样本下偶然失衡并不少见;观察性研究中,则更常见选择偏倚和混杂偏倚。
判断重点有两个。
- 差异是否集中在关键预后变量上。
- 差异是否会影响主要结局解释。
如果只是轻度差异,且不在关键协变量上,通常可在结果解释中说明。但如果是核心预后因素,就必须做进一步调整。
3.2 用合适的统计方法校正
对基线不均衡案例,常见处理方式包括:
- 多因素回归调整。
- 倾向评分匹配、加权或分层。
- 敏感性分析。
- 必要时进行亚组分析。
对连续变量和分类变量,不能只依赖单一 P 值判断均衡性。大样本时,P 值容易把很小的差异也判成显著。此时更推荐看标化差值。绝对值超过 10,通常提示差异达到需要关注的程度。
3.3 在论文中怎么写,才更规范
如果已出现基线不均衡案例,论文结果部分应清楚交代。可按以下逻辑写:
- 先报告纳入和排除过程。
- 再展示基线特征表。
- 说明哪些变量存在组间差异。
- 解释这些差异对结局分析的影响。
- 在统计方法中交代校正方案。
不要回避不均衡。真正专业的写法,是把问题说清楚,再说明你如何控制它。 这比只给出一张“看起来整齐”的表格更符合 E-E-A-T 原则。
4. 基线表制作中,最容易踩的3个坑
4.1 只看P值,不看实际差异
这是最常见的错误。P 值能告诉你差异是否存在,但不能告诉你差异有多大。尤其在大样本中,微小差别也可能显著。
4.2 连续变量和分类变量混用统计口径
不同变量要用不同描述方法。连续变量可用均数±标准差或中位数。分类变量则要用频数和百分比。口径不统一,会让基线不均衡案例的判断失真。
4.3 忽视纳入排除的层次统计
基线信息不仅包括组间比较,还包括入排过程。应按层次排除法统计每个排除标准对应的人数和百分比,避免合计与实际人数不一致。这个细节看似简单,却直接影响研究的可信度。
5. 实战建议:把基线不均衡案例变成可控问题
5.1 先做标准化的基线表
建议优先使用规范化流程,把纳入排除图和基线特征表一起完成。流程图负责交代样本来源,基线表负责交代组间差异。两者结合,才是完整的临床研究起点。
5.2 对关键变量提前设定调整策略
在方案阶段就应明确哪些变量属于核心混杂因素。这样即使后期出现基线不均衡案例,也能快速进入建模或匹配流程,而不是临时补救。
5.3 借助工具提高一致性
在实际论文写作中,手工整理基线表容易出错。使用规范化工具,可快速完成分组统计、表格导出和结果整理,减少重复劳动,也更方便留痕和复核。对临床科研团队来说,解螺旋这类工具的价值,不只是提速,更是把基线不均衡案例的识别、统计和呈现流程标准化。 这样可以更快得到结构清晰的基线表,及时发现问题变量,并为后续回归、匹配或敏感性分析留出空间。
总结Conclusion
基线不均衡案例并不可怕,可怕的是没有发现、不会解释、也不会处理。临床研究中,连续变量不均衡、分类变量不均衡、多变量联合不均衡,是最常见的3类情况。应对时,关键是先判断差异性质,再选择回归、倾向评分或敏感性分析进行校正。真正高质量的论文,不是看起来“完全平衡”,而是能清楚说明不平衡,并用规范方法控制偏倚。

- 引言Introduction
- 1. 为什么要重视基线不均衡案例
- 2. 3类基线不均衡案例,分别怎么识别
- 3. 发现基线不均衡案例后,临床如何应对
- 4. 基线表制作中,最容易踩的3个坑
- 5. 实战建议:把基线不均衡案例变成可控问题
- 总结Conclusion