120
 分享
引言Introduction

基线不均衡后果 ,是临床研究、真实世界研究和药物评价中最容易被低估的问题之一。表面上看,组间差异只是起点不同;实际上,它可能直接把“治疗有效”误导成“人群更轻”,或者把“方案无效”误判为“样本选择偏差”。对医学生、医生和科研人员来说,理解这一问题,是读懂证据和避免错误推断的前提。
1. 什么是基线不均衡后果
1.1 基线不均衡不是简单的“起点不同”
基线不均衡,指研究开始时,比较组在年龄、疾病严重度、既往治疗、合并症、实验室指标等关键变量上存在系统差异。当这些差异与结局本身相关时,后续观察到的结果就可能被混杂。
例如,一组患者入组时病情更轻,另一组更重。即使后者接受了更强的干预,最终结局仍可能更差。此时,差的未必是治疗,而可能是起点不同。
1.2 后果在于“结论被污染”
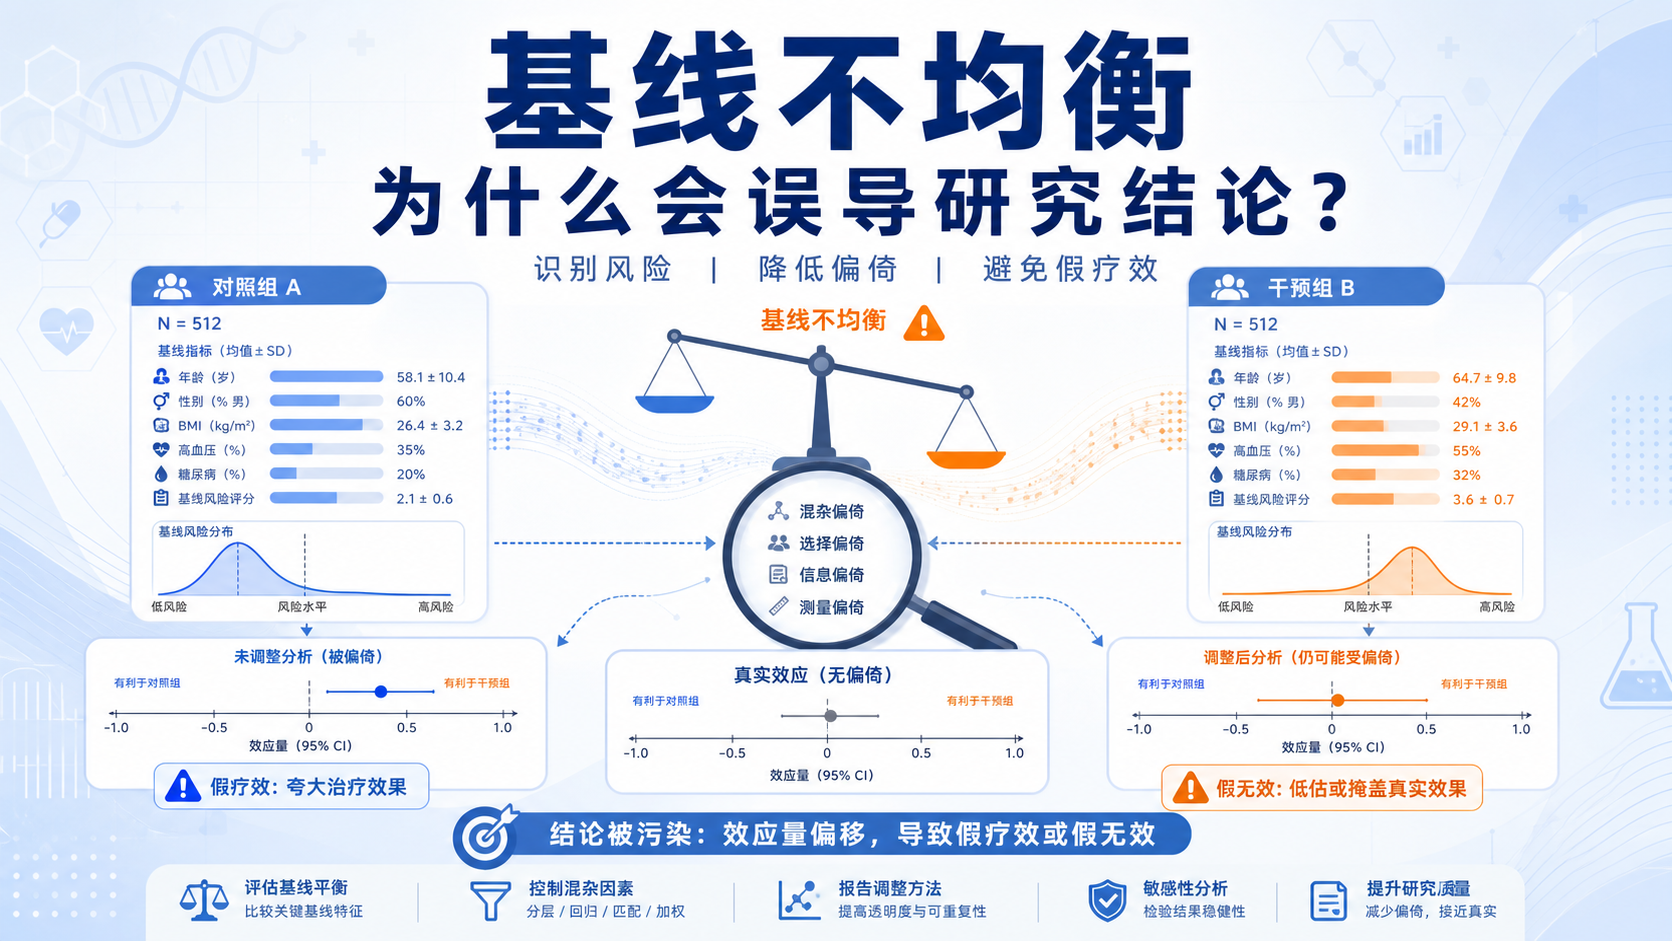
基线不均衡后果的核心,不是数据看起来不整齐,而是因果解释被削弱。 研究者看到的组间差异,可能混入了基线差异带来的影响。
这会带来两类常见错误。第一,把基线更优的一组误认为疗效更好。第二,把真正有效的干预,因为对照组基线更差而低估效果。两种情况都会让结论偏离真实。
2. 为什么基线不均衡会误导结论
2.1 它会制造“假疗效”或“假无效”
如果干预组患者本来更年轻、病程更短、合并症更少,结局改善可能主要来自这些优势,而不是干预本身。这时看到的疗效,可能只是基线优势的投影。
反过来,如果干预组纳入了更多高危患者,即使治疗有真实获益,也可能被基线劣势掩盖。研究结果会显得“不显著”或“效果有限”。这就是基线不均衡后果 最典型的误导机制。
2.2 它会放大混杂偏倚
在非随机研究中,分组往往不是随机发生的。医生会根据病情选择方案,患者也会因自身条件进入不同组。这样一来,分组变量和结局变量之间就可能同时受到第三因素影响。
基线不均衡后果 因此常与混杂偏倚同时出现。若不进行校正,统计显著并不等于因果成立。尤其在样本量较小、事件数较少时,一个基线变量的轻微差异,都可能明显改变效应估计。
2.3 它会改变效应量和置信区间
基线差异不仅影响P值,还会影响效应量。比如,某组初始风险更高,其绝对风险下降空间更大,容易出现“看上去获益更多”的现象。相反,若基线较低,天花板效应会让改善幅度被压缩。
因此,基线不均衡后果 并不只是“统计上不好看”,而是会让效应量方向、大小和不确定性都发生变化。对于临床决策,这比单纯的显著性更重要。
3. 哪些研究场景最容易出现误导
3.1 回顾性研究和真实世界研究
回顾性研究依赖既有数据,分组无法控制。真实世界研究虽然更贴近临床,但也更容易出现选择偏倚。基线不均衡后果 在这类研究中尤其常见。
常见问题包括:
- 高危患者更容易进入某种治疗组。
- 医疗资源差异导致分组不均。
- 数据缺失使某些变量被系统性排除。
这些因素都会让结论失真。
3.2 小样本随机对照试验
随机化能降低偏倚,但不能保证每个基线变量都完全平衡。样本量小的时候,随机分配后的组间差异可能依然明显。此时,如果不做基线检验和必要调整,基线不均衡后果 仍可能出现。
尤其在单中心、小样本、亚组分析中,这种风险更高。研究者不能因为“随机了”就忽视基线。
3.3 亚组分析和多终点研究
亚组分析本身就会缩小样本量,增加偶然不平衡的概率。多终点研究则容易让研究者挑选“看起来最好”的结果,进一步放大偏差。基线不均衡后果 在这类情境下,常表现为结论不稳定、重复性差。
4. 如何识别基线不均衡带来的风险
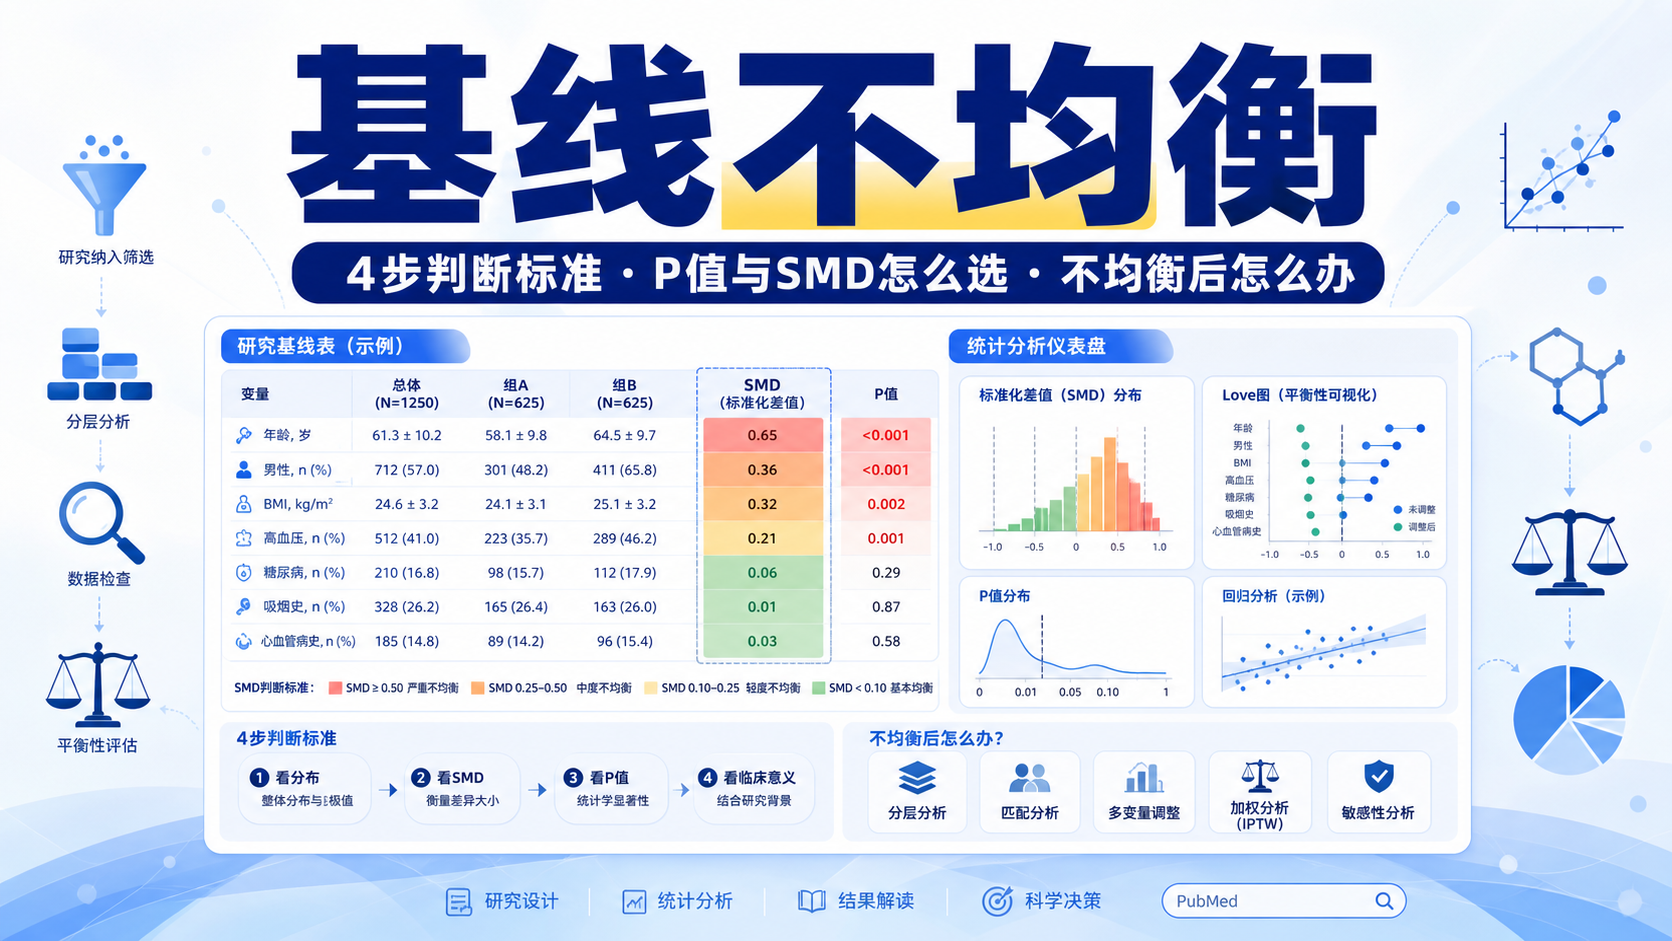
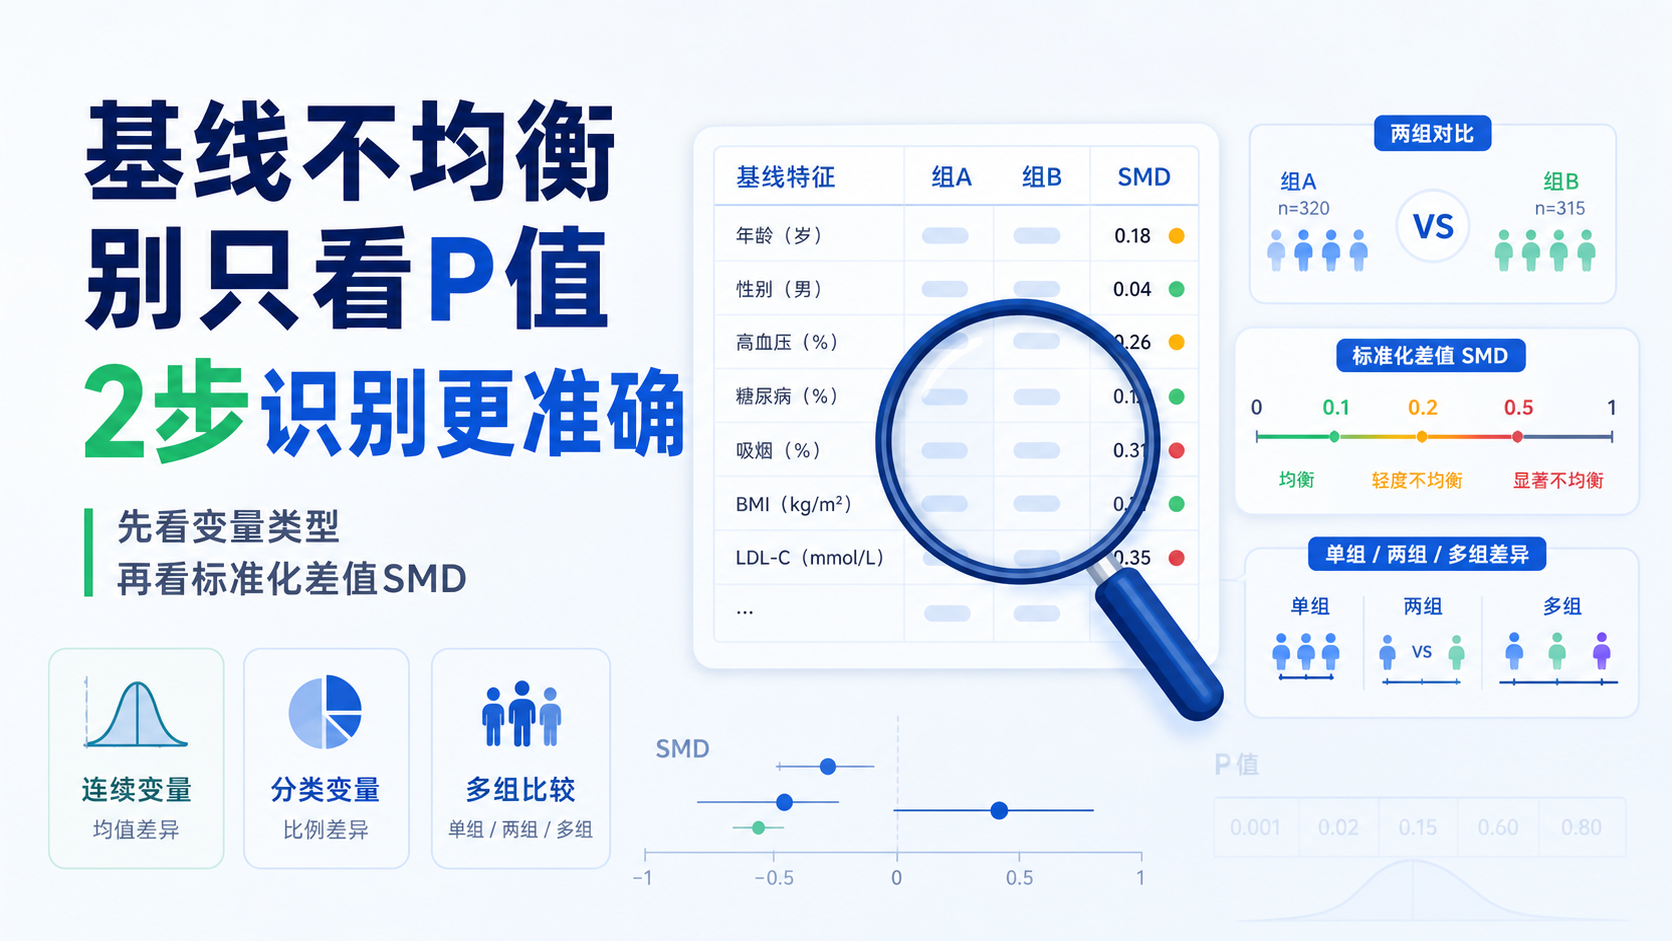
4.1 先看关键变量,而不是只看P值
很多研究会列出基线表,但只看“有没有统计学差异”是不够的。样本量足够大时,微小差异也可能显著;样本量很小时,重要差异又可能不显著。
更合理的做法是优先关注与结局强相关的变量,例如:
- 年龄
- 疾病严重程度
- 合并症负担
- 既往治疗史
- 关键实验室指标
如果这些变量不平衡,基线不均衡后果就需要高度警惕。
4.2 结合效应方向判断是否可疑
如果某组基线明显更好,且最终结局也更好,就要问一句:改善到底来自治疗,还是来自起点优势。相反,如果某组基线更差,但结局仍更优,干预效果可能反而被低估。
判断结论是否被误导,不能只看结果,还要看起点。
4.3 看研究是否做了调整
对于观察性研究,是否使用多变量回归、倾向评分匹配、逆概率加权等方法,是判断可信度的重要线索。对于随机试验,则要看是否进行了协变量调整、敏感性分析和缺失值处理。
没有校正的基线差异,往往意味着基线不均衡后果 尚未被控制。
5. 研究者如何降低误导风险
5.1 设计阶段尽量预防
最有效的方式,还是在设计阶段减少不均衡。常见策略包括:
- 随机化分配
- 分层随机
- 配对设计
- 限制入组标准
- 预先定义关键协变量
这些方法不能保证绝对平衡,但能显著降低系统性差异。
5.2 分析阶段做合理校正
若已经出现基线差异,不能简单忽略。应根据研究类型选择合适方法:
- 多因素回归,控制已知混杂。
- 倾向评分方法,改善组间可比性。
- 敏感性分析,检验结果稳健性。
- 缺失数据分析,避免选择性偏倚。
正确的统计处理,不能“消灭”不均衡,但可以减少它对结论的扭曲。
5.3 报告阶段保持透明
研究报告应完整呈现基线变量、样本流失、排除标准和统计调整方法。若存在明显差异,要明确说明其可能影响。透明报告本身,就是降低误导的一部分。
对审稿人和读者来说,最重要的是知道:结论是基于什么样的人群得出的,是否经得起偏倚检验。
6. 对临床阅读和科研实践的启示
6.1 读文献时要先问三个问题
面对一篇论文,建议先问:
- 分组是否可比。
- 关键基线是否平衡。
- 研究是否做了足够调整。
如果这三点答不清,结论就要保留。
6.2 做研究时要把“可比性”放在前面
很多研究失败,不是因为统计方法不够高级,而是起点就不公平。基线不均衡后果 提醒我们,研究设计不是附加项,而是证据质量的核心。
6.3 解螺旋如何帮助降低阅读和写作痛点
在科研写作、文献解读和课题汇报中,最难的往往不是找数据,而是判断数据是否可信。解螺旋品牌聚焦医学科研内容支持,可帮助用户把研究问题、基线比较、统计调整和结论表达梳理得更清楚。对于需要快速产出高质量综述、论文初稿或课题材料的医生和研究者,这类结构化支持能显著减少因理解偏差导致的误判。
总结Conclusion
基线不均衡后果之所以会误导结论,本质上是因为它破坏了组间可比性。 当起点不同,结局差异就不再能直接归因于干预本身。无论是回顾性研究、真实世界研究,还是小样本随机试验,研究者都应先看基线,再谈结论。
对临床和科研人员而言,真正严谨的做法,是从设计、分析到报告全流程控制偏倚。若你希望在文献解读、课题写作和医学内容产出中更高效地识别这类问题,可以关注解螺旋品牌,借助更系统的科研支持,把“看似有效”与“真正有效”区分开来。

- 引言Introduction
- 1. 什么是基线不均衡后果
- 2. 为什么基线不均衡会误导结论
- 3. 哪些研究场景最容易出现误导
- 4. 如何识别基线不均衡带来的风险
- 5. 研究者如何降低误导风险
- 6. 对临床阅读和科研实践的启示
- 总结Conclusion