

 15
 分享
引言Introduction
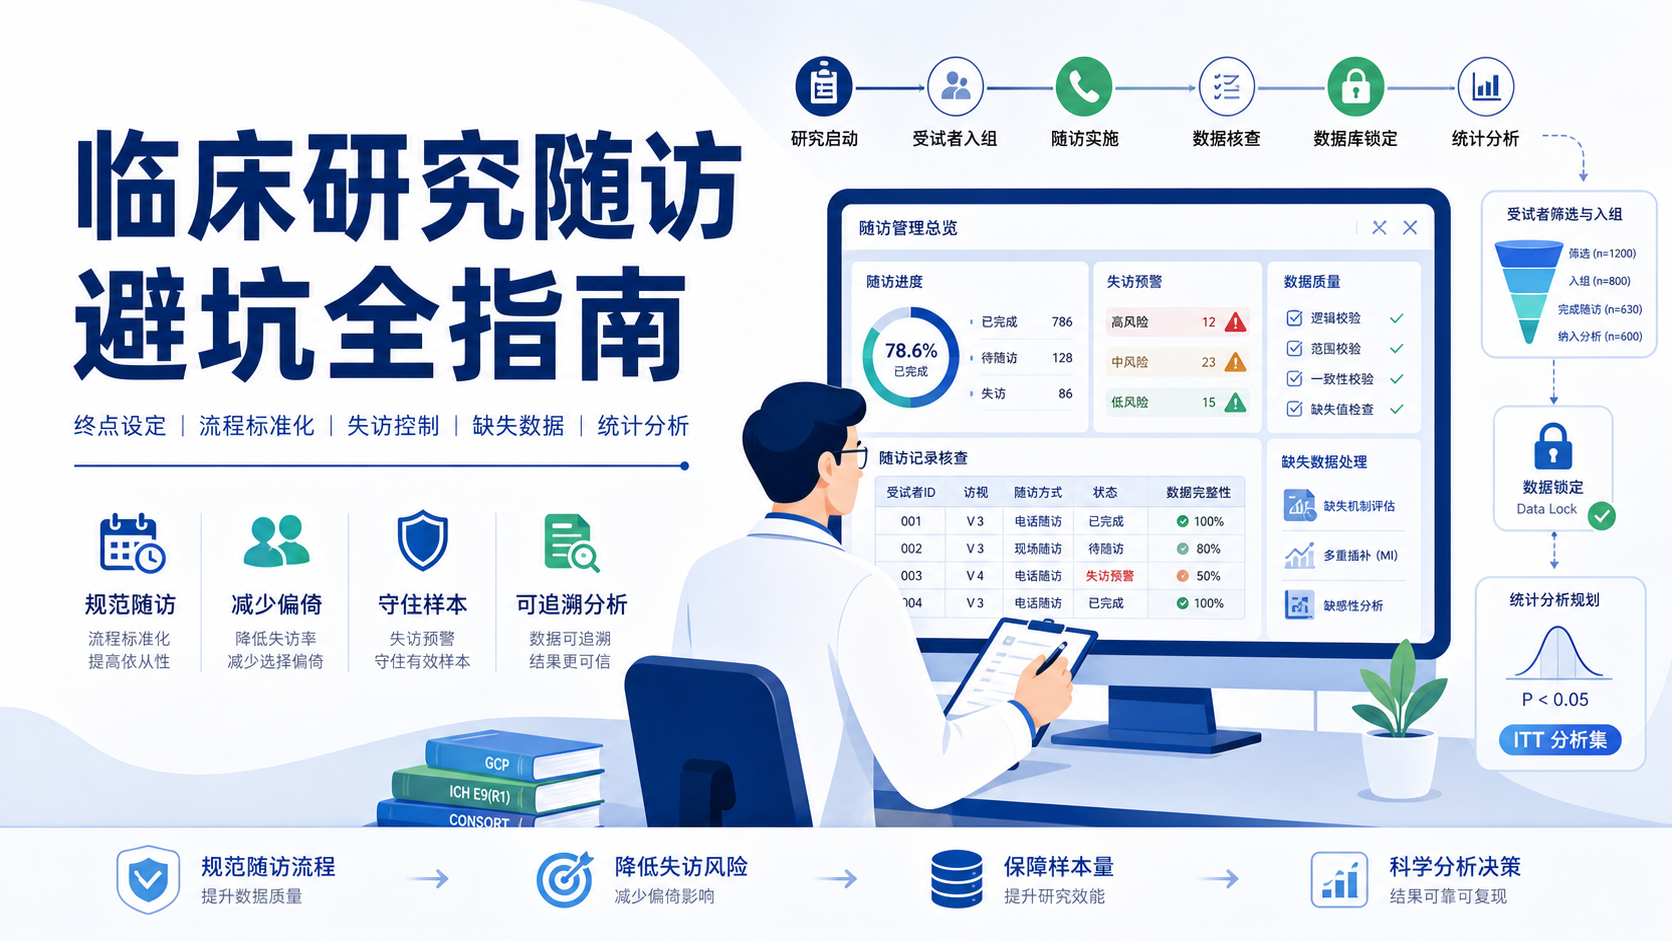
临床论文里,随访数据常决定结论是否可信。很多研究不是设计差,而是随访失真。失访、误填、时间点不统一,都会直接拉低证据等级。要想让研究结果经得起审稿和复核,随访质控必须前置到方案阶段。 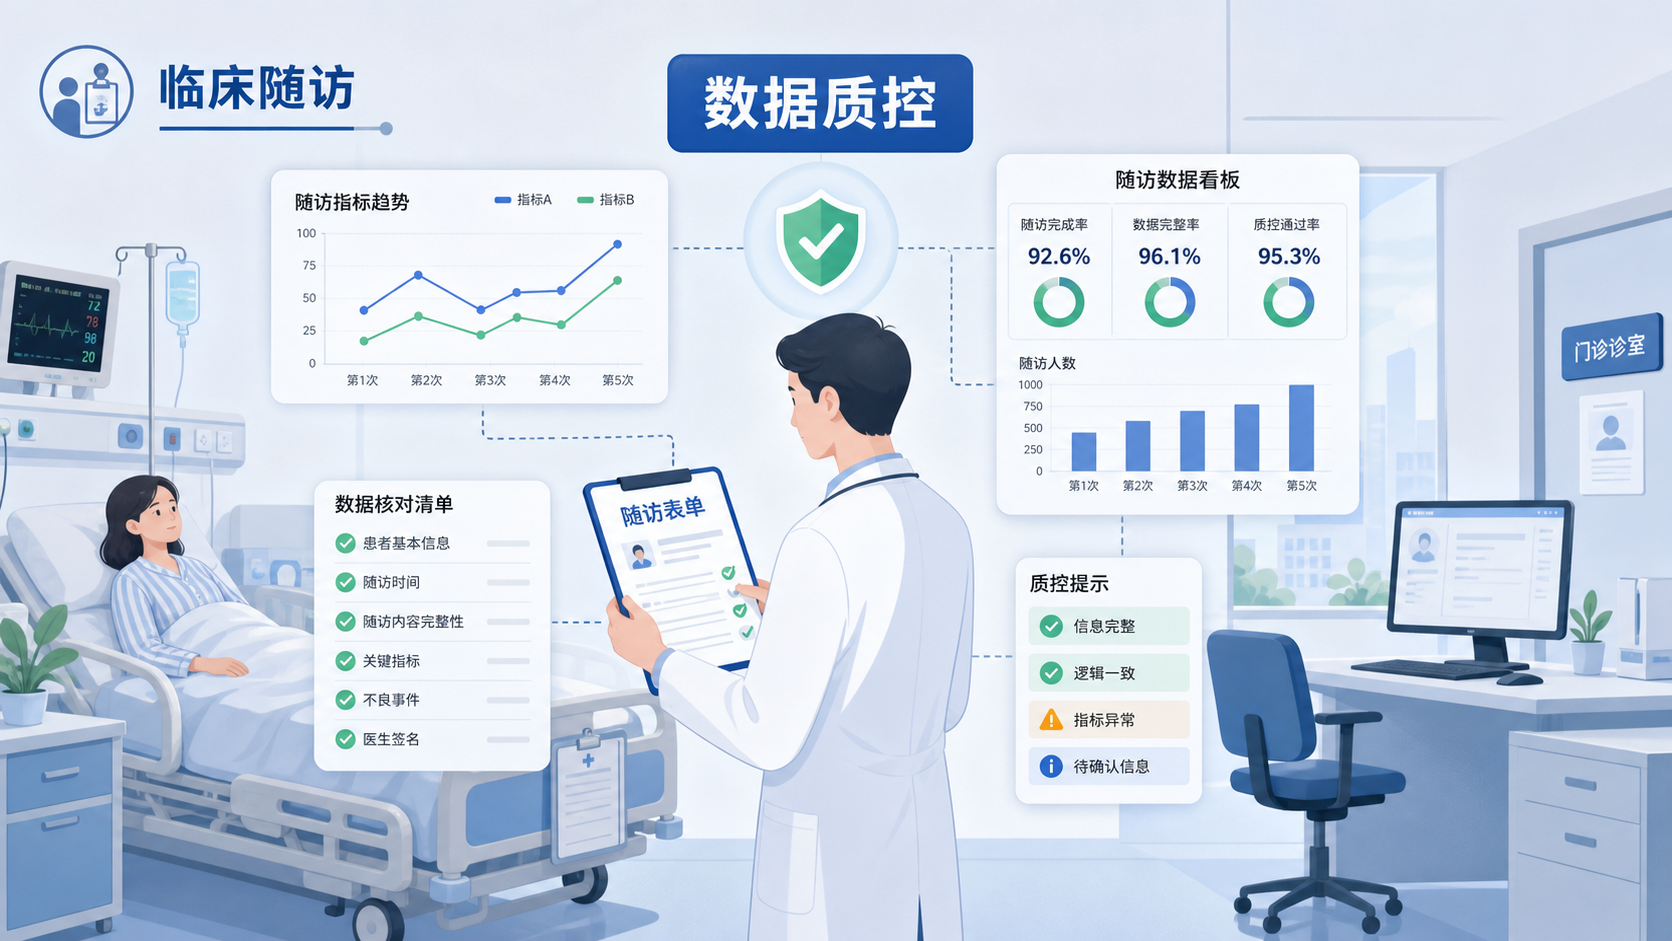
1. 随访设计先于数据收集
1.1 明确终点和时间窗
随访数据的质量,首先取决于设计是否清楚。研究开始前,就要定义主要终点、次要终点和观察时间点。比如术后30天并发症、6个月复发率、12个月生存率,必须写明。时间窗越模糊,后期数据越容易漂移。
对医学生和科研人员来说,最常见的问题不是“没数据”,而是“数据不在同一规则下产生”。同一结局,如果不同中心、不同随访员用不同口径记录,结果就无法合并分析。尤其是多中心研究,更要统一随访频率、结局判定标准和记录格式。
1.2 与研究问题保持一致
随访不是越多越好,而是要围绕研究目的展开。若研究药物疗效,就要重点记录用药依从性、复发、实验室指标和不良反应。若研究手术结局,就要关注再入院、再手术和功能评分。没有研究目的约束的随访,容易变成“信息堆积”,但不产生可分析证据。
在方案阶段应同步制定CRF或电子数据采集表。字段越清楚,后续越少返工。建议提前定义:
- 变量名称和单位。
- 允许范围。
- 缺失值编码。
- 结局判定规则。
- 失访判定标准。
2. 统一随访流程,减少系统误差
2.1 标准化访视和电话随访
临床论文随访数据最怕“人换了,标准也换了”。因此,研究团队要统一访视流程。门诊复查、电话随访、线上问卷、病历回访,都应有固定话术和固定顺序。同一研究中的不同随访方式,必须保持等价性。
对于电话随访,要明确由谁发起、问什么、如何追问、何时升级转诊记录。对于门诊随访,要规定体格检查和辅助检查是否必须完成。若某些指标只能在特定时间点测量,更应在方案中写死,避免因工作安排导致时间偏移。
2.2 做好人员培训和一致性考核
资料收集人员一致性,是随访质控中最容易被忽视的一环。研究开始前应进行统一培训,并通过预实验检查执行效果。培训不是走流程,而是为了减少观察者偏倚。
建议重点培训三类内容:
- 结局定义。
- 问卷提问顺序。
- 异常值和缺失值处理规则。
如果是多中心研究,还应定期做一致性复核。比如抽查10%随访记录,比较不同研究者对同一病例的判定是否一致。这个过程能尽早发现偏差,避免正式分析时才暴露问题。
3. 控制失访和脱落,守住样本完整性
3.1 失访率要提前预警
随访数据一旦缺失过多,统计效能会明显下降。临床研究中,失访率越高,选择偏倚风险越大。尤其当失访与病情严重程度相关时,偏倚会更明显。失访不是单纯的“数据少了”,而是可能改变结论方向。
研究中要区分几类常见问题:
- 已入组但不符合条件的病例。
- 自动退出或拒绝继续随访的病例。
- 未接受干预或私下交换组别的病例。
- 关键结局缺失的病例。
这些情况都可能影响意向性治疗分析。若不提前管理,最后很容易出现“样本在,证据不在”。
3.2 用策略提高随访完成率
提高随访率,核心是让研究对象更容易完成随访,而不是事后补救。可操作的措施包括:
- 入组时留下多个联系方式。
- 设定提醒机制。
- 控制随访间隔。
- 简化问卷长度。
- 对关键结局优先随访。
若研究周期较长,建议建立分层提醒。对高风险患者、高依从性差患者和重要亚组,可加密联系频率。与其后期大量补数据,不如前期减少脱落。
4. 数据录入、核查和缺失处理要可追溯
4.1 录入前先清洗
随访数据的常见问题,不仅是缺失,还有逻辑错误。例如术后第3天记录“12个月复发”,随访日期早于事件日期,明显不合理。又如同一患者在不同表格中性别、年龄、手术日期不一致,也需要核查。数据清洗的目标,是尽量消除系统性错误。
建议在录入前完成以下步骤:
- 检查时间顺序是否合理。
- 核对极端值是否真实。
- 统一单位和编码。
- 删除重复记录。
- 保留修改痕迹。
若使用电子数据采集系统,应设置逻辑校验。比如“出院日期不能早于入院日期”,“手术日期不能早于诊断日期”。这类规则可以在源头减少错误。
4.2 缺失数据不能简单删除
很多研究把缺失值直接剔除,结果看似干净,实则可能引入偏倚。缺失数据处理必须基于缺失机制,而不是图省事。 如果缺失很少,且机制近似随机,影响可能有限。但如果缺失较多,或与预后相关,就不能简单忽略。
常见处理思路包括:
- 说明缺失比例和原因。
- 尽可能回溯补全。
- 采用合适的统计方法处理。
- 在敏感性分析中检验稳健性。
对RCT来说,最好在方案中预先写明缺失数据处理方法。这样论文写作时更容易与CONSORT要求对齐,也更利于审稿人判断研究可信度。
5. 统计分析前先判断临床意义
5.1 不能只看P值
随访数据分析中,很多作者只盯着P值,但临床研究更需要看效应值和临床意义。一个差异即使统计学显著,也不一定有临床价值。反过来,样本量不足时,重要差异也可能因为功效不够而“不显著”。统计学结论不能替代临床判断。
因此,论文中应同时报告:
- 效应值。
- 95%置信区间。
- 事件发生率。
- 绝对风险差或相对风险。
对医生读者来说,这些信息比单纯P值更能回答“这个结果能不能用于临床”。
5.2 ITT和敏感性分析要提前规划
如果是随机对照试验,随访数据分析通常应优先考虑意向性治疗分析,即按最初随机分组进行统计。这样更能保留随机分组的平衡性。对脱落和交叉治疗较多的研究,敏感性分析也很重要。它可以帮助判断结果是否受失访影响。
建议在论文方法部分明确说明:
- 主要分析集。
- 缺失值处理方式。
- 是否进行了亚组分析。
- 是否进行了敏感性分析。
分析策略写在前面,结果才更可信。
临床论文随访数据的核心,不是“收得多”,而是“收得准、收得全、收得可追溯”。如果你正在准备RCT、队列研究或回顾性研究,建议从设计、采集到分析全流程建立质控表单。像解螺旋这样的专业平台,能帮助你把随访流程、数据清洗和论文写作打通,减少返工,也更容易产出符合投稿要求的高质量研究。
总结Conclusion
临床论文随访数据的质控,关键在五点。先定终点和时间窗,再统一流程,接着控制失访,随后做好录入核查,最后用临床意义指导统计分析。 这五步看似基础,却直接决定论文能否站得住。对医生和科研人员来说,真正高质量的随访,不是补出来的,而是设计出来的。若你希望把随访数据管理做得更规范、更高效,可以借助解螺旋的专业支持,把数据质量真正落到论文产出上。
- 引言Introduction
- 1. 随访设计先于数据收集
- 2. 统一随访流程,减少系统误差
- 3. 控制失访和脱落,守住样本完整性
- 4. 数据录入、核查和缺失处理要可追溯
- 5. 统计分析前先判断临床意义
- 总结Conclusion