

 12
 分享
引言Introduction
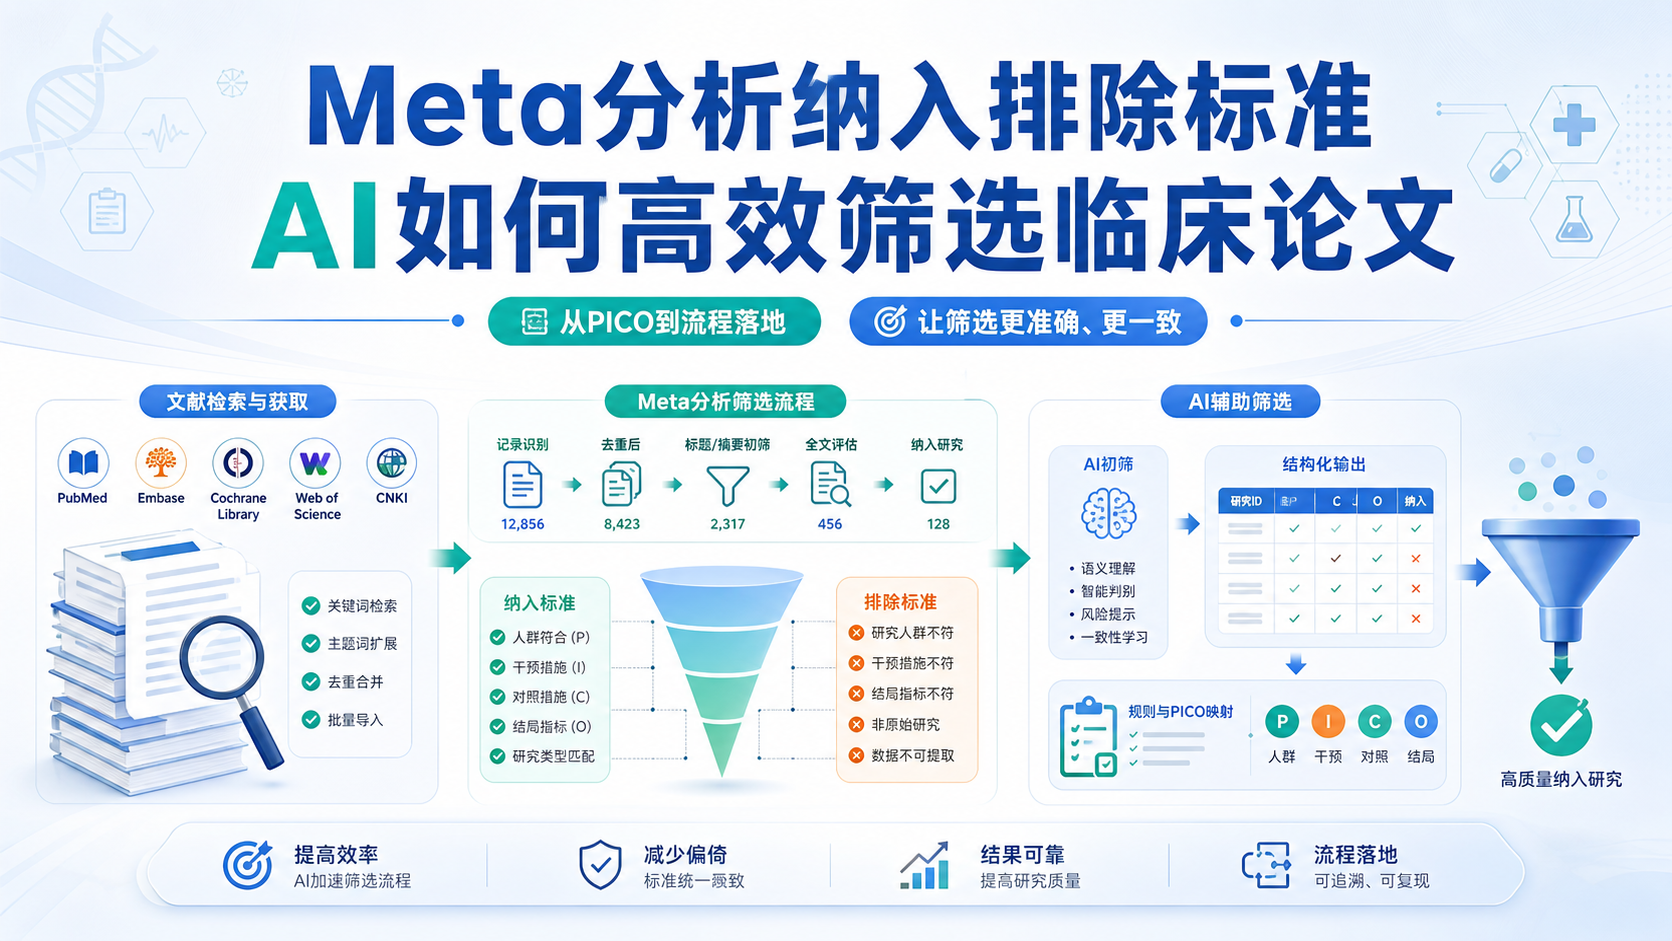
临床论文的纳入排除标准,决定了Meta分析是否可信。标准定得不严,结果就会偏;定得太窄,又可能无文可纳。对医学生、医生和科研人员来说,真正的难点不是“会不会做Meta分析”,而是能否用一致、可复核的规则筛出合格研究。 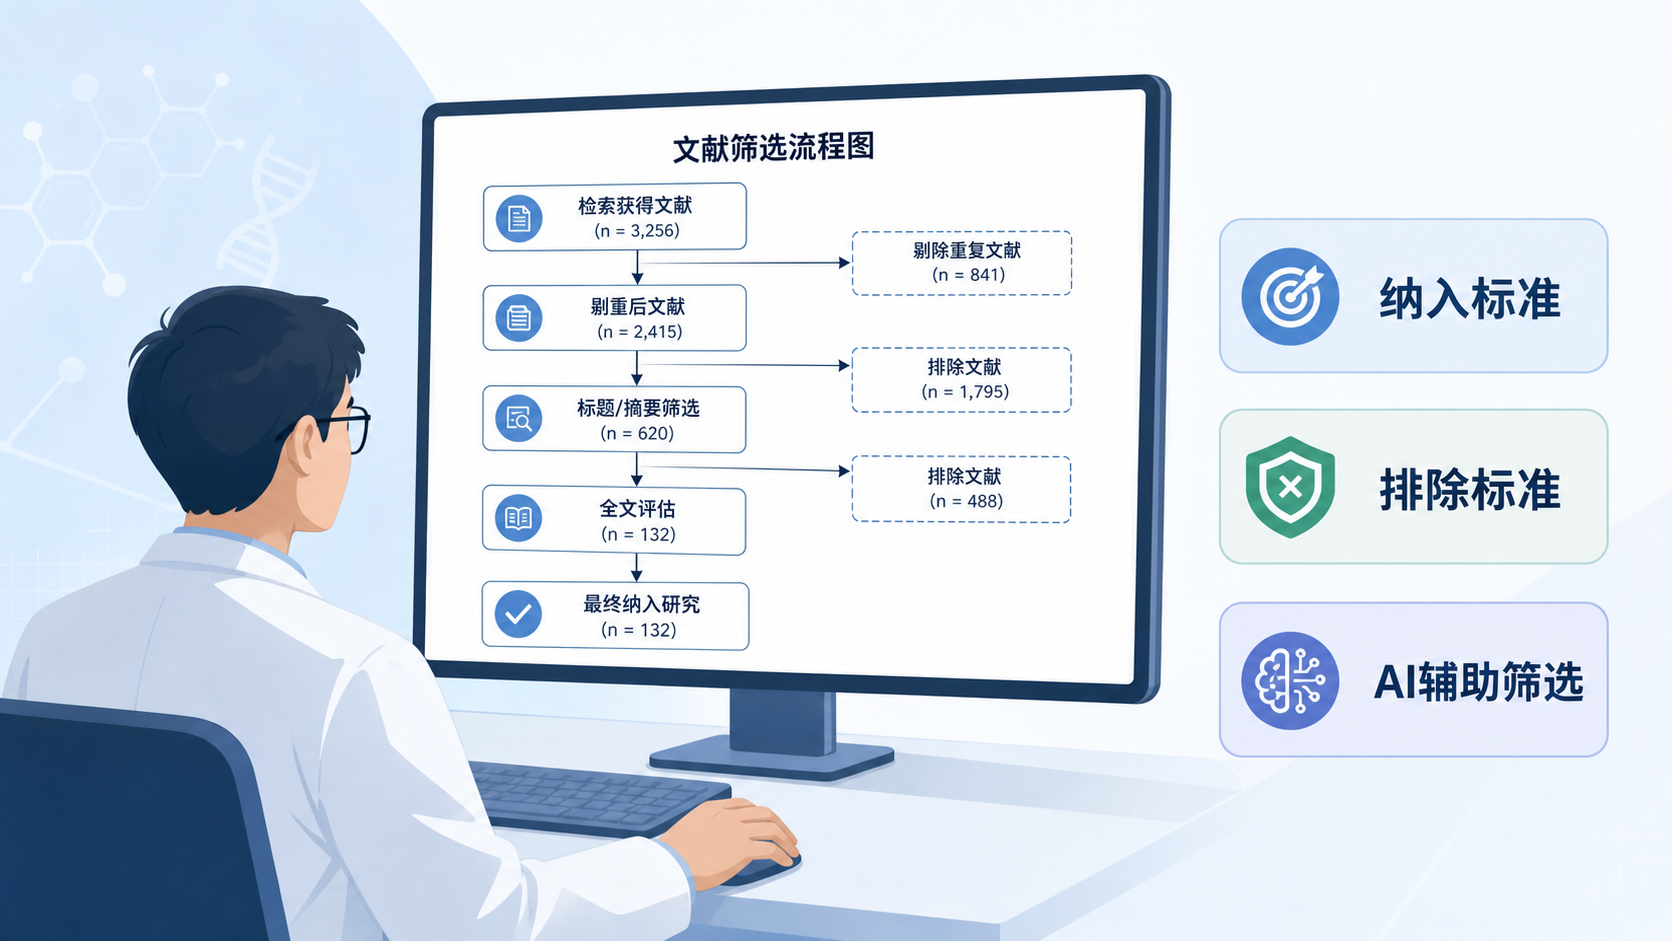
1. 为什么纳入排除标准是Meta分析的起点
1.1 标准一旦模糊,后续分析都会失真
Meta分析本质上是对具备相似条件的研究结果进行综合 。如果纳入研究的对象、干预、结局或设计差异过大,即使把数据合并,结论也可能没有临床意义。系统评价可以先于Meta分析存在,但是否进行定量合并,取决于研究是否具有足够同质性。
换句话说,纳入排除标准不是形式,而是研究问题的边界。 边界越清楚,后面的文献筛选、质量评价、异质性检验和敏感性分析就越容易执行。
1.2 标准的核心作用有三点
临床研究中,纳入排除标准主要承担三项任务。
- 限定研究对象,确保问题一致。
- 控制偏倚来源,减少无关文献干扰。
- 提高可重复性,让别人能按同样规则复现筛选过程。
从循证医学角度看,Meta分析的价值在于增加样本量,提高检验效能 。但前提是纳入的研究“能放在一起比较”。如果标准混乱,样本量再大也不等于证据更强。
2. 临床论文纳入标准怎么定
2.1 纳入标准要围绕PICO展开
规范的纳入标准,通常围绕PICO框架展开,即研究对象、干预措施、对照措施和结局指标。对于临床论文,建议至少明确以下内容。
- 研究对象:疾病诊断、年龄范围、性别、病程、分期。
- 干预措施:药物、手术、康复、护理或其他处理方式。
- 对照措施:安慰剂、常规治疗、另一种治疗方案。
- 结局指标:有效率、死亡率、并发症、评分变化、生存期等。
- 研究设计:随机对照试验、队列研究、病例对照研究等。
纳入标准越具体,后续筛选越高效。 但也不能过度收窄,否则很容易把本可合并的高质量研究全部排除。
2.2 常见的可操作写法
临床Meta分析中,纳入标准应写成可执行句式,而不是笼统描述。例如:
- 研究对象为明确诊断的成人患者。
- 研究类型为随机对照试验或队列研究。
- 干预措施为某药物单药或联合治疗。
- 对照组接受安慰剂、常规治疗或其他标准方案。
- 至少报告一个可提取的结局指标。
- 文献提供原始数据,便于效应量计算。
这里要特别注意,“可提取数据”是纳入标准中的硬条件 。若一篇研究设计合理,但没有足够的均数、标准差、事件数或样本量,仍可能无法进入合并分析。
2.3 不同研究类型的标准侧重点不同
不同Meta分析类型,纳入标准侧重点并不相同。
- 连续性资料Meta分析,重点看均数、标准差和测量单位是否统一。
- 二分类Meta分析,重点看事件数和总样本量是否齐全。
- 诊断性研究Meta分析,重点看金标准是否明确,阈值是否一致。
- 生存资料Meta分析,重点看是否能提取HR及95%CI。
- 网络Meta分析,则还要看比较节点是否完整。
不要把一个标准套用到所有研究类型。 这会直接影响后续效应量选择,如WMD、SMD、OR、RR或HR。
3. 排除标准为什么更容易出错
3.1 排除标准要写得足够具体
很多研究的问题不在于纳入标准不够,而在于排除标准太随意。常见错误是把“质量差”“数据不全”“不相关”写成模糊条目。这样的标准虽然看似合理,但实际执行时缺乏统一性。
更好的写法应包含明确原因,例如:
- 重复发表或数据重复。
- 综述、病例报告、会议摘要、动物实验、体外实验。
- 非目标人群,如儿童、孕妇、特定合并症人群。
- 干预或对照不符合预设方案。
- 缺少主要结局或关键原始数据。
- 文献语言、时间范围或数据库来源不符合研究方案。
排除标准的本质,是提前定义“什么不能进来”。 越具体,越能减少主观筛选。
3.2 重复文献和信息不完整,是最常见的排除原因
在实际筛选中,重复发表和重复数据是高频问题。尤其同一研究团队在不同期刊、不同语言版本或不同随访时间点发表时,容易出现数据重叠。若不先排除重复数据,会导致样本被重复计算,合并结果失真。
另一类常见问题是信息不完整。比如缺少标准差、结局事件数不清、随访时间不一致。此时可以尝试联系作者补充,但若仍无法获得关键数据,应按预设规则排除。
3.3 排除标准不能“事后修改”
排除标准必须在正式筛选前确定。 如果在看完结果后再调整标准,会引入选择性偏倚。对于临床论文尤其如此,因为研究者很容易受到阳性结果吸引,产生无意识的偏向。
建议在方案阶段就记录:
- 排除的原因类别。
- 每一类的判定依据。
- 是否允许联系作者补数。
- 无法补数时的处理方式。
这样,最终的PRISMA流程图和方法学描述才更可信。
4. AI如何辅助临床论文筛选
4.1 AI最适合做“初筛加速器”
AI在Meta分析中的价值,不是替代研究者判断,而是提高筛选效率。对于大量检索结果,AI可以先根据标题和摘要进行相关性排序,帮助研究者更快定位可能纳入的文献。
常见应用包括:
- 自动识别RCT、队列研究、病例对照研究。
- 标记是否含有目标疾病、干预和结局关键词。
- 辅助去重,减少重复记录。
- 根据预设规则生成初筛建议。
但AI输出只能作为辅助,不能直接替代最终纳入决定。 因为很多临床研究的细节只在全文中体现,摘要无法完整反映设计质量和数据可用性。
4.2 AI能提升一致性,但前提是规则先统一
如果研究者之间的标准本身不统一,AI再强也无法避免偏差。正确顺序应该是先建立标准,再让AI辅助执行。建议按以下流程操作。
- 先定义PICO和研究设计边界。
- 写出纳入和排除标准。
- 用少量文献做试筛。
- 让AI标记可疑记录。
- 由两名研究者独立复核。
- 对分歧文献进行讨论或第三方裁定。
这种做法比单纯“让AI全自动筛文献”更符合临床科研规范。
4.3 AI也适合做信息提取前的结构化整理
在文献进入全文筛选后,AI还能帮助整理以下信息:
- 作者、年份、国家。
- 研究设计和样本量。
- 干预与对照方案。
- 结局指标及随访时长。
- 统计量类型,如均数差、OR、RR、HR。
这一步非常重要,因为Meta分析后续能否进行,往往取决于原始数据是否可结构化提取。AI在这里的价值,是减少人工整理时间,而不是改变学术判断标准。
5. 标准制定后,如何真正落地到Meta分析流程
5.1 从检索到纳入,必须一环扣一环
完整的Meta分析流程通常包括检索、筛选、质量评价、数据提取、合并分析、敏感性分析和发表偏倚检验。纳入排除标准贯穿每一步,尤其影响流程图、基本特征表和最终结论。
如果前期标准清晰,后续就更容易完成以下工作:
- 明确各数据库检索策略。
- 快速判断是否进入全文评估。
- 统一质量评价口径。
- 减少异质性来源。
- 提高结果解释的可信度。
真正高质量的Meta分析,不是把更多文章塞进来,而是把最合适的文章筛出来。
5.2 标准要和效应量、软件、结局一起设计
很多初学者先想统计软件,再想选题,最后才补标准,这种顺序不理想。更合理的做法是,先定研究问题,再定纳入排除标准,再决定效应量和软件。
例如:
- 连续性结局,通常需要均数和标准差,效应量可能是WMD或SMD。
- 二分类结局,需要事件数和总例数,常用OR或RR。
- 生存结局,常需HR及其95%CI。
只有标准、数据和统计方法三者匹配,Meta分析才真正可执行。 这也是临床论文能否顺利发表的关键。
5.3 用解螺旋,把筛选从“经验活”变成“流程活”
对于需要高效率完成文献筛选和数据整理的科研团队,建议把标准先写成可执行模板,再借助工具提升效率。解螺旋可用于文献管理、结构化整理和筛选流程辅助,帮助研究者更快完成重复性工作,把更多时间留给方案设计、偏倚判断和结果解释。当纳入排除标准清晰、流程规范、工具到位时,Meta分析的效率和质量都会明显提升。
总结Conclusion
临床论文的纳入排除标准,不只是方法学部分的一段文字,而是Meta分析可信度的核心。标准决定边界,边界决定证据质量。 AI可以帮助初筛、去重和结构化整理,但不能替代研究者对临床问题的判断。对于医学生、医生和科研人员来说,最稳妥的路径是先建立清晰标准,再用AI提高效率,再用人工复核保证质量。若你正在做临床Meta分析,建议用解螺旋协助整理文献与筛选流程,让研究更快、更稳、更规范。
- 引言Introduction
- 1. 为什么纳入排除标准是Meta分析的起点
- 2. 临床论文纳入标准怎么定
- 3. 排除标准为什么更容易出错
- 4. AI如何辅助临床论文筛选
- 5. 标准制定后,如何真正落地到Meta分析流程
- 总结Conclusion