

 13
 分享
引言Introduction
单细胞Hi-C正在把“平均信号”变成“细胞级空间结构”。它能回答同一组织里,不同细胞的染色质折叠是否一致,异常结构是否与疾病相关。对医学生、医生和科研人员来说,这项技术的价值,不只是看见三维基因组,更是把机制研究推进到临床样本。
1. 单细胞Hi-C是什么,解决了什么问题
1.1 从群体Hi-C到单细胞Hi-C
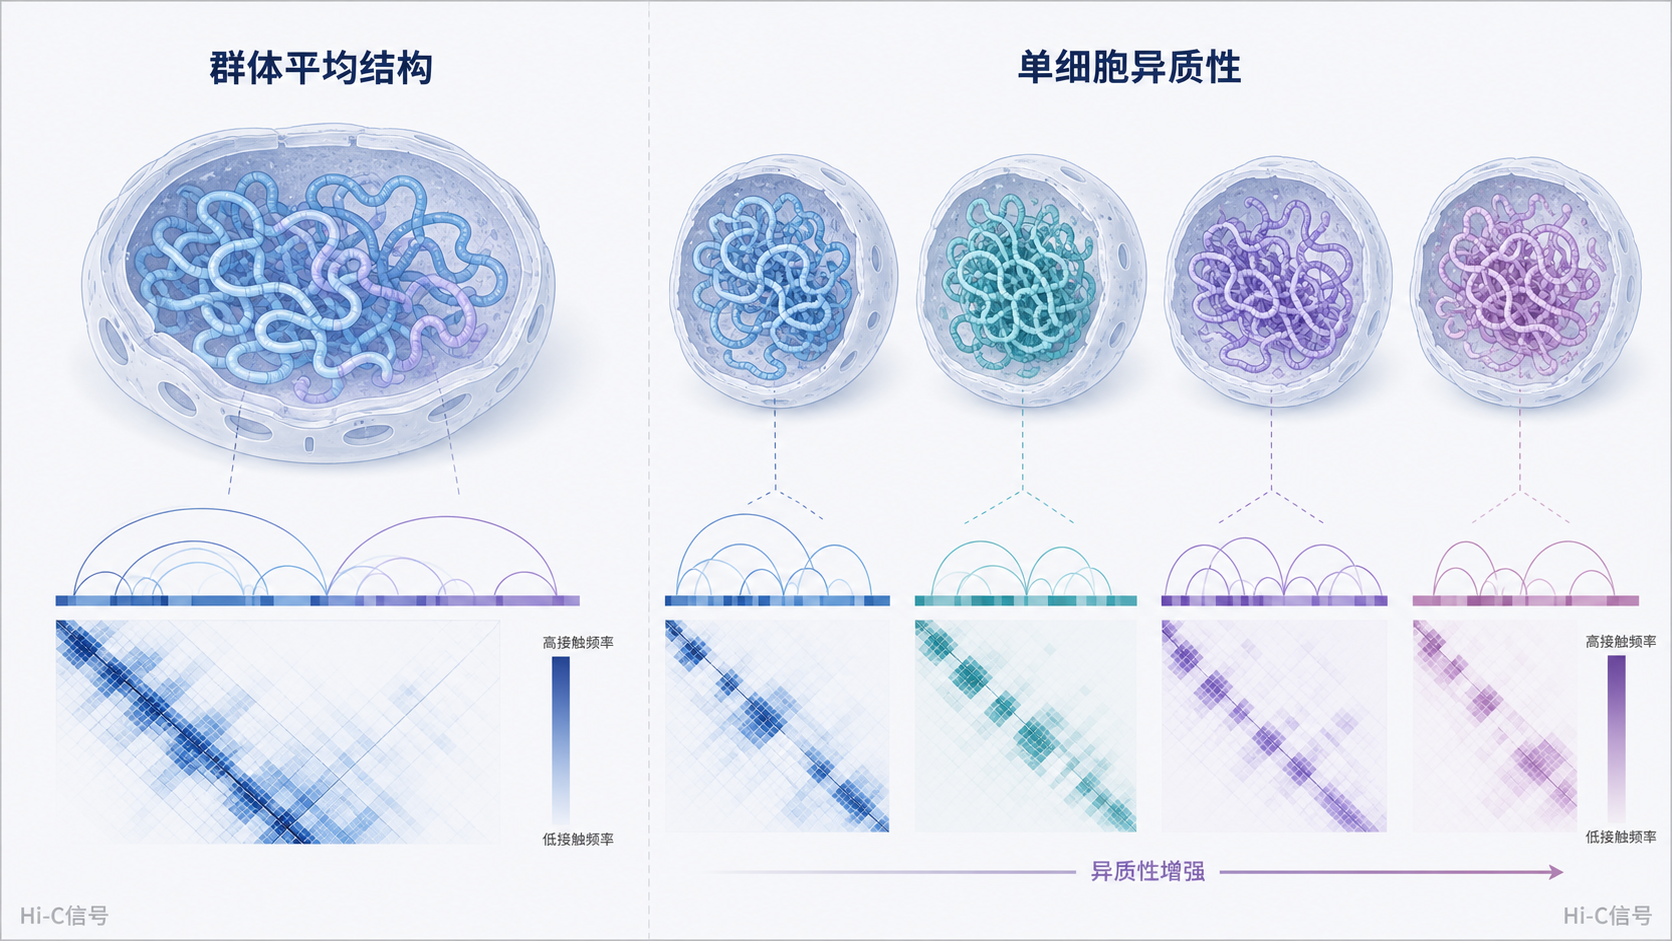
传统Hi-C反映的是一群细胞的平均染色质接触图谱。它能识别TAD、A/B compartment和远距离互作,但掩盖了细胞间差异。单细胞Hi-C的核心价值,是把三维基因组结构还原到单个细胞水平。
这对异质性强的样本尤其重要。比如肿瘤、早期胚胎、神经组织和免疫细胞群体。群体测序里看起来稳定的结构,到了单细胞层面,可能是多个状态混合后的结果。
1.2 它回答的不是“哪里有接触”,而是“谁在接触”
单细胞Hi-C并不只是提高分辨率。它更重要的是揭示结构状态。
同一细胞类型中,不同细胞可能处于不同染色质构象。比如:
- 某些细胞维持开放构象,转录更活跃。
- 某些细胞出现局部压缩,提示分化或应激状态。
- 某些病变细胞的长程互作发生重排,可能影响基因调控。
因此,单细胞Hi-C关注的是结构异质性,而不仅是平均接触频率。
2. 技术原理:单个细胞内如何获得三维接触信息
2.1 基本流程
单细胞Hi-C的核心思路与传统Hi-C一致,但把检测对象限制到单个细胞。一般流程包括:
- 交联固定染色质,保留空间邻近关系。
- 酶切或机械处理,切开DNA。
- 末端填充并标记。
- 连接空间上相邻的DNA片段。
- 逆交联、建库、测序。
- 通过比对识别接触对。
最终得到的是单个细胞内部的染色质接触矩阵 。
2.2 为什么难度远高于群体Hi-C
单细胞Hi-C最大的挑战,不是测序,而是信号稀疏。一个细胞核内可检测到的有效接触对很少,远低于群体样本。常见问题包括:
- 覆盖度低,矩阵稀疏。
- dropout严重。
- 技术噪声高。
- 批次效应明显。
这意味着分析时不能简单套用群体Hi-C思路。单细胞Hi-C数据需要更强的去噪、聚类和结构推断能力。
3. 单细胞Hi-C的关键应用场景
3.1 发育生物学
在胚胎发育过程中,细胞命运快速变化。三维基因组重塑往往早于表型改变。单细胞Hi-C可以捕捉染色质从“未分化状态”向“谱系特异状态”转变的过程。
对于发育研究者来说,这类数据的价值在于:
- 识别分化轨迹中的结构转折点。
- 比较不同发育阶段的染色质组织。
- 关联结构变化与关键转录因子激活。
3.2 肿瘤研究
肿瘤细胞具有高度异质性。单细胞Hi-C有助于观察:
- 染色体重排后的空间后果。
- 增殖亚群与侵袭亚群的结构差异。
- 治疗前后染色质重塑。
对临床转化而言,单细胞Hi-C最有潜力的方向之一,是把结构异常作为肿瘤分层和疗效预测的补充证据。
3.3 神经科学与罕见样本
神经组织细胞类型复杂,且许多样本难以获得高质量活细胞悬液。单细胞Hi-C可用于冷冻组织或难处理样本的三维结构解析。对于罕见病、脑组织和尸检样本,这一点尤为重要。
4. 数据分析:单细胞Hi-C为什么“看图容易,解释难”
4.1 主要分析步骤
单细胞Hi-C分析通常包括:
- 读段质控与比对。
- 有效接触对筛选。
- 去除重复和伪连接。
- 构建接触矩阵。
- 降维、聚类与细胞状态识别。
- 结构特征提取,如compartment、TAD样信号、loop倾向。
但由于数据稀疏,很多单细胞Hi-C图谱并不适合直接肉眼比较。分析重点通常从“单个峰”转向“结构模式”与“细胞群分层”。
4.2 常见误区
很多初学者会把单细胞Hi-C当成“单细胞版的群体Hi-C”。这会带来两个问题:
- 过度依赖局部热点,不看全局结构。
- 忽略数据稀疏性带来的统计偏差。
更合理的做法是结合多种信息,例如:
- 单细胞转录组,判断功能状态。
- ATAC-seq,判断开放性。
- 甲基化数据,判断表观调控背景。
单细胞Hi-C的解释,必须放在多组学框架中。
5. 从基础研究到临床转化,还差哪几步
5.1 目前最现实的临床价值
从临床角度看,单细胞Hi-C尚未成为常规检测项目,但它已经具备明确的转化方向:
- 作为机制研究工具,解释疾病发生过程。
- 作为伴随研究工具,辅助分型。
- 作为多组学整合的一部分,增强预测模型。
尤其在肿瘤和发育异常领域,三维基因组异常往往与转录失衡、复制压力和染色体不稳定相关。这使单细胞Hi-C成为连接结构生物学与临床表型的重要桥梁。
5.2 真正的瓶颈
单细胞Hi-C走向临床,还需要解决四个问题:
- 成本高。
- 通量有限。
- 分析流程复杂。
- 标准化不足。
此外,临床样本来源复杂,固定方式、保存时间和细胞质量都会影响结果。对于医院和科研平台来说,样本前处理标准化,比想象中更关键。
5.3 未来方向
未来的单细胞Hi-C,可能会与以下方向深度融合:
- 空间转录组。
- 单细胞多组学。
- 机器学习结构预测。
- 临床分层模型。
谁能把三维结构信息和疾病分型、疗效预测真正连起来,谁就更接近转化应用。
6. 做单细胞Hi-C研究,如何提高成功率
6.1 实验设计优先于“盲目上机”
单细胞Hi-C样本少,容错率低。建议优先明确三个问题:
- 研究的是发育、肿瘤,还是神经样本。
- 关注的是整体结构,还是特定染色体异常。
- 是否需要与RNA或ATAC联合分析。
这样可以避免只拿到“漂亮但解释力弱”的图。
6.2 数据分析要提前规划
单细胞Hi-C不是后期再补分析。建库前就要考虑:
- 预期细胞数。
- 每细胞有效接触数。
- 是否需要分群。
- 参考基因组和重复区域处理策略。
对于缺乏本地分析团队的实验室,把原始数据处理、质控和多组学整合交给成熟平台,往往比临时摸索更稳妥。
6.3 借助专业平台降低试错成本
如果你希望更高效地推进单细胞Hi-C项目,解螺旋可以为课题设计、数据分析和结果可视化提供支持。对于医学生、医生和科研人员来说,这类平台价值很直接:
- 节省重复试错时间。
- 提高分析流程规范性。
- 更快产出可发表的图表和结果。
把复杂流程交给专业团队,研究者就能把精力集中在科学问题本身。
总结Conclusion
单细胞Hi-C把三维基因组研究从“群体平均”推进到“单细胞异质性”。它适合研究发育、肿瘤、神经和罕见样本,也为临床转化提供了新的结构证据。虽然它仍面临成本、通量和分析标准化等挑战,但其方向已经非常明确。
如果你正在规划单细胞Hi-C项目,或希望把三维基因组数据用于机制研究和发表转化,建议尽早借助解螺旋的专业支持,让实验设计、分析和解释更高效、更可靠。
- 引言Introduction
- 1. 单细胞Hi-C是什么,解决了什么问题
- 2. 技术原理:单个细胞内如何获得三维接触信息
- 3. 单细胞Hi-C的关键应用场景
- 4. 数据分析:单细胞Hi-C为什么“看图容易,解释难”
- 5. 从基础研究到临床转化,还差哪几步
- 6. 做单细胞Hi-C研究,如何提高成功率
- 总结Conclusion