

 38
 分享
引言Introduction
临床论文写作最常卡在两点。样本不够大,变量不够新。很多研究不是没有数据,而是不会把变量、结局、分层和模型系统串起来,最后只能写成一篇平淡的回顾性分析。真正拉开差距的,是统计方法和高通量思维。
1. 临床论文统计方法为什么决定文章上限
1.1 统计方法不是“补充项”,而是研究设计的一部分
很多人把统计方法放在论文最后写,实际上这会直接影响课题能不能成立。临床研究里,统计不是简单做一个P值。它决定你如何定义暴露、结局、混杂因素和亚组。
如果研究问题不清,后面的模型越多,论文越危险。
一个成熟的临床论文,通常先回答四件事:
- 暴露因素是什么。
- 主要结局是什么。
- 哪些变量需要控制。
- 结果是否稳定,能否重复。
这也是为什么回顾性队列、病例对照、横断面和生存分析,会对应不同的统计框架。方法选错,结论就会偏。
1.2 高质量论文看的是“控制混杂”的能力
临床研究最大的敌人是混杂。尤其是回顾性研究,患者基线往往不平衡。常见做法包括:
- 倾向评分匹配,降低组间差异。
- 逆概率加权,重建更可比的人群。
- 多因素回归,校正已知混杂。
- 分层分析,观察不同人群的效应差异。
标准化差异通常比单纯P值更能反映基线平衡。
很多研究会把标准化差异控制在10%以内,作为组间可比性的参考。这个思路比“只看P值显著不显著”更适合临床论文。
2. 临床论文统计方法的核心框架
2.1 从描述性统计开始,先把人群讲清楚
一篇论文首先要回答“研究对象是谁”。这一步决定了后面所有结果是否可信。描述性统计通常包括:
- 连续变量:均数、标准差,或中位数、四分位数。
- 分类变量:例数和百分比。
- 组间比较:t检验、秩和检验、卡方检验或Fisher精确检验。
不要一上来就做复杂模型。先把基线表做好。
基线表是临床论文的门面,也是后续统计的起点。如果这部分不规范,审稿人很容易质疑整篇文章的数据质量。
2.2 生存分析和回归模型是临床论文高频工具
如果研究结局涉及死亡、复发、事件发生时间,就必须考虑生存分析。常见方法有:
- Kaplan-Meier曲线,用于展示不同组的累积生存差异。
- Log-rank检验,用于比较两组生存曲线。
- Cox比例风险模型,用于校正多因素影响。
- 竞争风险模型,用于处理非目标事件干扰。
Cox模型的价值在于,它能在多变量环境下估计某个因素对结局的独立影响。
但前提是比例风险假设成立。如果曲线交叉,或者假设被破坏,就要考虑分段分析,或使用更合适的模型。
2.3 相关性、诊断和预测分析,各有不同目标
临床论文并不只做“有无差异”。常见目标还包括:
- 相关性分析,判断变量间关系。
- 诊断价值分析,常用ROC曲线、AUC、敏感度、特异度。
- 预测模型构建,常用LASSO、随机森林、列线图、校准曲线。
不同研究目标,对应不同统计方法。
比如做诊断研究,重点不是P值,而是模型区分能力和临床可用性。做预后研究,重点则是独立危险因素和模型稳定性。
3. 高通量分析:从“单变量验证”走向“穷举筛选”
3.1 什么是高通量思维
高通量分析的核心,不是盲目堆数据,而是把大量变量放进统一框架中筛选。它强调的是“穷举”而不是“拍脑袋”。在临床研究中,这种思路常见于:
- 多个临床变量同时筛选。
- 多个分子、通路或特征联合分析。
- 多个终点或亚组并行比较。
- 多组数据库交叉验证。
高通量分析的本质,是把可检验的变量尽可能系统化。
这类研究更适合拥有数据库、服务器和批量统计能力的团队。因为变量多,模型多,重复计算量也更大。
3.2 穷举变量不是乱跑模型,而是有规则地筛选
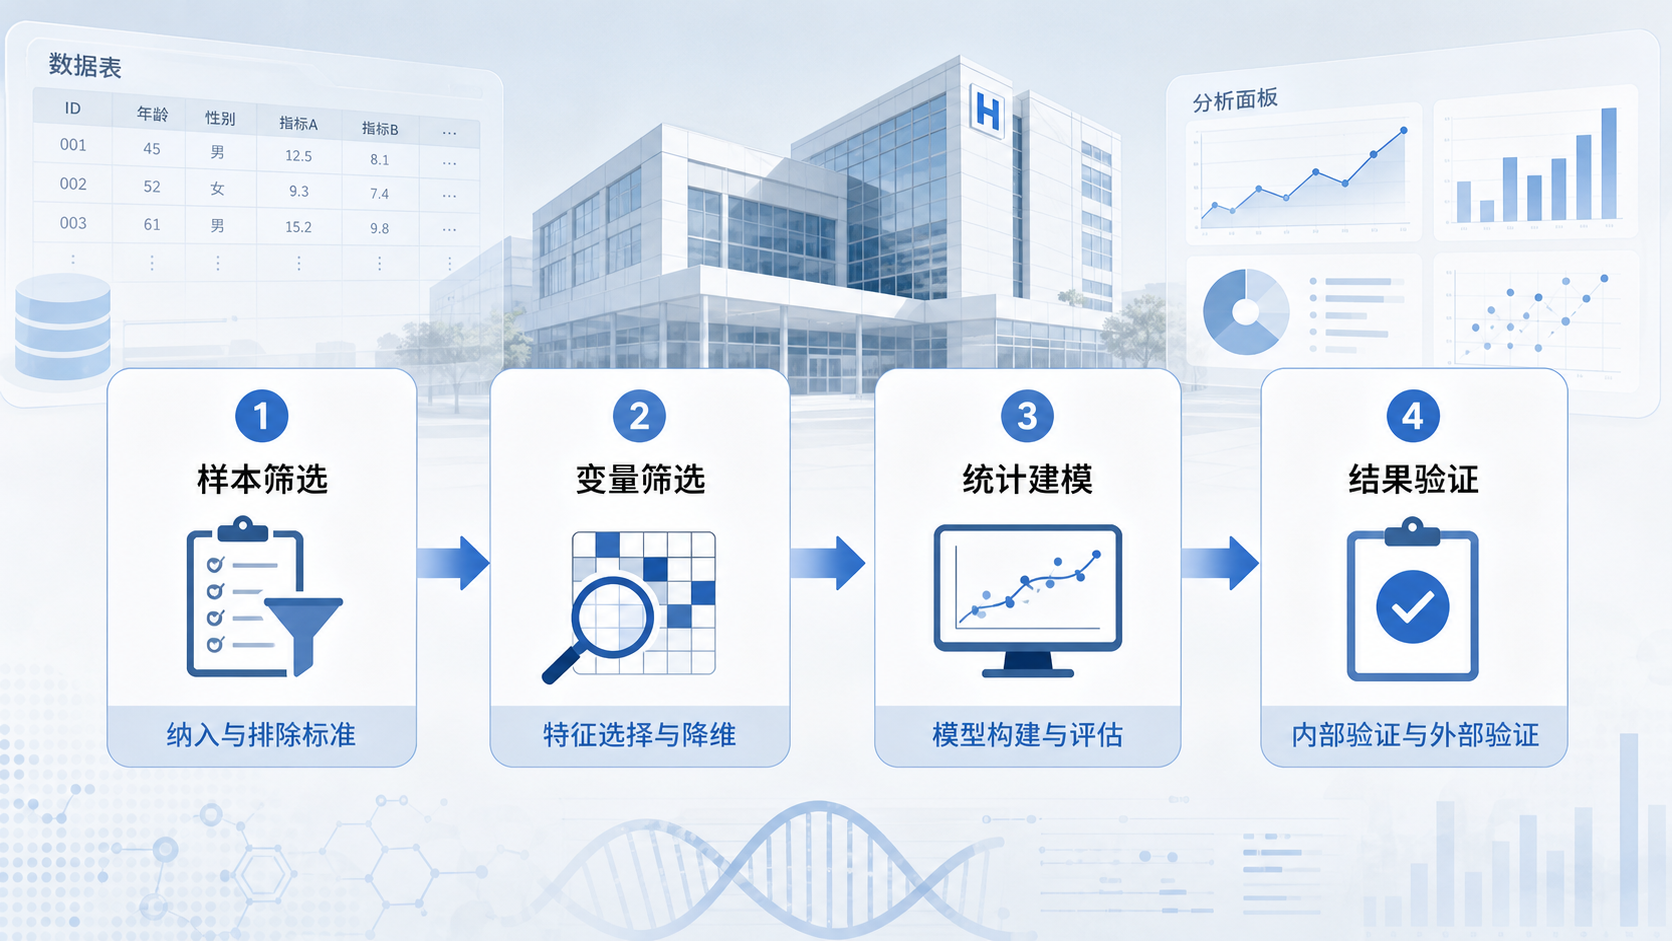
很多人误以为“穷举”就是把所有变量都扔进模型。其实不是。专业做法通常是:
- 先定义候选变量集合。
- 进行差异分析或初筛。
- 再看单因素结果。
- 进入多因素模型。
- 做亚组和敏感性分析。
- 最后验证稳定性。
只有经过规则筛选的高通量,才有论文价值。
如果只是机械地跑几十个模型,结果很容易变成数据挖掘噪声。审稿人最反感的,就是没有生物学或临床逻辑支撑的“阳性结果堆积”。
3.3 高通量分析适合哪些临床研究场景
高通量思维特别适合以下场景:
- 数据量大,但单一假设不够强。
- 研究变量多,临床维度丰富。
- 需要寻找创新切入点。
- 想从数据库中筛出可验证的候选因素。
例如,一个课题如果只验证一个假设,可能很快就做完。
但如果将疾病、分子、年龄、性别、分层阶段、免疫浸润、预后和治疗反应同时纳入,就能形成更完整的证据链。
这也是为什么同一份数据库,有人只能写一篇普通文章,有人能持续发文。
差别不在数据本身,而在变量组织能力。
4. 临床论文如何把统计方法写得更像高水平文章
4.1 方法部分要具体,不能写成模板句
很多论文的方法部分太空。只写“采用SPSS进行统计分析”,这远远不够。更规范的写法应包括:
- 数据类型和分布判断方法。
- 所用检验及适用条件。
- 缺失值处理方式。
- 变量进入模型的标准。
- 亚组和敏感性分析的设定。
- 双侧检验与显著性阈值。
方法写得越具体,论文越容易通过审稿。
因为审稿人关心的是:你的分析是否可重复,是否存在选择性报告。
4.2 结果部分要服务于研究问题
结果不是越多越好,而是越能支撑主线越好。临床论文里最常见的结果组合包括:
- 基线比较。
- 单因素分析。
- 多因素分析。
- 生存曲线。
- 亚组分析。
- 敏感性分析。
- 预测性能评估。
如果结果过多,但彼此没有逻辑连接,文章就会显得散。
高水平文章往往不是“分析很多”,而是“每一步都围绕一个主问题”。
4.3 发表友好的统计思路,往往来自“可验证性”
从发表角度看,最重要的是研究结果能否被重复和验证。常见提升方式有:
- 在不同数据库中重复分析。
- 用独立队列验证结论。
- 用实验或临床指标补强。
- 用分层和亚组验证稳健性。
对于实验资源有限的团队,qPCR、基础临床验证和公开数据库复核,往往比高成本实验更现实。关键不是堆砌实验,而是让证据链闭合。
5. 解螺旋如何帮助你把统计方法变成发文能力
5.1 你缺的往往不是数据,而是分析框架
很多医学生、医生和科研人员手里都有数据,但不知道如何把变量变成论文结构。问题通常不在“有没有结果”,而在:
- 不知道先筛什么。
- 不知道哪些变量值得保留。
- 不知道模型如何递进。
- 不知道怎么把阳性结果串成故事线。
解螺旋提供的价值,就是把分散变量整理成可发表的分析路径。
这对于临床论文统计方法尤为关键,因为论文能否成稿,往往取决于前期框架设计,而不是最后一张图。
5.2 高通量分析的真正价值,是提高命中率
当你能系统筛选变量、建立多层验证、处理混杂因素时,文章的命中率会明显提升。尤其是在以下方面:
- 候选变量筛选更快。
- 统计路径更清晰。
- 图表结构更完整。
- 文章逻辑更像高水平研究。
如果你希望把临床论文统计方法从“会做”升级到“会发”,更需要的是一套成熟的分析体系,而不是零散技巧。
解螺旋的思路,正是围绕临床研究流程、统计建模和高通量筛选来帮助研究者提高效率。
总结Conclusion
临床论文统计方法不是附属技能,而是决定文章层级的核心能力。回顾性研究要处理混杂,生存研究要处理时间结局,高通量分析则要求你系统穷举变量,再通过规则筛选建立证据链。真正高质量的论文,既要有方法,也要有逻辑。
如果你正在做临床研究,却总是卡在选变量、选模型、写方法和做结果整合上,可以考虑借助解螺旋,把统计分析和发文路径一次性理顺,让你的数据更接近可发表状态。
- 引言Introduction
- 1. 临床论文统计方法为什么决定文章上限
- 2. 临床论文统计方法的核心框架
- 3. 高通量分析:从“单变量验证”走向“穷举筛选”
- 4. 临床论文如何把统计方法写得更像高水平文章
- 5. 解螺旋如何帮助你把统计方法变成发文能力
- 总结Conclusion