

 15
 分享
引言Introduction
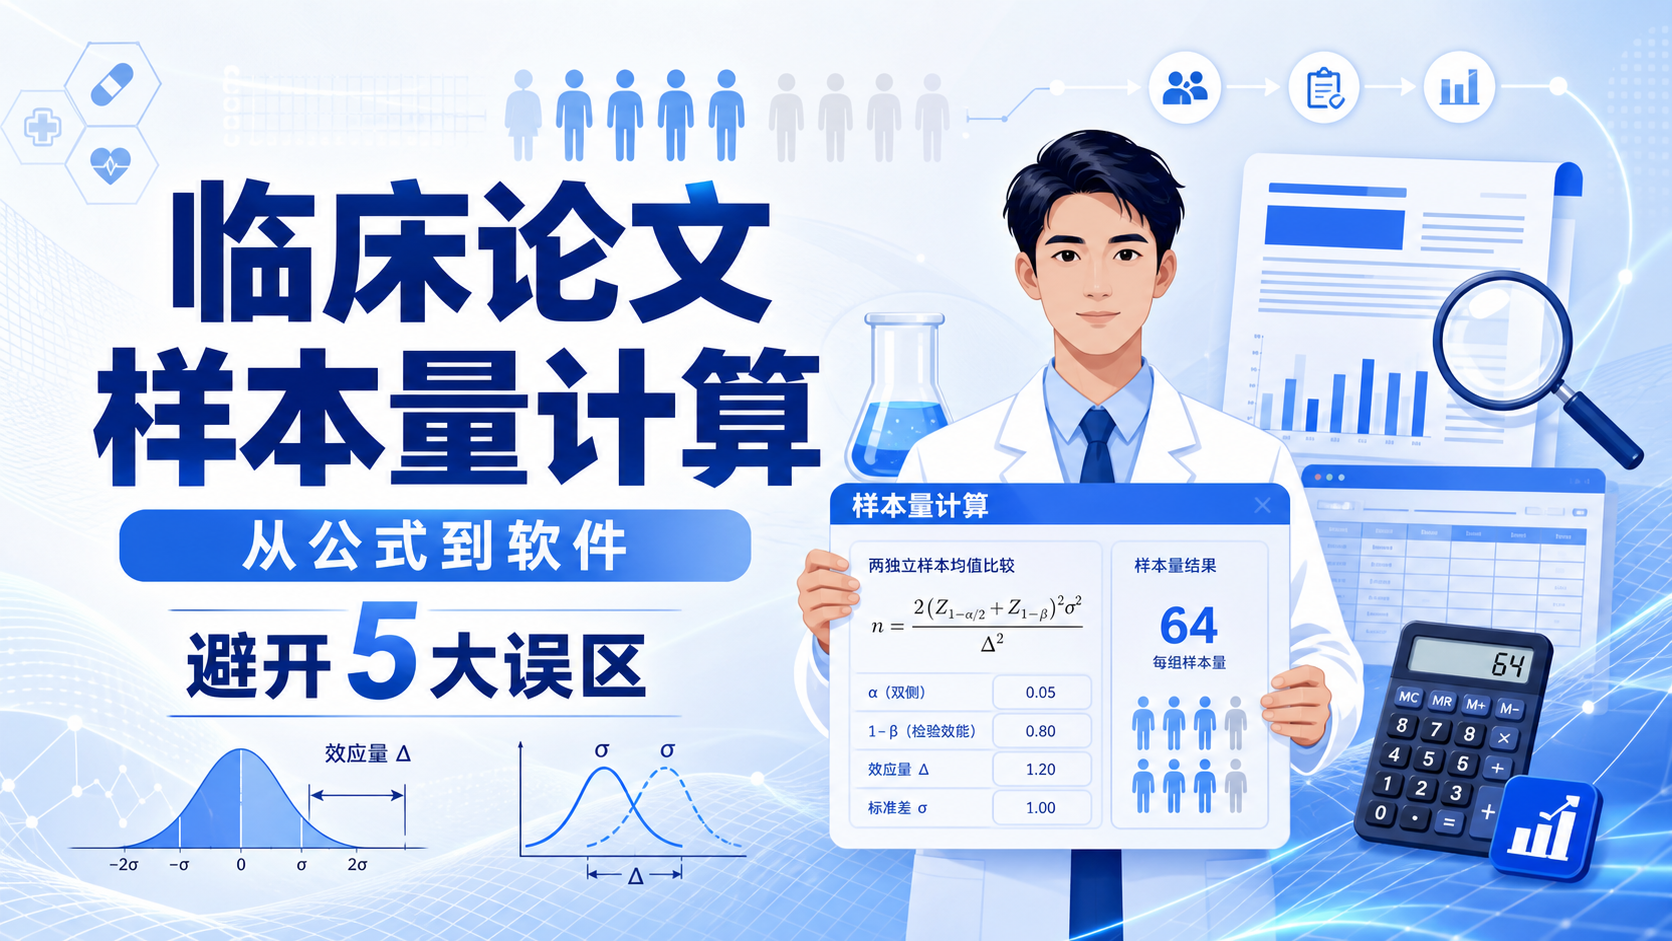
临床论文写作里,样本量常被低估。很多研究不是“没结果”,而是样本量设定不合理,导致研究一开始就站不稳 。要么样本太少,效能不足。要么参数选错,审稿时被质疑。下面从研究设计、参数到软件计算,系统梳理临床论文样本量计算的完整流程。
1. 为什么临床论文样本量必须先于统计分析确定
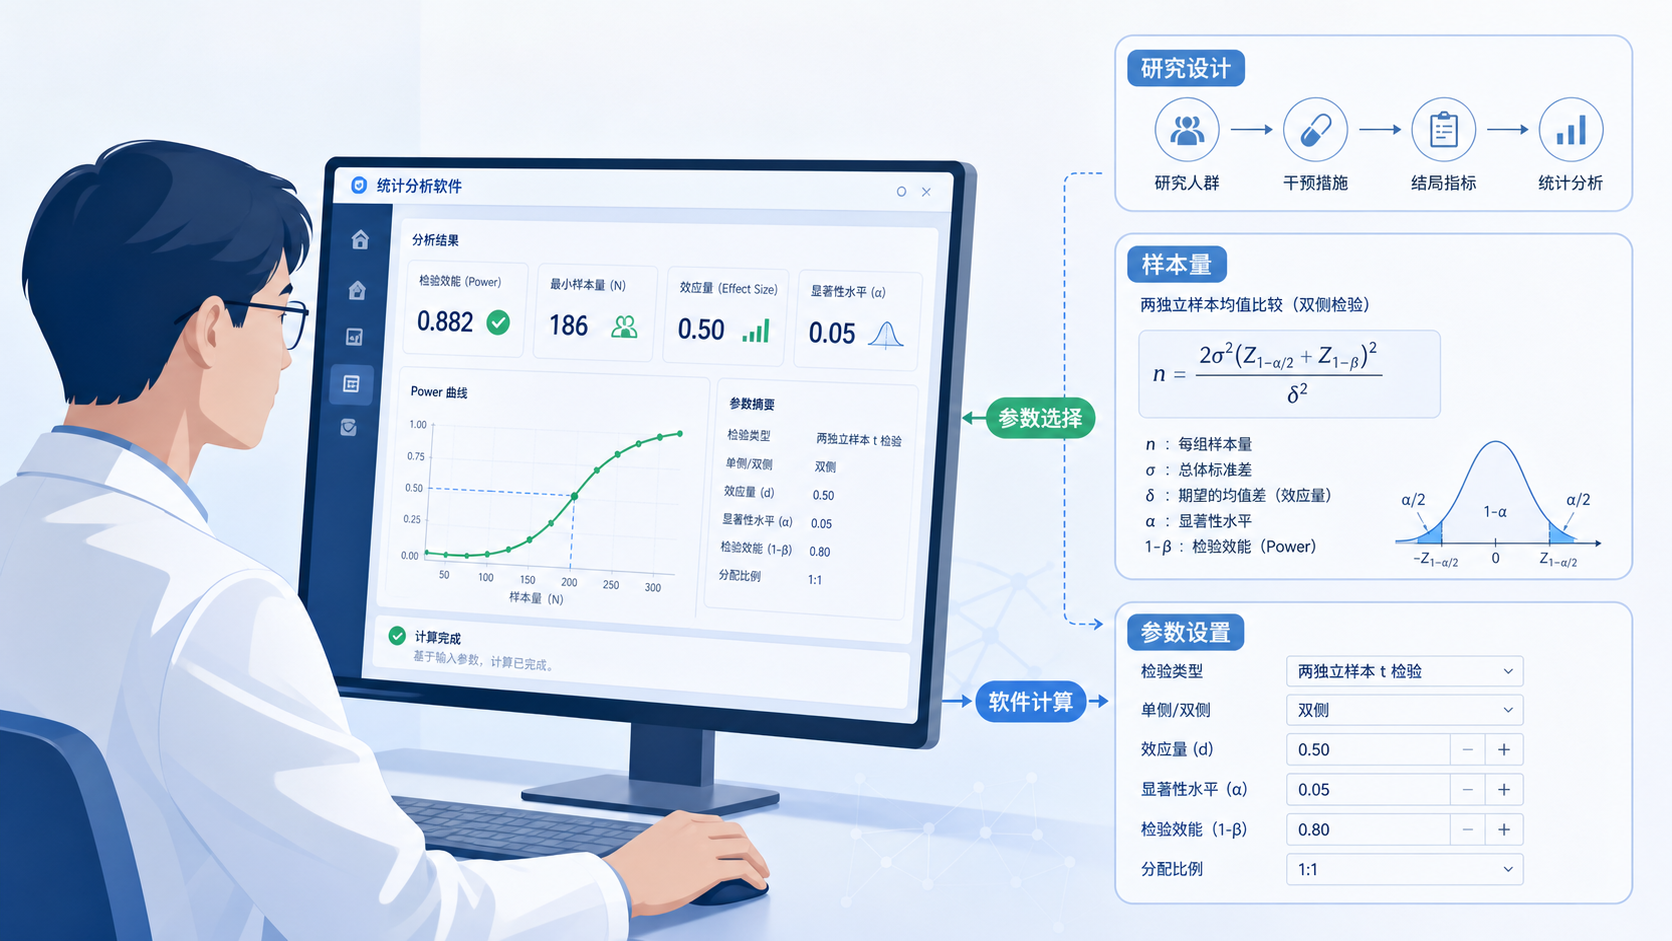
临床论文样本量计算,不是投稿前补做的步骤。它应该在研究设计阶段完成。因为样本量取决于研究问题、结局类型和研究设计 。先定设计,再定公式,最后才是软件计算。
如果你做的是横断面调查,重点通常是患病率或均数估计。如果做的是病例对照研究,重点是暴露与结局的关联。两类研究对应的公式完全不同。脱离研究设计谈样本量,结果往往没有可解释性。
临床研究中还常见一个现实问题。研究者手里只有现成病例,比如100例患者、100例对照,就直接开始写论文。这个做法并不等于不需要样本量。审稿人会问的是,这100例是否足以支撑你的研究结论 。如果理论样本量远高于现有病例,就需要解释抽样限制、病例来源和研究可行性。
1.1 先明确研究问题,再选样本量公式
样本量不是统一答案。它依赖以下核心信息:
- 研究类型,横断面、病例对照、队列研究、随机对照试验。
- 主要结局,率、均数、构成比、OR、RR、差值。
- 参数假设,预期效应量、误差、把握度、显著性水平。
- 抽样方式,简单随机、分层、整群或多阶段抽样。
同样是“临床论文样本量计算”,不同设计对应的计算逻辑完全不同。 这也是为什么研究方案里必须先写清楚研究设计。
1.2 为什么文献参数可以用,但不能照搬
很多人会问,既然文献已报道患病率10%,为什么还要再做研究。原因很简单。文献参数通常来自不同地区、不同人群、不同纳入标准,不能直接代表你的目标人群。
另外,样本量计算本身就依赖一个“预估值”。这个预估值来自文献、前期研究或专家经验。它不是最终真值,而是为了让研究达到可接受精度而做的合理假设。换句话说,样本量计算不是证明答案,而是为了确保研究有能力找到答案。
2. 临床论文样本量计算的核心参数
临床论文样本量计算,最关键的不是软件,而是参数。参数选错,软件输出再漂亮也没有意义。真正决定结果的,是你如何定义效应量、误差、α值和把握度。
一般来说,最常用的参数包括以下几类:
- α值,常设为0.05。
- 把握度,通常设为80%或90%。
- 预期率或预期均数,用于估计总体特征。
- 允许误差,决定结果精度。
- 标准差,常用于均数估计。
- 组间差异,常用于比较研究。
2.1 率的估计:关注精度而不是显著性
如果你的研究目的是估计某种疾病的患病率,比如乙肝表面抗原携带率,那么核心是“估计误差有多大”。这类研究通常关注精度,也就是允许误差Δ。
例如,预计患病率为10%,希望误差控制在1%以内。这里不是说结果必须恰好等于10%,而是希望估计区间足够窄。样本量越大,估计越稳定,置信区间越窄。
这类研究最常见的思路是:
- 设定预计率P。
- 设定允许误差d。
- 设定α值。
- 计算理论样本量。
如果预计率较低,想要把误差压得很小,样本量往往会明显增大。临床研究里这种情况并不少见。
2.2 均数的估计:标准差比均数本身更重要
很多初学者会误以为均数估计要先知道均数。实际上,均数样本量计算更依赖标准差,而不是均数本身 。因为标准差反映离散程度,决定了数据“散得有多开”。
如果目标是估计某工厂人群的白细胞平均水平,研究者需要的是:
- 预计标准差。
- 允许误差。
- 显著性水平。
标准差越大,所需样本量通常越多。因为波动更大,想把平均值估得更准,就需要更多观察对象。这也是临床论文中常被忽视的一点。
2.3 比较研究:效应量决定样本量大小
如果研究目标是比较两组差异,比如病例组和对照组的暴露率差异,样本量计算要围绕效应量展开。常见效应量包括:
- 两组率差。
- 两组均数差。
- OR值。
- RR值。
效应量越小,越难检出差异,样本量就越大。反过来,如果预期差异很明显,所需样本量会相对减少。临床论文里,效应量设定是否合理,直接关系到研究是否可行。
3. 从研究设计到公式选择的标准流程
临床论文样本量计算不是先开软件,而是先走流程。推荐按以下顺序进行。
3.1 第一步,确定研究设计
先判断你的研究属于哪一类。
- 横断面调查,常用于患病率、均数估计。
- 病例对照研究,常用于危险因素分析。
- 队列研究,常用于发病风险比较。
- 干预研究,常用于疗效评价。
研究设计决定统计模型,也决定样本量公式。 这是最基础的一步,不能跳过。
3.2 第二步,明确主要结局指标
一个研究里可以有多个指标,但样本量通常只围绕主要结局计算。比如:
- 主要结局是某病患病率。
- 主要结局是治疗前后某指标变化。
- 主要结局是两组有效率差异。
如果主要结局不清楚,样本量就无法准确设定。临床研究写作中,结局指标必须与样本量计算一一对应 。
3.3 第三步,设定参数并写入方案
在研究设计书中,建议写清楚以下内容:
- 研究类型。
- 纳入标准和排除标准。
- 主要结局指标。
- 统计假设。
- α值和把握度。
- 预期效应量来源。
- 计算方法或软件名称。
这样做的好处是可追溯。后续答辩、伦理审查和投稿时,都能解释清楚样本量从哪里来。这也是临床论文规范性的体现。
4. 常用软件怎么做临床论文样本量计算
在实际操作中,很多研究者会使用PASS软件。它的优势是模块多、适用面广,适合临床研究中常见的多种样本量场景。软件本身不是替代思考,而是执行计算。
4.1 软件计算的基本思路
PASS这类软件的逻辑,本质上是输入参数后,由程序迭代计算出满足条件的样本量。你需要先知道自己要算什么,再在菜单中找到对应模块。软件不会替你判断研究设计,只会根据你输入的参数给出结果。
常见操作流程包括:
- 选择研究类型模块。
- 输入α值。
- 输入把握度或检验效能。
- 输入预期率、均数、标准差或效应量。
- 设定单双侧检验。
- 运行后读取样本量结果。
4.2 以总体率估计为例
假设研究目的是调查某地区乙肝表面抗原携带率,预估为10%,希望误差不超过1%。这类问题适合使用总体率估计模块。
操作时要重点确认:
- 预计率P,0.10。
- 允许误差d,0.01。
- α值,常用0.05。
- 估计方法,选择适合的比例估计模块。
计算结果可能达到数千例,这是正常的。因为当目标是高精度估计总体率时,样本量本来就可能很大 。这类结果不是软件“算大了”,而是研究问题本身要求高精度。
4.3 以总体均数估计为例
如果目标是估计白细胞平均值,软件中应选择均数估计模块。此时输入的关键参数是:
- 预计标准差。
- 允许误差。
- α值。
需要注意,均数估计不一定要填入预计均数本身。很多时候,标准差才是影响样本量的核心变量 。标准差来自前期文献或预实验,更适合用来设定计算基础。
4.4 比较两组差异时的常见设置
如果研究是病例组与对照组比较,或者两组治疗效果比较,软件计算时还要输入组间差异、分组比例和检验效能。常见设置包括:
- 双侧检验。
- 80%或90%把握度。
- 1:1分组,或按实际比例分配。
- 预期差异来自文献或预实验。
如果效应量设定过于乐观,样本量会被低估。 这是临床论文里最容易出问题的环节。
5. 临床论文样本量计算中最常见的误区
很多样本量问题,并不是算不出来,而是前期设定不合理。下面几个误区非常典型。
5.1 把现有病例数当成样本量依据
“我只有100例,所以样本量就是100例。”这句话在实际研究中经常出现,但它不是严格的样本量逻辑。现有样本数只是可用资源,不等于理论所需样本量。 论文中需要说明的是,样本量是否足以支持研究目的。
5.2 直接照搬文献参数
不同医院、地区和年龄构成,都会影响参数。直接照搬其他研究的患病率、标准差或效应量,风险很高。更稳妥的做法是结合本地数据、预实验结果和相关文献,取一个保守值。
5.3 忽略失访和无效率
如果是前瞻性研究、干预研究或长期随访研究,样本量还要考虑脱落率。比如预计失访10%,通常要在理论样本量基础上再上调。不预留脱落空间,最后很容易样本不足。
5.4 混淆统计显著性和临床意义
统计学上显著,不等于临床上有价值。样本量设定时,不能只追求P值。还要考虑差异是否有临床解释意义。临床论文的样本量,最终服务的是临床问题,而不是单纯的显著性。
6. 写进论文和项目申请书时,应该怎么表述
样本量计算完成后,不只是放在统计学部分一句带过。建议在论文和项目申请书中写清楚以下信息:
- 研究设计类型。
- 主要结局指标。
- 参数来源。
- 计算公式或软件名称。
- α值、把握度和允许误差。
- 是否考虑脱落率。
- 最终样本量及其依据。
这样写的好处是透明、规范,也便于审稿人复核。这是临床论文中最基本的可信度建设。
如果你希望把样本量计算、研究设计和统计表述统一到一套可直接落地的写作框架中,可以借助解螺旋。它能帮助你把参数选择、软件操作和论文表达串成完整链条,减少前期反复修改。对于临床论文作者来说,这一步往往比单纯“会算”更重要。
总结Conclusion
临床论文样本量计算,本质上是一个从研究问题出发、经过参数设定、再到软件验证的完整流程。先定研究设计,再定结局指标,再定参数,最后才是软件计算。 只有这样,样本量才有统计学意义,也才经得起伦理、答辩和审稿的检验。
如果你正在准备临床研究项目或论文,不妨先把研究类型、主要结局和参数来源理清,再进入计算环节。需要更高效地完成这一步,可以进一步了解解螺旋,让样本量计算和论文写作真正形成闭环。
- 引言Introduction
- 1. 为什么临床论文样本量必须先于统计分析确定
- 2. 临床论文样本量计算的核心参数
- 3. 从研究设计到公式选择的标准流程
- 4. 常用软件怎么做临床论文样本量计算
- 5. 临床论文样本量计算中最常见的误区
- 6. 写进论文和项目申请书时,应该怎么表述
- 总结Conclusion