10
 分享
引言Introduction
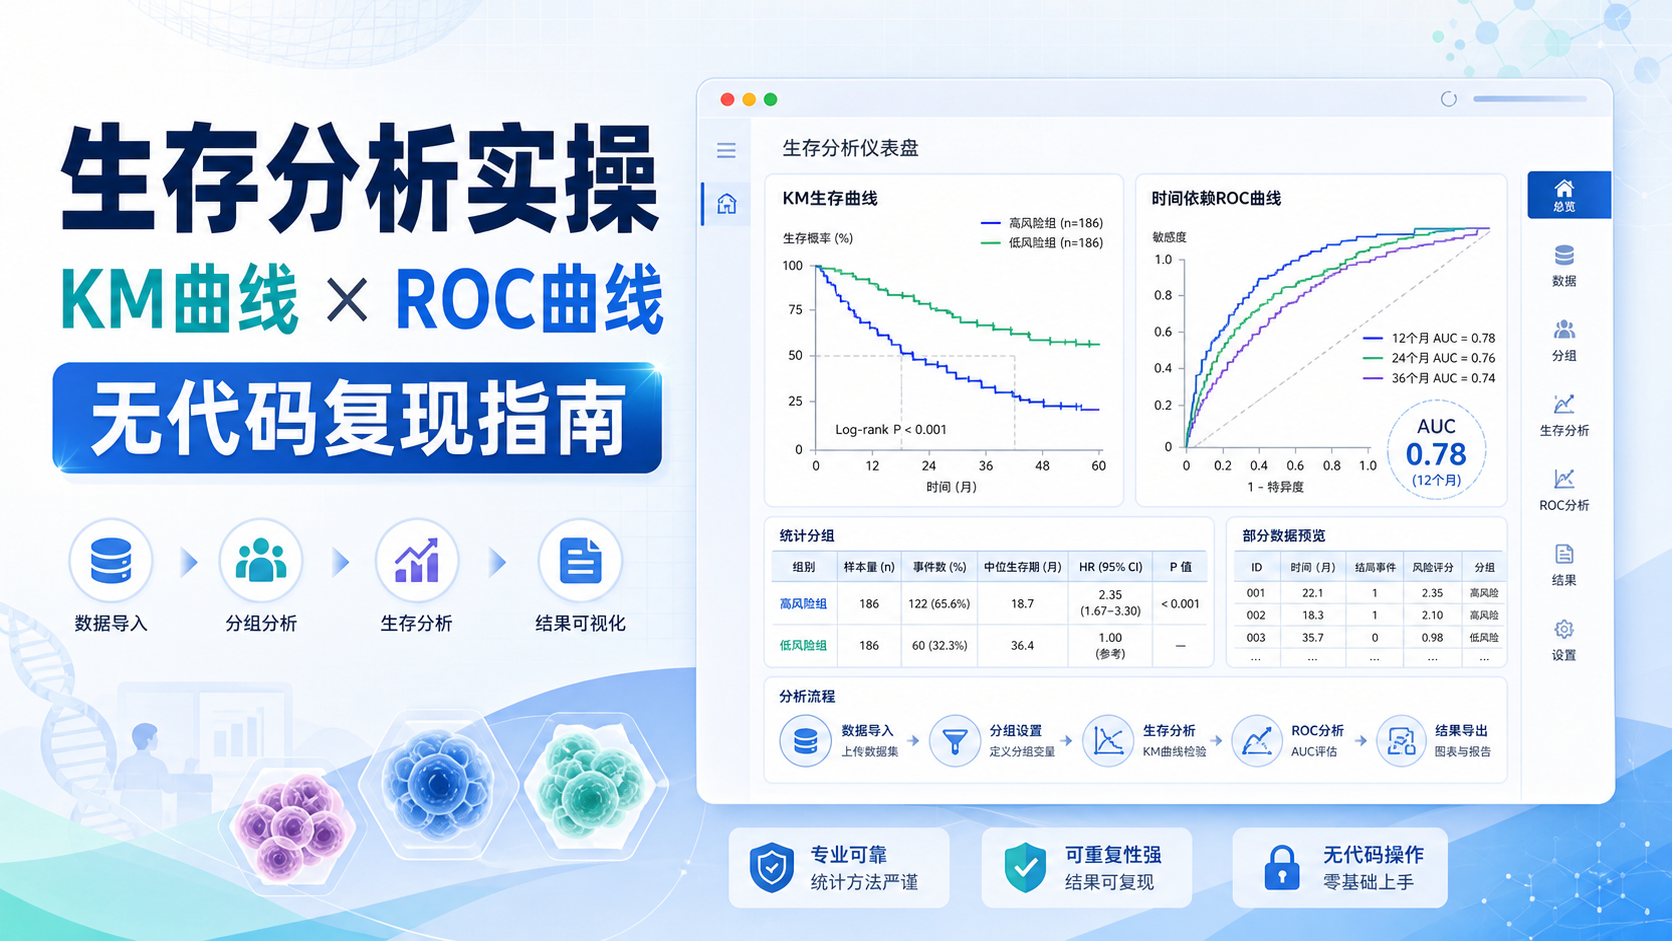
生存分析常卡在两点,数据整理复杂,图形复现耗时。对医学生、医生和科研人员来说,真正难的不是“会不会画图”,而是能否把KM曲线、ROC曲线和模型评价串成一套可投稿流程。本文用一个完整思路,拆解从分组到验证的实操链路。
1. 生存分析实操的核心逻辑
1.1 先明确分析目标
生存分析不是单独画一张图,而是回答三个问题。第一,分组后生存差异是否存在。第二,模型是否具有区分能力。第三,这种区分能力在不同时间点是否稳定。
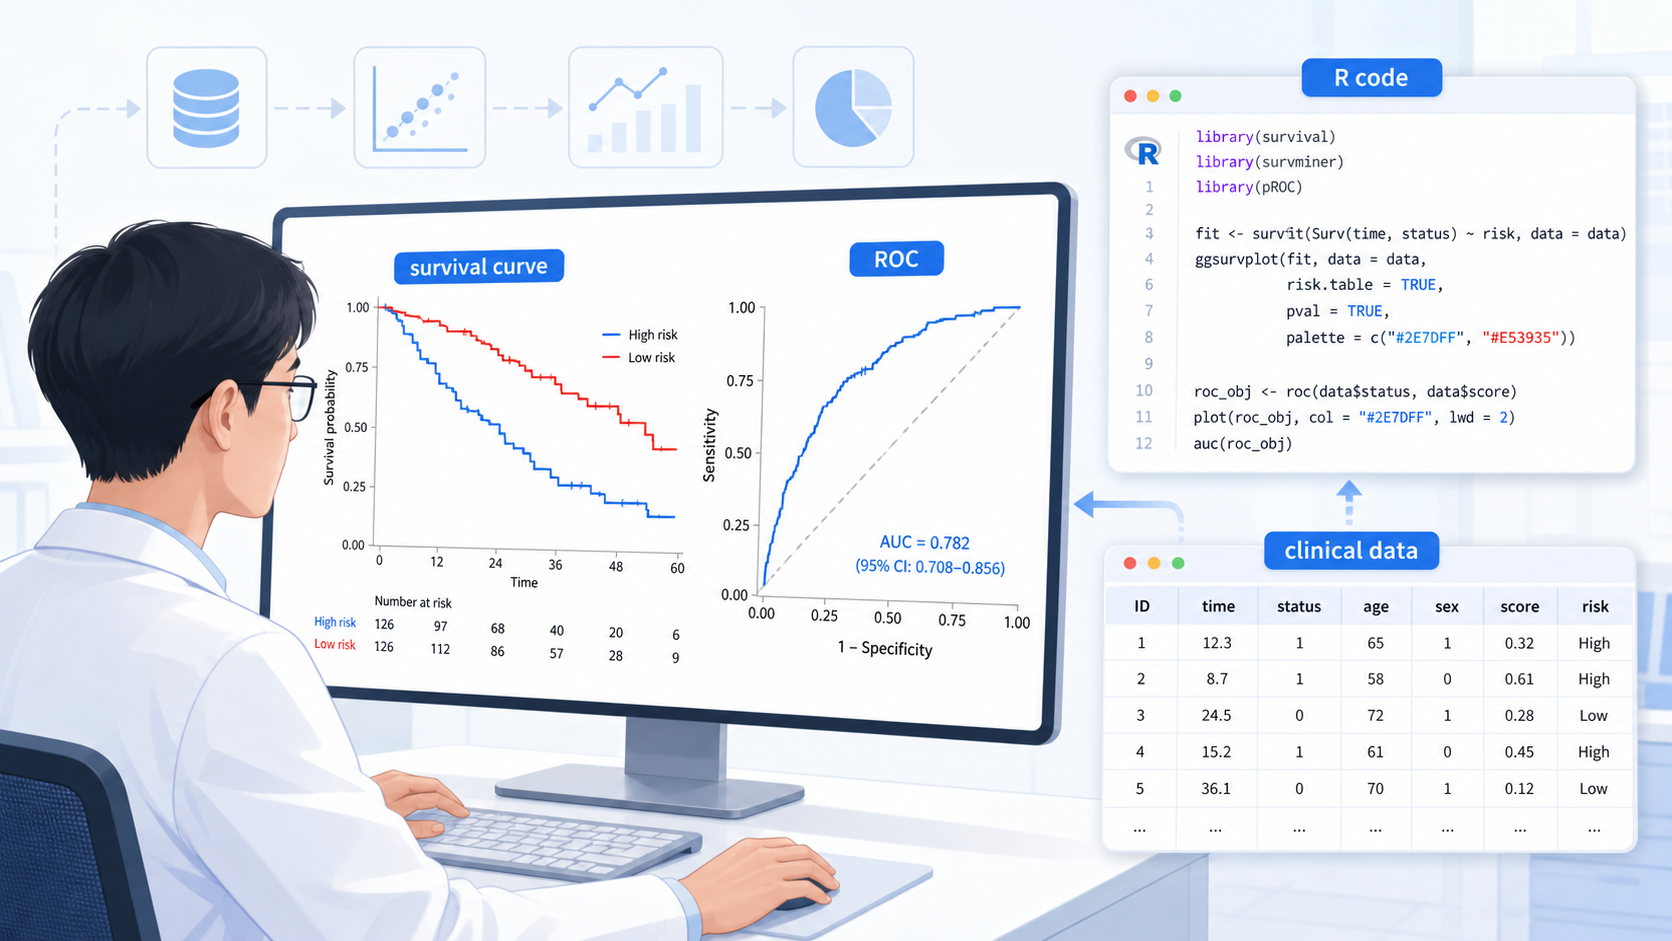
KM曲线解决的是“组间生存是否不同” 。ROC曲线解决的是“模型能否区分结局”。两者结合,才能形成比较完整的模型评价链条。对于论文写作,这也是常见的结果组合。
1.2 常见输入数据结构
标准生存分析通常需要三类信息。
- 生存时间,如os_time。
- 结局状态,如status,通常0表示删失,1表示事件发生。
- 分组或预测变量,如高低表达组,或连续marker值。
在实际项目中,最容易出错的是样本编号不一致。样本ID对齐,是后续所有分析成立的前提。 如果临床信息、表达矩阵和分组文件无法一一对应,KM和ROC都会失真。
1.3 无代码复现的价值
传统实操依赖手工写代码,流程长,重复多。对教学、汇报和初稿验证来说,无代码复现的价值在于把步骤标准化。你只需要知道每一步的输入、输出和判读逻辑,就能快速复现结果。
这也是解螺旋一直强调的思路。把复杂分析拆成可执行模块,能显著降低学习门槛,也更利于团队协作。
2. KM曲线怎么做才规范
2.1 分组前先完成数据匹配
KM曲线的前提,是先有清晰分组。常见做法是按中位数把样本分成High和Low两组,或依据模型风险值划分高低风险组。
在实际操作中,需要先统一样本ID长度,再去重,再和临床表合并。这样做的目的很明确。避免同一患者多条记录进入分析。 一旦重复样本未处理,KM结果和p值都可能被污染。
2.2 生存拟合与Log-Rank检验
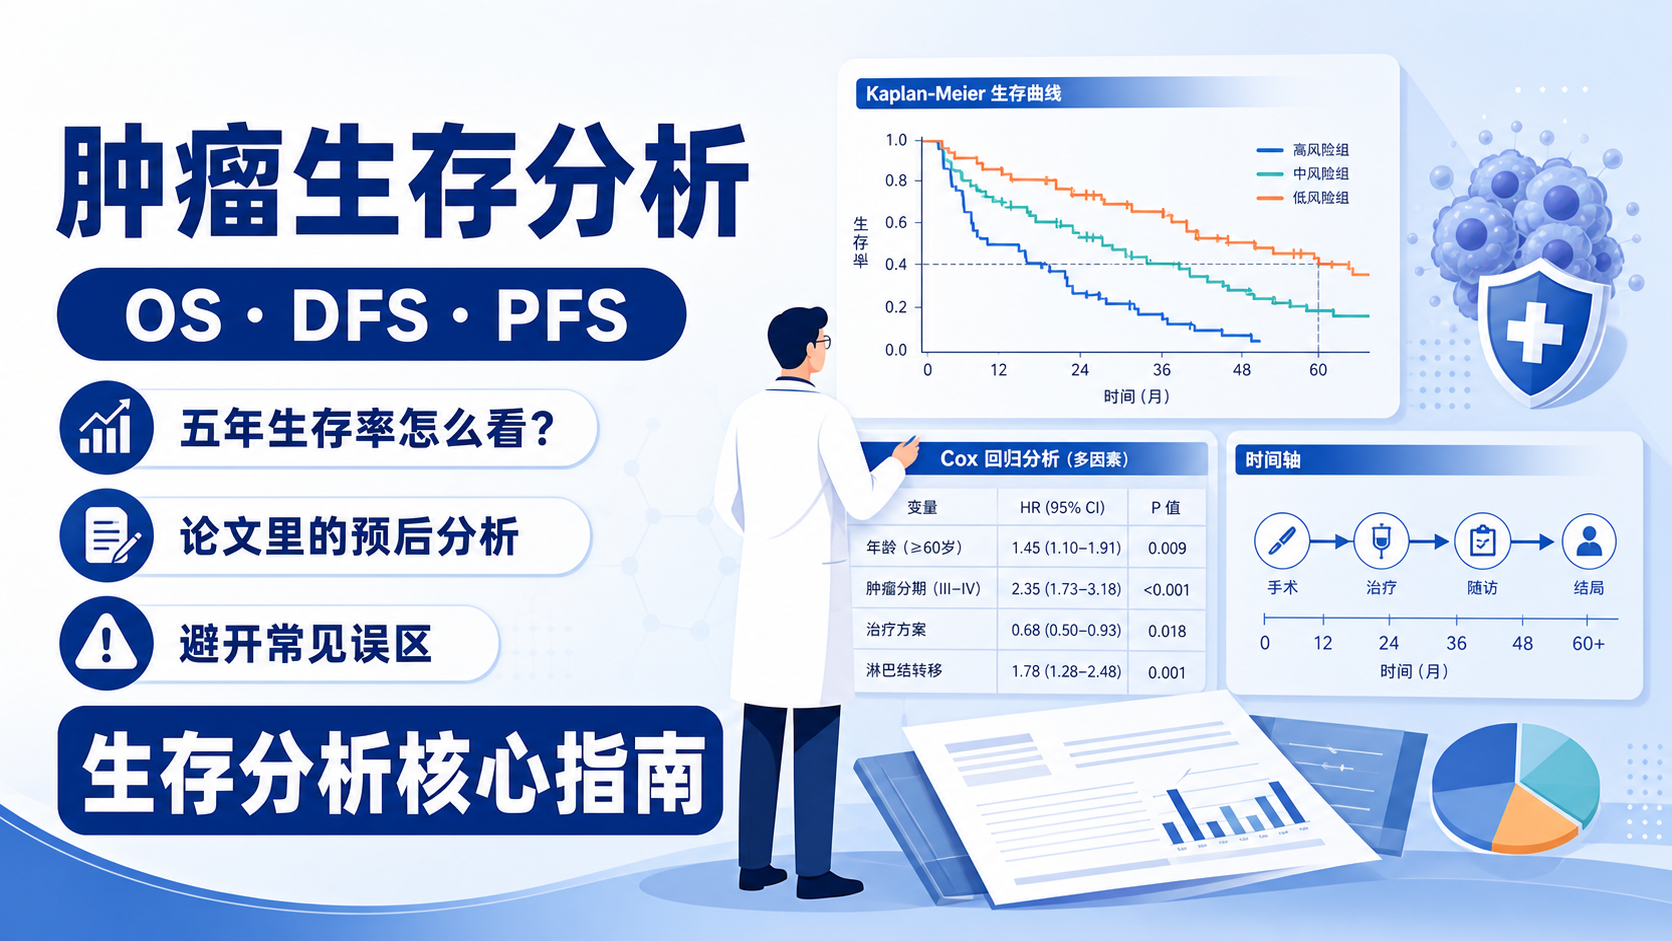
KM曲线本质上是生存函数的非参数估计。拟合完成后,通常需要进一步做Log-Rank检验,用于比较两组生存曲线是否有统计学差异。
判读时建议关注三点。
- 曲线是否明显分离。
- p值是否小于0.05。
- 风险表是否支持两组样本随时间递减的变化趋势。
如果只有曲线“看起来分开”,但p值不显著,论文结论不能写得过满。 这是生存分析中最常见的误区。
2.3 论文图形输出的关键细节
一张规范的KM图,不只是曲线本身,还包括:
- p值。
- 风险表。
- 置信区间。
- 分组标签。
- 图例位置和配色。
临床科研图形最忌讳信息缺失。图太简略,审稿人会问“样本量多少”“删失情况怎样”“分组依据是什么”。因此,KM图必须兼顾可读性和信息完整性。
3. ROC曲线如何用于模型评价
3.1 ROC关注的是区分能力
ROC曲线与KM曲线不是替代关系,而是互补关系。KM强调生存差异,ROC强调预测性能。对于一个预后模型,二者最好同时出现。
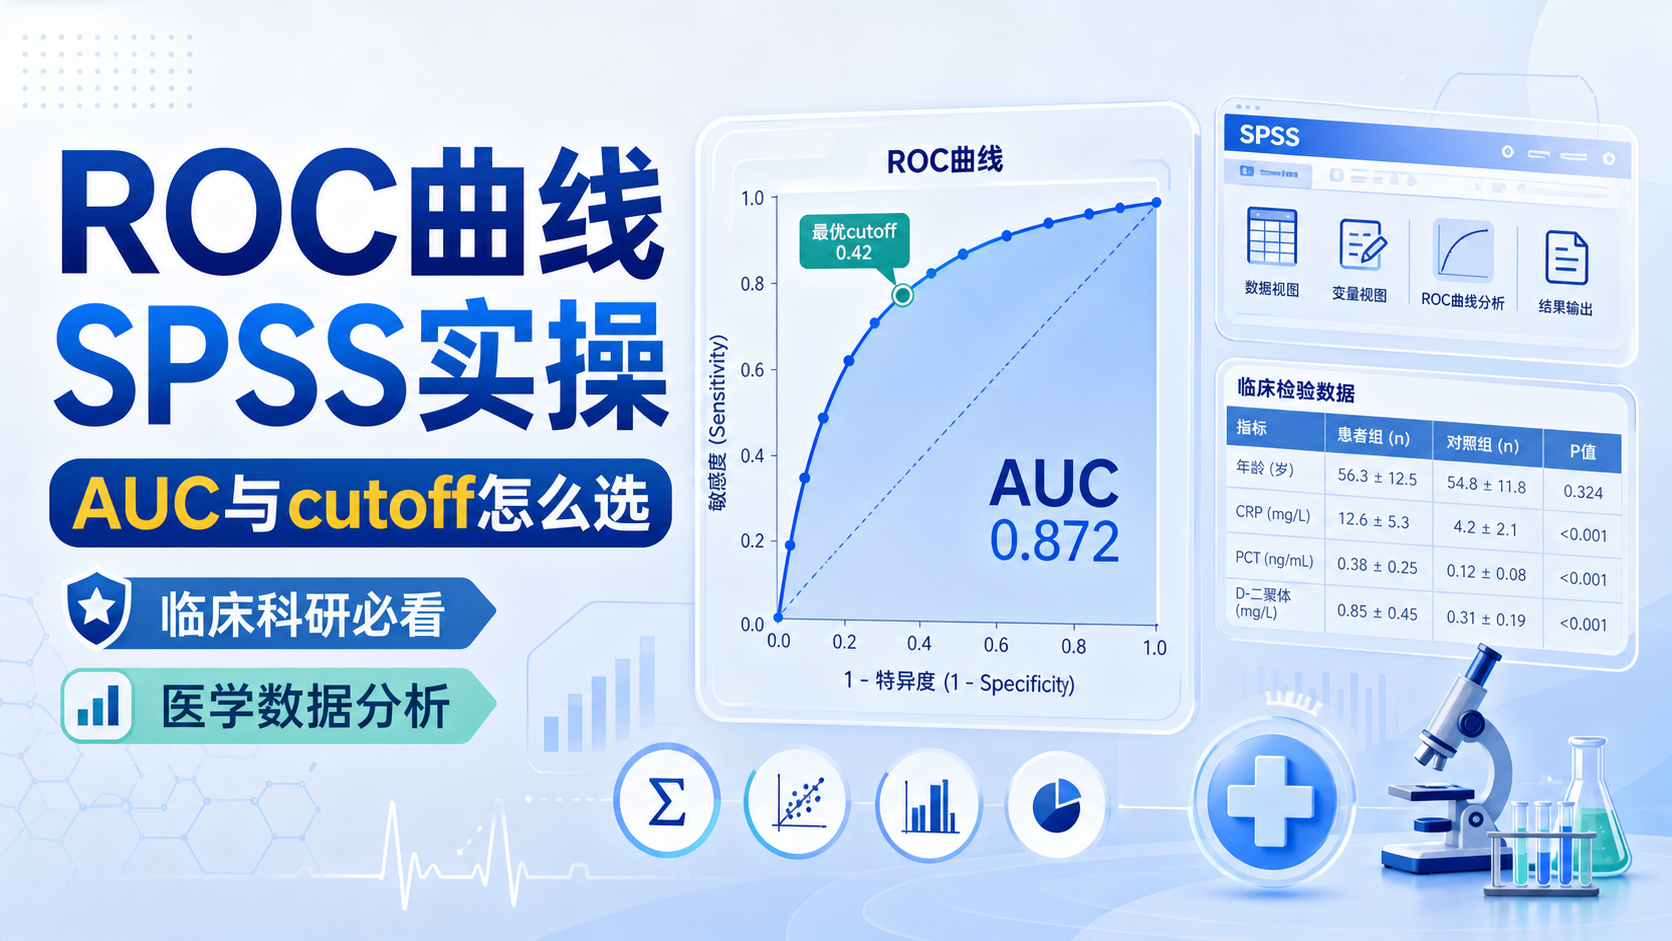
ROC的核心指标是AUC。一般来说,AUC越高,模型区分能力越强。课程实操中也提到,训练集和验证集AUC若能保持在0.7以上,通常说明模型具有一定应用价值。 当然,这不是绝对标准,仍需结合样本量和外部验证判断。
3.2 时间依赖ROC更适合生存资料
普通ROC适合二分类结局。生存资料中,由于结局有时间维度,更常用时间依赖ROC。它可以分别计算1年、3年、5年的AUC,更符合预后研究场景。
这类分析的优势很清楚。
- 能体现不同时间点的预测能力。
- 能比较模型在短期和长期的稳定性。
- 便于构建列线图、风险评分和临床决策模型。
对预后研究而言,时间依赖ROC比单一时间点的二分类ROC更严谨。
3.3 AUC结果怎么判读
AUC并不是越接近1就一定越好。还要看是否过拟合,是否仅在训练集表现优秀,验证集却明显下降。
实操中可参考以下判断。
- AUC < 0.6,区分能力偏弱。
- AUC 0.6-0.7,属于一般。
- AUC ≥ 0.7,通常具有进一步研究价值。
- 训练集高、验证集低,提示泛化能力不足。
真正有价值的模型,不只在单个数据集中表现好,而是在不同数据集上都能维持相对稳定的AUC。
4. 从代码到结果,生存分析实操的标准流程
4.1 先准备数据,再做分析
标准流程通常包括以下步骤。
- 清空环境。
- 加载R包。
- 导入表达矩阵和临床数据。
- 提取目标基因或marker。
- 统一样本ID并去重。
- 合并生存时间和状态。
- 完成分组。
- 绘制KM曲线。
- 进行时间依赖ROC分析。
- 输出AUC和图形。
顺序不能乱。 很多初学者喜欢先画图再补数据,结果往往是数据结构不匹配,分析对象不统一。
4.2 KM与ROC最好在同一逻辑下完成
如果KM和ROC来自不同分组逻辑,结果就不容易解释。比如KM用中位数分组,ROC却用另一个阈值,审稿人会追问一致性问题。
因此,建议保持统一的分析框架。
- 同一批样本。
- 同一套分组规则。
- 同一变量体系。
- 同一生存终点定义。
这样得到的图,才能相互支撑。KM证明差异存在,ROC证明模型能分层。 这就是完整的结果闭环。
4.3 常见错误与规避方法
生存分析中常见的错误主要有四类。
- 样本ID未去重。
- status编码反了。
- 生存时间单位混乱。
- 训练集和验证集变量不一致。
其中最危险的是时间单位问题。月、天、年混用,会直接影响ROC时间点解释。在作图前必须统一单位,并在图注中明确写出。
5. 让生存分析更快落地的实用建议
5.1 报告结果要兼顾统计与临床解释
好的结果不只是“有显著性”,还要能回答临床问题。比如,某个marker是否能区分高危患者,是否适合用于预后分层,是否值得进一步做外部验证。
建议在结果部分明确写出以下内容。
- 分组策略。
- KM检验结果。
- 1年、3年、5年AUC。
- 训练集与验证集的一致性。
- 可能的临床意义。
统计结果只是基础,临床解释才是投稿时真正加分的部分。
5.2 AI无代码复现适合哪些场景
无代码复现特别适合三类场景。
- 教学演示。
- 论文初稿验证。
- 团队协作中的快速结果确认。
对于科研人员来说,它的意义不在于替代统计学,而在于让你更快验证假设,减少重复劳动。尤其是在模型搭建早期,先快速看见KM和ROC结果,再决定是否深入建模,是更高效的路径。
5.3 用解螺旋提升复现效率
如果你希望把生存分析实操真正变成稳定流程,解螺旋的课程和方法论会更适合系统学习。它把复杂的生信分析拆成模块化步骤,适合从数据整理、KM曲线到时间依赖ROC的完整复现。
对于想提高论文产出效率的人来说,解螺旋的价值在于把“会看结果”变成“能独立复现结果”。 这比单纯记代码更重要。
总结Conclusion
生存分析的关键,不是单独会画KM或ROC,而是能把数据整理、分组、拟合、检验和评价串成完整流程。KM曲线回答生存差异,ROC曲线回答预测能力,二者结合才是规范的预后分析。 对医学生、医生和科研人员来说,掌握这一套逻辑,比零散记忆代码更重要。若你希望更高效地完成生存分析实操,并快速复现论文级图形,可以进一步了解解螺旋的系统化方法与工具支持。

- 引言Introduction
- 1. 生存分析实操的核心逻辑
- 2. KM曲线怎么做才规范
- 3. ROC曲线如何用于模型评价
- 4. 从代码到结果,生存分析实操的标准流程
- 5. 让生存分析更快落地的实用建议
- 总结Conclusion