6
 分享
引言Introduction
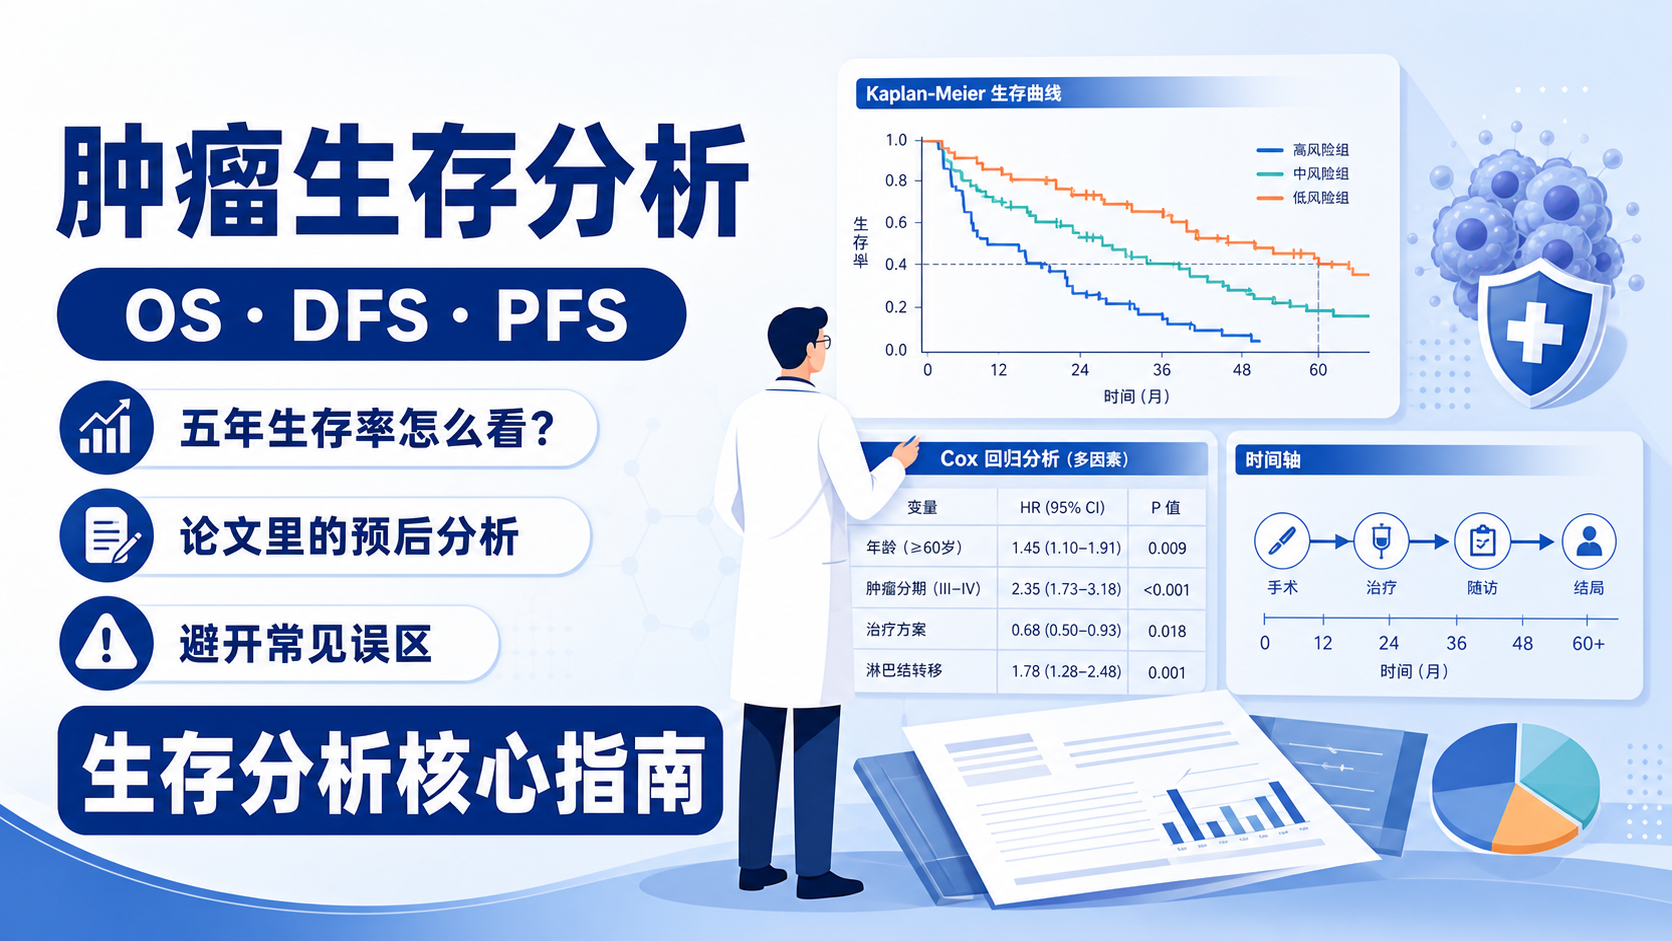
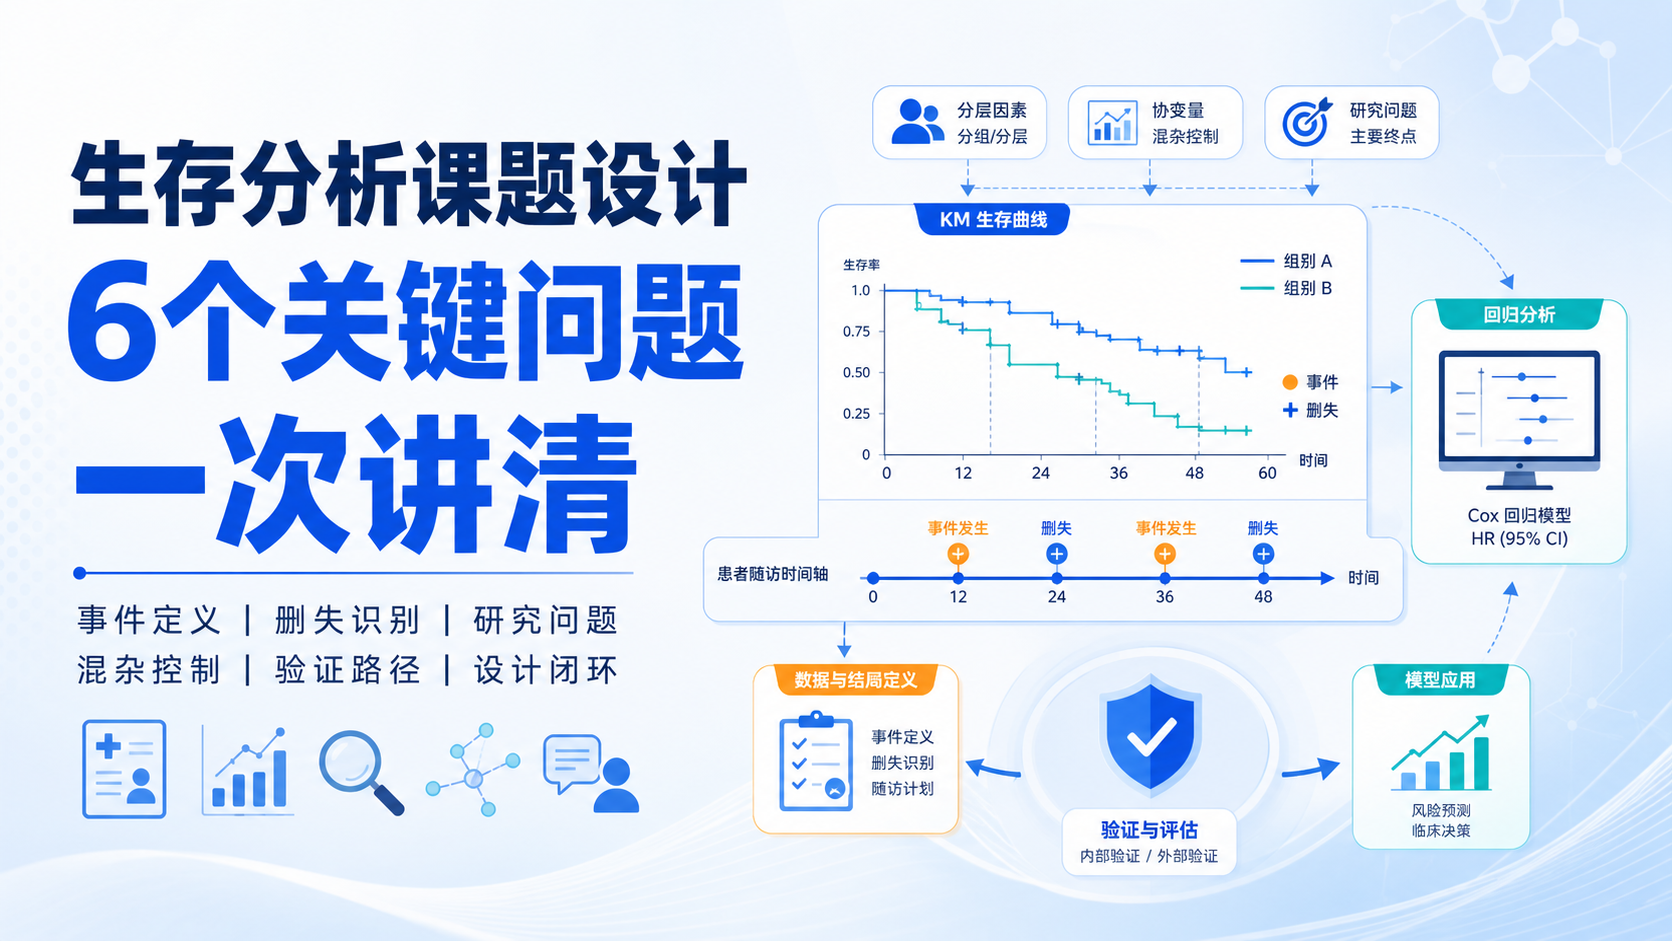
生存分析不是把数据丢进软件就能出结果。很多课题失败,不是模型错了,而是设计一开始就偏了。时间、事件、删失、终点定义,只要一个环节不清楚,后面的结果就很难解释。
1. 先定义“事件”,再谈生存时间
1.1 终点必须可量化、可重复
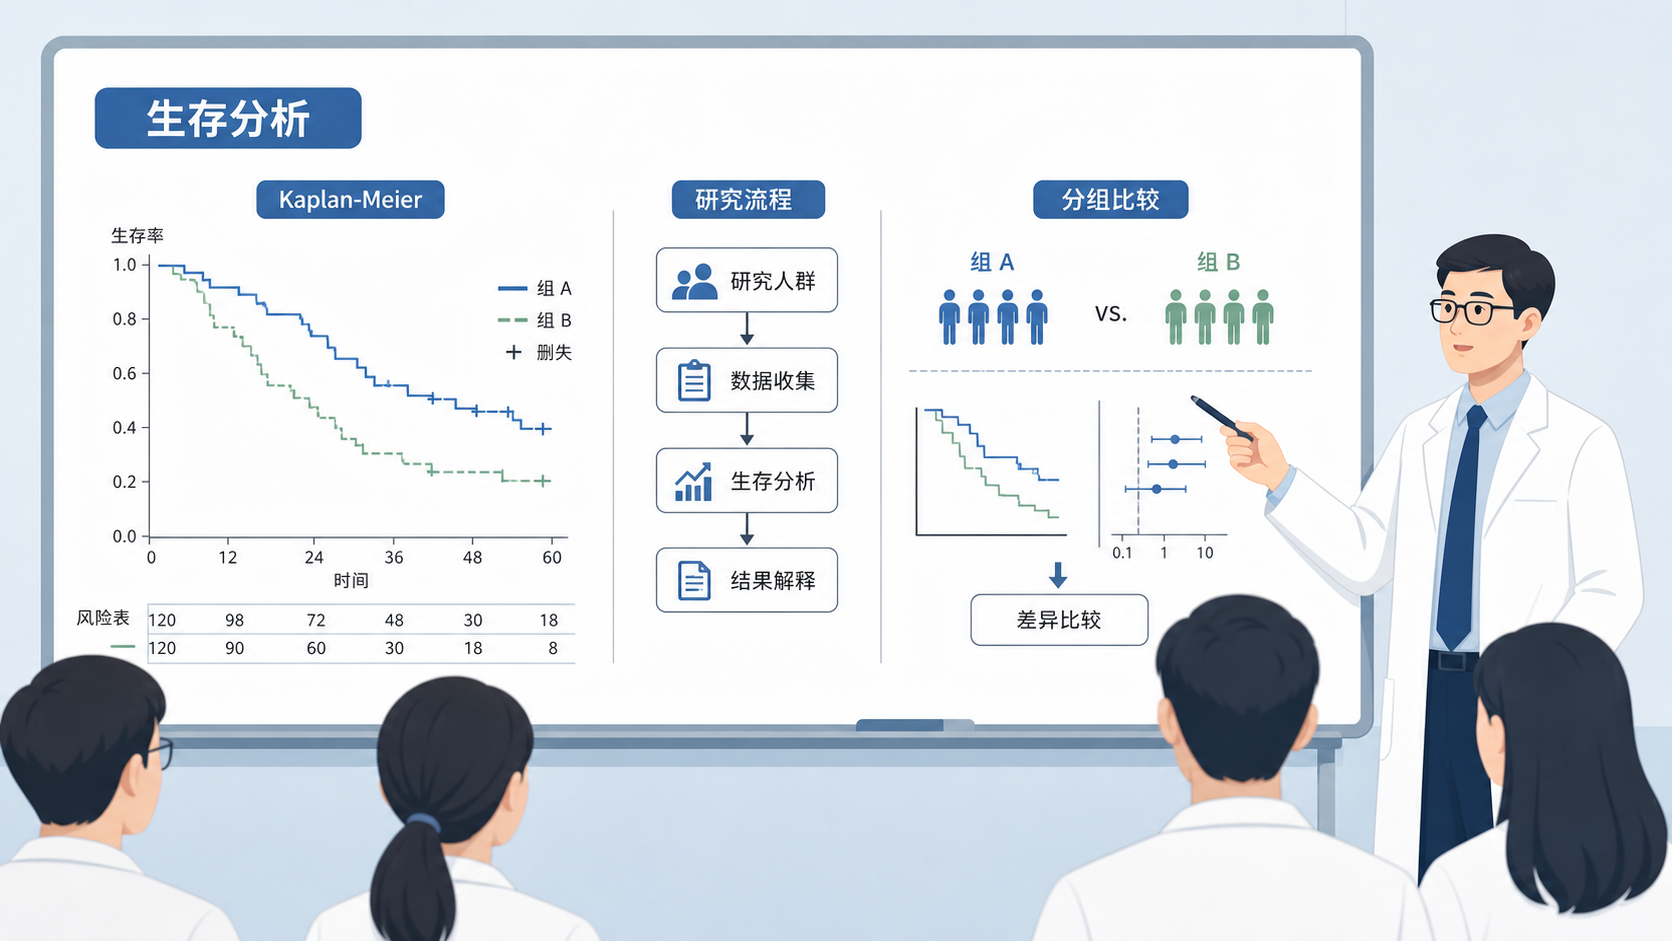
生存分析的核心不是“活了多久”,而是某个事件发生之前的时间 。这个事件可以是死亡、复发、进展、感染、再入院。不同终点对应不同研究问题,不能混用。
在课题设计阶段,必须先回答三个问题。
- 结局事件是什么。
- 事件是否能够被准确记录。
- 事件定义是否在全队列中一致。
如果终点不统一,Kaplan-Meier曲线再漂亮也没有解释力。临床研究中最常见的错误之一,就是把“总生存”“无进展生存”“疾病特异生存”混为一谈。终点不同,统计含义完全不同。
1.2 时间起点也要统一
时间变量不是简单记录“多久”。它必须从同一个起点开始计算。常见起点包括确诊日、手术日、入组日、治疗开始日。
如果起点不一致,生存时间就不可比。比如一部分患者从确诊日算起,另一部分从手术日算起,结果会系统性偏移。这会直接影响HR、P值和曲线形态。
导师在看课题时,通常会先问一句:你的时间零点是什么。这个问题看似基础,但它决定了整个研究框架是否成立。
2. 识别删失类型,避免把“不完整数据”当成“缺失数据”
2.1 删失不是错误,是生存数据的常态
生存数据最重要的特点之一,就是存在删失。删失意味着受试者在观察期内没有出现目标事件,但也未必能完整随访到结局。这不是异常,而是生存分析必须处理的现实。
最常见的是右删失。比如研究结束时患者仍存活,或者中途失访,事件是否发生无法确认,只知道其生存时间至少超过某个时点。
如果把这些样本直接删掉,样本量会缩小,偏倚也会增加。生存分析方法的价值,就在于它能合理利用这些信息。
2.2 右删失最常见,左删失和区间删失要提前识别
在绝大多数临床课题中,最常见的是右删失。它适用于“随访到某时点仍未发生事件”的情形。左删失和区间删失较少见,但在特定场景中必须考虑。
- 左删失,知道事件在某时点前已发生,但不知道准确时间。
- 区间删失,知道事件发生在两个观察时间之间。
- 右删失,知道事件尚未发生,或无法继续观察。
如果课题设计阶段没有区分删失类型,后续模型选择就容易出错。
这也是很多初学者做生存分析时最容易忽略的地方。
3. 明确研究问题,决定用描述、差异、相关还是回归
3.1 生存分析不是只有KM曲线
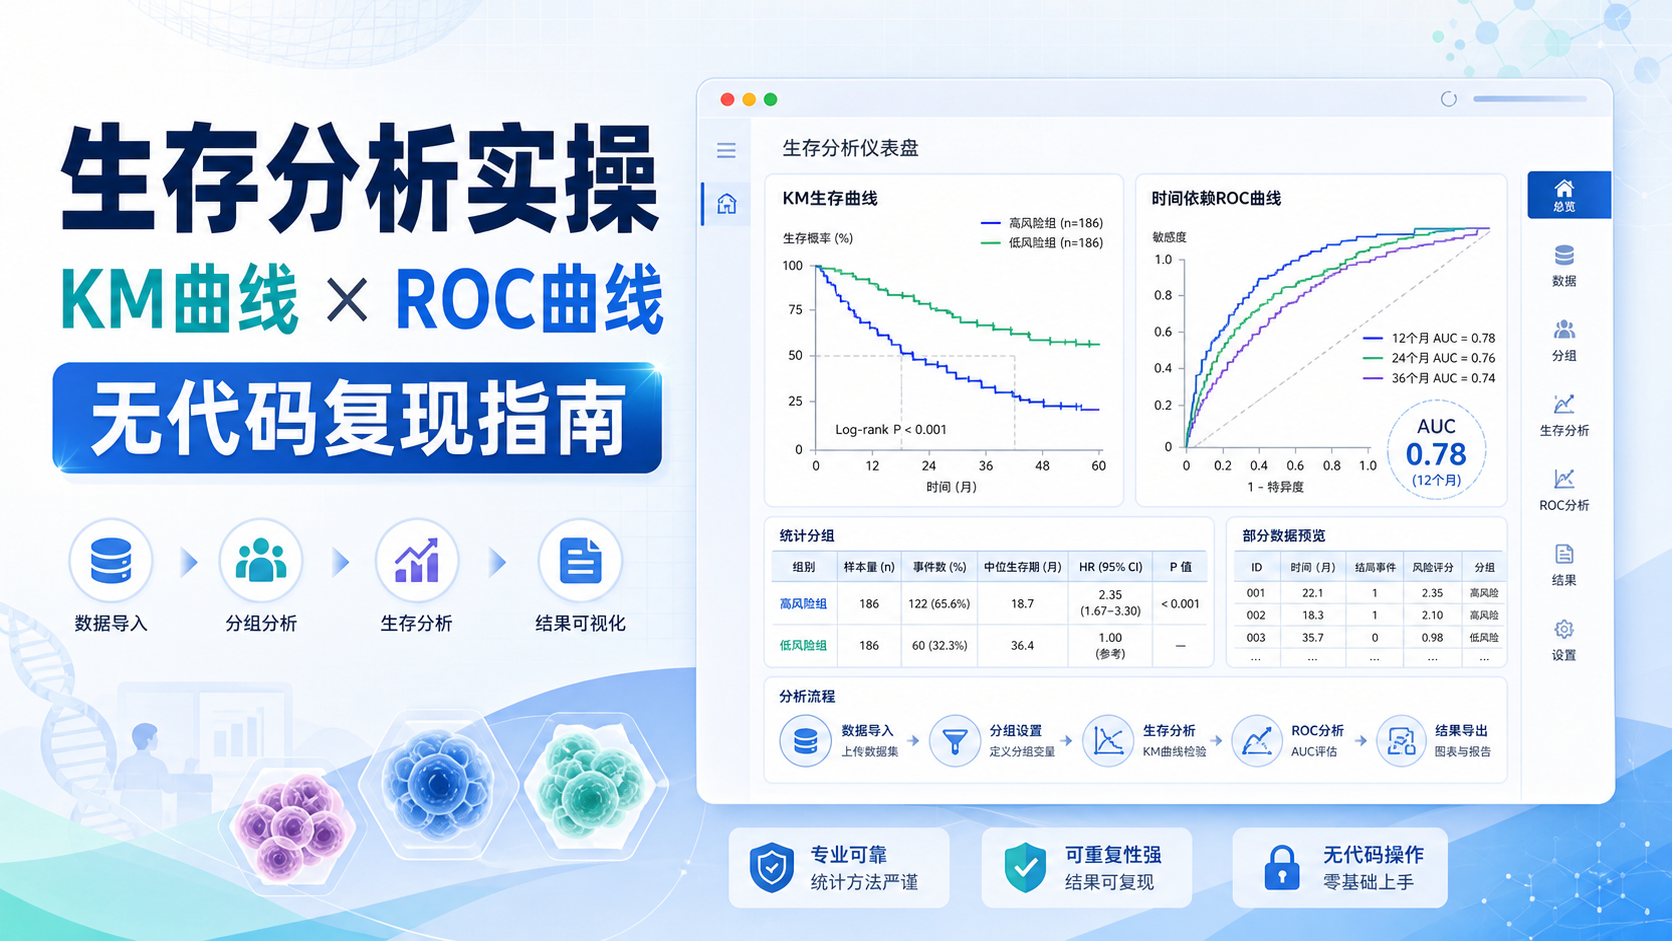
很多人一提生存分析,只想到Kaplan-Meier曲线和log-rank检验。实际上,生存分析是一个方法体系,不只是画图。
通常可以分成四类问题。
- 描述,某组患者的生存分布如何。
- 差异,不同组之间是否有生存差别。
- 相关,某变量与生存结局是否相关。
- 回归,在调整混杂因素后,哪些变量仍然独立影响结局。
如果你的研究目的只是比较两组差异,KM和log-rank往往就够了。
如果你想回答“哪些因素独立影响预后”,就必须进入Cox回归或其他多变量模型。
3.2 课题问题决定统计策略
导师设计课题时,最看重的不是你会不会操作软件,而是你有没有先把科学问题说清楚。
例如:
- 只想比较治疗A和治疗B的生存差异,重点是组间比较。
- 想找出影响预后的关键因素,重点是多因素分析。
- 想建立临床预测模型,重点是变量筛选、建模和验证。
研究问题不同,统计路径完全不同。
如果前期没有定义清楚,后面很容易出现“图做出来了,但回答不了问题”的情况。
4. 提前处理混杂因素和分层变量,避免结果失真
4.1 预后研究里,混杂是常态
临床生存数据很少是“单因素决定结局”。年龄、分期、治疗方式、合并症、病理类型,这些变量往往同时影响结局。
如果不控制混杂因素,单纯比较两组生存曲线,结论可能是假的。
例如,一组患者年龄更大、分期更晚,即使治疗方案相同,生存曲线也可能更差。此时观察到的差异,不一定来自治疗本身,而可能来自基线不平衡。
所以,课题设计阶段就要考虑哪些变量必须纳入模型。
4.2 分层分析要服务于研究目的
分层分析不是为了“多出几张图”,而是为了回答更具体的问题。常见分层变量包括性别、年龄、分期、治疗方式、分子分型。
分层分析适合以下场景:
- 某变量是否在不同亚组中作用一致。
- 是否存在交互效应。
- 某治疗只在特定人群中有效。
但分层不能过度。样本量不足时,分层过多会导致每层样本过少,结果不稳定。这也是为什么导师会强调,设计时要兼顾科学性和可行性。
5. 先想清楚验证路径,再决定课题能不能落地
5.1 好课题必须可验证
一个好的生存分析课题,不只是能在数据库里跑出显著性,还要能被后续验证。验证路径至少要提前想三步。
- 统计结果是否稳定。
- 关键变量是否有临床解释。
- 是否有实验、临床或外部队列支持。
如果一个结论只能停留在单一数据库,可信度就有限。尤其是做科研发表时,审稿人最常问的就是:结果能否复现,是否有外部证据支持。
5.2 常见的验证方式要与资源匹配
不同团队的验证条件不同。基础实验室、临床科室、病理平台,适合的验证方式并不一样。
- 基础实验条件较好,可考虑qPCR、Western blot、功能实验。
- 临床资源较强,可考虑独立队列、病理免疫组化。
- 样本有限时,优先做成本更低、可重复性更高的验证。
验证不是越多越好,而是越匹配越好。
这一点非常重要。很多课题失败,不是没有结果,而是验证路径与研究资源不匹配。
6. 导师最关注的,不是“会不会做”,而是“设计是否闭环”
6.1 一个成熟的生存分析课题,必须形成闭环
从导师视角看,生存分析课题设计至少要回答五件事。
- 事件定义是否明确。
- 时间起点是否统一。
- 删失处理是否合理。
- 统计方法是否匹配研究问题。
- 验证路径是否可行。
这五点连成闭环,课题才有可发表性。任何一个环节断裂,都会影响结果解释。
6.2 解螺旋式训练的价值,在于把设计变成习惯
真正的能力,不是做一次成功,而是能反复做对。生存分析也是如此。你需要不断练习识别终点、判断删失、选择模型、检查混杂,并从每一次结果中复盘。
对医学生、医生和科研人员来说,最有效的方式不是只看教程,而是把方法论变成自己的思维框架。持续训练、反复校正、及时反馈,才是掌握生存分析教程的关键。
如果你想让课题设计更稳、更快、更接近发表标准,可以借助解螺旋的系统化支持,把选题、设计、分析和验证串成一条线,少走弯路。
总结Conclusion
生存分析课题设计的关键,不在于软件操作,而在于前期设计是否严谨。先定义事件,再统一时间起点;先识别删失,再选择模型;先明确研究问题,再决定统计路线;最后补上可行的验证路径。
如果你正在做生存分析教程相关课题,建议先用这五个关键点自查一遍。把框架搭稳,后面的分析才有意义。想进一步提升课题设计质量,可以关注解螺旋 ,用更系统的方法把生存分析真正做扎实。

- 引言Introduction
- 1. 先定义“事件”,再谈生存时间
- 2. 识别删失类型,避免把“不完整数据”当成“缺失数据”
- 3. 明确研究问题,决定用描述、差异、相关还是回归
- 4. 提前处理混杂因素和分层变量,避免结果失真
- 5. 先想清楚验证路径,再决定课题能不能落地
- 6. 导师最关注的,不是“会不会做”,而是“设计是否闭环”
- 总结Conclusion