14
 分享
引言Introduction
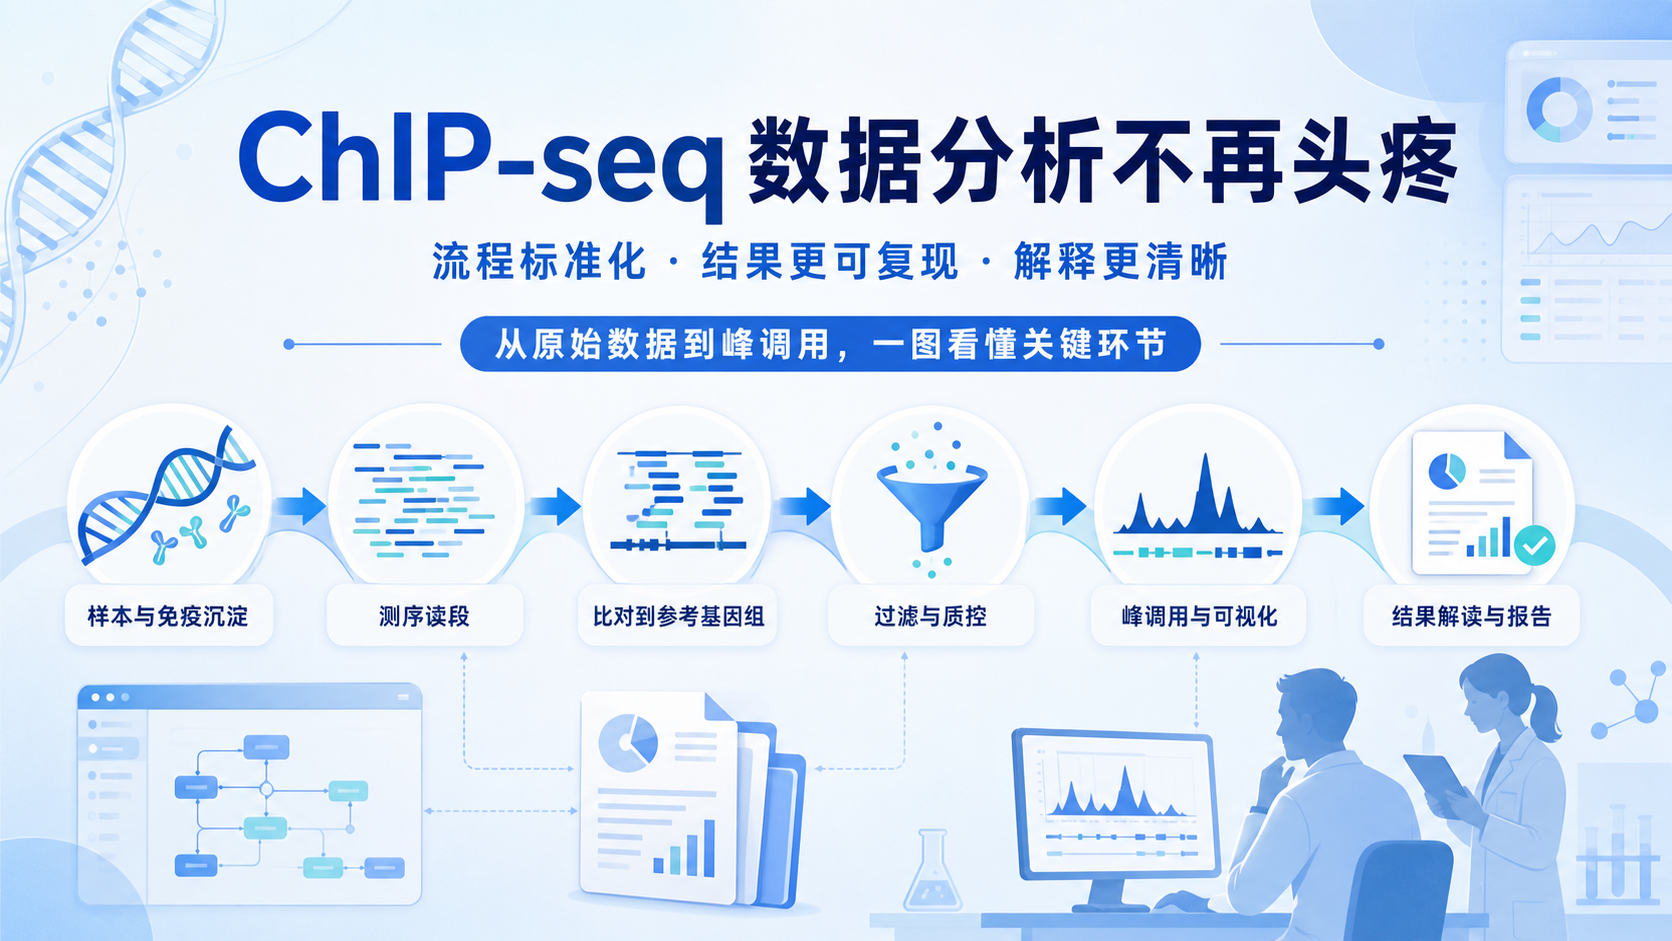
ChIP-seq原始数据一多,很多人会卡在质控、比对、峰调用和可视化这几步。流程看似固定,但工具切换频繁,参数多,结果还要能复现。对医学生、医生和科研人员来说,真正难的不是实验,而是把数据分析做对。
1. ChIP-seq数据分析为什么总让人头疼
1.1 原始数据只是起点,不是终点
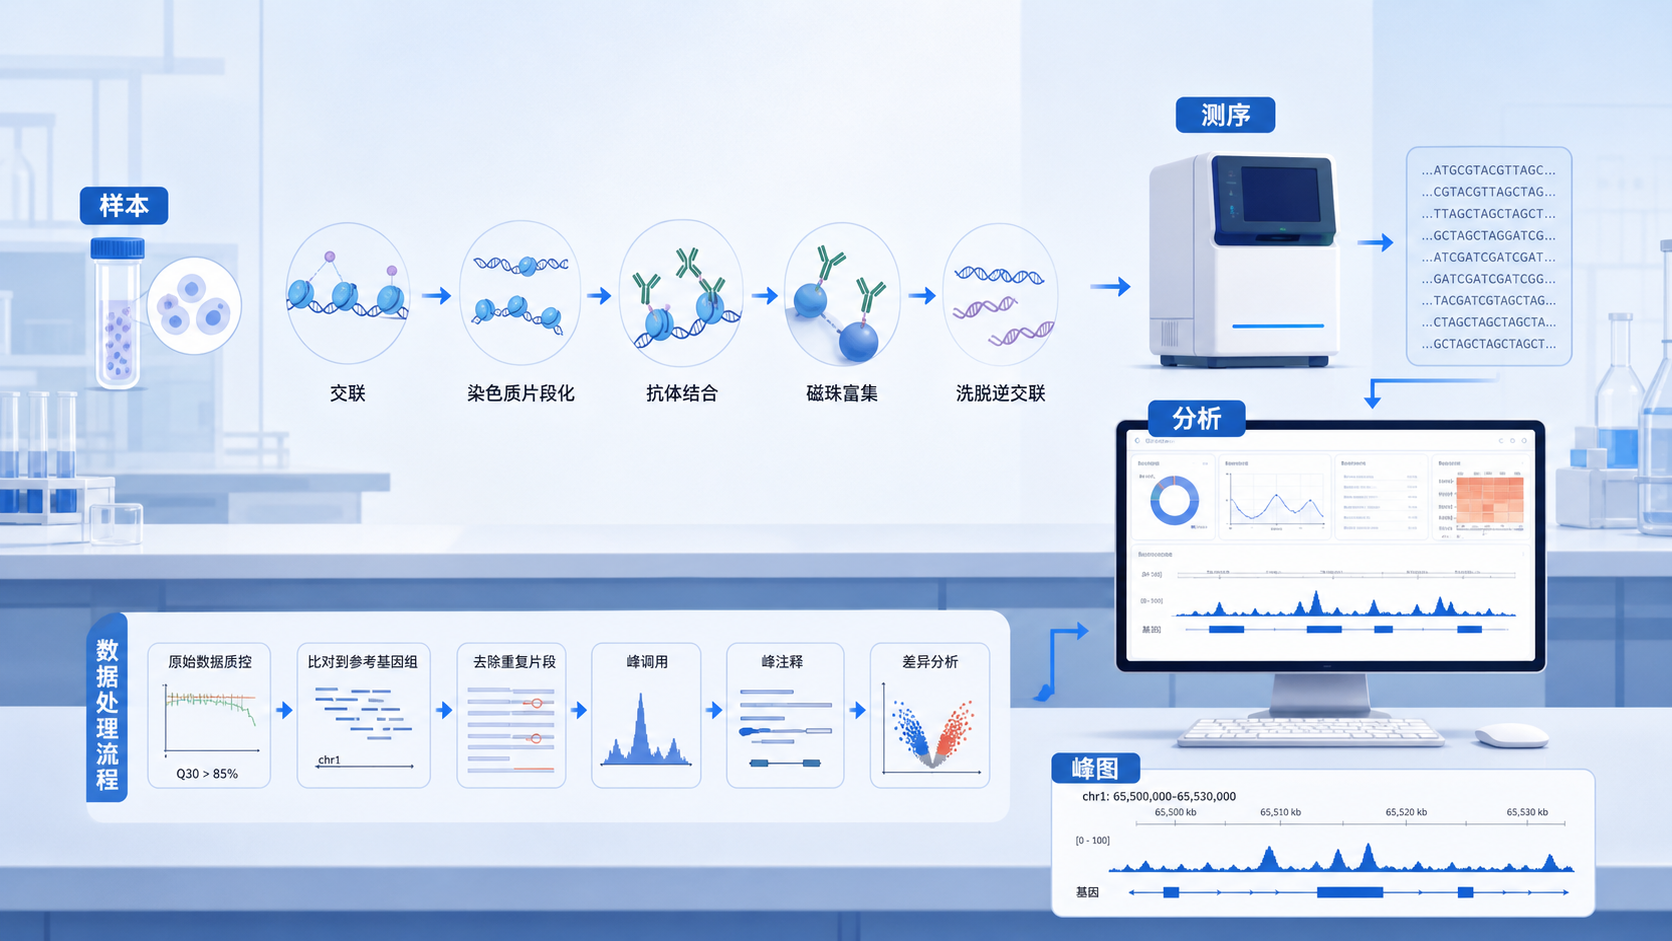
ChIP-seq实验结束后,拿到的通常不是结论,而是原始测序数据。后续还要完成一整套分析。常见步骤包括:
- 原始数据质控。
- 比对到参考基因组。
- 去重复和过滤低质量比对。
- 峰调用。
- 富集分析与注释。
- 可视化与结果整理。
每一步都可能影响最终结论。 如果前面的参数设置不稳,后面的峰位、富集倍数和差异比较都会被放大偏差。
1.2 结果不难看懂,难在流程不统一
ChIP-seq的分析本身并不是无解。真正的问题在于,不同软件、不同脚本、不同版本数据库,都会让结果出现差异。对于非生信背景用户来说,最常见的困扰有三个:
- 不知道从哪里开始。
- 不清楚每一步该用什么工具。
- 结果出来了,却难以判断是否可信。
如果流程不能标准化,数据就很难复现。 这也是很多课题组在重复分析时效率低下的根本原因。
1.3 只看峰图远远不够
很多人以为ChIP-seq只要看峰图就行。实际上,峰图只是结果展示的一部分。要真正解释实验,需要结合:
- 测序深度。
- 比对率。
- 重复样本一致性。
- 峰的数量和分布。
- 与输入对照的富集差异。
没有这些基础指标,峰图再漂亮也不够严谨。 对科研人员来说,能否把“图”变成“证据”,才是关键。
2. ChIP-seq流程的核心环节到底有哪些
2.1 先把原始数据处理干净
ChIP-seq分析第一步,通常是原始数据质控。目的是判断测序质量是否满足后续分析要求。重点看:
- 碱基质量分布。
- 接头污染。
- 低质量reads比例。
- GC偏倚。
- duplication情况。
如果原始数据质量差,后续的比对和峰调用都会受影响。这一步不是形式检查,而是决定数据能不能继续往下走。
2.2 比对和过滤决定数据可用性
比对到参考基因组后,还要进一步筛选有效reads。常见处理包括去除低质量比对、重复reads和明显异常片段。这样做的目的,是尽量保留真正来自蛋白-DNA结合区域的信号。
在这个阶段,分析者需要特别关注:
- 比对率是否合理。
- 去重复后保留了多少有效数据。
- 样本间是否存在明显偏差。
如果重复率过高或有效reads过少,峰调用结果会明显变弱。
2.3 峰调用和下游解释是核心输出
峰调用是ChIP-seq分析最关键的输出之一。它决定哪些基因组区域被识别为富集区域。之后通常还要做:
- 峰注释到基因附近。
- 计算峰在启动子、增强子或基因体的分布。
- 富集通路分析。
- 与对照组做差异比较。
这一步需要较强的生物学解释能力。峰不是终点,峰背后的调控意义才是重点。
3. WorkBuddy如何降低ChIP-seq分析门槛
3.1 把零散步骤整合成更顺手的流程
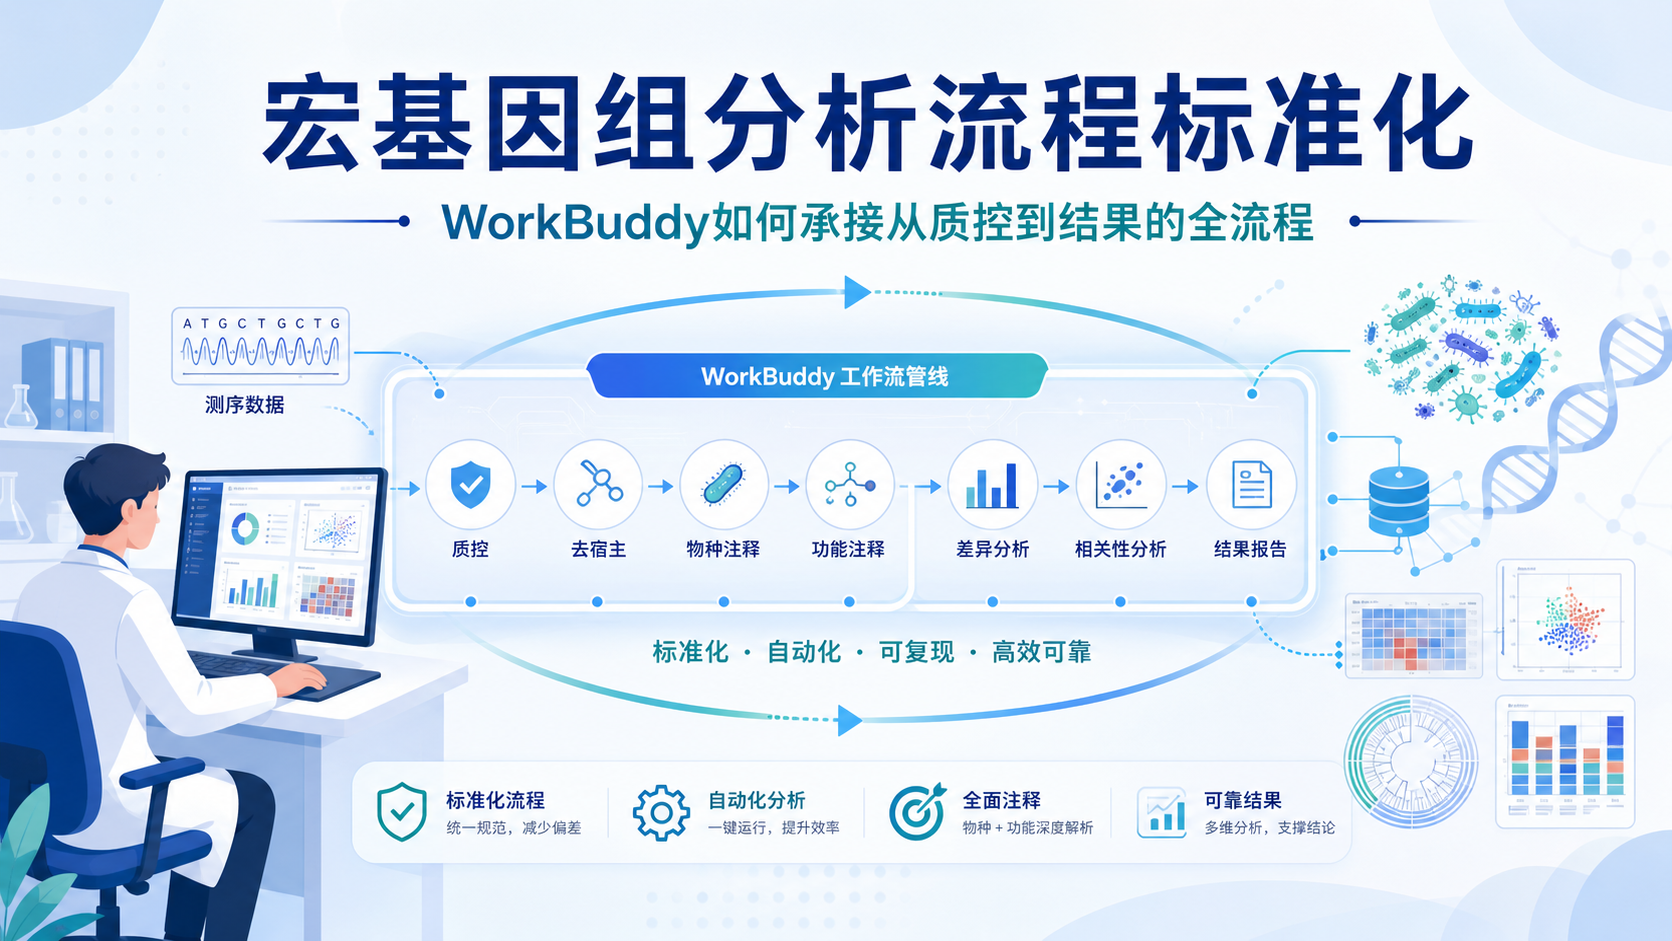
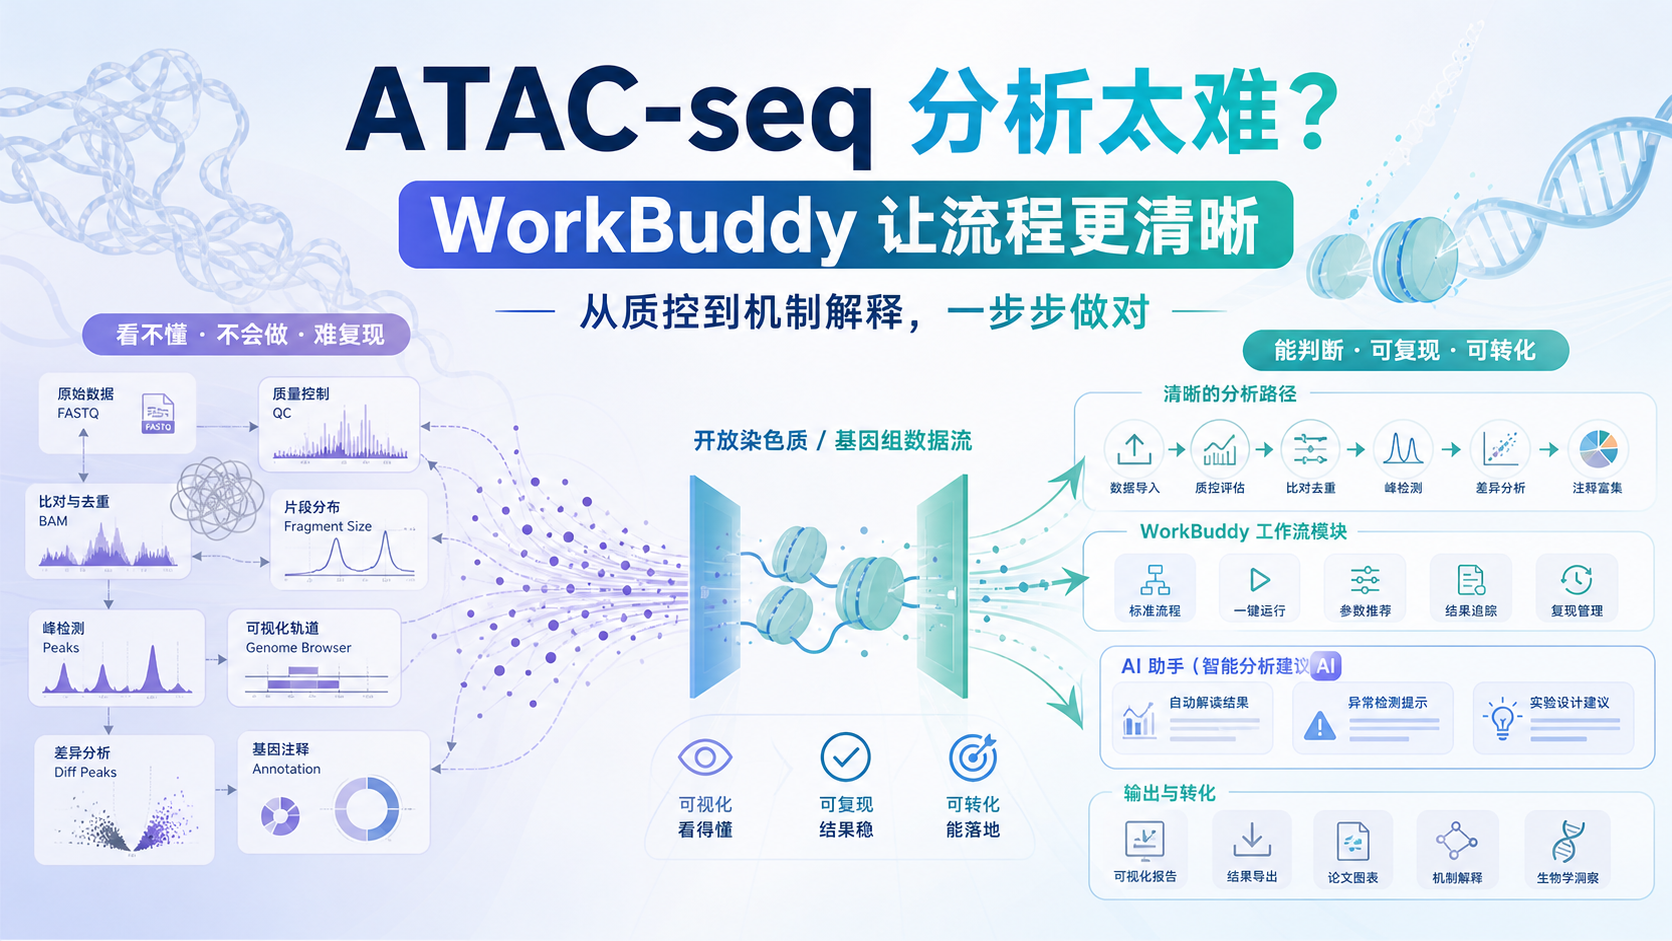
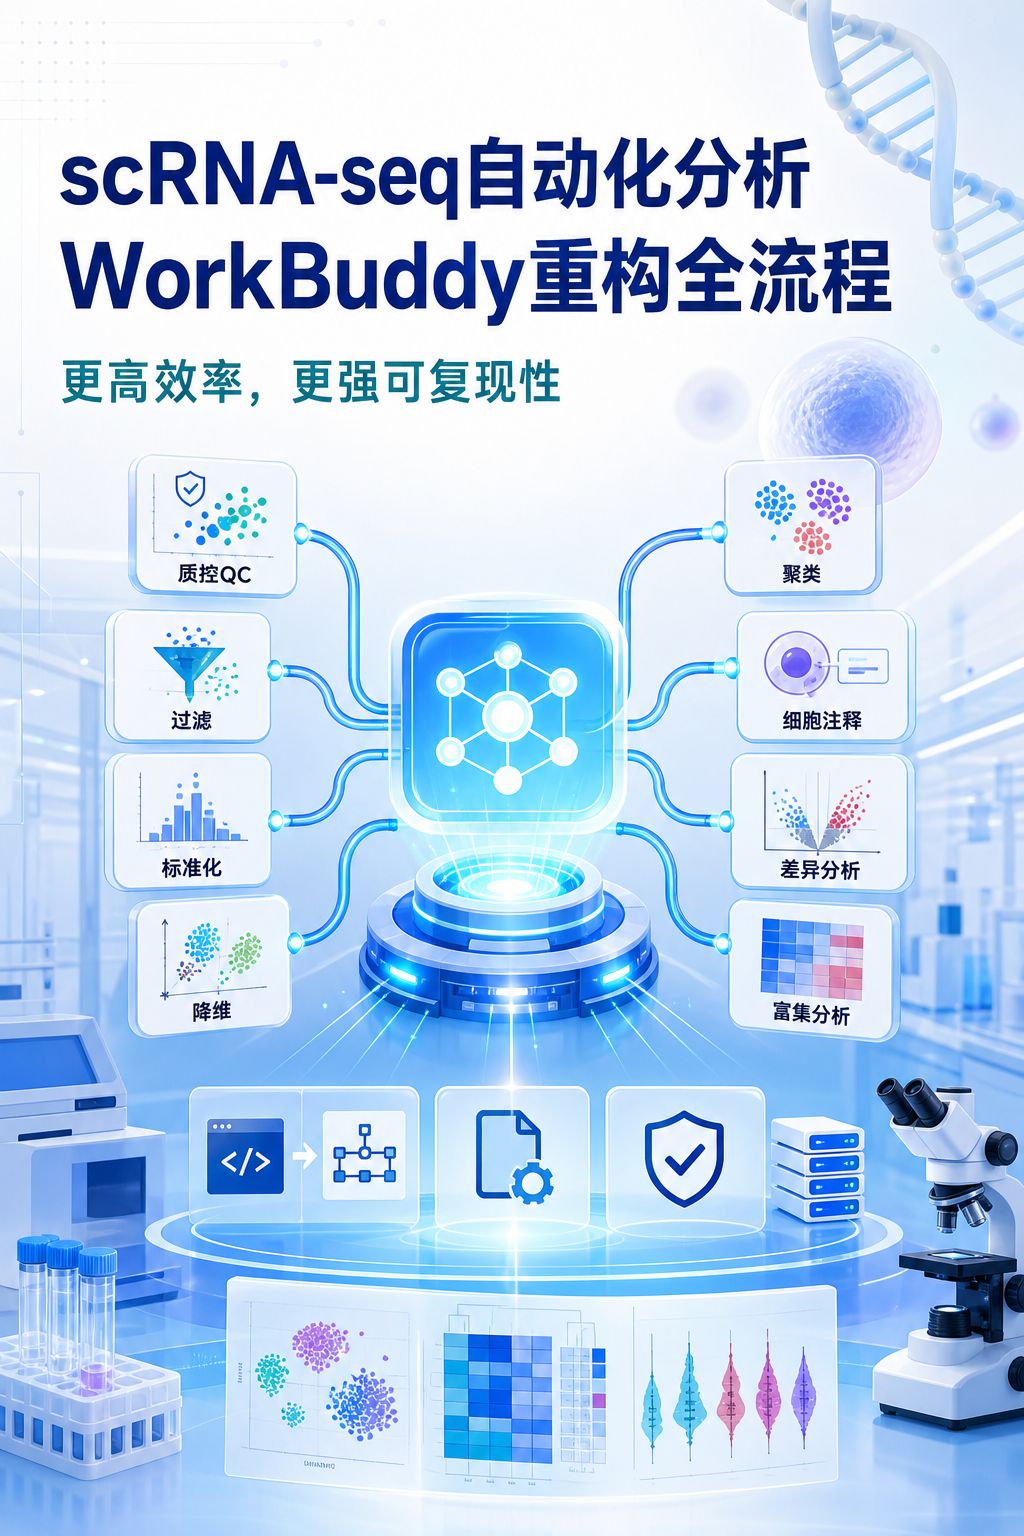
对于很多科研人员来说,最大的痛点不是不会做分析,而是每一步都要单独找工具、记命令、对参数。WorkBuddy的价值就在于,把流程尽量整合,让用户更容易完成标准化分析。
它适合用来帮助你更快地梳理:
- 数据导入。
- 分析流程执行。
- 结果整理。
- 图表输出。
当流程被固定下来,重复分析就会轻很多。 这对需要批量处理样本的实验室尤其重要。
3.2 更适合需要可复现结果的场景
ChIP-seq数据分析不能只追求“跑通”,更要追求“可复现”。这是科研写作、文章投稿和组会汇报都绕不开的要求。WorkBuddy在这类场景中的优势,是帮助用户减少人工切换和手动整理带来的误差。
尤其在以下场景中更有价值:
- 多批次样本整合分析。
- 重复实验结果对比。
- 需要快速生成报告。
- 需要团队协同处理数据。
标准化流程越清楚,结果越容易被同行理解和复核。
3.3 从“会不会用”变成“怎么解释”
很多初学者卡在软件操作上,最后没有时间去思考结果本身。WorkBuddy这类工具的意义,不只是帮你跑流程,还能把注意力拉回到科学问题本身。
你最终要回答的往往是:
- 这个蛋白是否真的富集在目标区域。
- 这个结合变化是否与表型一致。
- 这个结果能否支持机制假设。
工具只是手段,科学解释才是目的。
4. 医学生、医生和科研人员最该关注什么
4.1 不要把分析等同于出图
很多人误以为只要生成热图、峰图和火山图就完成了分析。其实不然。真正有价值的分析,必须能支撑研究结论。建议重点检查以下内容:
- 输入对照是否设置正确。
- 重复样本是否一致。
- 峰是否集中在预期区域。
- 富集结果是否与文献或机制一致。
没有生物学解释的图,只是漂亮图片,不是科研证据。
4.2 结果可信度要靠流程而不是感觉
ChIP-seq分析最怕的是“看起来差不多”。尤其当不同样本、不同批次、不同软件给出略微不同的结果时,很多人会凭经验选一个“最好看的”。
更稳妥的做法是:
- 先确认原始数据质量。
- 再确认比对和过滤是否合理。
- 然后看峰调用是否稳定。
- 最后再做生物学解释。
流程严谨,结果才经得起复查。
4.3 复杂分析也可以被标准化管理
对于临床相关研究和基础转化研究来说,时间成本很重要。分析流程越标准,团队越能把精力放在课题设计、样本解释和文章撰写上,而不是反复调试工具。
这也是为什么越来越多实验室开始寻找更易用的分析方式。不是为了偷懒,而是为了把专业工作做得更稳定。
总结Conclusion
ChIP-seq数据分析之所以复杂,不是因为概念难,而是因为流程长、工具多、复现要求高。对医学生、医生和科研人员来说,真正需要的是一套清晰、稳定、可解释的分析路径。WorkBuddy+ChIP-seq流程的价值,就是把繁琐步骤尽量标准化,让你更快进入结果解读阶段。
如果你正在做ChIP-seq项目,或希望把分析从“能跑”提升到“规范可复现”,可以进一步了解解螺旋提供的工具与支持。用更顺手的方式完成ChIP-seq流程,才能把更多时间留给科学问题本身。
- 引言Introduction
- 1. ChIP-seq数据分析为什么总让人头疼
- 2. ChIP-seq流程的核心环节到底有哪些
- 3. WorkBuddy如何降低ChIP-seq分析门槛
- 4. 医学生、医生和科研人员最该关注什么
- 总结Conclusion