8
 分享
引言Introduction
样本量算不准,研究容易被质疑。太少,统计效能不足。太多,浪费时间和资源。对临床科研而言,样本量计算不是可选项,而是研究设计的起点 。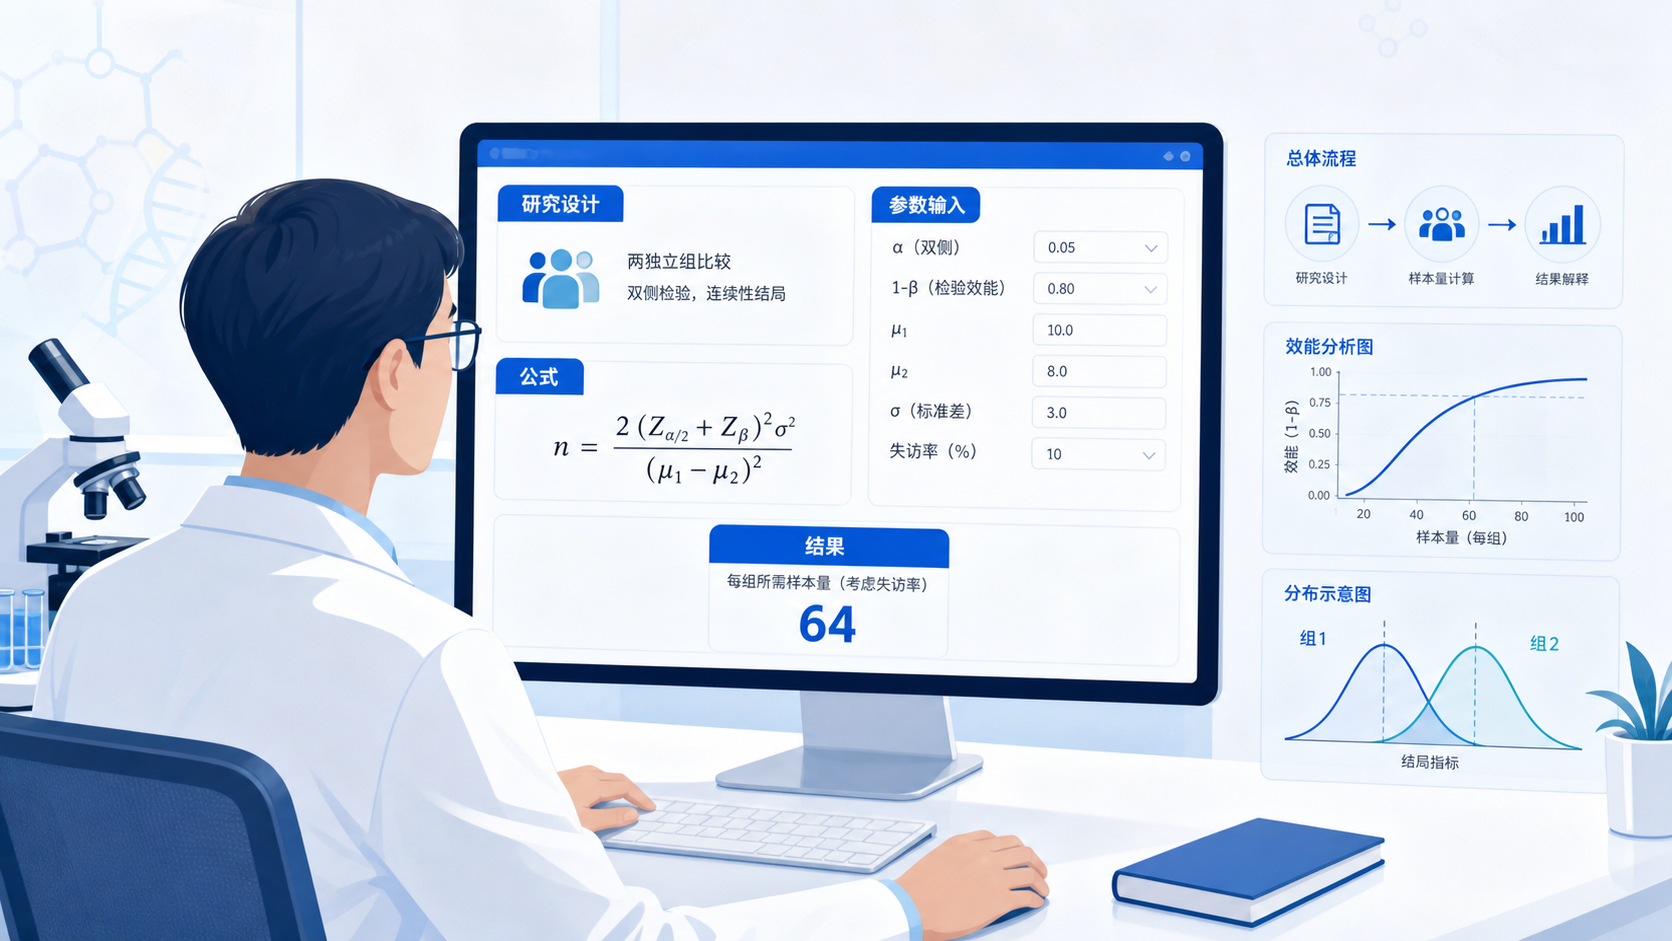
1. 为什么样本量计算是临床研究的第一步
1.1 先定研究设计,再谈样本量
样本量不是一个孤立数字。它依赖研究问题、研究设计和结局指标。
比如,横断面研究常用于估计患病率或均数。病例对照研究关注暴露与结局的关联。随机对照试验则更强调组间差异、检验效能和效应量。研究类型不同,样本量公式就不同。
这也是很多初学者容易出错的地方。只问“样本量怎么算”,但不说明研究设计,答案通常没有意义。临床科研中,正确顺序应是:
- 明确研究目的。
- 确定研究设计。
- 选择主要结局。
- 设定参数。
- 再计算样本量。
1.2 为什么不能只凭经验拍板
不少研究者会说,手里只有100例病例,是否还要算样本量。答案是要。因为审稿人关心的不是“你有多少”,而是“你为什么取这个数”。
样本量计算的本质,是根据预设的研究目的,估计达到统计学要求所需的最小样本数。它的作用是让研究结果更可靠,也让方法学更可解释。
如果样本量太小,可能出现两类问题:
- 真实差异存在,但检不出来。
- 结果波动大,置信区间过宽。
如果样本量过大,则会增加招募成本、随访负担和伦理风险。对临床研究来说,这同样不是好事。
2. WorkBuddy样本量计算能解决什么问题
2.1 让复杂计算更接近临床场景
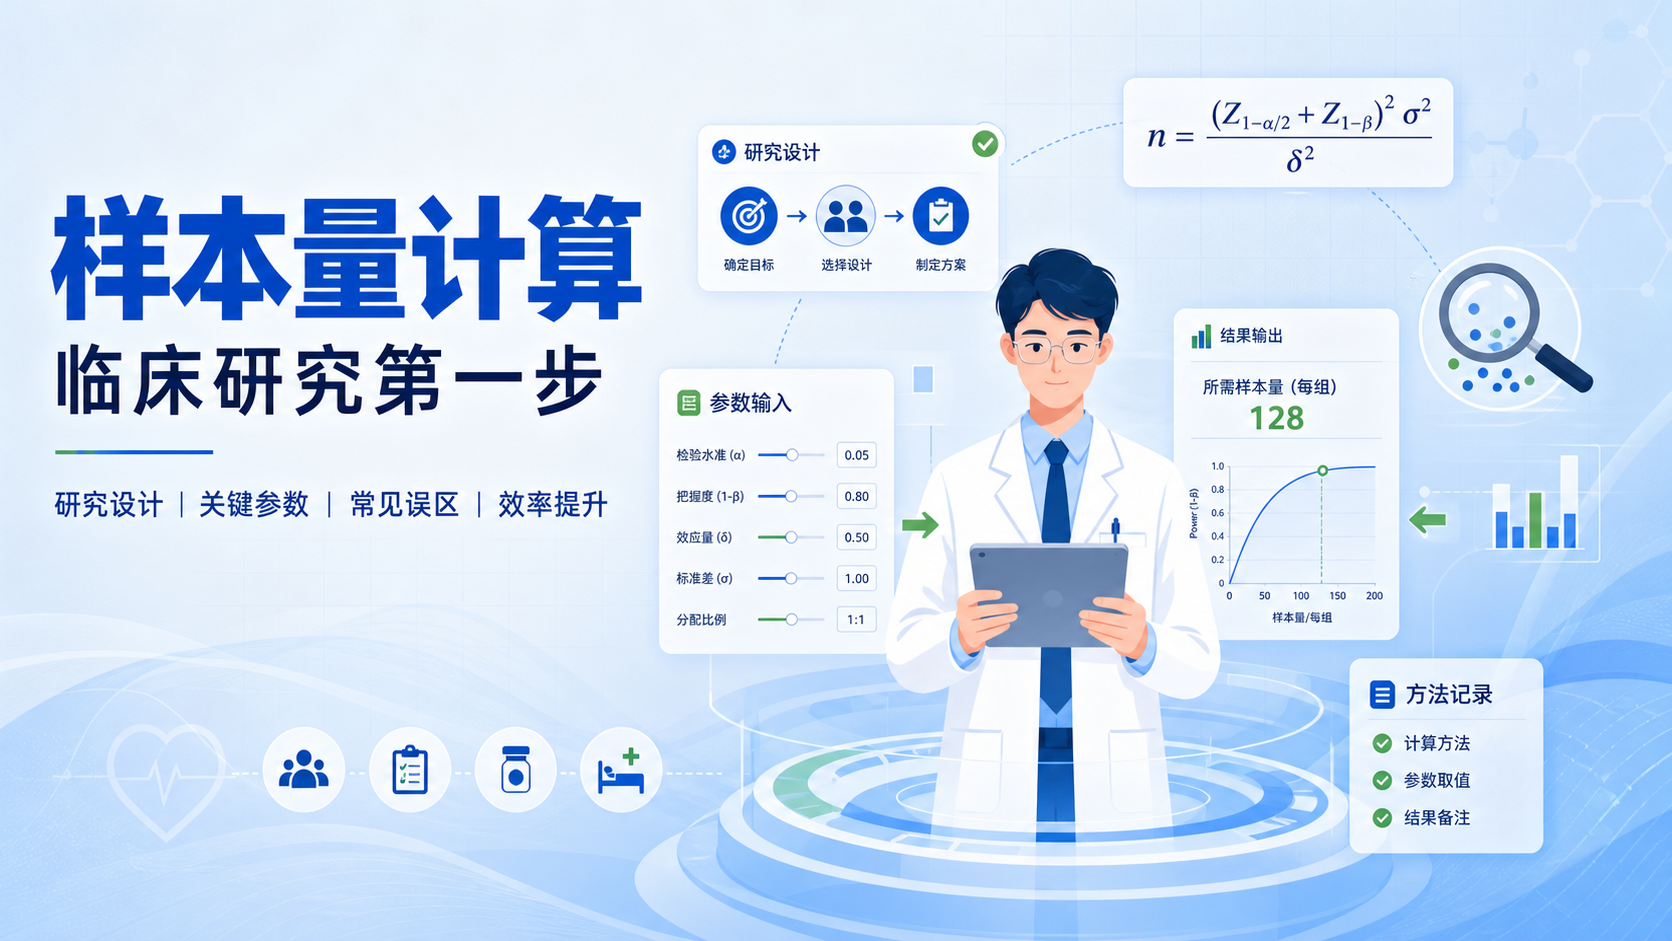
临床研究里的样本量计算,常常不是单纯套公式这么简单。你需要先判断是估计率、估计均数,还是比较两组差异。还要考虑α值、把握度、误差界值、预期发生率或标准差。
WorkBuddy的价值在于,它把这类常见流程整合到科研工作流里。对医生和科研人员来说,重点不是记住每个公式,而是快速找到正确的计算路径。
尤其在横断面调查、RCT、队列或病例对照研究中,参数设置稍有不同,结果就会变化明显。工具化流程能减少手工切换和理解偏差。
2.2 临床研究中最常见的三类计算需求
在实际应用中,样本量计算最常见的需求主要有三类:
- 总体率估计 ,如患病率、携带率、发生率。
- 总体均数估计 ,如血压、身高、实验室指标均值。
- 组间比较 ,如两组率比较、两组均数比较、RCT优效性或非劣效性设计。
其中,总体率和总体均数的计算相对基础,但参数设定最容易出错。比如,总体率计算需要明确预估值和允许误差;总体均数计算更依赖标准差,而不是均值本身。
很多人忽略了这一点。样本量计算真正决定结果的,是参数,而不是软件按钮。
3. 样本量计算时最关键的参数
3.1 研究设计决定公式
不同研究设计,对应不同统计模型。横断面研究通常用于描述性问题,比如某地区乙肝表面抗原携带率。病例对照研究通常用于分析暴露因素。RCT则用于干预效果评价。
因此,样本量计算前必须先明确:
- 研究类型。
- 主要终点。
- 统计检验方式。
- 单侧还是双侧检验。
如果这些信息不清楚,软件只能给出一个数字,却未必是你真正需要的数字。
3.2 预估值、误差和把握度
样本量计算常涉及三个核心参数:
- 预估值 。如患病率预计为10%。
- 允许误差 。如误差不超过1%。
- 把握度或检验效能 。通常用于比较研究,反映发现真实差异的能力。
在总体率估计中,误差越小,所需样本量越大。以患病率10%、误差1%为例,所需样本量会明显增加。原因很简单,研究越想“看得准”,就越需要更多样本支撑。
在总体均数估计中,关键参数往往是标准差。标准差越大,说明个体差异越大,样本量通常也会增加。
3.3 文献和前期数据的重要性
样本量计算不是凭空设定。预估值最好来源于文献、预实验或既往数据库。比如:
- 参考同类人群的患病率报道。
- 参考前期研究的标准差。
- 参考类似中心的RCT效应量。
这样做的好处是,参数更有依据,也更容易通过伦理和方法学审查。
如果没有可靠文献,预估值只能基于保守假设。但要注意,假设必须在方案中说明来源和理由。
4. WorkBuddy在临床样本量计算中的实际使用逻辑
4.1 先选研究类型,再填参数
对临床科研人员来说,最实用的方式不是“从公式开始”,而是“从研究问题开始”。
可以按这个流程走:
- 打开样本量计算模块。
- 选择研究设计类型。
- 选择对应的结局指标。
- 输入预估率、误差、标准差或组间差异。
- 查看计算结果,并记录参数来源。
这个流程的意义在于,它把方法学步骤标准化了。对非统计背景的医生来说,标准化流程比记忆公式更重要。
4.2 结果不是终点,记录方法才是关键
很多研究者算完样本量就结束了,但在论文和研究设计书里,真正重要的是可追溯性。需要写清楚:
- 使用了什么研究设计。
- 主要结局是什么。
- 采用了什么样本量公式或软件。
- 参数如何设定。
- 参数依据来自哪里。
- 软件版本或计算方式是什么。
这一点在SCI投稿和伦理审批中都很重要。审稿人不仅看结果,也看你的方法是否规范。
4.3 工具能提速,但不能替代判断
样本量计算工具能节省时间,但不能替代科研判断。比如:
- 某些研究样本固定,无法继续扩大。
- 某些真实世界研究只能纳入有限病例。
- 某些多中心研究需要按失访率再做膨胀。
- 某些复杂设计要考虑分层、整群或多阶段抽样。
工具解决的是效率问题,研究者解决的是合理性问题。 两者必须结合。
5. 临床科研中常见的三个误区
5.1 把样本量当成“越大越好”
样本量并非越大越好。它需要和研究目标匹配。若样本数远超实际需要,会增加资源消耗,也可能带来伦理压力。
合理样本量的标准,不是最大,而是“足够”。
5.2 只看软件输出,不看参数来源
软件结果看起来很专业,但如果输入参数不合理,输出就没有意义。比如患病率设为10%,但文献依据其实来自另一类人群,那么结果就可能偏离真实场景。
样本量计算的核心不是工具,而是参数的真实性。
5.3 忽略失访和实际执行偏差
临床研究常有失访、排除和数据缺失。计算时通常需要预留一定比例的冗余样本,否则最终有效样本会不足。
常见做法是,在理论样本量基础上,按预估失访率上调。这样更符合真实研究流程。
6. 用解螺旋提升样本量计算效率
6.1 从设计到计算的一体化思路
如果你正在做临床课题,最耗时的往往不是点一下计算按钮,而是前面的设计判断。解螺旋提供的临床研究工作台,强调的正是这一点。
它把研究设计、数据库整理、样本量计算和后续分析放在同一个工作流里。 对于需要频繁切换任务的医生、硕士生和科研人员,这种整合思路更高效,也更符合真实科研节奏。
6.2 让复杂科研流程更可控
当你面对横断面调查、病例对照研究或RCT时,真正难的是把参数、公式和论文写作统一起来。解螺旋可以帮助用户更快进入规范流程,减少重复劳动,把精力放在研究问题本身。
如果你希望把样本量计算做得更规范、更高效,解螺旋会是一个值得优先尝试的科研工具。
总结Conclusion
样本量计算不是附属步骤,而是临床科研设计的核心环节。它决定了研究是否有统计学把握,也影响论文能否经得起审稿和复现。对于医学生、医生和科研人员来说,最重要的是先明确研究设计,再选择正确参数,最后完成规范记录。如果你希望把样本量计算和整个研究流程做得更高效,建议使用解螺旋,直接提升临床科研执行力。
- 引言Introduction
- 1. 为什么样本量计算是临床研究的第一步
- 2. WorkBuddy样本量计算能解决什么问题
- 3. 样本量计算时最关键的参数
- 4. WorkBuddy在临床样本量计算中的实际使用逻辑
- 5. 临床科研中常见的三个误区
- 6. 用解螺旋提升样本量计算效率
- 总结Conclusion