28
 分享
引言Introduction
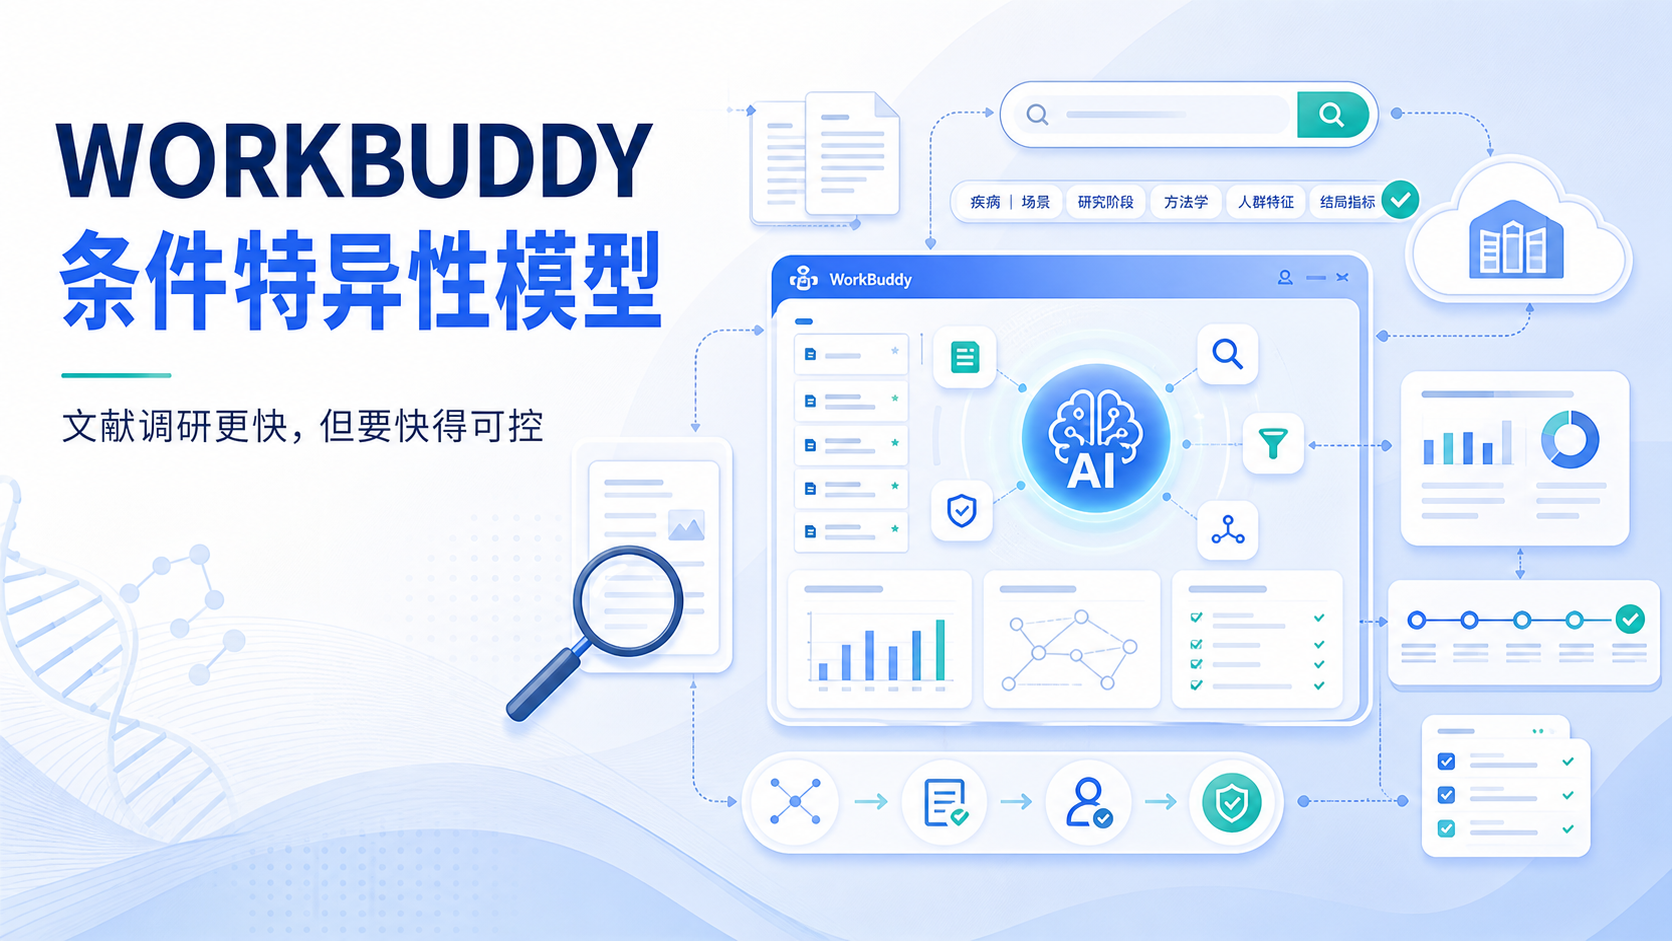
做文献调研,最耗时的往往不是“读”,而是“找、筛、整理、再核对”。如果检索范围不清,模型配置又不合适,速度会明显下降。WorkBuddy条件特异性模型的价值,就是把不同研究场景拆开处理,减少无效步骤,提高调研效率。
1. 什么是WorkBuddy条件特异性模型
1.1 按研究场景拆分,而不是“一套模型跑到底”
WorkBuddy的条件特异性模型,本质上是把不同任务分给不同能力配置。它不是只用一个通用模板处理所有问题,而是根据任务类型调用更匹配的工作流。
在实际使用中,这种区分很重要。因为文献调研、临床研究、综述写作、Meta分析,所需步骤完全不同。同一套流程无法同时兼顾速度、字段完整性和学术严谨性。
例如,学生模式更适合文献调研、写综述、写论文等场景。零年模式则更偏向临床研究。两者并不是重复安装,而是为不同任务预置不同技能包。对于需要更复杂步骤的任务,比如Meta分析,单靠通用模式往往不够。
1.2 为什么“条件特异性”能提升效率
效率提升来自两点。第一,减少模型在不相关步骤上的消耗。第二,让检索和整理更贴近任务目标。
如果任务已经被完整执行过一遍,下一次再做,通常会更快,时间可能缩短60%以上。 这不是因为文献库突然变小,而是因为工作流已经成熟,重复步骤被固化了。
对于科研人员来说,这种提升更有意义。因为大量时间其实花在重复劳动上,比如:
- 设定检索范围。
- 标注文献类型。
- 提取PMID、DOI、期刊、IF。
- 汇总一句话结论。
- 校对格式和字段。
条件特异性模型的作用,就是把这些重复动作尽量标准化。
2. 用WorkBuddy做文献调研,快在哪里
2.1 不是只“搜到”,而是“搜到后能直接用”
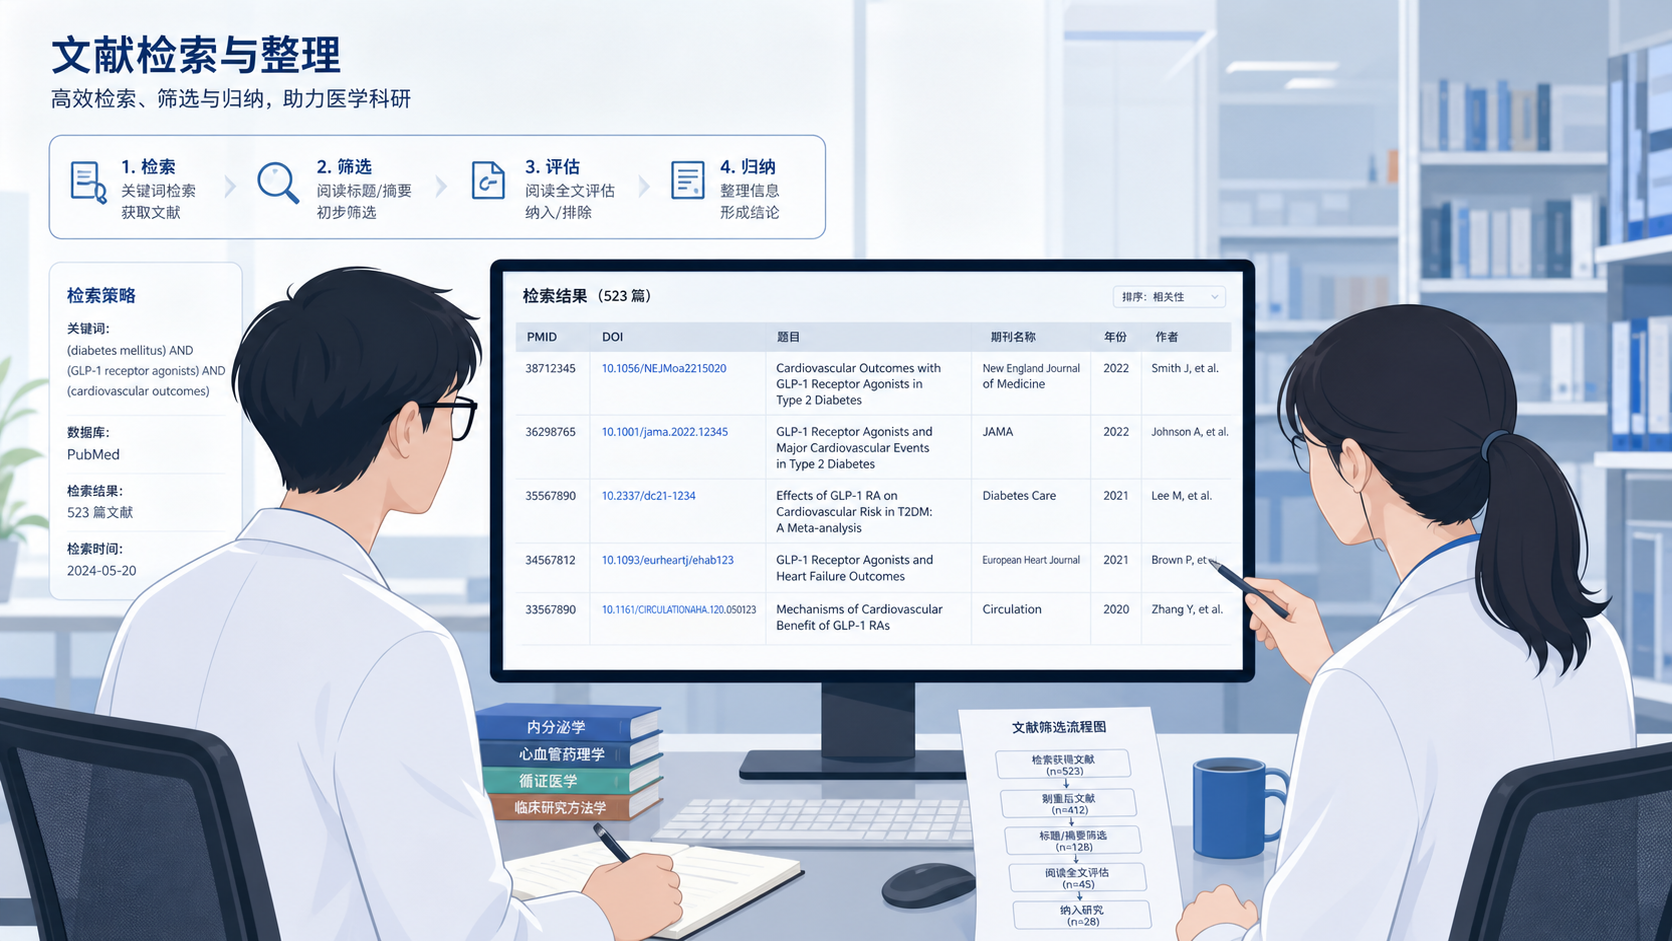
传统检索工具只能帮你找到文献。后续的筛选、分类、整理,仍然要人工完成。WorkBuddy更强调结果可用性。它的优势不只是检索,而是把检索结果转成可继续处理的结构化信息。
根据实际使用反馈,它能抓取高分文献,并输出多维表格。常见字段包括:
- PMID。
- 标题和中文标题。
- 期刊名。
- Impact Factor。
- 发表时间。
- DOI。
- 一句话结论。
这一步很关键。因为科研工作真正需要的,不只是“看见文章”,而是“马上进入下一步分析”。
2.2 生成速度的体感差异
从实测体验看,一次完整任务通常大约需要7到10分钟。这个时间包括检索、筛选、结构化输出和文档生成。对于需要快速搭建初始文献库的人来说,这个速度是可接受的。
但要注意,速度并不等于零错误。 即使是高性能大模型,也不能保证每次都百分之百准确。实际中可能出现日期错误、字段漏填或分类偏差。原因通常不是平台失效,而是模型在不同调用条件下存在性能差异。
所以,WorkBuddy的价值不在于“替代人工校对”,而在于把人工整理前移到更高效的阶段。先生成,再核对,再优化,是更合理的流程。
2.3 WebSearch覆盖更广,但学术验证要单独看
WorkBuddy的WebSearch覆盖面较广,除了学术文献,还能检索新闻、博客等非学术来源。这个特点适合快速摸底研究热点,尤其是在选题初期。
但如果你的目标是严谨的学术综述,就不能只看覆盖面。学术文献验证流程是否严谨,才决定结果能不能用于论文。
和一些更偏通用搜索的工具相比,WorkBuddy在学术验证环节的稳定性取决于具体配置和任务设计。科研场景里,最好把“广覆盖”和“强验证”分开考虑。
3. 条件特异性模型适合哪些文献调研场景
3.1 适合先搭框架,再做精细筛选
在临床和基础研究中,文献调研通常分为两步。第一步是快速搭建文献框架。第二步是做深度筛选。
WorkBuddy条件特异性模型特别适合第一步。比如你可以先限定:
- 主题词。
- 时间范围。
- 发表类型。
- IF阈值。
- 疾病方向或人群特征。
这样做的好处是,系统输出的不是一堆无序文献,而是一套可直接用于筛选的候选库。对于需要短时间完成初筛的人来说,这一步能显著减少人工浏览成本。
3.2 适合个性化任务,不适合盲目通用
如果你只需要“乳腺癌近三年的高影响因子综述”,条件特异性模型就很合适。你可以继续细化要求,比如:
- 限定关键词为乳腺癌和免疫。
- 限定过去一个月或过去三年的文献。
- 限定Impact Factor大于10。
- 输出综述与论著分别统计。
这种任务下,模型更容易给出精准结果。因为约束越明确,检索就越聚焦。
相反,如果你要求非常开放,比如“帮我看看这个方向最近有什么”,结果往往会更分散。条件特异性模型的前提,是你愿意先定义条件。 条件越清楚,输出越可控。
3.3 适合需要多字段管理的科研团队
对于课题组、实验室或医院科研团队来说,单次文献调研只是起点。真正麻烦的是后续归档和共享。WorkBuddy可以把结果整理成表格或文档,方便团队协作。
实际使用中,它还能生成飞书文档,并支持继续导出、分享,甚至发送到邮箱。对于需要多人协作的项目,这种能力很实用。因为团队真正节省的不是检索时间,而是沟通和重录时间。
4. 影响速度的关键因素
4.1 模型选择会直接影响任务表现
WorkBuddy本身提供了不同模型选项。以DeepSeek相关模型为例,v4 fresh通常足够应对多数常规任务,速度也更快。遇到更难的任务时,可以用pro版本,但它通常更慢,性能也更强。
这说明一个事实。不是模型越强越适合所有任务。 对于日常文献调研,够用、稳定、可复现,往往比极限性能更重要。
另外,自定义模型也可以接入。只要在设置里填入API key,就能把自己的模型配置放进去。这样做的好处是灵活,但也意味着你需要自己管理调用成本和模型表现。
4.2 任务设计决定结果质量
同样的工具,不同的提示词和约束条件,会得到完全不同的结果。比如:
- 只说“检索乳腺癌文献”,结果会很散。
- 说明“限定乳腺癌免疫、近一个月、IF大于10”,结果会更精准。
- 要求“输出PMID、DOI和一句话结论”,结果就更适合建库。
任务设计越清晰,模型越能稳定执行。 这也是为什么条件特异性模型的效果,往往比通用问法更好。
4.3 审核环节不能省
再快的工具,也不能替代最终审稿。尤其是日期、分类、期刊信息这类字段,仍需要人工核对。对于投稿、开题、基金申请等场景,任何一个错误字段都可能带来返工。
因此,更合理的做法是:
- 先用条件特异性模型生成候选结果。
- 再人工核对重点字段。
- 最后按研究目标二次筛选。
这样既保留效率,也保留严谨性。
5. 结语:快,但要快得可控
WorkBuddy条件特异性模型的核心价值,不只是“快”,而是在明确条件下快速产出可用的文献结果 。它适合需要高效做选题、搭库、筛文献、出表格的医学生、医生和科研人员。对重复任务来说,它还能通过固定流程持续提速,后续执行通常更顺。
如果你希望把文献调研从“人工慢筛”变成“结构化生成加人工校验”,可以考虑用解螺旋的产品思路来搭建更高效的工作流。在明确条件、减少重复、保留核对的前提下,解螺旋可以帮助你把文献调研做得更快,也更稳。
- 引言Introduction
- 1. 什么是WorkBuddy条件特异性模型
- 2. 用WorkBuddy做文献调研,快在哪里
- 3. 条件特异性模型适合哪些文献调研场景
- 4. 影响速度的关键因素
- 5. 结语:快,但要快得可控