11
 分享
引言Introduction
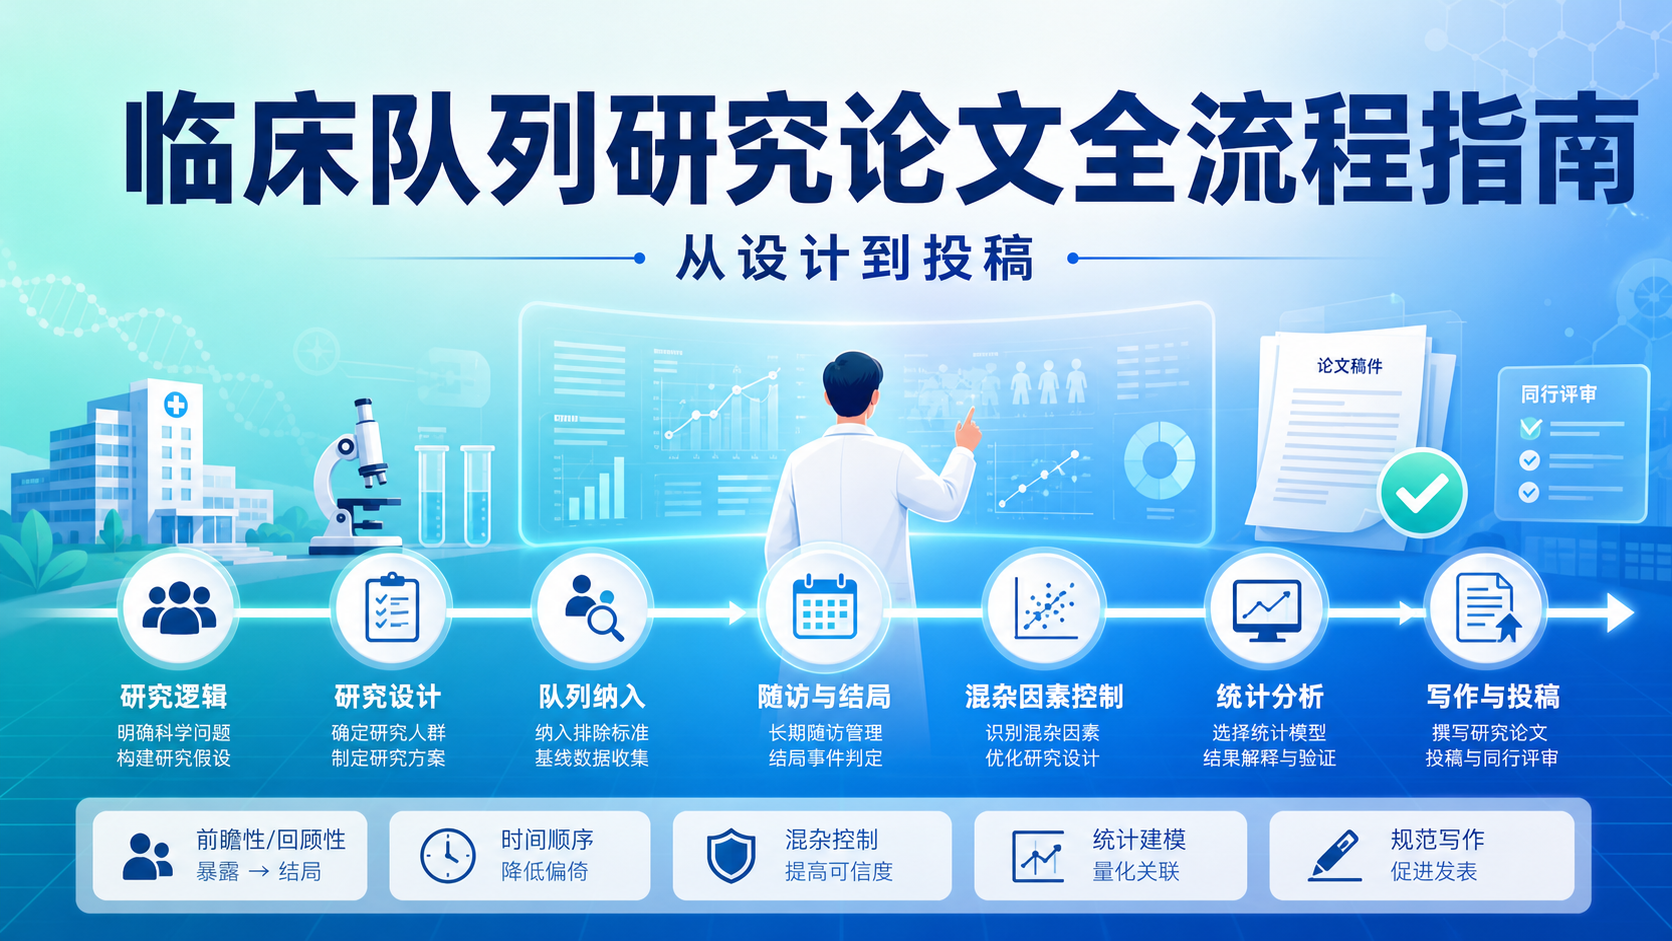
临床队列研究论文常见的问题,不是“没有数据”,而是设计不严谨、随访不完整、统计不匹配 。很多研究做到最后,仍然难以回答“暴露与结局是否真的有关”。要写出能发表的队列研究,必须从问题、分组、随访到分析,一步一步搭好框架。
1. 临床队列研究论文的核心逻辑
1.1 先回答“谁先暴露,谁后结局”
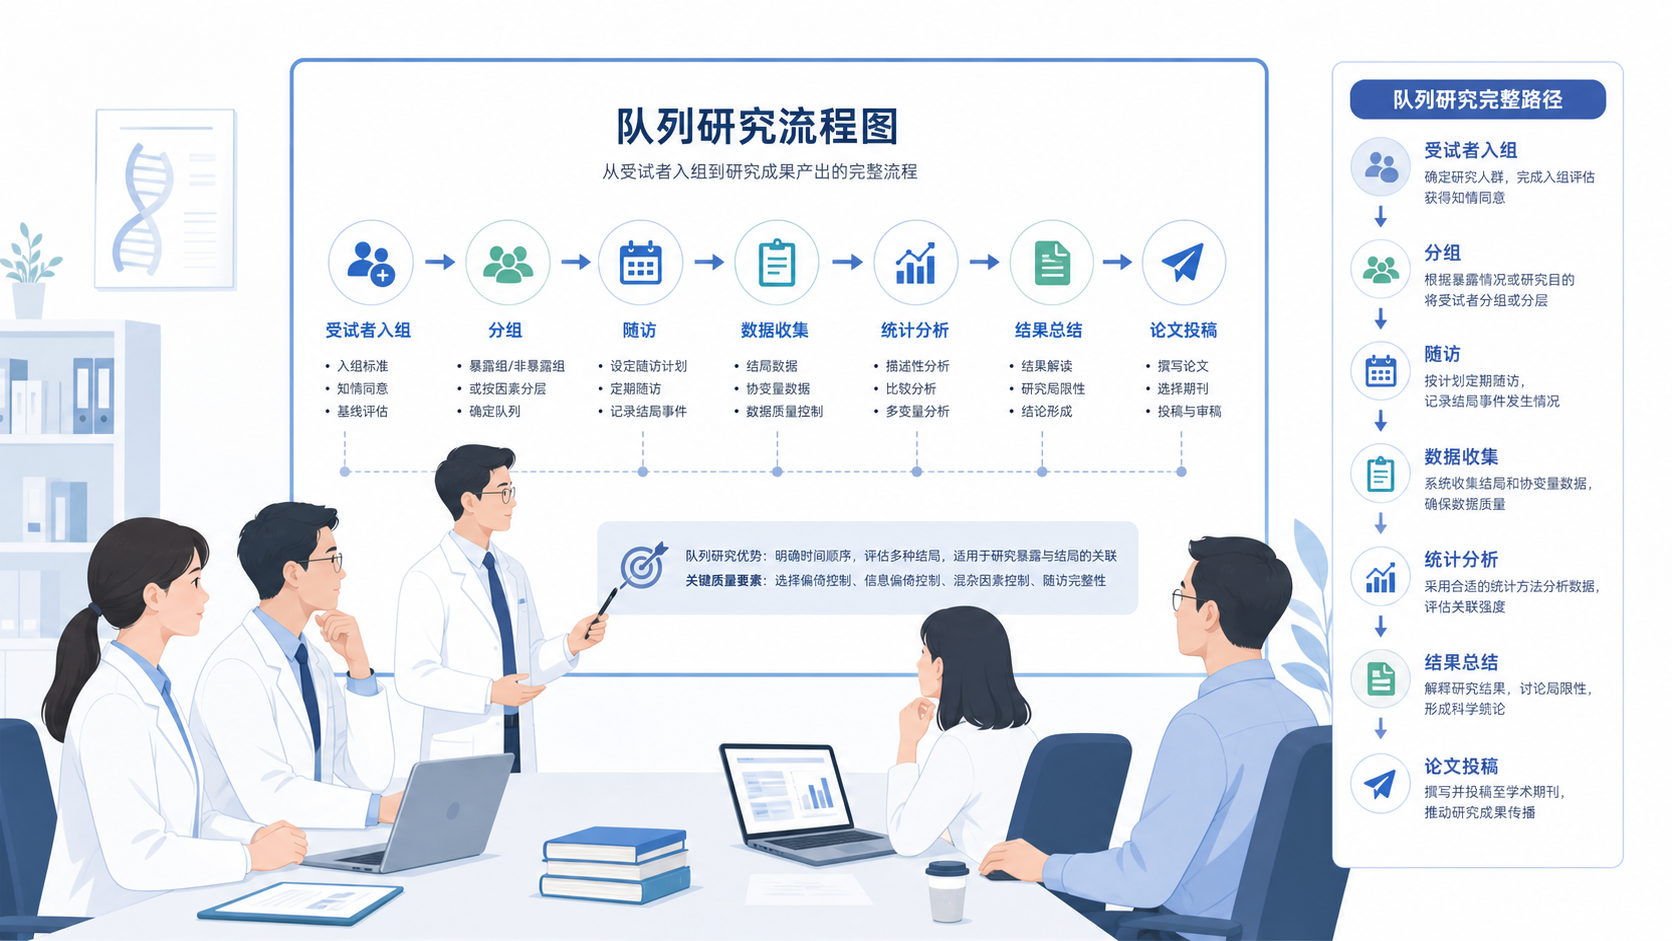
队列研究的本质,是按照暴露状态或基线特征 分组,再向后观察结局发生情况。经典例子是吸烟与不吸烟人群,随访20年,看肺癌发生率是否不同。
这类研究的优势,在于时间顺序清楚。 先有暴露,再有结局,因此比横断面研究更适合讨论因果线索。但它仍然是观察性研究,不能简单等同于因果证明。
队列研究常用于两类问题。
- 推断病因 ,例如某种暴露是否增加疾病风险。
- 评估预后或治疗措施 ,例如某种基线特征是否影响生存、复发或并发症发生。
1.2 临床问题决定研究类型
如果研究对象是健康人群,重点通常是寻找危险因素。若研究对象已经患病,则更常见的是预后研究。两者的分组标准不同,结局指标也不同。
例如:
- 推断病因时,通常按“是否暴露”分组。
- 评估预后时,通常按“是否患病后存在某种特征”分组。
分组逻辑不清,是临床队列研究论文最常见的硬伤。 研究问题必须先定,再决定纳入标准、观察指标和统计方法。
2. 设计阶段决定论文上限
2.1 研究假设要具体
好的队列研究,不是先收集数据再找结论,而是先提出清晰假设。比如“甲胎蛋白水平升高是否与肝癌预后不良相关”,就比“研究某指标和肝癌关系”更可操作。
研究假设最好满足三点。
- 暴露明确。
- 结局明确。
- 时间窗明确。
假设越具体,后续变量选择、统计建模和结果解释就越稳定。
2.2 纳入标准要和问题匹配
纳入标准决定样本是否可比,也决定结果能否外推。临床研究中,常见做法是根据疾病状态、诊断标准、治疗时间窗和年龄范围设置条件。
如果是预后研究,建议重点关注以下内容:
- 是否为同一疾病诊断标准。
- 是否处于相近疾病分期。
- 基线治疗是否可比。
- 是否存在严重缺失数据。
纳入标准不是越宽越好,而是越贴近研究问题越好。
2.3 结局指标要可追踪
临床队列研究论文常见的结局包括生存、复发、并发症、再入院、功能恢复等。结局必须满足可测量、可重复、可追踪。
建议在设计阶段就明确:
- 主要结局是什么。
- 次要结局是什么。
- 观察终点如何定义。
- 随访截止时间如何设定。
如果结局定义含糊,后面即使样本量足够,也容易出现结论不稳或杂音过多的问题。
3. 研究实施:前瞻性、回顾性与混合队列
3.1 前瞻性与回顾性各有用途
前瞻性队列研究是从现在开始,向未来观察结局。优势是资料收集规范,变量定义更统一。缺点是耗时长,成本高。
回顾性队列研究则是从既往病历、数据库或登记系统中提取资料,再分析后续结局。优势是速度快,适合临床论文快速产出。缺点是缺失值、信息偏倚和选择偏倚更常见。
临床队列研究论文中,回顾性研究非常常见,但对数据质量的要求并不低。 关键不在“回顾性”本身,而在数据是否完整、定义是否统一。
3.2 双向与混合队列更适合真实世界
双向队列研究,通常是先回顾既往数据,再继续前瞻性随访。混合队列则是在同一时间点结合两类数据。
这类设计适合临床真实世界研究,因为可以兼顾效率和随访长度。尤其在结局较慢出现、但又希望提高样本量时,混合设计更有实用价值。
不过,混合队列对数据整合要求更高。历史数据与前瞻性数据的变量定义必须一致,否则分析结果会被系统性误差干扰。
4. 随访与偏倚控制是成败关键
4.1 随访不是越长越好,而是要够用
随访时间要和结局发生规律匹配。短了,结局还没出现。长了,失访增加,数据噪音变大。
设计随访时,至少要明确:
- 起点是什么。
- 终点是什么。
- 随访间隔多长。
- 失访如何处理。
随访设计的核心,是保证每个病例有相对一致的观察窗口。 这直接影响生存分析、复发分析和风险比较的可靠性。
4.2 选择性偏倚要尽量避免
队列研究最大的风险之一,是分组本身不真实。比如治疗组和对照组在年龄、病情严重程度、合并症上差异明显,最后的结论就可能被基线差异驱动,而不是被暴露本身驱动。
常见控制方法包括:
- 限制入组范围。
- 配对。
- 分层分析。
- 多因素回归。
- 倾向评分方法。
如果分组不平衡,不能只靠“样本多”解决。 必须在设计和统计两端同时控制。
4.3 混杂因素必须提前识别
临床研究中的混杂因素很多,常见如年龄、性别、疾病分期、合并症、治疗方式、基线实验室指标等。它们可能同时影响暴露和结局。
建议在方案阶段就列出候选混杂因素,并说明纳入模型的理由。这样做的好处是:
- 统计模型更有解释力。
- 结果更容易通过审稿。
- 论文讨论部分更有逻辑。
没有混杂控制的队列研究,往往只能提示关联,难以支持稳健结论。
5. 统计分析要服务于研究问题
5.1 描述性统计先交代基线
正式建模前,先做基线描述。比较两组在年龄、性别、病情严重程度、治疗方案等方面是否平衡。这个步骤不是形式,而是判断偏倚的重要依据。
常见写法包括:
- 连续变量的均值、标准差或中位数、四分位数。
- 分类变量的频数和百分比。
- 组间差异检验。
如果基线差异明显,后续分析就必须加强调整,而不能直接比较结局。
5.2 模型选择要看结局类型
不同结局对应不同模型。临床队列研究论文中,常见选择如下:
- 二分类结局,可用Logistic回归。
- 生存结局,可用Cox回归。
- 重复测量结局,可用混合效应模型或广义估计方程。
- 计数结局,可考虑Poisson或负二项模型。
不要为了“高级”而选模型,要为了结局类型和研究问题选模型。 这是审稿人最关注的基本功之一。
5.3 结果报告要完整
结果部分不要只写P值。更重要的是效应量和置信区间。例如OR、HR、RR及95%CI。这样读者才能判断结果强度和稳定性。
临床队列研究论文还应尽量报告:
- 样本量。
- 失访情况。
- 缺失值处理方式。
- 亚组或敏感性分析结果。
这些信息能显著增强论文可信度,也更符合E-E-A-T要求中的专业性与信任度。
6. 从数据到论文:写作与投稿的衔接
6.1 论文结构要顺着研究逻辑写
队列研究论文的写作顺序,最好和研究流程一致。
- 引言提出临床问题。
- 方法说明分组、随访和统计。
- 结果按基线、结局和模型展开。
- 讨论解释机制、优势和局限。
方法部分写得越清楚,结果部分越容易被接受。 审稿人看队列论文,首先看的就是设计是否成立。
6.2 讨论部分要诚实
讨论不是堆砌文献,而是解释结果为什么出现。建议从三个层面展开:
- 与既往研究是否一致。
- 可能的生物学或临床机制是什么。
- 研究局限在哪里。
尤其要正面承认局限,比如单中心、样本量有限、残余混杂、失访偏倚等。诚实不是减分项,而是提升可信度的关键。
6.3 选刊要匹配研究层级
队列研究适合投稿临床医学期刊和流行病学期刊。选择时要看三个维度:
- 研究问题是否重要。
- 设计是否规范。
- 数据和统计是否扎实。
临床队列研究论文能否发表,不只取决于结果显著与否,更取决于设计是否严谨、证据链是否完整。 若研究从方案到统计都比较规范,投中合适期刊的概率会明显提高。
总结Conclusion
临床队列研究论文的关键,不是“有没有做随访”,而是研究问题是否清晰、分组是否合理、混杂是否控制、统计是否匹配 。从设计到发表,每一步都决定最终质量。对于医学生、医生和科研人员来说,真正高质量的队列研究,必须建立在严谨的方案和规范的数据管理之上。
如果你正在准备临床队列研究论文,建议尽早把研究框架、变量定义、随访方案和统计路线梳理清楚。解螺旋可以帮助你更高效地理清研究设计逻辑、优化论文结构,并提升投稿准备效率。
- 引言Introduction
- 1. 临床队列研究论文的核心逻辑
- 2. 设计阶段决定论文上限
- 3. 研究实施:前瞻性、回顾性与混合队列
- 4. 随访与偏倚控制是成败关键
- 5. 统计分析要服务于研究问题
- 6. 从数据到论文:写作与投稿的衔接
- 总结Conclusion