22
 分享
引言Introduction
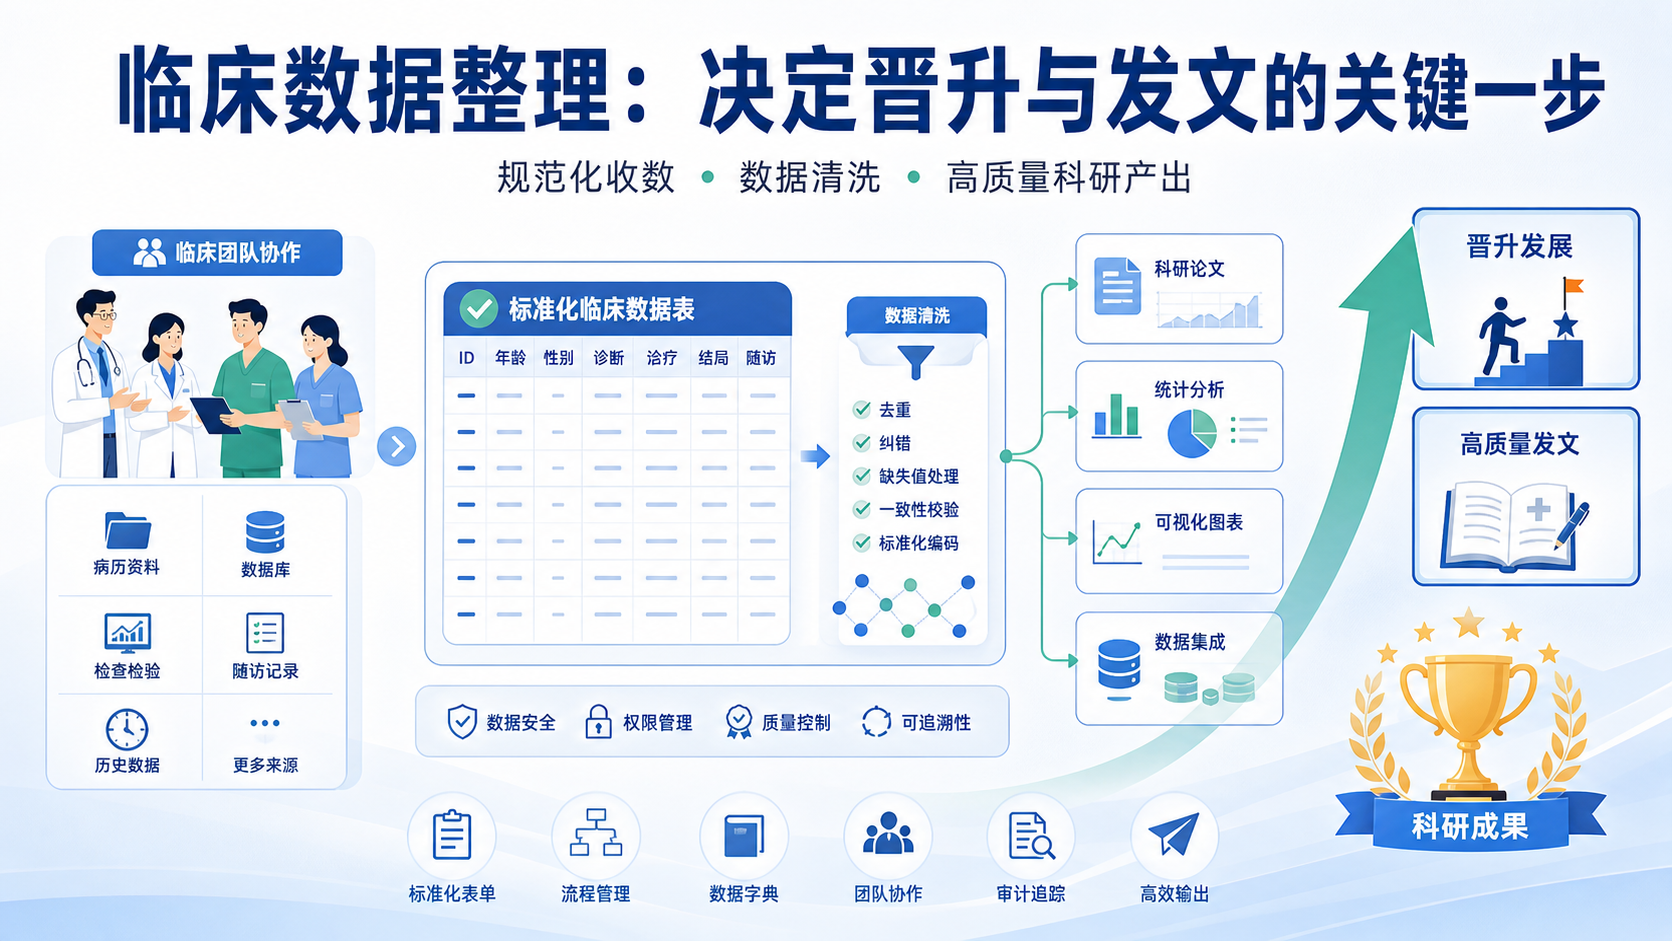
临床研究越来越看重“数据质量”而不是单纯病例数量。很多医生卡在晋升前,不是不会写文章,而是临床原始数据整理不规范,导致分析做不深、结果不稳、返修反复 。对医学生、医生和科研人员来说,真正的门槛往往在数据起点。
1. 为什么临床数据整理会直接影响晋升
1.1 数据不是附属工作,而是科研地基
临床研究的第一步,不是建模,也不是写作,而是把原始数据整理成可分析的数据集。如果变量定义不统一,缺失值处理不规范,后续统计再漂亮也站不住。
晋升评审看重的不只是文章数量,还看研究是否可重复、是否有临床价值、是否能形成稳定产出。数据整理能力,决定了你能不能持续做课题。
很多临床项目失败,并不是课题方向不行,而是数据层面出了问题。比如:
- 入排标准不清,样本前后不一致。
- 暴露因素定义模糊,前后口径不同。
- 结局变量记录不全,无法做生存分析或预后分析。
- 同一指标来自不同检验系统,单位没有统一。
这些问题会直接拉低研究可信度,也会拖慢晋升节奏。
1.2 高质量数据决定你能走多远
临床数据整理能力强的医生,往往能更快形成自己的研究路线。原因很简单。
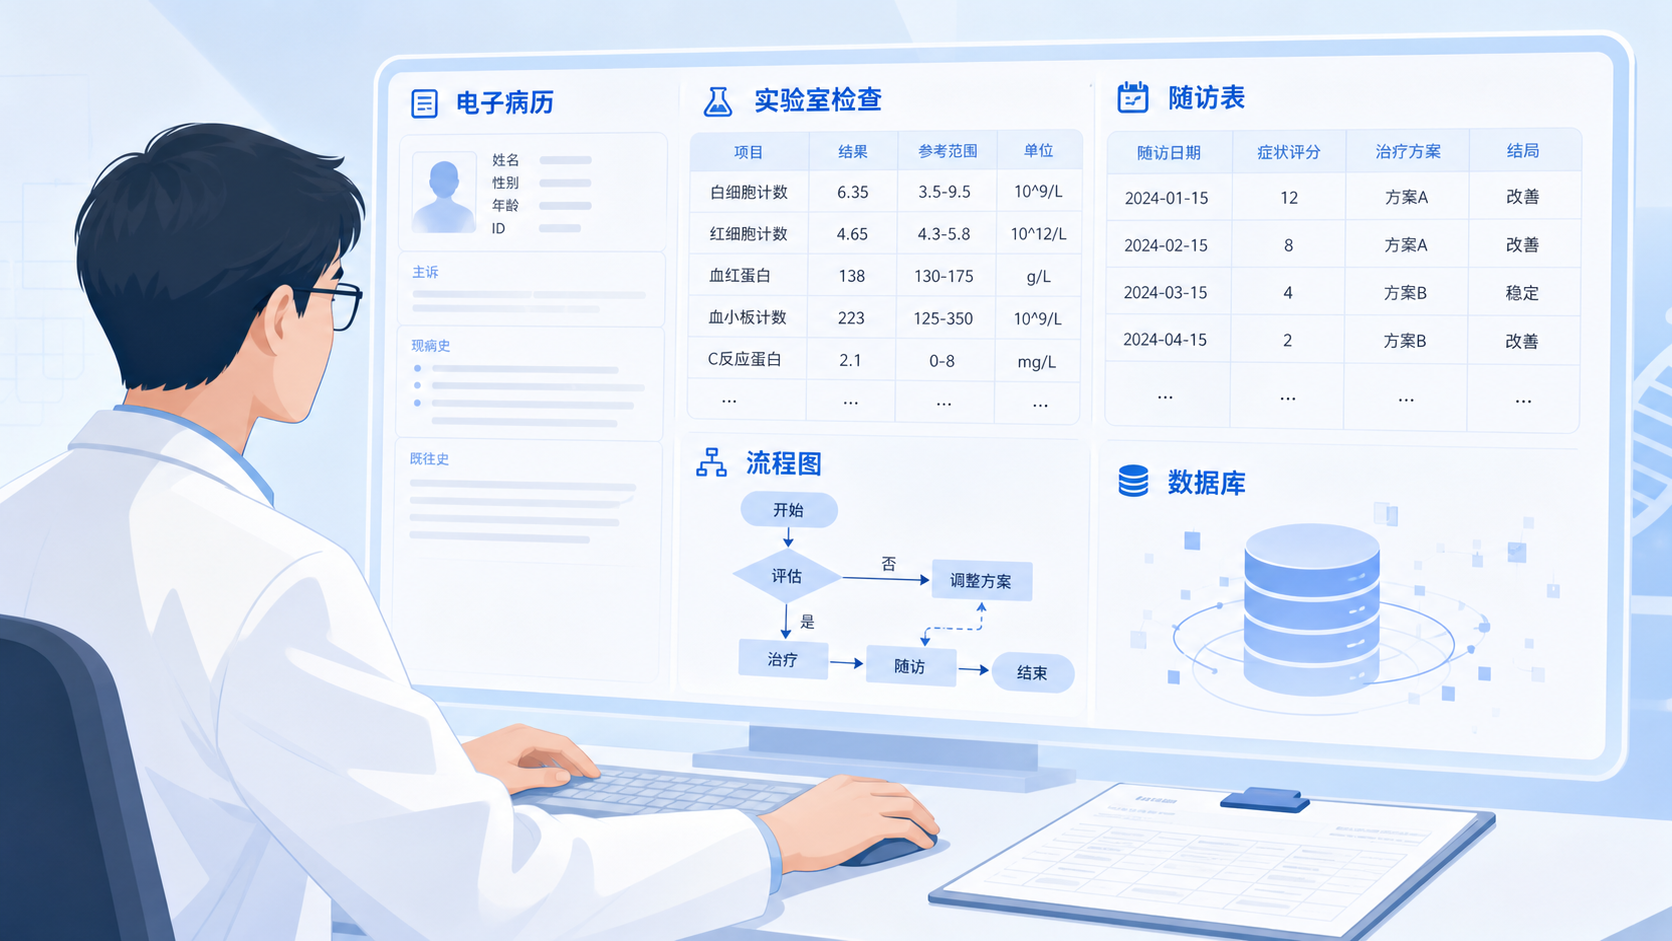
他们不是等别人给题目,而是能从病历、检验、影像、手术记录和随访中主动发现问题。数据越完整,研究问题越容易被提出,也越容易被验证。
从实践看,数据整理不是简单录入,而是一个标准化过程。它包括:
- 确定研究问题。
- 定义变量。
- 统一口径。
- 清洗异常值。
- 处理缺失数据。
- 建立可复用数据库。
这也是为什么很多团队强调,晋升真正的硬门槛,不是“会不会看文献”,而是能不能把临床原始数据整理成可发表、可复现、可扩展的研究资产。
2. 临床原始数据整理的核心步骤
2.1 先统一研究问题,再动手收数
临床数据整理最怕“边收边改”。一旦研究问题反复变,字段就会越来越乱。
正确做法是先固定研究框架,再定义变量清单。尤其是回顾性研究,必须提前写清:
- 纳入标准。
- 排除标准。
- 暴露因素。
- 结局指标。
- 协变量和混杂因素。
变量定义越清楚,后续统计越省力。
比如同样是“感染”,是入院48小时内感染,还是住院期间感染,必须提前统一。否则不同研究者录入的数据会互相冲突。
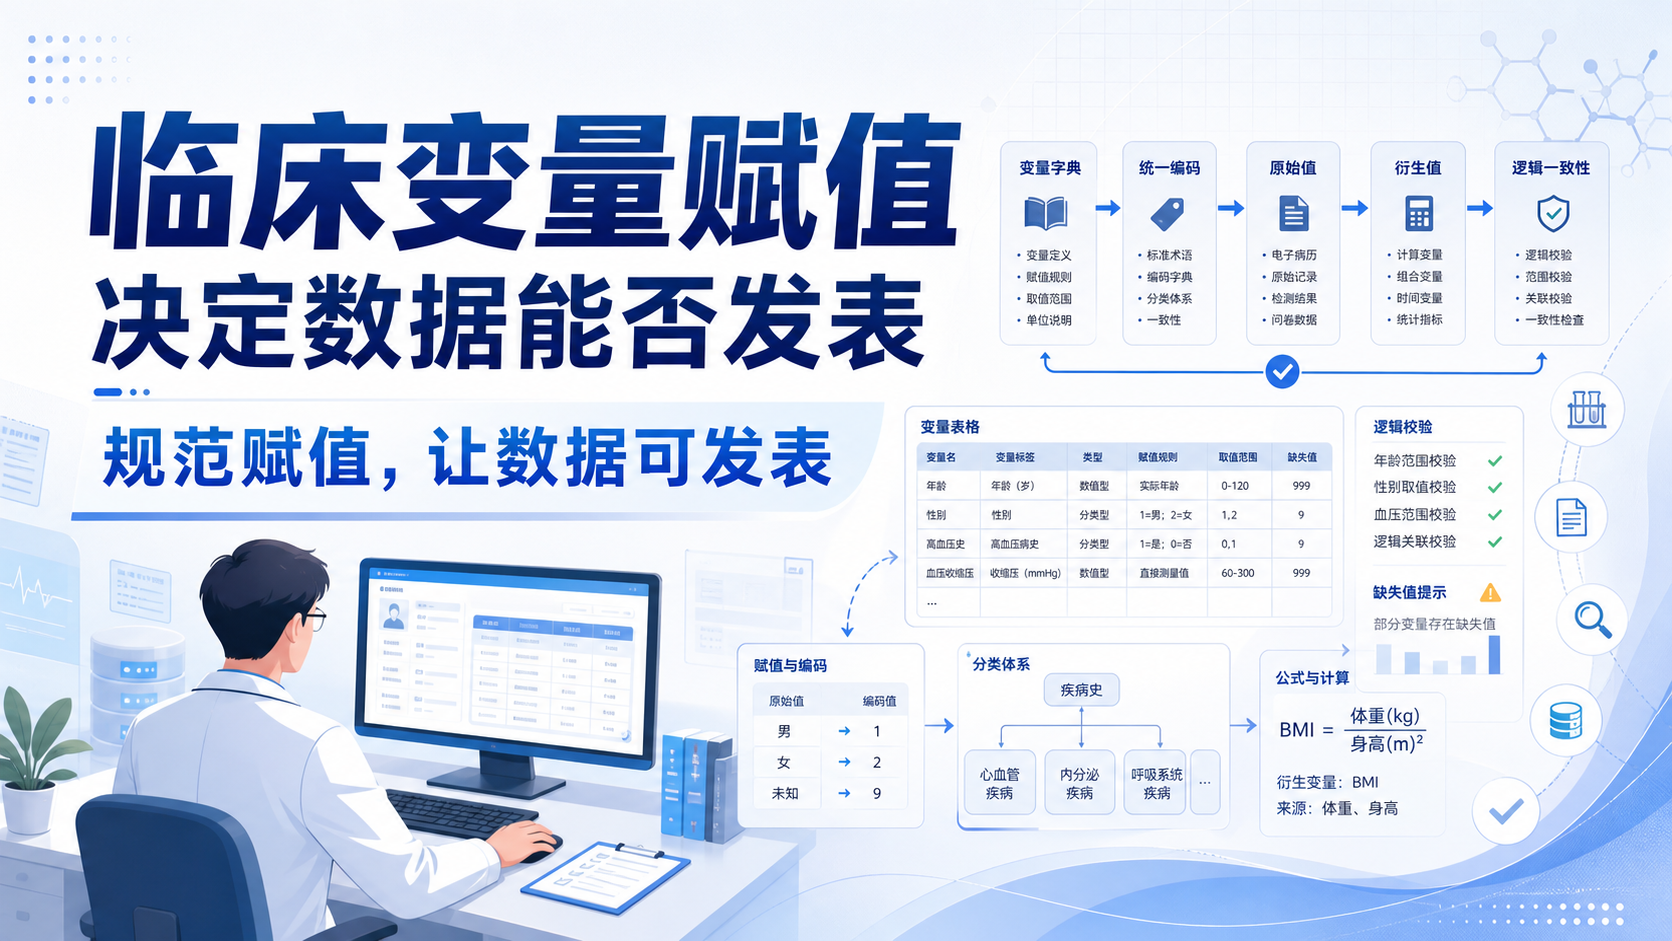
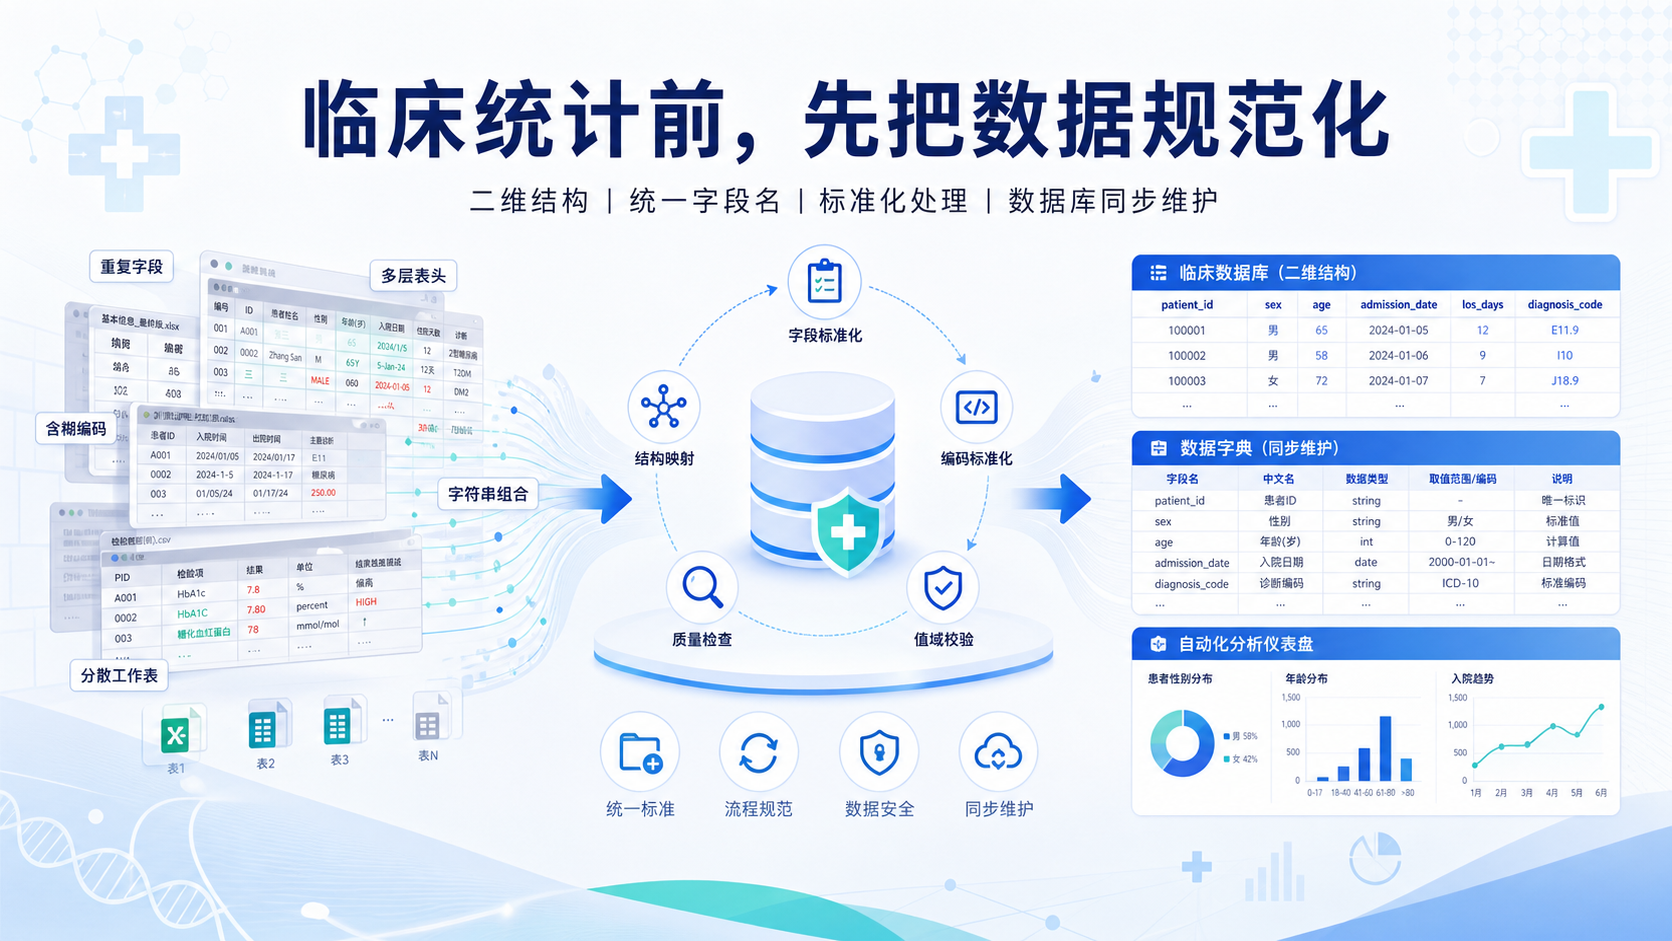
2.2 建立标准化数据字典
数据字典是临床原始数据整理的核心工具。它至少应包含:
- 变量名称。
- 变量定义。
- 数据来源。
- 单位。
- 取值范围。
- 缺失值编码规则。
例如,白细胞计数、肌酐、乳酸、CRP 等实验室指标,必须统一单位和检测时间点。
同一指标如果来源不同数据库,必须先做口径对齐。 这是很多多中心研究最容易忽略的地方。
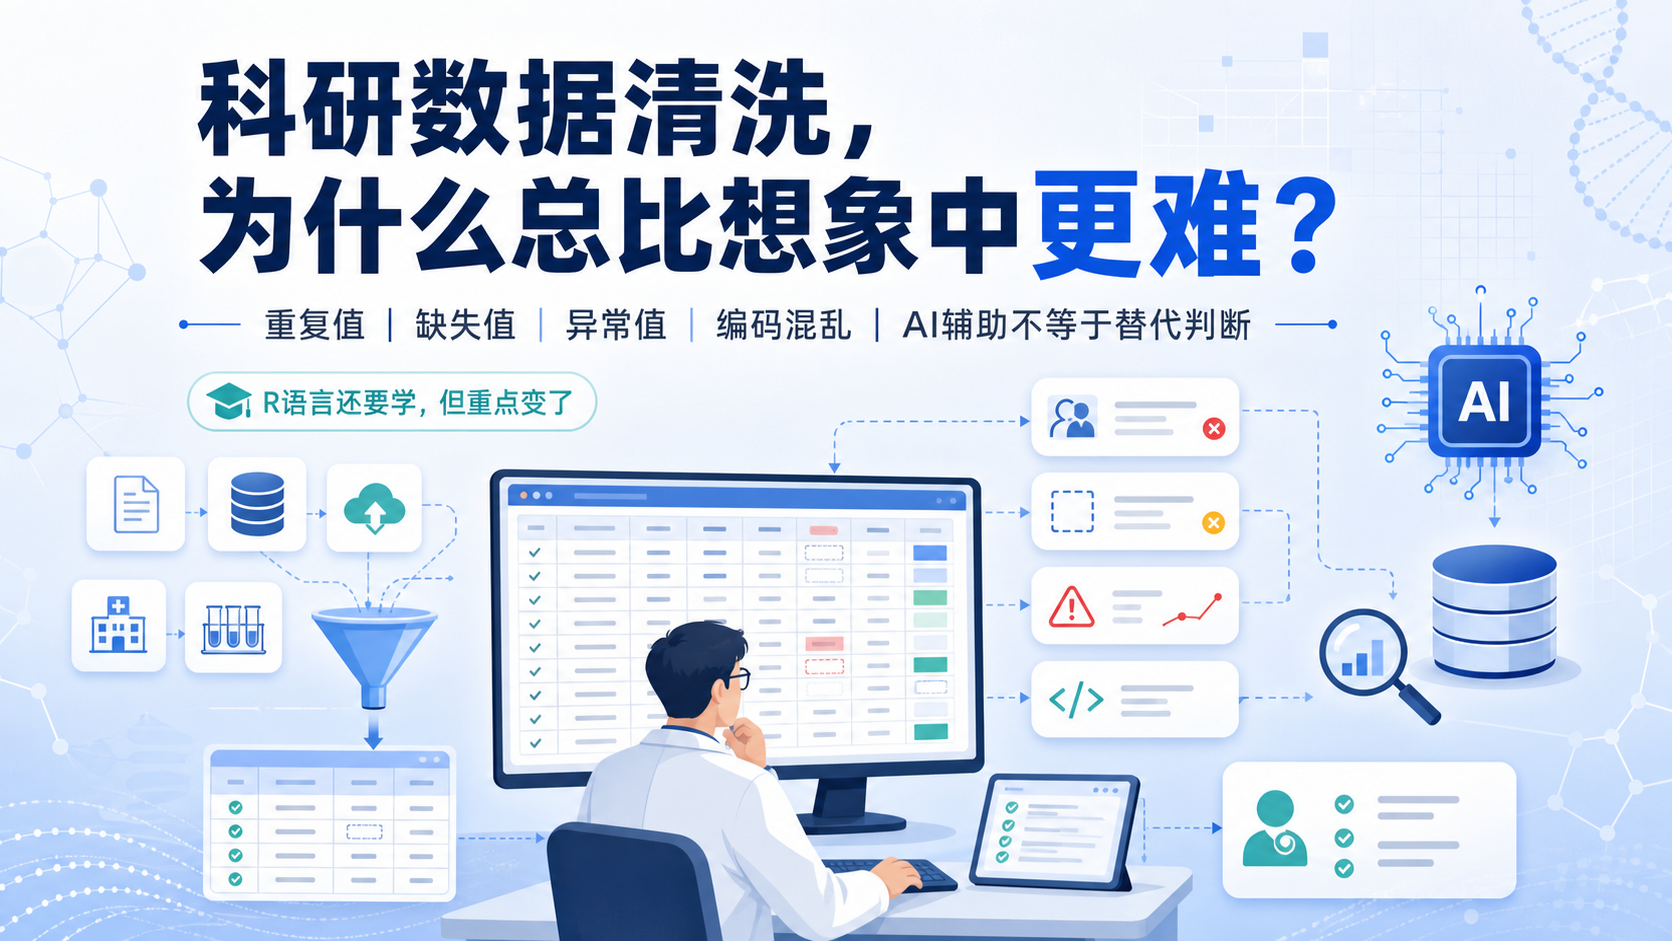
2.3 清洗数据,先做“排除法”
临床数据里常见问题有三类:
- 重复记录。
- 极端值。
- 不完整记录。
处理时建议按顺序排查:
- 查重复病例号和重复时间点。
- 查明显超出生理范围的数值。
- 查缺失比例过高的变量。
- 查时间逻辑冲突,比如死亡时间早于入院时间。
数据清洗不是删得越多越好,而是保留真实、完整、可解释的信息。
如果删得过多,样本量会下降,统计效能也会受影响。
2.4 缺失值处理要有原则
临床研究中,缺失值几乎不可避免。关键是处理方式要一致。
常见方法包括:
- 完整病例分析。
- 均值或中位数填补。
- 多重插补。
- 按缺失情况分层分析。
但并不是所有变量都适合插补。对于核心结局变量,不能轻易补值。
对于缺失比例特别高的变量,最好考虑是否纳入主分析。
3. 晋升导向下,什么样的数据整理最有价值
3.1 能支撑连续产出的数据最有价值
临床晋升不是只看一篇文章,而是看你是否具备持续研究能力。
因此,最有价值的数据整理,不是一次性项目,而是可复用的数据平台。比如:
- 某专科疾病数据库。
- ICU 住院患者数据库。
- 某手术术后随访数据库。
- 某类实验室指标与预后数据库。
一套整理规范的数据,能支持多个研究问题。
今天做预后分析,明天做风险分层,后天做模型构建。这样更符合晋升所需的持续产出逻辑。
3.2 结合临床场景做变量设计
真正有临床价值的数据整理,不是堆字段,而是围绕临床路径设计变量。
例如研究脓毒症、急性肾损伤、术后并发症或 ICU 预后时,应优先整理:
- 基线人口学特征。
- 生命体征。
- 实验室检查。
- 治疗措施。
- 结局指标。
- 随访信息。
变量设计要服务于临床假设,而不是反过来。
如果只是为了凑字段,最后往往分析很多,却没有真正能解释临床问题的主线。
3.3 图表和流程也要提前规划
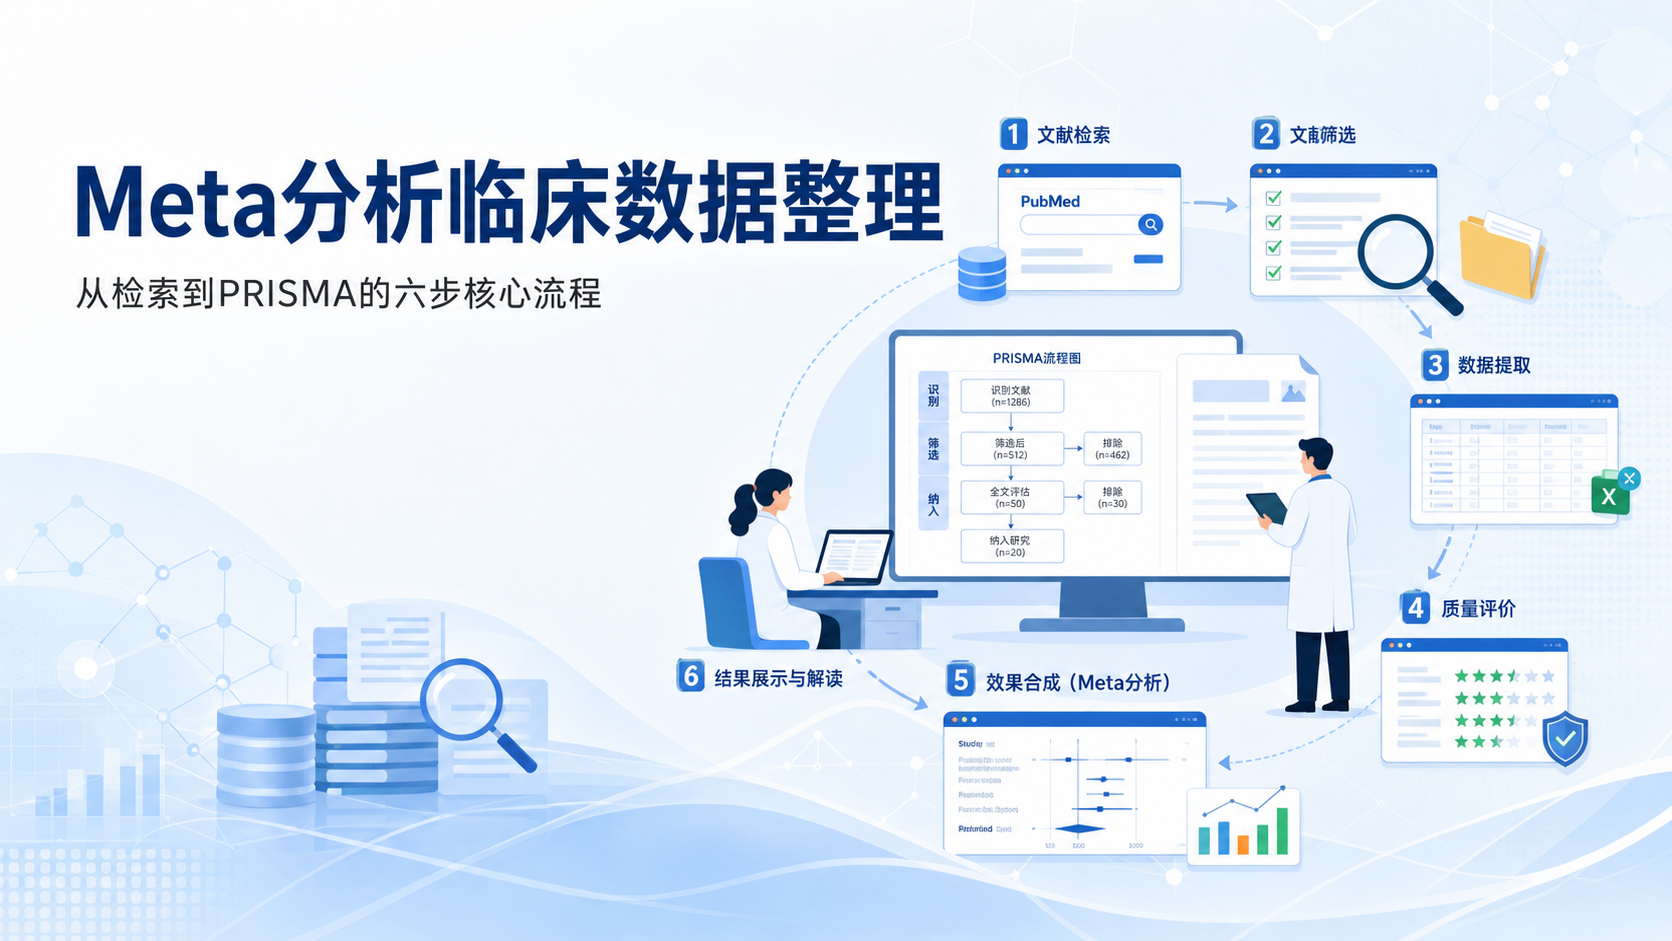
高质量临床研究通常不仅有表格,还有清晰流程图。
建议在数据整理阶段就同步规划:
- 纳入排除流程图。
- 基线资料表。
- 相关性分析表。
- 回归分析表。
- 生存曲线或分层图。
这样做的好处是,后期写作不会返工。
数据整理做得好,文章结构自然清晰。 这对第一次发文章的年轻医生尤其重要。
4. 从“会收数”到“会发文”,差别就在规范化
4.1 规范化收集,决定审稿人是否信服
审稿人最常问的,不是你用了什么高级模型,而是数据是否可靠。
所以临床原始数据整理必须做到可追溯:
- 每个变量的来源可查。
- 每个结局的定义可查。
- 每次排除的理由可查。
- 每一步数据处理有记录。
可追溯性,是临床研究信任度的核心。
没有这一步,后续再好的统计方法都容易被质疑。
4.2 团队协作比个人蛮干更有效
真正高效的数据整理,往往不是一个人硬扛,而是分工明确。
例如:
- 临床医生负责定义变量和判读医学含义。
- 研究人员负责清洗和统计。
- 数据管理人员负责格式统一和质控。
- 资深导师负责研究方向把关。
这种协作模式,能显著提升效率,也能减少低级错误。
对于准备晋升的医生来说,把数据基础打牢,比盲目追热点更重要。
4.3 研究能力的差距,往往从数据开始拉开
同样是做一篇临床文章,有的人两周就能进入统计阶段,有的人三个月还在补病历。
差别不在努力程度,而在于是否形成了自己的数据整理流程。
一套成熟的整理规范,能让你面对新课题时快速复制。
这也是很多医院越来越重视数据管理培训的原因。因为一旦基础数据稳定,后面的模型分析、论文写作和课题申报都会顺很多。
5. 用好专业支持,才能把数据变成成果
5.1 自己做,容易卡在细节
临床原始数据整理看起来简单,实际很耗时间。
常见卡点包括:
- 病历字段不一致。
- 变量命名混乱。
- 数据口径前后不统一。
- 统计前发现大量缺失。
- 返修时补数据来不及。
这些问题会消耗大量精力。对临床工作繁忙的医生来说,尤其明显。
如果没有标准化工具和流程,数据整理往往会拖慢整个课题周期。
5.2 解螺旋可以帮助你把整理流程做规范
如果你希望把临床原始数据整理做得更稳、更快,解螺旋 可以提供从数据规范、变量梳理到研究设计的支持。
对于需要晋升、发文或做课题申报的医生来说,这类专业协助能帮助你:
- 明确研究变量。
- 优化数据表结构。
- 减少无效返工。
- 提高数据可分析性。
把临床数据整理好,才有机会把研究做深,把文章做稳。
这一步做对了,后面的统计、写作和投稿都会更顺。
总结Conclusion
临床数据整理不是琐事,而是医生晋升的基础能力。它决定了研究能不能做深、文章能不能发表、课题能不能持续。对医学生、医生和科研人员来说,真正的竞争力,不只是会看文献,而是能把临床原始数据整理成规范、可信、可复用的研究资产 。
如果你正在准备晋升、做课题,或者想提升临床研究产出效率,建议尽早建立标准化的数据整理流程。也欢迎了解解螺旋 ,让专业团队帮助你把临床数据整理得更规范、更高效,更快走向可发表、可晋升的研究成果。

- 引言Introduction
- 1. 为什么临床数据整理会直接影响晋升
- 2. 临床原始数据整理的核心步骤
- 3. 晋升导向下,什么样的数据整理最有价值
- 4. 从“会收数”到“会发文”,差别就在规范化
- 5. 用好专业支持,才能把数据变成成果
- 总结Conclusion