21
 分享
引言Introduction
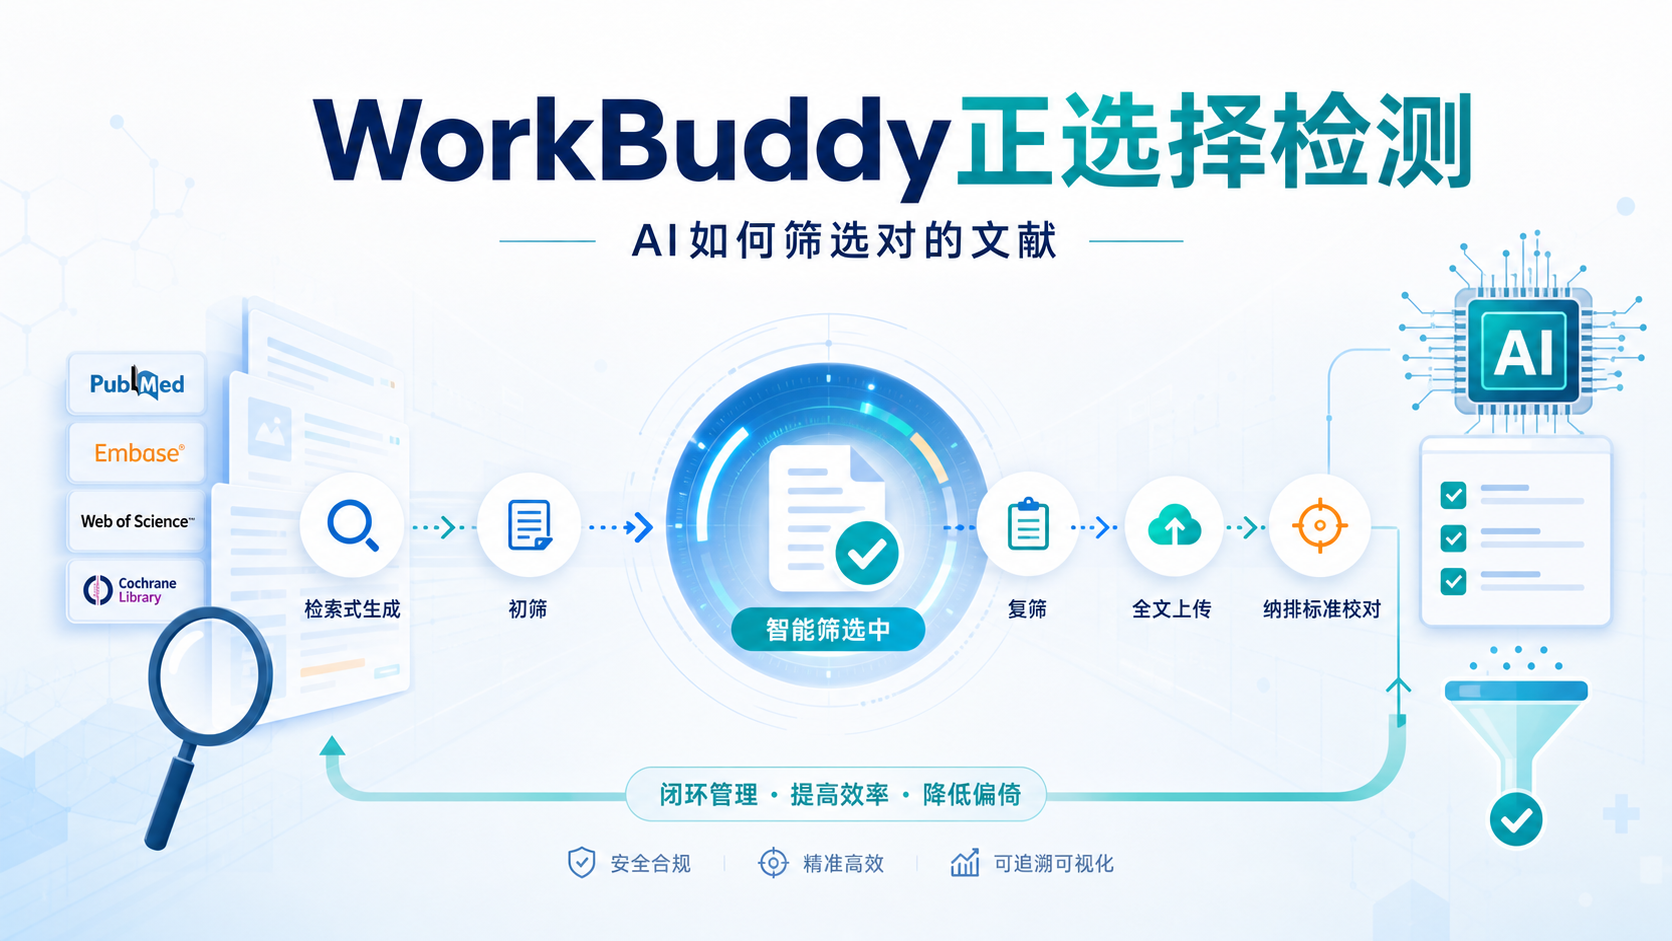
做系统综述或Meta分析时,最耗时的往往不是写作,而是检索、筛选、复筛和数据提取 。如果纳排标准不清,检索式不稳,后面每一步都会返工。WorkBuddy正选择检测,核心就是把这条流程变得更可控。
1. 什么是WorkBuddy正选择检测
1.1 它解决的不是“找文献”,而是“选对文献”
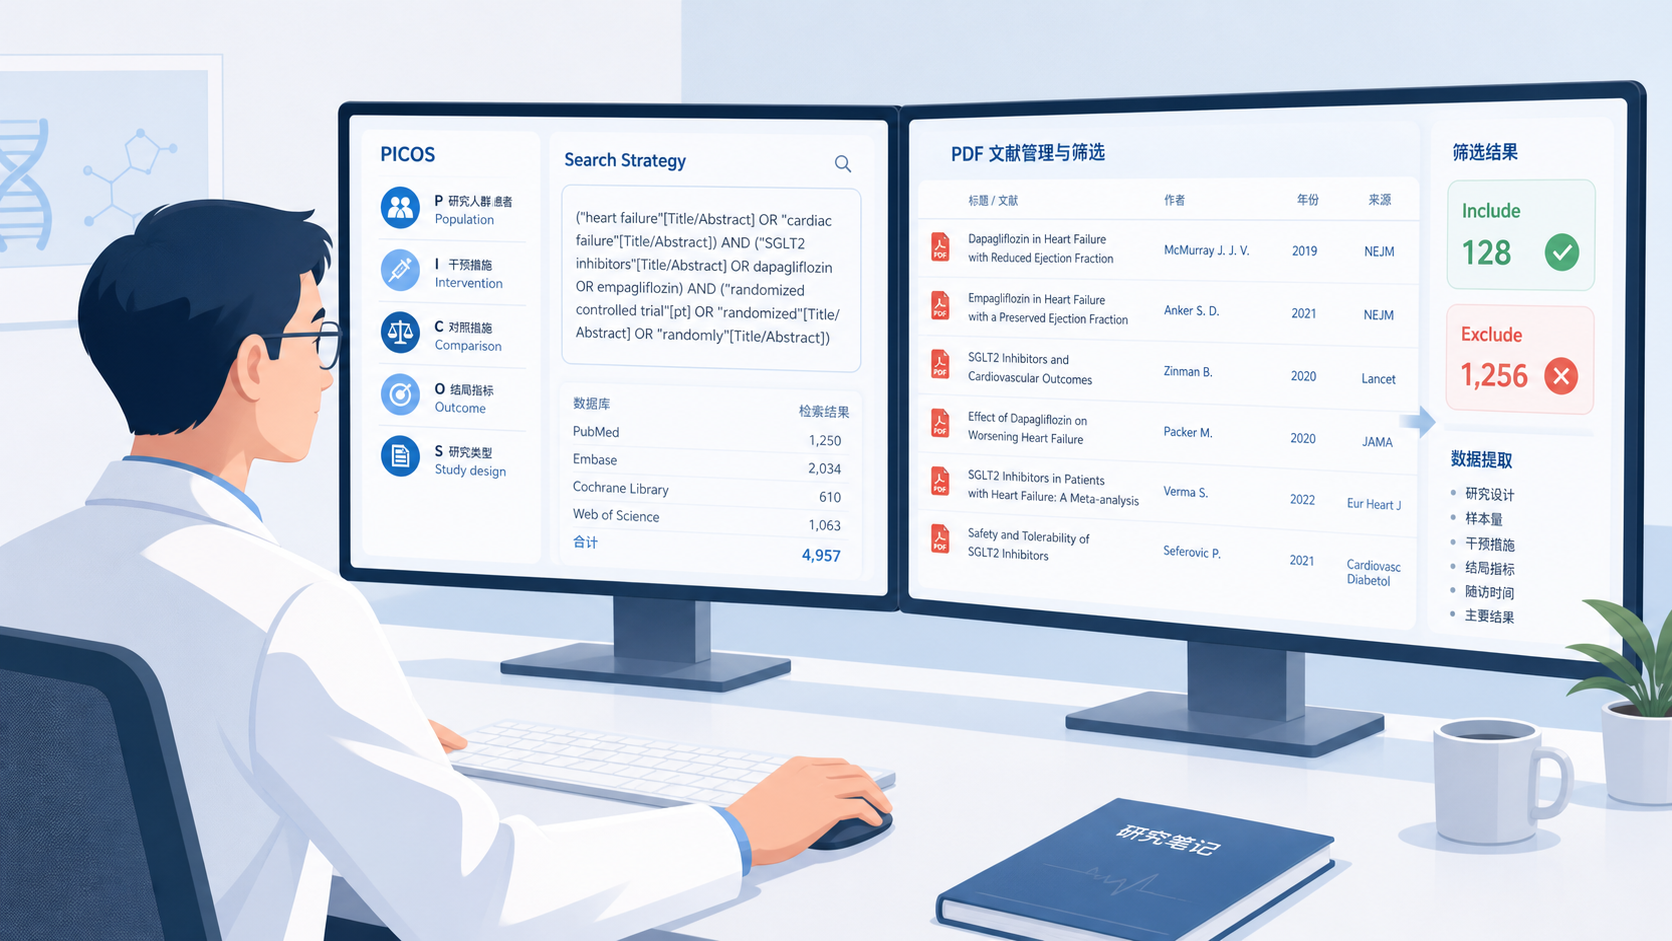
WorkBuddy正选择检测更准确地说,是一套围绕纳排标准、检索式生成、初筛复筛、全文提取 的辅助流程。它不是替代研究者判断,而是把流程拆成标准化步骤,减少遗漏和重复劳动。
对于医学生、医生和科研人员来说,真正的痛点通常有三个。
- 选题后,不知道如何快速生成PICOS。
- 纳排标准写得宽或窄,导致结果失控。
- 文献太多,筛选和提取耗时长,且容易出错。
WorkBuddy的价值在于,把“主观性很强”的环节前置管理。
1.2 适合哪些研究场景
这类工具更适合做需要明确比较对象和结局指标的研究,比如系统综述、Meta分析、干预研究证据汇总等。尤其当你需要从多个数据库中统一筛选文献时,它能显著提升流程一致性。
但要注意,工具只能辅助,不会替你判断所有临床问题 。尤其是纳排标准,必须由研究者结合课题背景进行校对。因为非原则性的微调,就可能让最终纳入文献数量和研究结论发生明显变化。
2. 从纳排标准开始:WorkBuddy的第一道关口
2.1 纳排标准为什么最关键
在系统综述中,纳排标准决定你“研究什么”和“排除什么”。它直接影响样本是否一致,结论是否可靠。对Meta分析而言,这一步不是形式,而是方法学核心。
WorkBuddy的工作方式是,用户输入选题关键词后,系统可帮助生成PICOS、纳排标准和检索式。这个过程能节省起草时间,但AI生成内容必须人工审核 。尤其是以下三类内容,不能直接照搬。
- 研究对象的限定。
- 干预措施和对照方式。
- 结局指标和研究类型。
2.2 为什么说纳排标准具有主观性
纳排标准在方法学上存在一定主观空间。比如年龄范围、结局测量时间点、是否允许联合干预、是否纳入某类观察性研究,都可能影响结果。
但这种主观性有边界。不能出现明显临床原则性错误 ,比如把不相关疾病混为一类,或把无法比较的研究类型强行纳入同一分析。否则后续的异质性会非常高,甚至让结果失去解释价值。
2.3 实操中应该怎么校对
建议在使用WorkBuddy生成的纳排标准后,按以下顺序核对。
- 研究问题是否清晰。
- 人群是否可比。
- 干预和对照是否一致。
- 结局是否可量化。
- 研究设计是否与目标一致。
如果你的课题只纳入RCT,非RCT应在早期就明确排除。 这一点很重要,因为工作台当前对非RCT类型研究有排除策略,标准一旦设定,就会影响后续筛选逻辑。
3. 检索式生成:从单库思维到多库适配
3.1 AI可以生成检索式,但不能忽略数据库差异
WorkBuddy支持根据纳排标准生成检索式,并针对不同数据库输出不同格式。这一点对科研人员很有用,因为PubMed、Embase等数据库的字段和语法并不完全一致。
同一个研究问题,在不同数据库中必须使用不同写法。 这也是很多初学者容易出错的地方。关键词、主题词、布尔逻辑、字段限定,任何一个环节都可能影响召回率。
3.2 检索式优化的重点
生成检索式后,建议重点检查以下内容。
- 是否覆盖同义词。
- 是否包含核心主题词和自由词。
- 是否存在逻辑断裂。
- 是否过宽导致噪音过多。
- 是否过窄导致漏检。
如果检索结果太少,可能是关键词覆盖不够。如果结果过多,通常说明限定条件不足。真正可用的检索式,应该在敏感性和特异性之间取得平衡。
3.3 目前的数据库支持边界
根据现有知识库,WorkBuddy工作台目前纳入了四个数据库的检索结果,但暂不支持中国知网、万方等没有开放API的中文数据库 。这意味着,如果你的课题需要覆盖中文文献,仍需使用人工补充策略。
这不是缺点,而是边界。科研流程中,明确工具能力边界,比盲目依赖更重要。
4. 初筛、复筛与全文上传:把流程做成闭环
4.1 为什么初筛和复筛会慢
当一次检索返回大量文献时,初筛和数据提取节点会明显变慢。原因很直接。系统需要逐条处理标题、摘要、全文信息,并根据设定标准做判断。
此外,WorkBuddy允许手动补充文献和上传全文PDF,用于全文复筛和数据提取。这个设计很好,因为很多真实研究并不是数据库结果就能完全覆盖,人工补文献几乎是必需的。
4.2 全文上传后,AI能做什么
上传PDF后,系统需要先把PDF转换成文本或markdown,再进行信息提取。这个过程通常比标题摘要筛选更耗时,因为全文内容更长,结构也更复杂。
在实践中,AI更适合做以下工作。
- 定位研究设计和样本信息。
- 提取干预措施和对照条件。
- 抽取主要结局数据。
- 辅助整理表格。
但要强调,全文提取的准确性依赖原文清晰度和格式质量 。扫描版、图片版、排版混乱的PDF,都可能增加识别误差。
4.3 推荐的工作流
如果你希望把流程做顺,建议按这个顺序执行。
- 明确选题和PICOS。
- 设定纳排标准。
- 生成并人工校对检索式。
- 检索多个数据库。
- 初筛标题和摘要。
- 复筛全文。
- 上传PDF进行数据提取。
- 最后人工核对表格。
这套流程的关键不是自动化程度,而是每一步都可追溯。
5. 使用WorkBuddy时,最容易踩的坑
5.1 把AI结果当成最终结果
这是最常见的问题。无论是PICOS、纳排标准还是检索式,AI都只能提供草案。真正决定研究质量的,仍然是研究者的判断。
如果你不校对,最容易出现的问题包括:
- 研究对象定义偏移。
- 结局指标不统一。
- 检索范围过窄。
- 误纳入不符合设计的研究。
5.2 忽视纳排标准的细节影响
很多人以为纳排标准只是文字表述,实际上它会直接影响文献池大小和异质性。比如把随访时间放宽,可能纳入更多研究。把联合干预放进去,也可能改变效应方向。
所以,纳排标准不是越宽越好,也不是越严越好,而是要服务于研究问题。
5.3 忽略人工补充
由于当前不支持没有开放API的中文数据库,且支持文献的数量和速度受检索结果规模影响,单纯依赖自动检索往往不够。手动补充文献,实际上是保证完整性的必要步骤。
6. 适合谁用,怎么用才高效
6.1 适合的人群
WorkBuddy正选择检测特别适合以下人群。
- 刚开始做系统综述的医学生。
- 需要快速搭建检索流程的住院医师或临床医生。
- 做课题申报、论文投稿、开题答辩的科研人员。
- 需要提高文献管理效率的研究团队。
6.2 高效使用的原则
想真正提高效率,建议把AI放在“前期建模”和“重复劳动”上,而不是放在最终判断上。
你可以把它当作三类助手:
- 结构助手,帮你生成PICOS和初稿标准。
- 检索助手,帮你适配不同数据库语法。
- 提取助手,帮你从全文中整理结构化信息。
但所有关键节点,仍需人工确认。 这既是科研规范,也是避免返工的最好办法。
6.3 结合解螺旋的工作思路
如果你希望把文献检索、筛选和全文提取做得更稳,可以借助解螺旋 这类科研工具和服务支持。它的价值不在于“替代研究者”,而在于帮助你把流程标准化、可追溯化,减少因为标准模糊、检索不全、提取耗时带来的重复劳动。对需要快速推进选题和写作的人来说,这种支持很实用。
总结Conclusion
WorkBuddy正选择检测的核心,不是简单替你找文献,而是把纳排标准、检索式、初筛复筛和全文提取 串成一条更清晰的研究流程。对医学生、医生和科研人员来说,最大的收益是节省时间,减少遗漏,提高方法学一致性。
但也要记住,AI生成内容必须人工校对 。尤其是纳排标准,既有主观性,也有方法学边界。只有把工具和专业判断结合起来,才能真正提高系统综述和Meta分析的质量。
如果你正在准备系统综述、Meta分析或课题开题,想让流程更省时、更规范,可以了解解螺旋 。把重复工作交给工具,把关键判断留给专业。

- 引言Introduction
- 1. 什么是WorkBuddy正选择检测
- 2. 从纳排标准开始:WorkBuddy的第一道关口
- 3. 检索式生成:从单库思维到多库适配
- 4. 初筛、复筛与全文上传:把流程做成闭环
- 5. 使用WorkBuddy时,最容易踩的坑
- 6. 适合谁用,怎么用才高效
- 总结Conclusion