3
 分享
引言Introduction
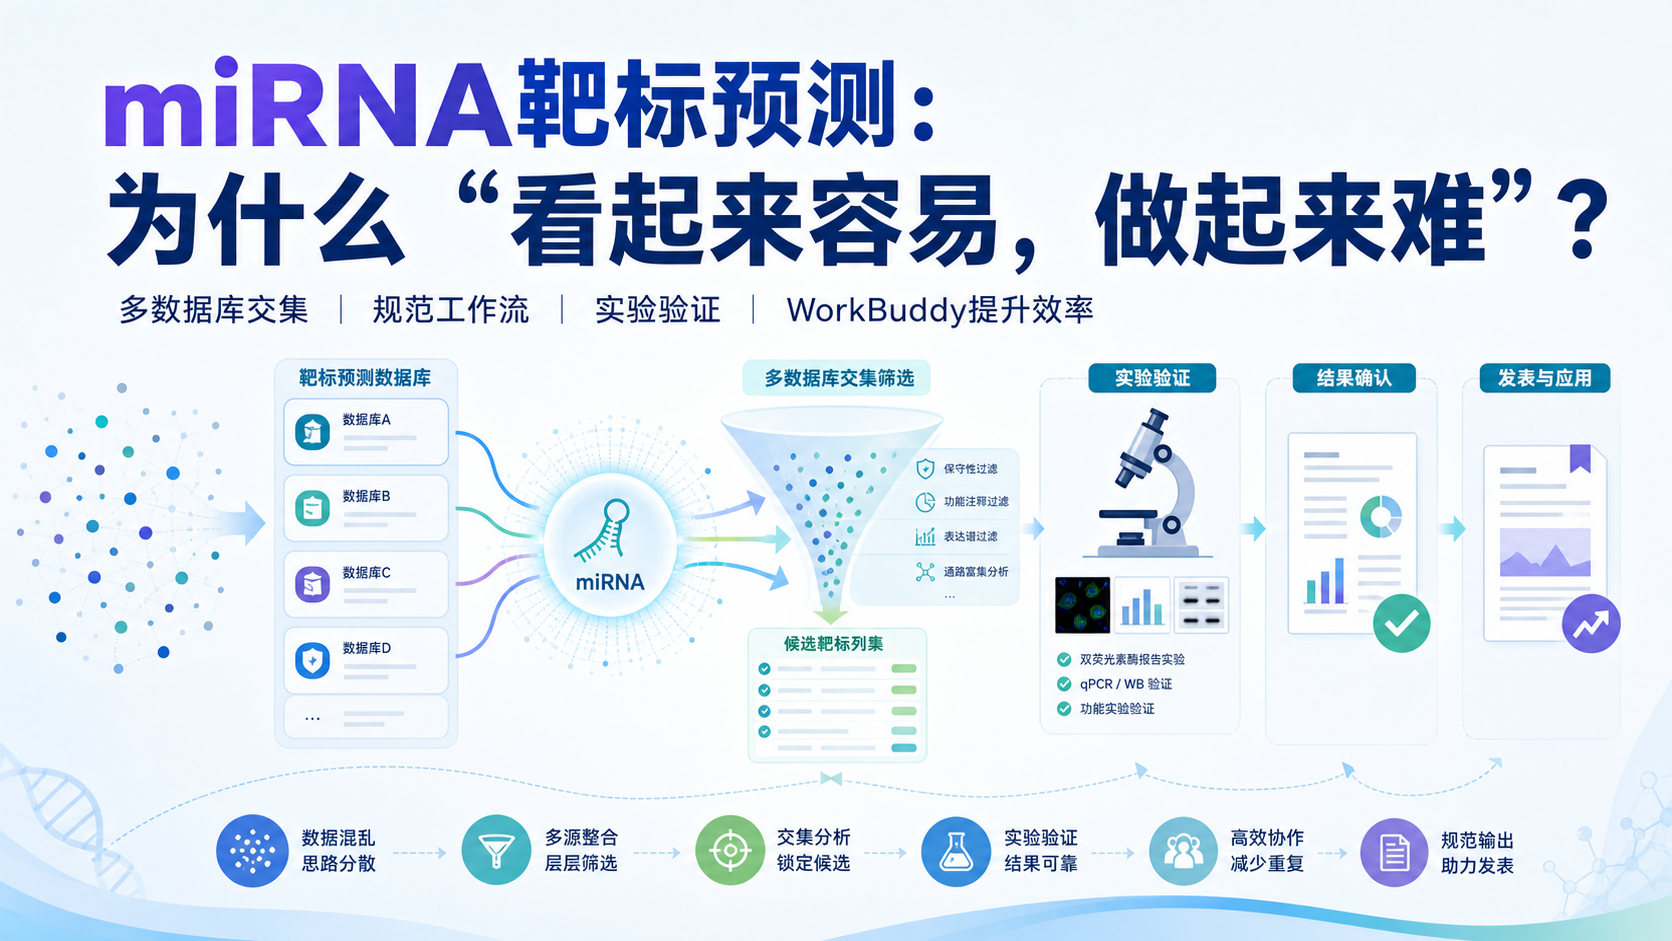
miRNA靶标预测看似简单,实际常卡在结果太多、数据库不一致、验证链条不闭合。对医学生、医生和科研人员来说,难点不是“能不能预测”,而是“如何快速缩小范围并提高可信度”。WorkBuddy可以把分散的预测思路整理成可执行流程,帮助你更快找到下一步实验方向。
1. miRNA靶标预测为什么总是“看起来容易,做起来难”
1.1 预测结果多,但真正可用的很少
miRNA通常通过种子序列与mRNA 3’UTR结合。理论上,一个miRNA可调控多个靶基因,一个靶基因也可被多个miRNA调控。这种网络结构决定了预测结果天然庞大。如果只看单一数据库,往往会得到成百上千个候选靶点。
更现实的问题是,不同数据库算法不同。
有的强调种子序列匹配,有的看保守性,有的看自由能,有的整合CLIP-Seq证据。结果就是,同一个miRNA在不同平台上的候选列表并不一致。
1.2 只做预测不做验证,结论不成立
生信预测的本质是“高概率候选”,不是客观事实。
这一点在miRNA研究里尤其重要。因为miRNA在哺乳动物中多通过不完全互补配对抑制翻译,单靠序列信息很难直接证明靶向关系。
所以规范流程一定是:
- 先预测。
- 再交叉筛选。
- 最后实验验证。
没有验证的靶标,只能算假说。不能算结论。
1.3 初学者最常见的三个误区
很多研究者在起步阶段会踩到同样的坑。
- 只依赖一个数据库。
- 不结合表型和文献背景。
- 不区分预测靶点和验证靶点。
这些问题会直接拉长项目周期。也会增加后续实验成本。
2. miRNA靶标预测的核心逻辑
2.1 先理解miRNA作用机制
miRNA的经典合成路径包括pri-miRNA、pre-miRNA和成熟miRNA。成熟miRNA进入RISC复合体后发挥作用。在动物细胞中,最常见的机制是通过与mRNA 3’UTR不完全互补配对,抑制翻译或影响mRNA稳定性。
因此,靶标预测不能只看“有没有配对”,还要看:
- 种子区是否匹配。
- 结合位点是否保守。
- 热力学稳定性如何。
- 位点是否可及。
- 是否有实验支持证据。
2.2 常用预测依据有哪些
从现有生信框架看,miRNA靶标预测主要依赖以下几类信息。
- 序列互补性 :最核心。尤其是5’端第2到第8位种子序列。
- 进化保守性 :跨物种保守位点更可信。
- 热动力学因素 :自由能越低,结合越稳定。
- 位点可及性 :mRNA二级结构会影响可结合程度。
- 位点位置与碱基分布 :也会影响RISC效率。
这也是为什么不同工具的输出会有差异。它们看的是不同证据层。
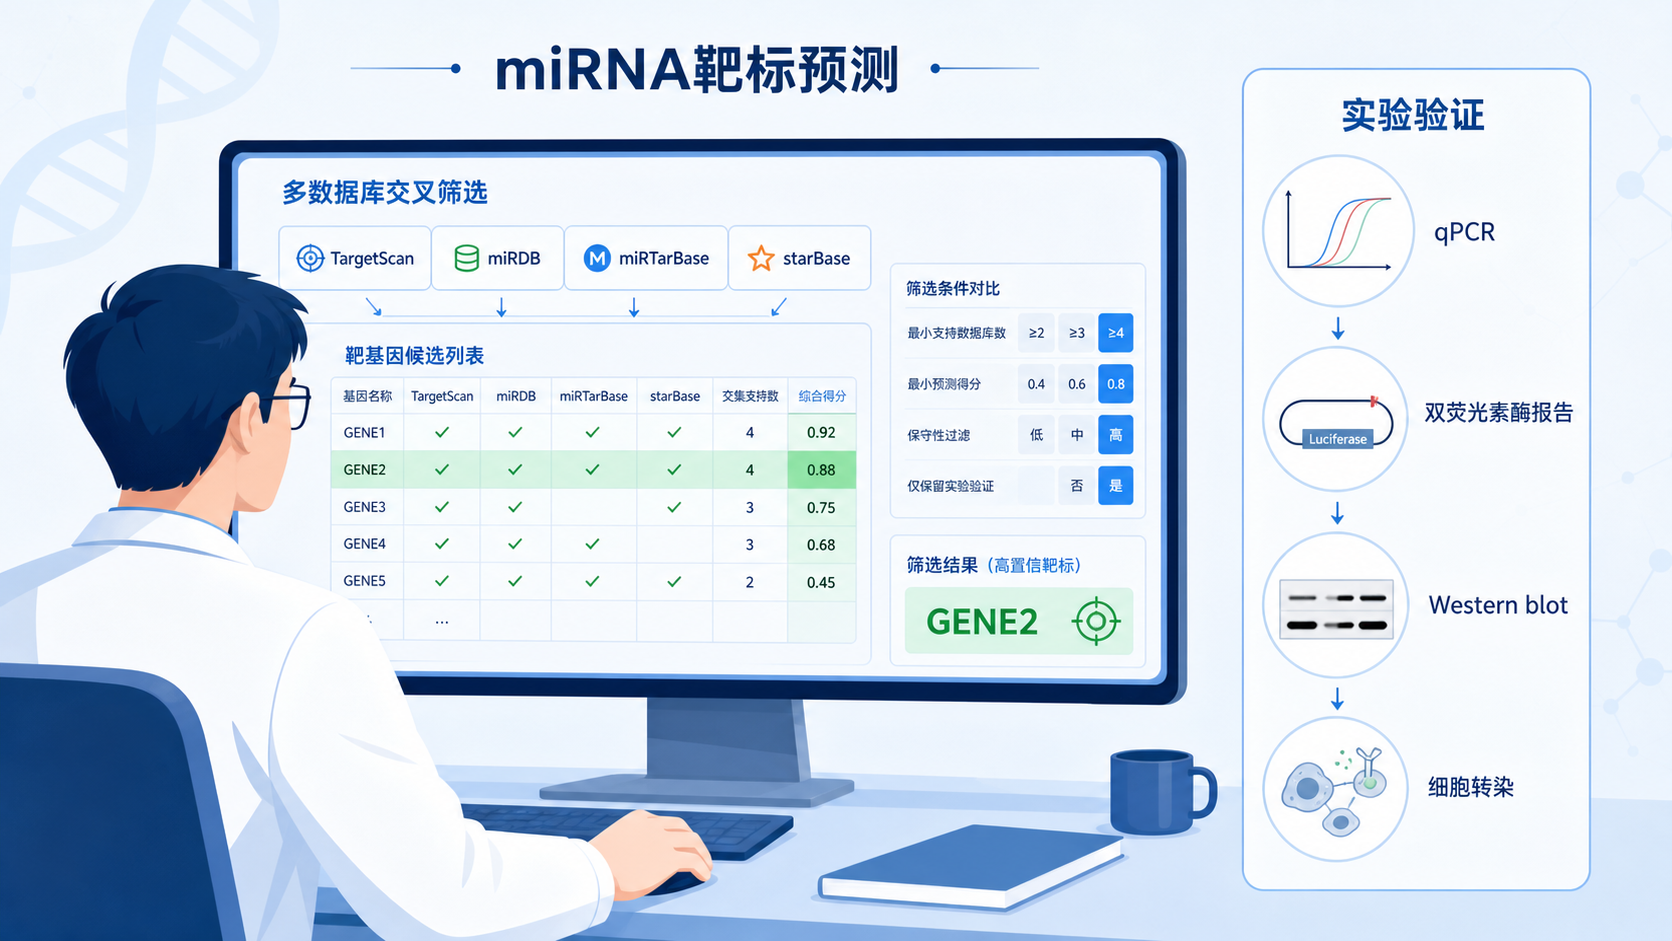
2.3 为什么必须做多数据库交集
单库结果多,假阳性也多。
多数据库取交集,是缩小范围最稳妥的方法。
这一步的逻辑很清晰。
如果多个独立算法都认为某个基因是靶点,那么它更值得进入后续验证。
反过来,只在一个平台出现的基因,不一定没有意义,但优先级应更低。
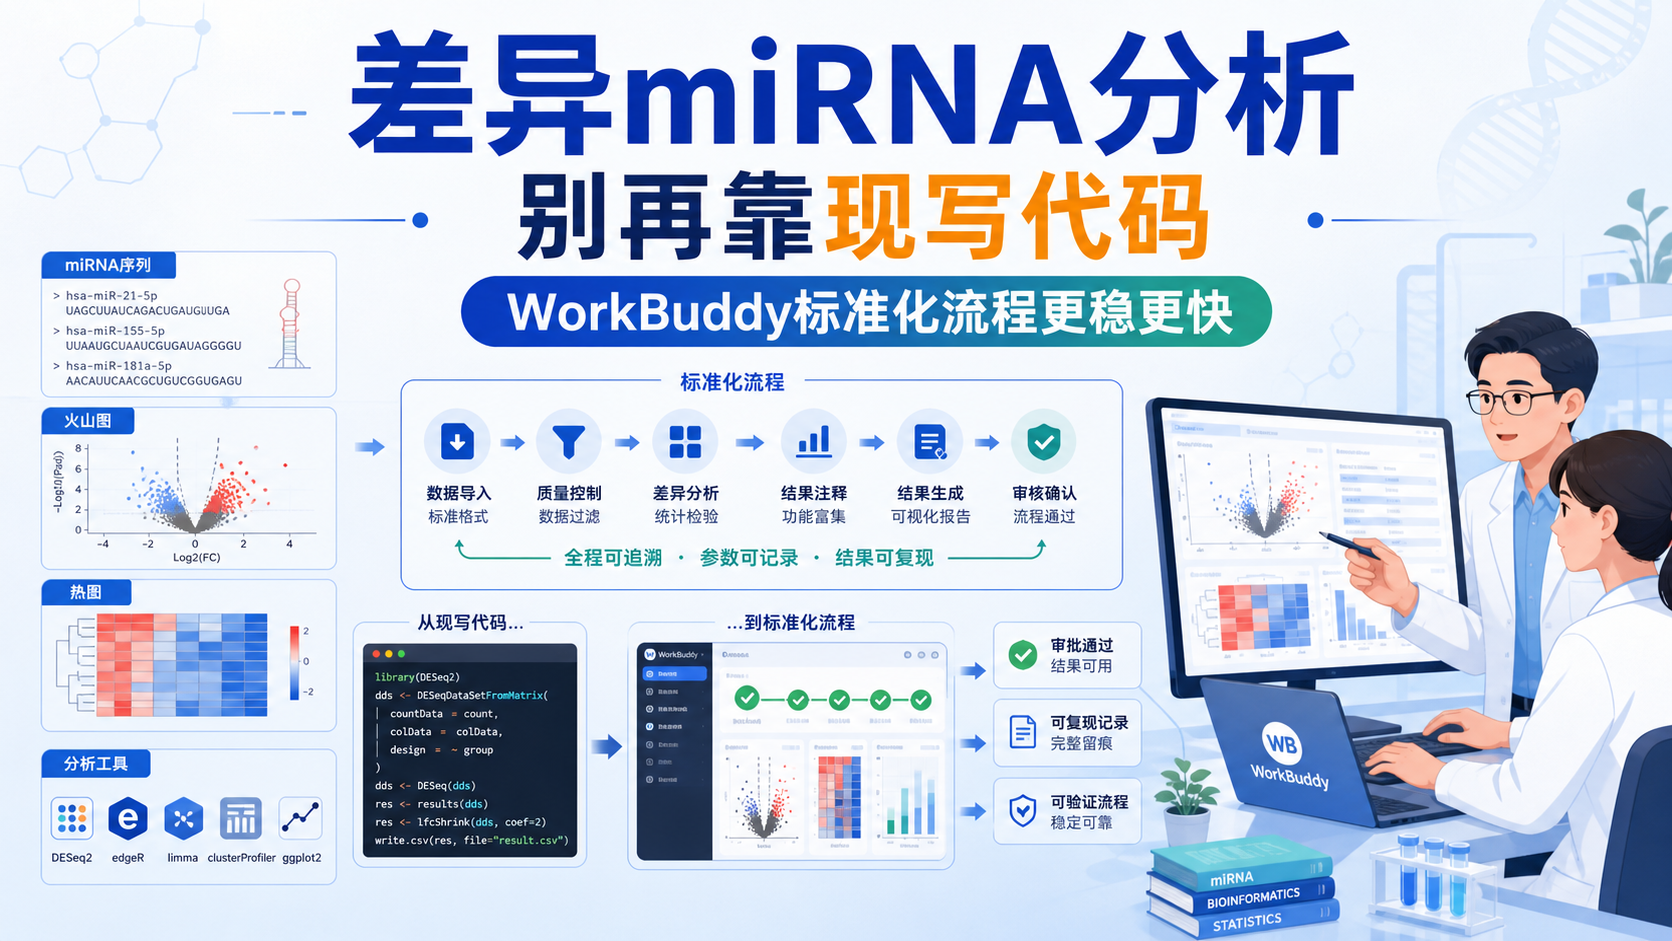
这也是WorkBuddy适合介入的地方。它更适合做“流程管理”和“结果整理”,帮助你把分散工具的输出快速归类,减少人工比对时间。
3. WorkBuddy如何提升miRNA靶标预测效率
3.1 把“散乱检索”变成“结构化筛选”
很多人做miRNA项目时,最浪费时间的不是实验,而是整理数据。
不同数据库导出的结果格式不同,字段不同,命名也可能不统一。比如同一个基因,可能因为转录本差异而出现多条记录。
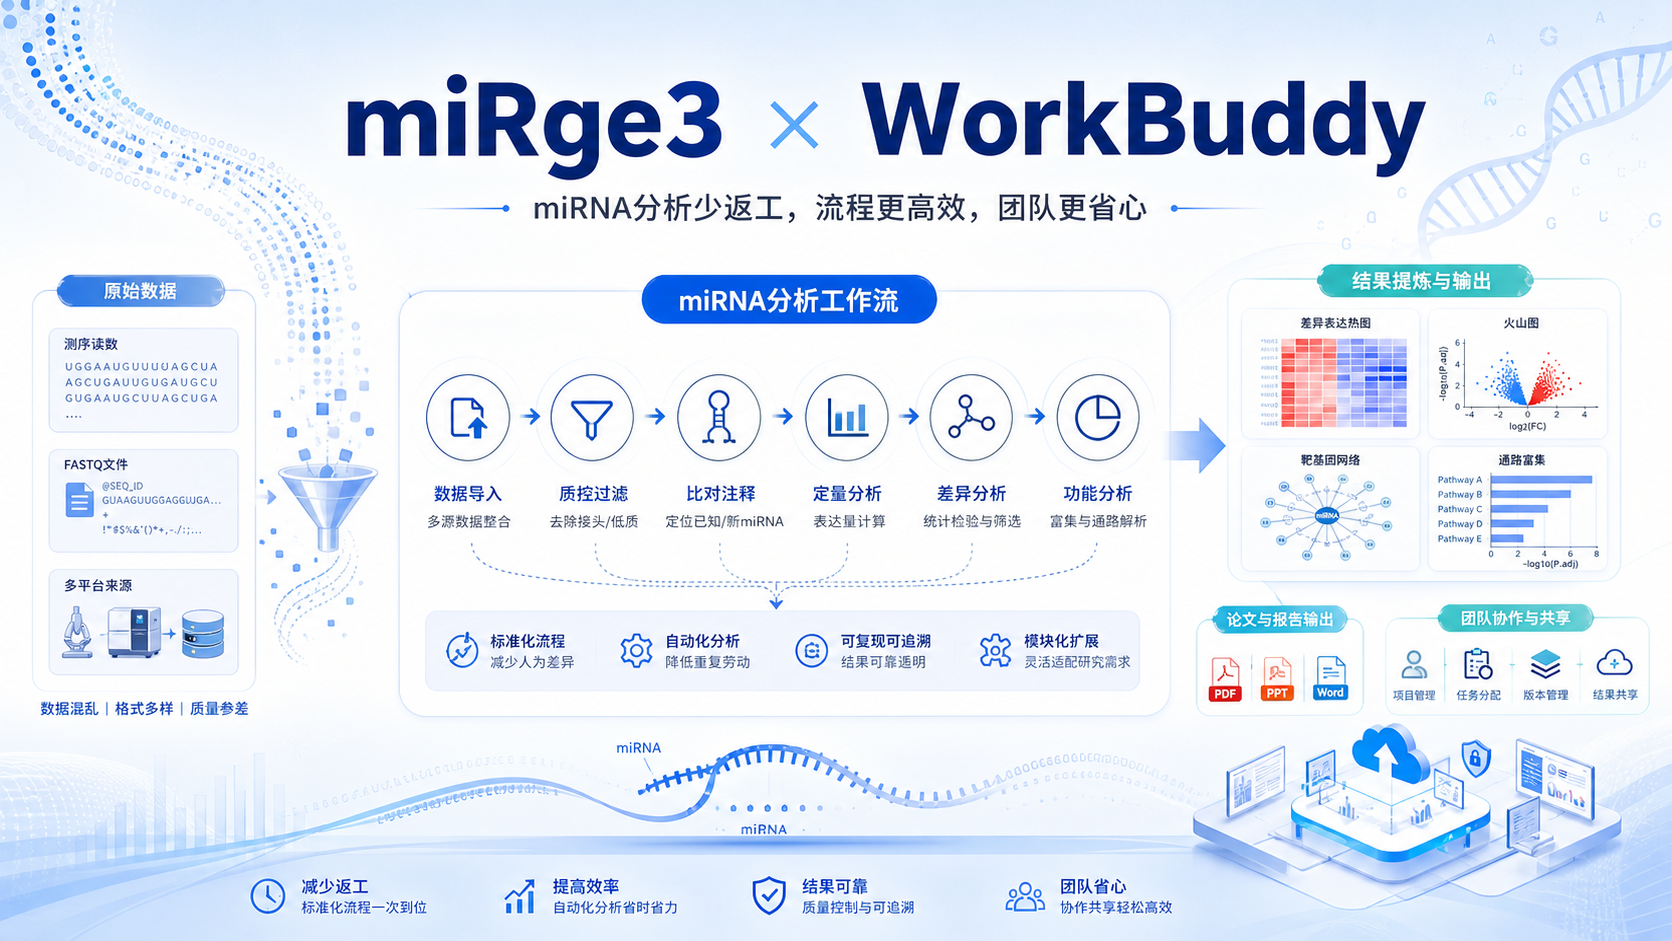
WorkBuddy的价值在于把筛选过程标准化。
你可以按以下逻辑整理信息:
- miRNA名称。
- 数据库来源。
- 候选靶基因。
- 保守性或评分。
- 是否有文献支持。
- 是否进入验证列表。
这样做的好处是,后续开题、组会、文章写作都更顺畅。
3.2 用“表型优先”替代“盲目追热门基因”
靶标不是越热门越好。
真正合理的选择标准,是靶点是否能解释你的表型。
比如你的实验现象是增殖增强、迁移增加、凋亡减少,那么靶点应优先考虑与细胞周期、黏附、凋亡、EMT相关的基因。
如果你的研究方向是肿瘤、炎症或代谢,也应回到疾病背景和通路逻辑上去选。
WorkBuddy更适合帮助研究者建立这条思路。
先按表型筛,再按数据库交叉验证,最后结合文献和通路分析。
3.3 适合科研团队的协作场景
在课题组里,miRNA靶标预测往往不是一个人完成的。
有人负责生信,有人负责细胞实验,有人负责文献梳理。
如果没有统一流程,结果很容易出现版本混乱。
WorkBuddy在这类场景下更像一个协作中枢。
它可以帮助团队统一记录:
- 预测对象。
- 筛选标准。
- 候选优先级。
- 验证进度。
这对提升项目复现性很关键。
4. miRNA靶标预测的规范工作流
4.1 推荐的四步流程
一个更稳妥的研究路径,通常包括以下步骤。
- 明确研究表型和疾病背景。
- 用多个数据库做靶标预测。
- 结合交集、保守性和文献缩小范围。
- 通过实验验证靶向关系。
这一流程看似朴素,但非常有效。
它能明显减少无效候选,提升后续验证成功率。
4.2 常见数据库各自适合做什么
在实际研究中,常用数据库各有侧重。
- TargetScan :强调种子区和保守性,适合初筛。
- miRanda :看序列匹配、热稳定性和保守性,候选较多。
- miRDB :更注重预测模型和二级结构相关信息。
- miRWalk、ENCORI :适合做综合比对和证据整合。
其中,ENCORI整合了多种数据库信息,也可结合CLIP-Seq证据,适合作为交叉验证平台。
对于需要压缩候选范围的项目,这类综合平台很实用。
4.3 最终验证仍然离不开实验
生信只能帮你缩小范围。
真正确认靶标关系,仍要回到实验。常见验证路径包括:
- 双荧光素酶报告实验。
- qPCR和Western blot。
- 过表达或抑制miRNA后的表型观察。
- 必要时结合RIP、CLIP等技术。
如果预测结果和实验表型一致,整个证据链就更完整。
这也是高质量论文最看重的部分。
5. WorkBuddy带来的实际改变
5.1 减少重复劳动
miRNA靶标预测最消耗时间的地方,往往是多平台比对和结果整理。
WorkBuddy如果能把这些流程模块化,就能显著降低重复输入和手动整理成本。
这对课题推进非常重要。
5.2 让科研判断更清晰
很多时候,研究者不是缺工具,而是缺判断框架。
WorkBuddy的意义,不在于替代专业分析,而在于帮助你更快形成“可验证假说”。
这会直接影响开题效率、实验路线和论文质量。
5.3 让项目更接近发表标准
高质量的miRNA研究,不是“找到一个靶点”这么简单。
而是要回答三个问题:
- 为什么选它。
- 为什么可信。
- 为什么能解释表型。
WorkBuddy如果用于标准化记录与筛选,就能帮助研究者把这三点写清楚。
这对投稿和答辩都很重要。
总结Conclusion
miRNA靶标预测不是单纯的数据库检索,而是一个“预测、筛选、验证”逐步收敛的过程。真正高效的做法,是结合多数据库交叉、表型导向筛选和实验验证。 对医学生、医生和科研人员来说,流程清晰比结果堆积更重要。
如果你希望把分散的靶标预测过程变成标准化、可协作、可追踪的研究流程,可以借助 解螺旋 提供的工具化支持,进一步提升miRNA课题推进效率。

- 引言Introduction
- 1. miRNA靶标预测为什么总是“看起来容易,做起来难”
- 2. miRNA靶标预测的核心逻辑
- 3. WorkBuddy如何提升miRNA靶标预测效率
- 4. miRNA靶标预测的规范工作流
- 5. WorkBuddy带来的实际改变
- 总结Conclusion