3
 分享
引言Introduction
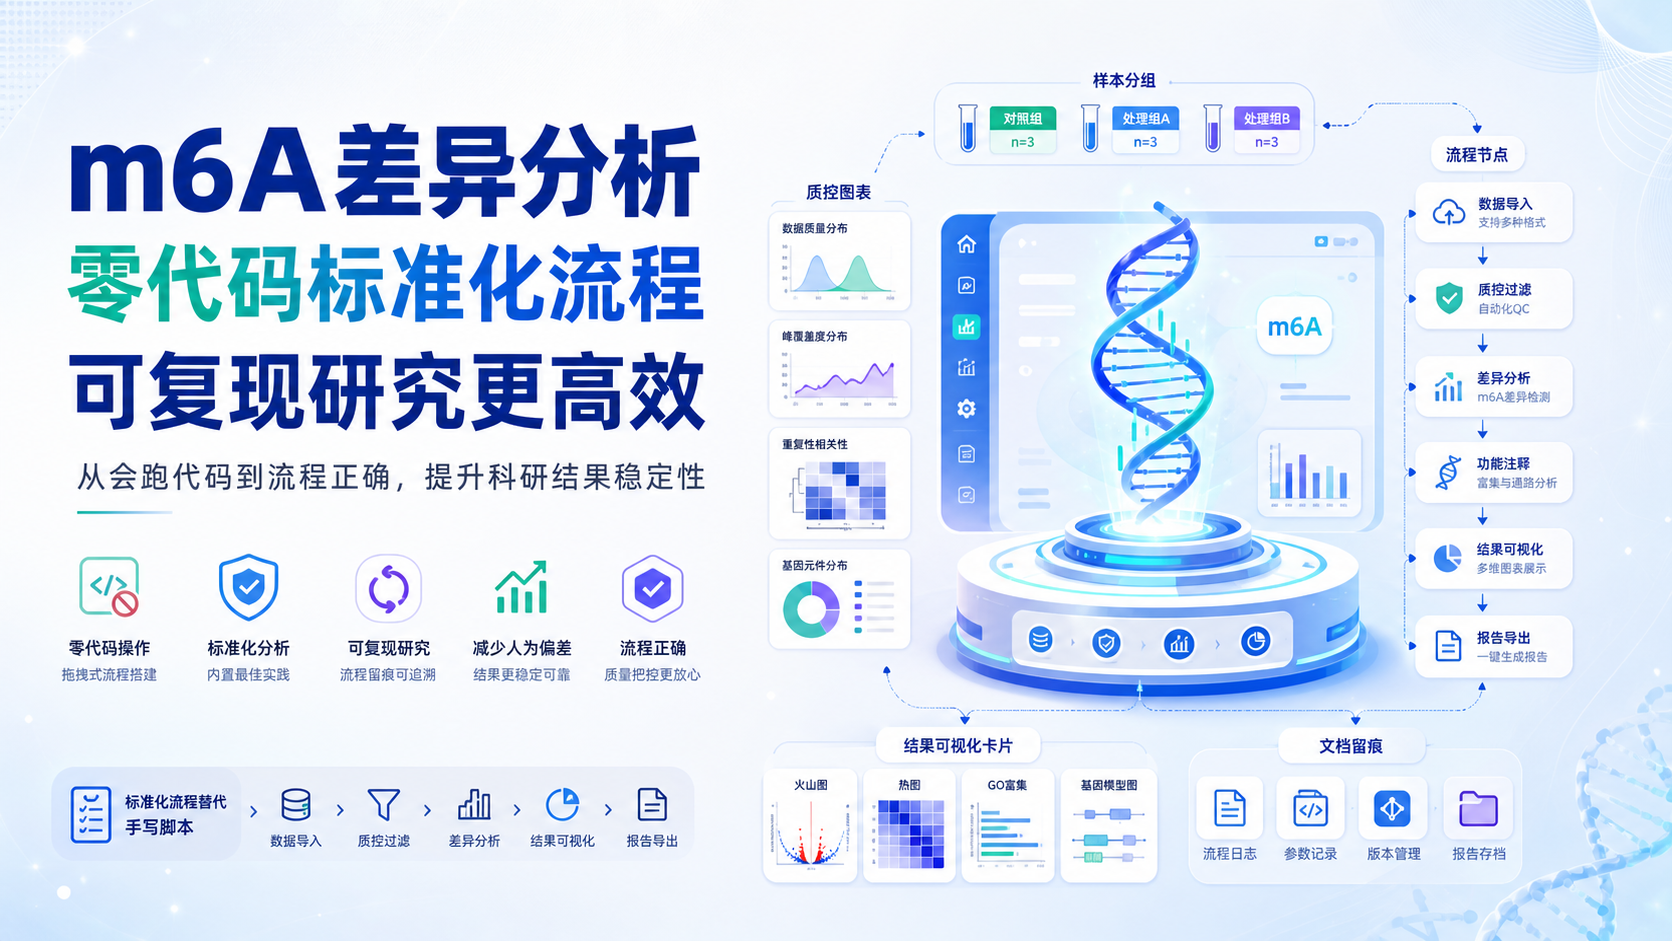
m6A差异分析常见痛点是流程长、参数多、结果难复现。对医学生、医生和科研人员来说,真正难的不是“看懂结果”,而是“把分析跑对”。如果工具能把固定流程标准化,零代码也能做出可验证的分析。 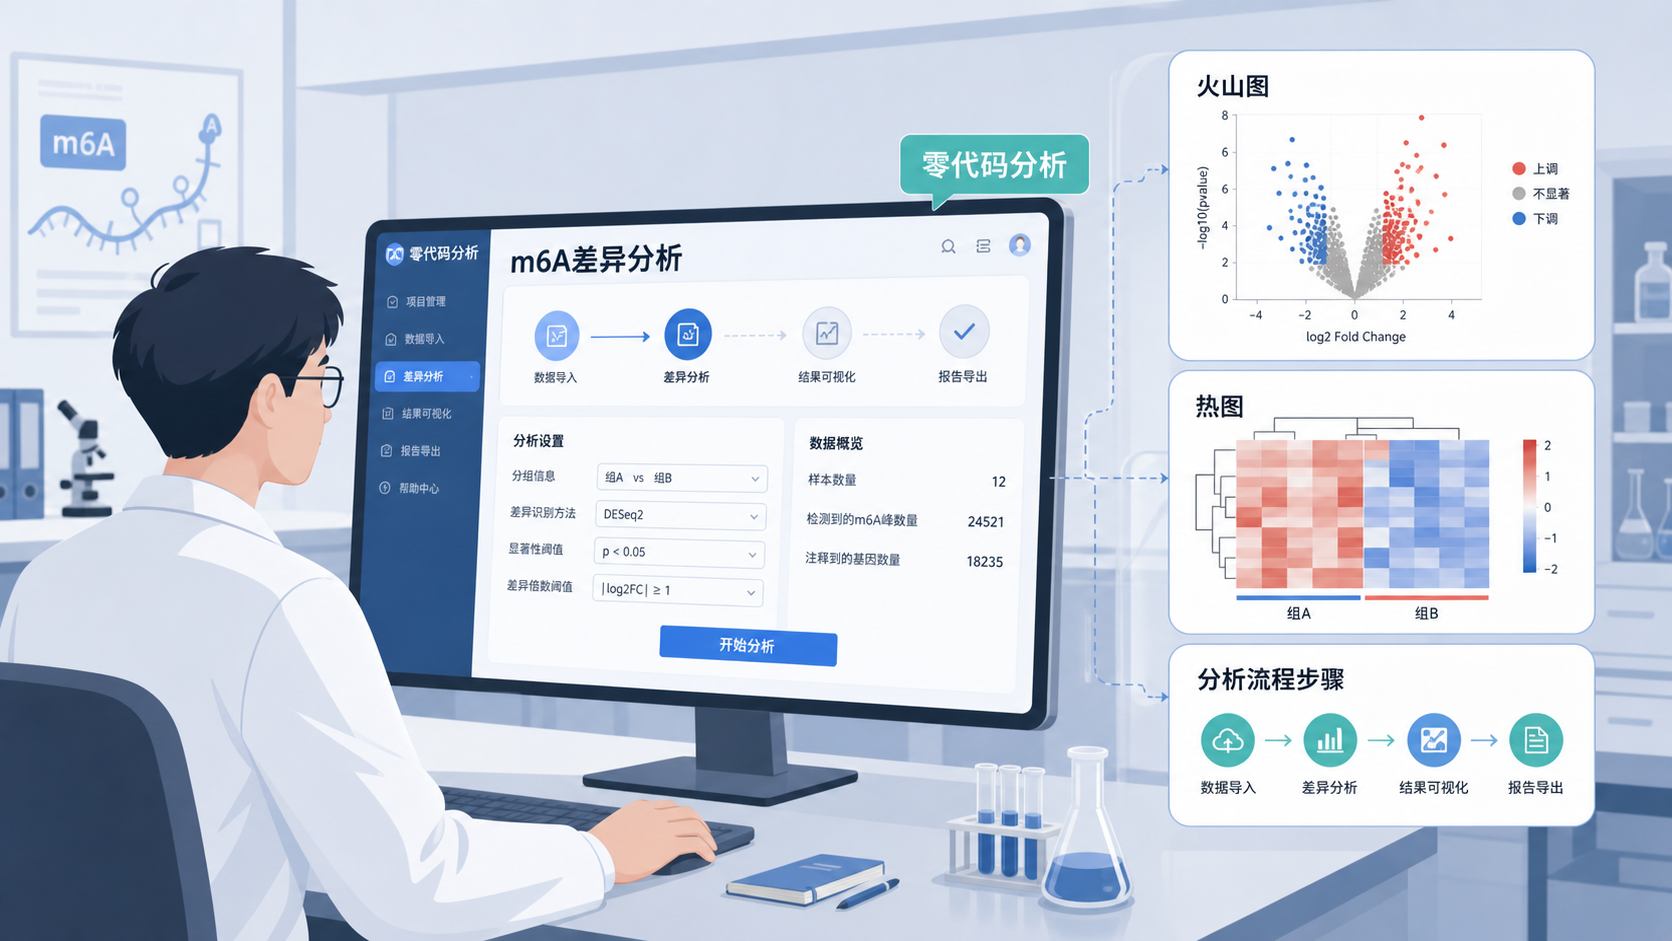
1. 为什么m6A差异分析更需要标准化流程
1.1 m6A差异分析的核心,不是“会跑代码”,而是“流程正确”
m6A差异分析通常涉及样本分组、表达矩阵整理、过滤低质量信号、统计检验和可视化。每一步都可能影响最终结论。
在真实研究中,常见问题有:
- 样本分组顺序错误。
- 过滤阈值不统一。
- 重复运行后结果不一致。
- 代码可跑,但难以复现。
对于临床研究和基础研究,分析结果必须能解释,也必须能复现。 这比单次跑通更重要。
1.2 传统现写代码方式的局限
知识库中提到,AI如果“自己现写代码”做数据分析,输出并不稳定。即使同样任务执行两次,文本和代码也可能不同。对懂代码的人,这还可以人工审核和修正。但对不熟悉代码的人,风险很高。
这类风险主要体现在:
- 代码逻辑不可控。
- 参数设置容易漂移。
- 结果难以追溯。
- 不利于团队协作和复用。
m6A差异分析属于典型的固定流程任务,最适合用稳定工具和标准化模块完成。
2. WorkBuddy如何把m6A差异分析变成零代码流程
2.1 用工具代替手写脚本,更适合科研场景
知识库强调,真正理想的方向不是让模型临时写代码,而是让它调用固定工具、固定代码包来完成分析。原因很直接。固定流程比临时生成的代码更可控,也更容易验证。
对m6A差异分析而言,标准化工具的价值在于:
- 输入固定格式的数据。
- 自动调用预设分析流程。
- 结果输出统一。
- 便于重复使用和团队共享。
WorkBuddy的优势,正在于把分析过程尽量工具化,而不是依赖每次重新生成代码。
2.2 零代码并不等于“无逻辑”,而是“逻辑被封装”
很多人误以为零代码就是点几下按钮。实际上,科研级零代码的前提是流程已经被封装好。用户不需要写代码,但底层仍然遵循统计学和生物信息学规则。
在m6A差异分析中,这种封装通常包括:
- 数据导入与检查。
- 分组信息匹配。
- 标准化处理。
- 差异分析建模。
- 结果导出与可视化。
这意味着研究者关注的是生物学问题,而不是重复劳动。
2.3 可复现性是零代码分析的关键指标
科研最怕“这次能出,下次不一样”。知识库明确提到,数据是固定的,分析流程里的代码也应该固定。只有这样,结果才稳定。
WorkBuddy这类工具化流程,核心价值就在于:
- 同一数据得到同一流程。
- 同一配置可以直接复用。
- 团队成员之间容易交接。
- 方便形成标准操作路径。
这对论文写作、基金申报和多中心研究尤其重要。
3. m6A差异分析中,哪些步骤最容易出错
3.1 样本分组顺序错位,会直接影响结果
差异分析里最基础,也最容易被忽略的一步,是表达矩阵列名和分组信息的顺序一致。知识库里也特别强调,列名和行名必须对应。如果不一致,结果就会出错。
在m6A差异分析中,常见错误包括:
- 对照组和处理组顺序反了。
- 样本名拼写不一致。
- 分组表中缺失样本。
- 批次信息未正确纳入。
分组错位不是小问题,它会让后续差异结果失真。
3.2 低质量信号不过滤,结果容易被噪音干扰
m6A相关数据往往存在背景噪音、低表达信号或检测不稳定的问题。知识库中展示了通过检测P值判断信号是否可靠,并过滤不表达或不可靠探针的思路。
这个思路对m6A差异分析同样重要。因为:
- 低质量信号会增加假阳性。
- 噪音会稀释真实差异。
- 不过滤会影响下游富集分析。
先做质量控制,再做差异分析,才更符合科研规范。
3.3 可视化不是装饰,而是验证分析是否合理
差异分析后,常用可视化包括火山图、热图、PCA图等。它们的作用不是“让图好看”,而是检查分析是否合理。
例如:
- PCA能看组间是否分离。
- 热图能看差异模式是否清楚。
- 火山图能快速定位显著变化基因。
如果可视化结果异常,往往提示前面某一步可能出了问题。图不是最后一步的装饰,而是流程验证的一部分。
4. WorkBuddy适合怎样的m6A研究场景
4.1 适合需要快速产出初步结果的课题组
对于课题组来说,m6A差异分析常常需要快速得到候选基因列表,再进入验证阶段。零代码工具特别适合这种场景。
适用情况包括:
- 课题前期筛选靶点。
- 论文补充分析。
- 多组样本差异比较。
- 临床分组初筛。
当你需要的是稳定、快速、可复用的分析流程,零代码比临时拼脚本更高效。
4.2 适合非计算背景研究者独立完成分析
很多临床医生和实验研究者并不排斥分析本身,真正的障碍是编程门槛。WorkBuddy这类工具的意义,就是让研究者不必先成为程序员,也能完成基础分析。
这类用户最在意的是:
- 能不能直接上传数据。
- 能不能自动匹配流程。
- 能不能导出规范结果。
- 能不能减少对他人依赖。
零代码不是降低标准,而是降低操作门槛。
4.3 适合需要团队协作和流程留痕的项目
临床研究和转化医学项目往往多人协作。一个人写脚本,别人接手时很容易出现理解偏差。标准化工具则更容易记录参数、保存配置和复用流程。
这对团队的价值很明确:
- 方便交接。
- 方便审稿回复。
- 方便复核结果。
- 方便后续扩展到其他组学分析。
流程留痕越清楚,科研越容易规范化。
5. 从差异分析到可复现研究,WorkBuddy的真正价值
5.1 把“会做分析”升级为“能稳定交付结果”
科研不是一次性演示,而是长期积累。m6A差异分析如果每次都重新摸索,效率会很低。更现实的路径,是把成熟流程固定下来,让分析变成可交付的标准模块。
这也是知识库里提到的核心趋势。未来工具会越来越像“操作系统”,把常见分析封装成可调用模块。对于研究者来说,最重要的不是每次从零开始,而是站在稳定流程上做判断。
5.2 对m6A研究,标准化工具能减少人为偏差
人为偏差常常来自:
- 手工整理数据时的疏漏。
- 统计方法选择不一致。
- 参数设置不统一。
- 不同人重复分析结果不同。
WorkBuddy这类工具的价值,就是把这些容易出错的环节前置标准化。 这样,研究者更容易把精力集中在生物学解释、机制验证和临床意义上。
5.3 与其反复调试,不如用可验证的流程推进研究
知识库提到,代码是可验证的,但前提是你能审核。对不熟悉代码的人,最稳妥的方式就是使用固定工具和标准流程。这样既减少试错,也降低沟通成本。
如果你正在做m6A差异分析,真正高效的做法不是反复写脚本,而是选择成熟、可复用、可追踪的工具链。这正是WorkBuddy能帮助科研团队提升效率的地方。
总结Conclusion
m6A差异分析的关键,不只是得到差异基因,更是保证流程正确、结果稳定、结论可复现。对于医学生、医生和科研人员来说,零代码并不是妥协,而是把复杂流程交给标准化工具,把精力留给科学问题本身。
如果你希望把m6A差异分析做得更快、更稳、更可复现,可以关注解螺旋提供的科研工具与方法支持。 借助WorkBuddy这类零代码思路,研究者能够更高效地完成差异分析,并把时间真正用在机制验证和论文产出上。

- 引言Introduction
- 1. 为什么m6A差异分析更需要标准化流程
- 2. WorkBuddy如何把m6A差异分析变成零代码流程
- 3. m6A差异分析中,哪些步骤最容易出错
- 4. WorkBuddy适合怎样的m6A研究场景
- 5. 从差异分析到可复现研究,WorkBuddy的真正价值
- 总结Conclusion