22
 分享
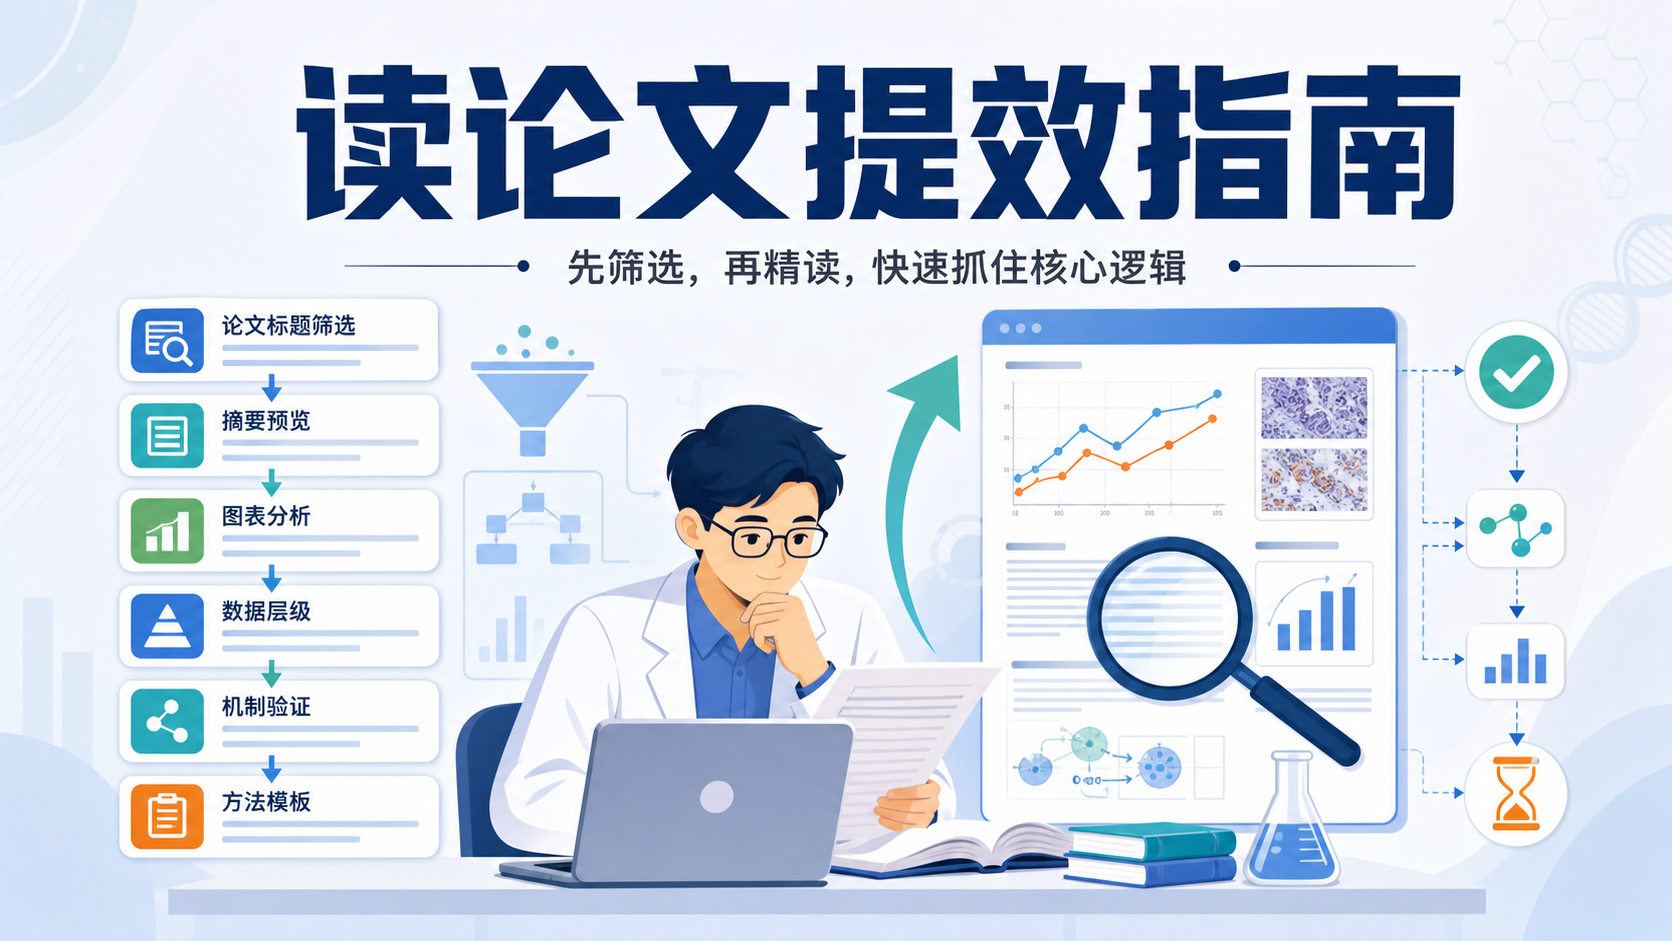
引言Introduction
生物医学文献数量增长太快,医学生、医生和科研人员常常卡在“看不完,也筛不准”。真正的问题不是文献少,而是不会在短时间内判断哪些值得精读,哪些可以跳过 。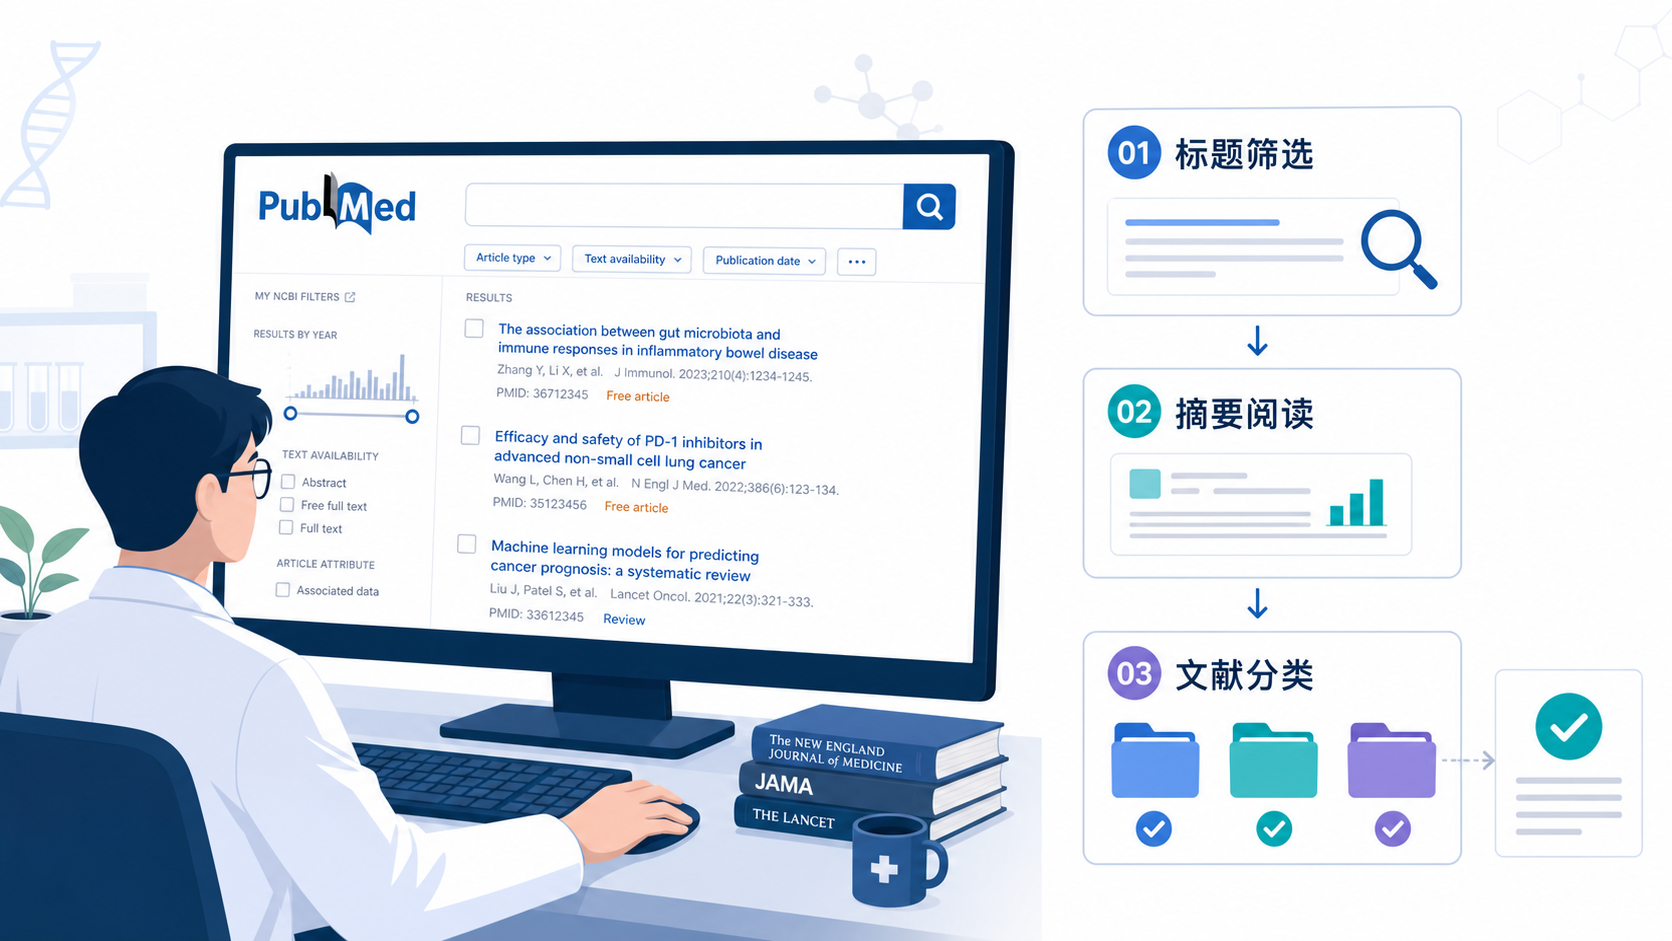
1. 先筛选,再精读,效率才会高
1.1 先看标题,判断相关性
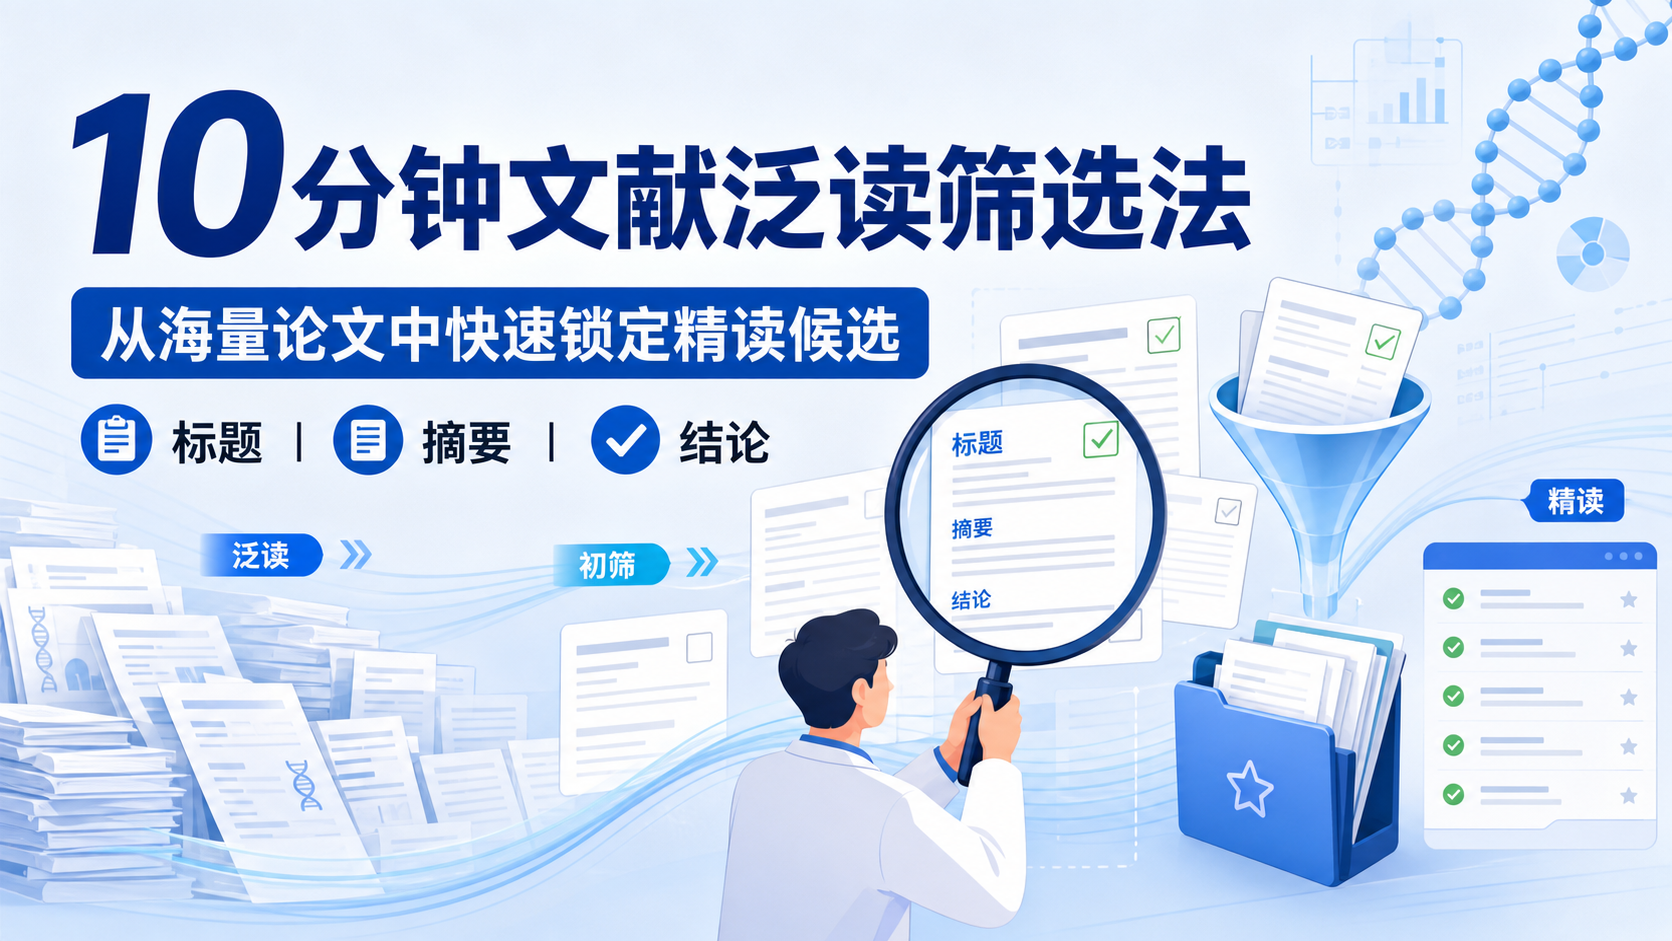
文献筛选的第一步,不是直接下载全文,而是先看标题。标题通常已经告诉你三个核心信息,疾病对象、研究因素和大致机制。如果这三点和你的课题差距很大,这篇文章大概率不值得继续看。
对医学生和临床研究者来说,筛选标准要尽量贴近自己的问题。比如你做肝癌机制研究,就优先找同样是肝癌、同类分子、同类实验路径的文章。不是所有高分文章都适合拿来做模板。适合自己的文章,往往比高影响因子但研究路径完全不同的文章更有价值。
1.2 摘要决定是否进入全文
标题通过后,再看摘要。摘要的作用不是替代全文,而是帮助你快速判断研究设计是否成立,结果是否支持作者结论。通常可以重点看以下几项。
- 研究对象是否匹配。
- 主要变量是否明确。
- 结论是否和数据对应。
- 是否有你能借鉴的实验设计。
如果摘要里已经看不出和自己课题的关联,全文通常也没有必要精读。 对写综述、做标书、搭建实验框架的人来说,摘要足够回答80%的“值不值得读”问题。
1.3 10分钟内完成第一轮筛选
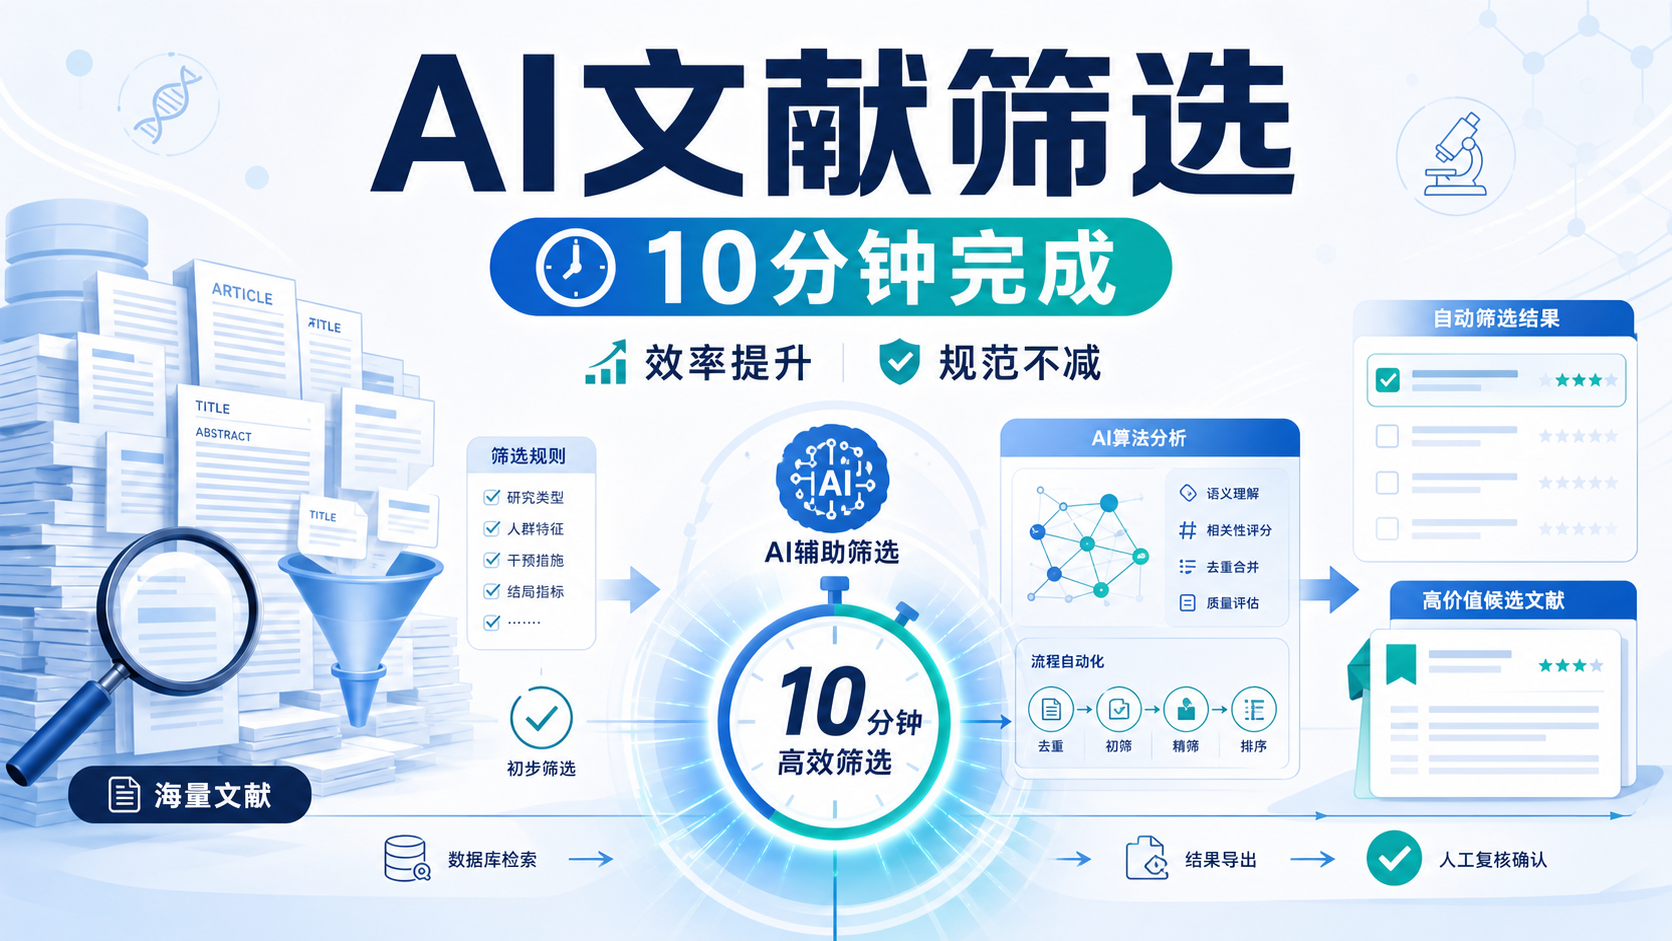
高效筛选的目标,不是逐篇读懂,而是在有限时间内快速压缩候选集。一个实用方法是,在10分钟内完成一批文献的初筛,保留7到8篇最可能值得精读的文章。其余文献先放入待查库。
建议按这个顺序执行。
- 先扫标题。
- 再看摘要。
- 最后看图表目录或结果小标题。
- 只保留与课题高度一致的文献。
这一步的本质,是把“文献信息快速抓取”变成一个标准流程,而不是凭感觉乱翻。
2. 精读的核心,是看懂论证链
2.1 先抓住文章的主线
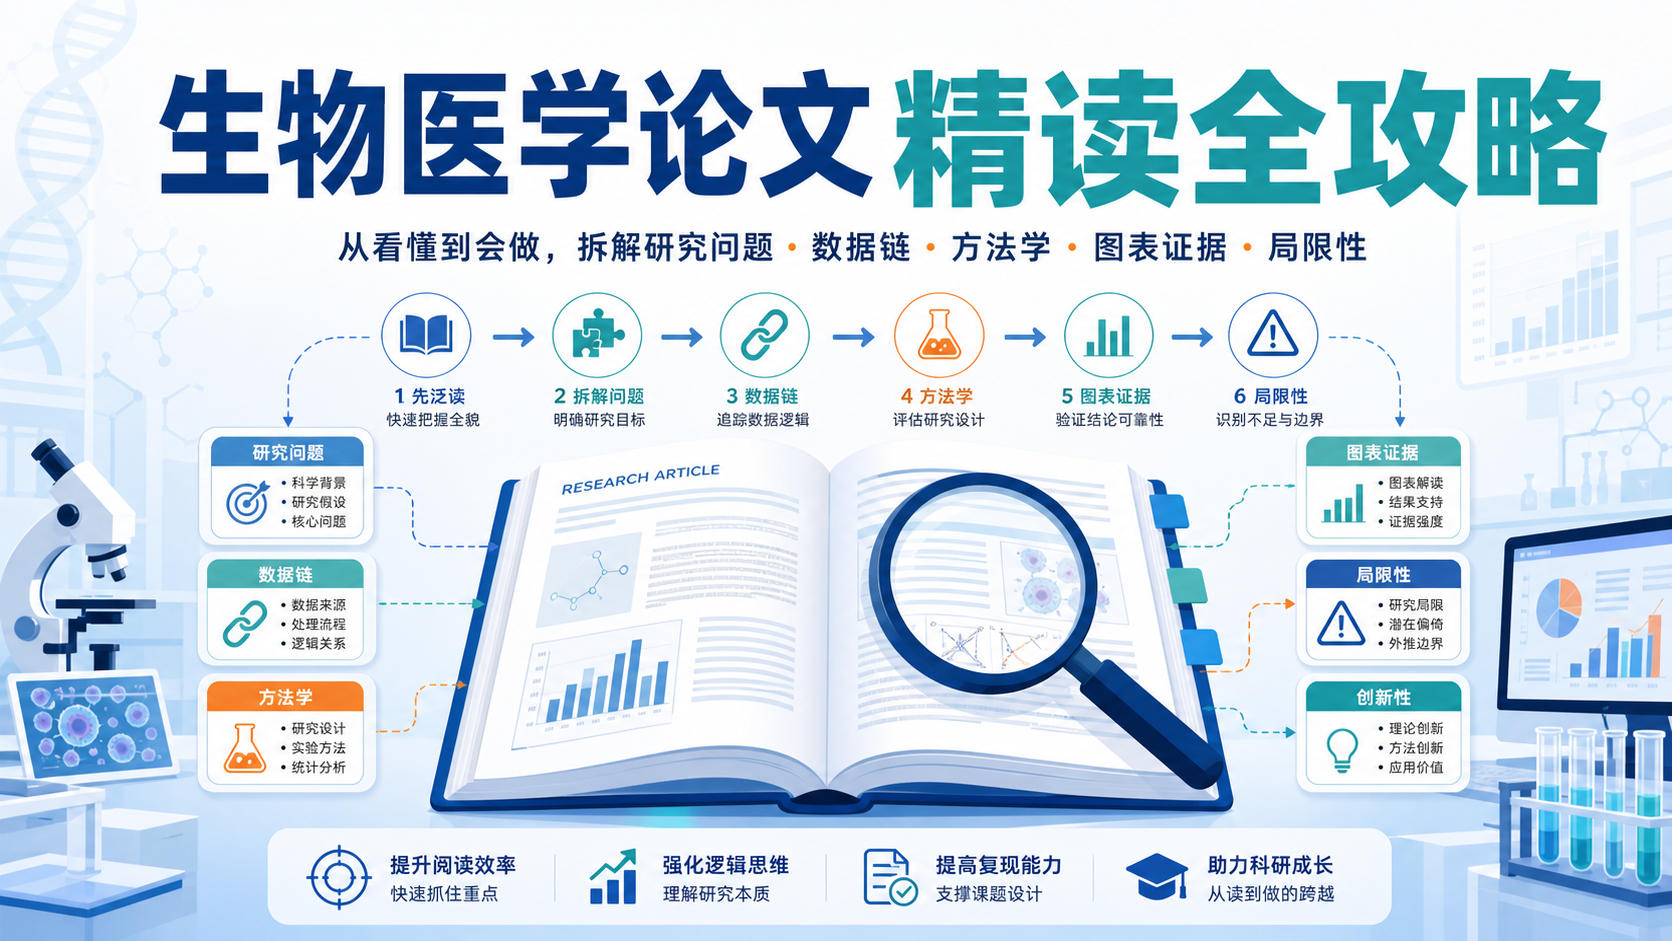
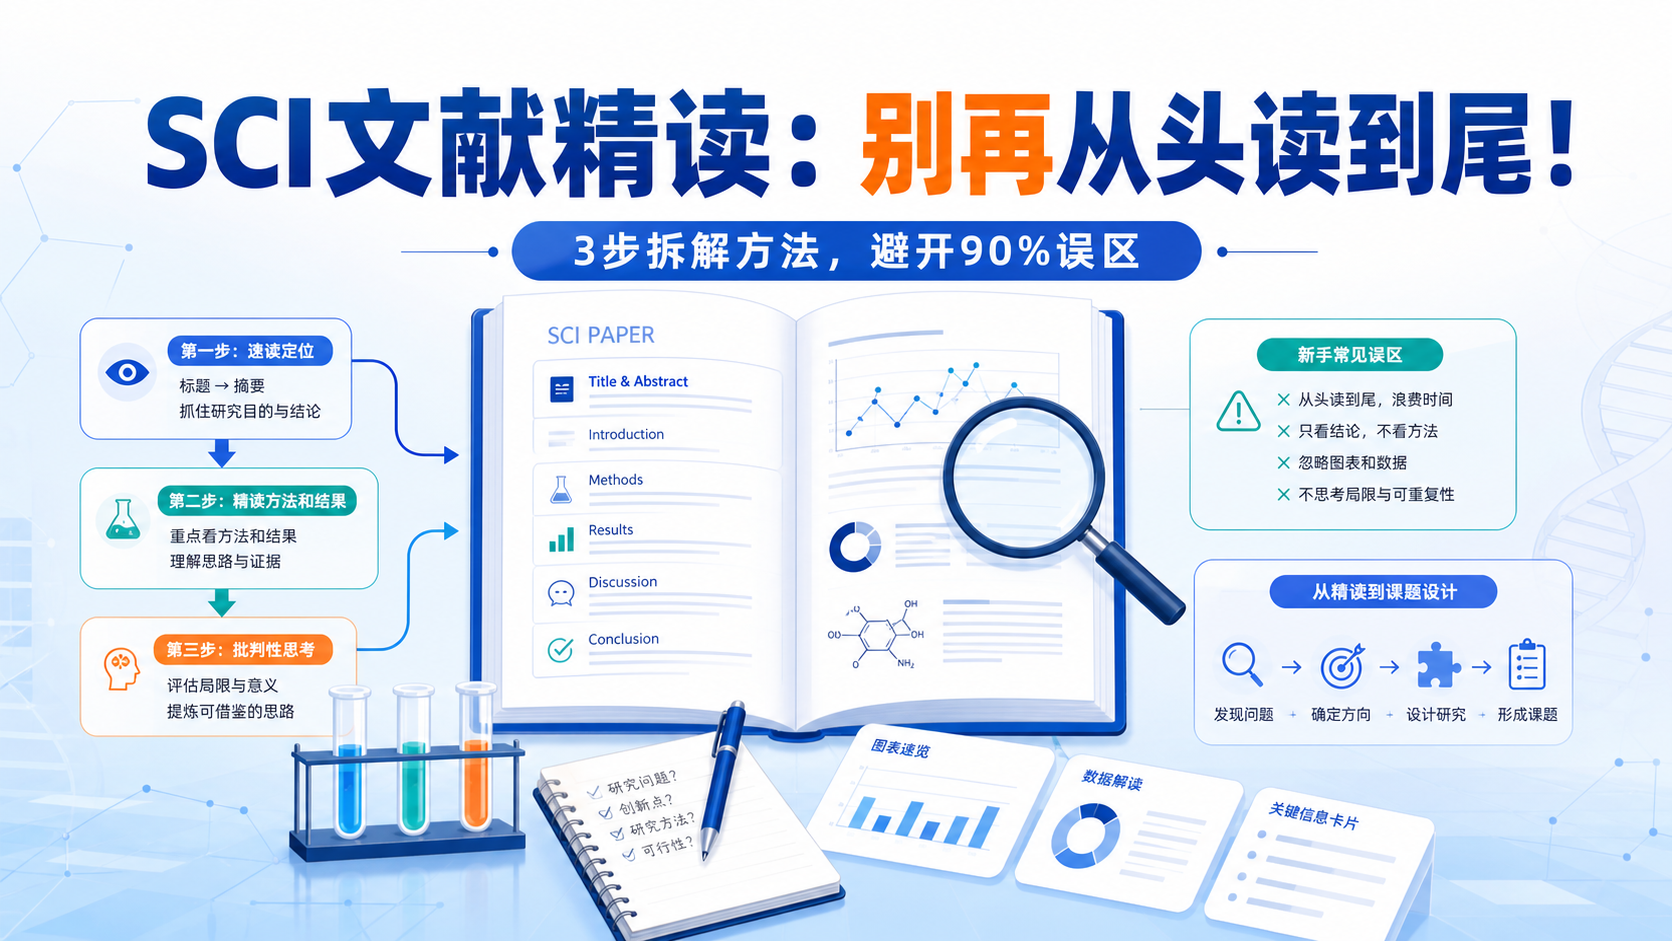
精读不是逐句翻译,也不是把每个单词都搞懂。真正重要的是,读完后能复述作者是怎么证明结论的。也就是说,你要抓住论文的论证链。一个合格的科研读者,应该能回答这三个问题。
- 作者观察到了什么现象。
- 作者用了什么证据证明。
- 这个证据是否足以支撑结论。
如果你读完文章,只记住了几个名词和几个图号,却说不出逻辑关系,就还没有真正进入精读。
2.2 因果逻辑比现象罗列更重要
生物医学论文的质量,很大程度上取决于因果逻辑是否闭合。低水平文章常常只是描述表型变化,高质量文章则会进一步证明变量之间的因果关系。常见的强化方式包括:
- 同一现象用多种模型重复验证。
- 同一结论用不同检测方法交叉支持。
- 同一分子在多个层面上被证明相关。
如果一篇文章只停留在“相关性”,没有进一步验证“是否存在因果关系”,它的证据等级通常有限。 这也是审稿人最常追问的问题之一。
2.3 审稿人思维能帮你发现漏洞
精读时要主动寻找“作者没说清楚的地方”。比如数据是否缺了对照组,结论是否跳得太快,机制链条中间是否少了关键一步。很多论文图看起来很多,但真正能支撑结论的证据并不充分。
你可以重点检查以下内容。
- 是否存在关键对照缺失。
- 结果之间是否能形成闭环。
- 机制实验是否真正完成了因果验证。
- 结论是否超出了数据本身。
站在审稿人的角度读文章,才能判断一篇论文到底强在哪里,弱在哪里。
3. 图表阅读,是高效精读的入口
3.1 先读图,再读正文
对于生物医学论文,图表往往比正文更能快速说明问题。很多时候,结果部分本质上是在解释图。对大多数文章来说,先看图,再回头看文字,会比从头顺读更高效。
推荐的顺序是。
- 看图题和图例。
- 判断图中展示了什么变量。
- 看分组是否合理。
- 再回到正文确认作者解释是否成立。
如果一篇文章的图已经能清晰传达结果,正文只是补充说明。反过来,如果图本身就看不懂,说明这篇文章需要更谨慎地处理。
3.2 重点看数据是否“讲得通”
图表阅读不是只看显著性星号,而是看数据是否符合逻辑。比如组间差异是否合理,趋势是否一致,结论是否被多个实验共同支持。特别是在Western blot、qPCR、免疫组化和功能实验中,图像和统计往往要一起看。
可优先检查以下几点。
- 分组是否完整。
- 结果方向是否一致。
- 统计方法是否匹配数据类型。
- 图像和定量结果是否相互支持。
图和数据不一致,是最常见的阅读警报信号。
3.3 难懂的图,先不要硬啃
不是所有图都值得在第一轮死磕。对于高通量数据、复杂共定位图、单细胞图谱或多组学分析,初学者可以先抓住结论,不必陷在每一个细节里。只要这部分不是你课题的核心证据,就可以先跳过,等需要时再回看。
这也是高效阅读的关键。先确保主线清楚,再处理细节。 否则很容易在非核心信息上消耗大量时间。
4. 按数据层级分层阅读,避免时间浪费
4.1 组织、细胞、动物,层级不同,证据强度不同
生物医学研究中,不同数据来源的意义不同。组织样本更接近临床真实状态,但容易受到混杂因素影响。细胞实验更适合验证机制。动物实验则常用于增强体内证据和提高可信度。
一般可这样理解。
- 组织水平,适合描述临床相关性。
- 细胞水平,适合做机制因果验证。
- 动物水平,适合验证整体效应和体内可重复性。
如果一篇文章只有组织相关性,没有细胞或动物层面的验证,它对机制解释的支撑通常不够完整。
4.2 机制研究要区分“间接”和“直接”
机制文章常见两类证据。第一类是间接机制,证明A变化后,B也变化。第二类是直接机制,证明A和B之间存在更明确的调控关系。阅读时要分清这两者,不要把相关性误读成直接作用。
建议重点关注以下问题。
- 作者是否做了救援实验。
- 是否验证了上游和下游关系。
- 是否有明确的干预和反向验证。
- 结论是否只是推测,还是被实验支持。
机制研究的价值,不在于图多,而在于因果链条是否严密。
4.3 生信部分只抓结论,不必过度停留
高通量和生物信息学分析常常信息量大,但并不一定都需要细读。若文章的核心贡献不在算法或队列分析,可以先抓住它的作用:它是在发现候选分子,还是在辅助验证结论。对于大多数实验型论文来说,生信部分更多是前置筛选工具,而不是最终答案。
阅读时可以只关注。
- 数据来源是否可信。
- 分析目标是否明确。
- 结果是否为后续实验提供方向。
不要让复杂的生信图,把你的阅读节奏拖垮。
5. 读懂一篇文章,最终要回到可复用的方法
5.1 把文章拆成模板
真正高效的精读,不是只记住内容,而是把文章拆成可复用模板。你需要提炼的是:它怎么提问题,怎么做分组,怎么安排图,怎么完成验证。对于准备发文章、做课题或写标书的人来说,这些比记住一句结论更重要。
可以记录成四项。
- 研究问题。
- 关键分组。
- 核心实验。
- 论证路径。
一篇值得精读的文献,应该能为你提供实验设计和文章结构的双重参考。
5.2 Rescue实验是机制论文的关键节点
如果你的研究涉及通路调控,救援实验往往是判断逻辑是否成立的重要证据。标准设计通常需要包括基础组、干预组、联合干预组和反向验证组。它的作用,是证明某个分子变化是否真的参与了表型改变。
读文章时要特别注意:
- 作者是否做了四组以上的关键验证。
- 干预后是否能恢复表型。
- 结论是否建立在反向验证基础上。
没有救援实验,很多机制链条只能算“提示”,还不能算“证明”。
5.3 用解螺旋提升筛选与精读效率
很多研究者卡在同一个问题上,检索结果很多,但真正能用的文献太少。解决办法不是多看几篇,而是建立一套稳定的筛选和精读框架。你需要的是更快抓住研究主线,更准确判断证据强度,更高效锁定模板文献。
如果你希望系统提升文献信息快速抓取 能力,并把筛选、精读、模板提炼变成可执行流程,解螺旋 可以帮助你把文献阅读从“耗时试错”变成“有标准的高效输入”。对医学生、医生和科研人员来说,这会直接影响课题推进速度和写作效率。
总结Conclusion
生物医学文献快速筛选与精读,核心不是读得更多,而是读得更准。先看标题和摘要完成初筛,再用图表和论证链判断是否值得精读,最后提炼出可复用的实验与写作模板。抓住因果逻辑,理解图表证据,才能真正提高文献阅读效率。
如果你想进一步提升筛选速度、减少无效阅读,并建立适合自己的文献阅读流程,可以关注解螺旋 ,把文献阅读能力真正转化为科研产出能力。

- 引言Introduction
- 1. 先筛选,再精读,效率才会高
- 2. 精读的核心,是看懂论证链
- 3. 图表阅读,是高效精读的入口
- 4. 按数据层级分层阅读,避免时间浪费
- 5. 读懂一篇文章,最终要回到可复用的方法
- 总结Conclusion