13
 分享
引言Introduction
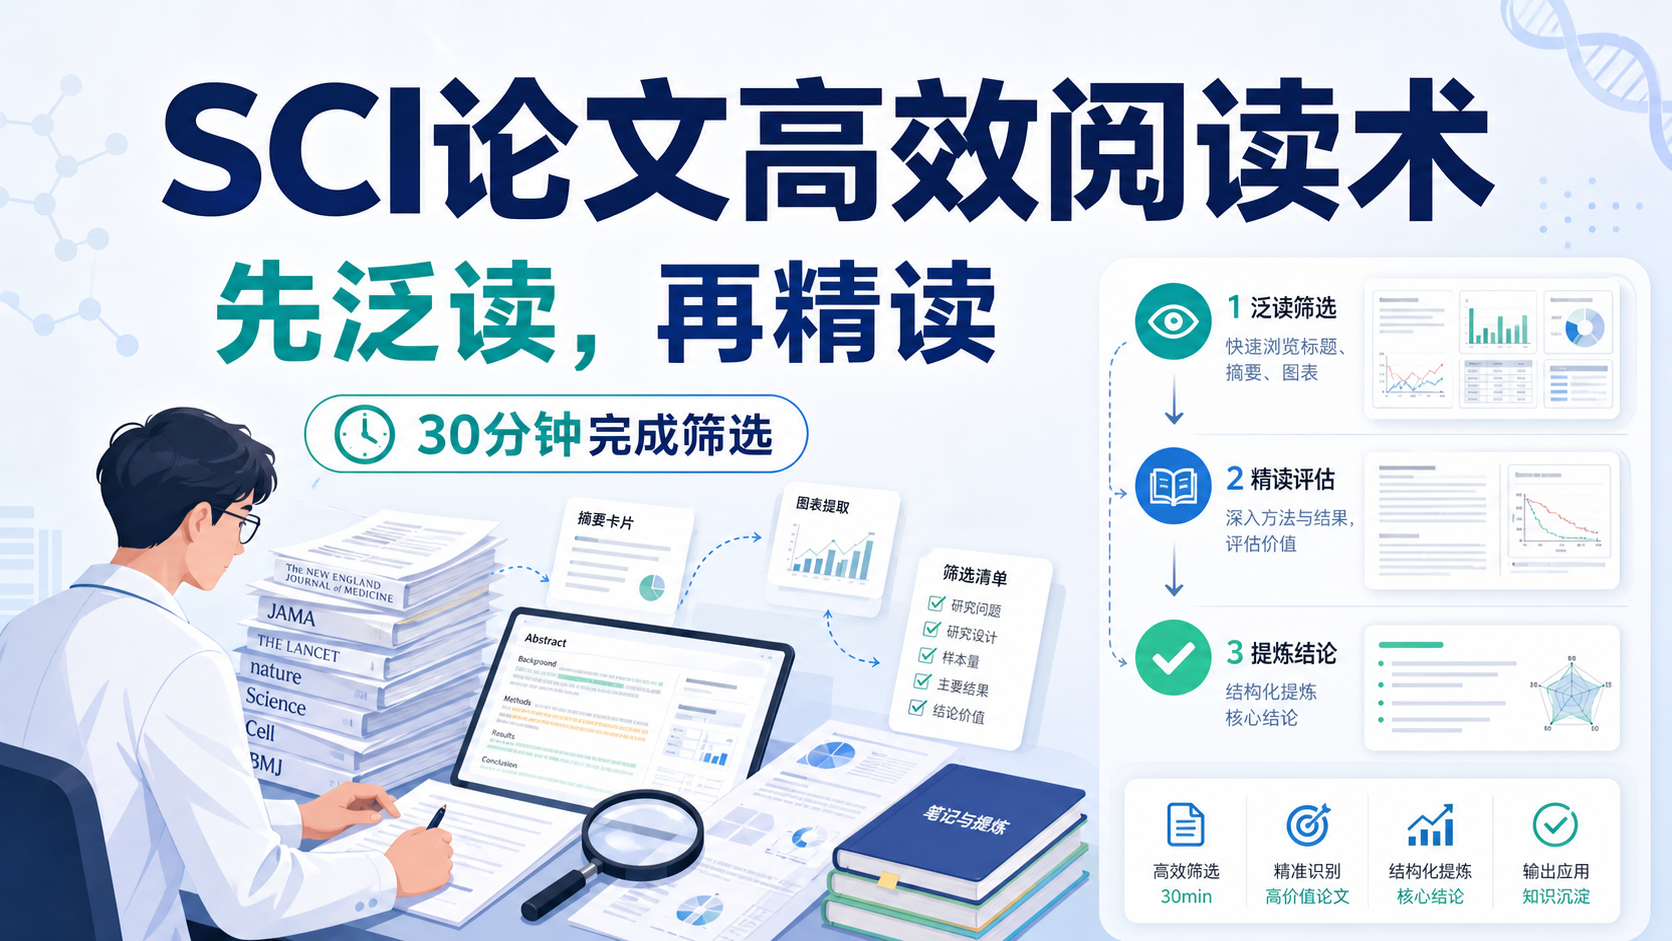
很多人读SCI论文慢,不是因为不努力,而是方法错了。逐字硬看,常常1小时只换来模糊印象。真正高效的做法,是先泛读筛选,再精读深挖。把“读完”变成“读懂”,你才能把时间用在真正值得精读的文章上。
1. 为什么SCI论文不能逐字硬读
1.1 读得多,不等于读得对
很多医学生和科研人员都有相同困扰。文献堆积很快,时间却很少。若每篇都从头读到尾,效率会迅速下降。真正的痛点,不是不会读,而是不知道哪些内容值得读。
SCI论文本身有固定结构。标题、摘要、引言、方法、结果、讨论,信息密度并不均匀。对大多数课题来说,参考文献和部分方法细节并不是第一优先级。把时间平均分配到每一段,往往是浪费。
1.2 无效阅读最消耗精力
无效阅读通常有3种表现。
- 先翻译,再理解。
- 从第一句读到最后一句,不判断价值。
- 读完后说不清研究问题、设计和结论。
一篇文献如果和你的课题无关,哪怕读完也没有产出。 从科研训练角度看,这种阅读只是在“消耗注意力”,并不会形成可复用的知识框架。
1.3 先建立筛选标准,才能提速
高效阅读的前提不是“快”,而是“会筛”。你必须先明确,什么样的文章值得精读。一般至少看4个维度。
- 研究问题是否相关。
- 研究设计是否可借鉴。
- 样本量和证据强度是否足够。
- 结论是否能反哺自己的课题。
如果这4点里有2点以上不匹配,就应该停在泛读阶段。
2. SCI高效阅读技巧的核心:先泛读,再精读
2.1 泛读的目标,是快速判断“值不值得看”
泛读不是偷懒,而是专业判断。它的目标很明确。在最短时间内筛掉无关文献,留下值得精读的候选文章。
对于一个成熟课题,常常会检索到十几篇甚至几十篇相关论文。如果每篇都精读,时间一定不够。
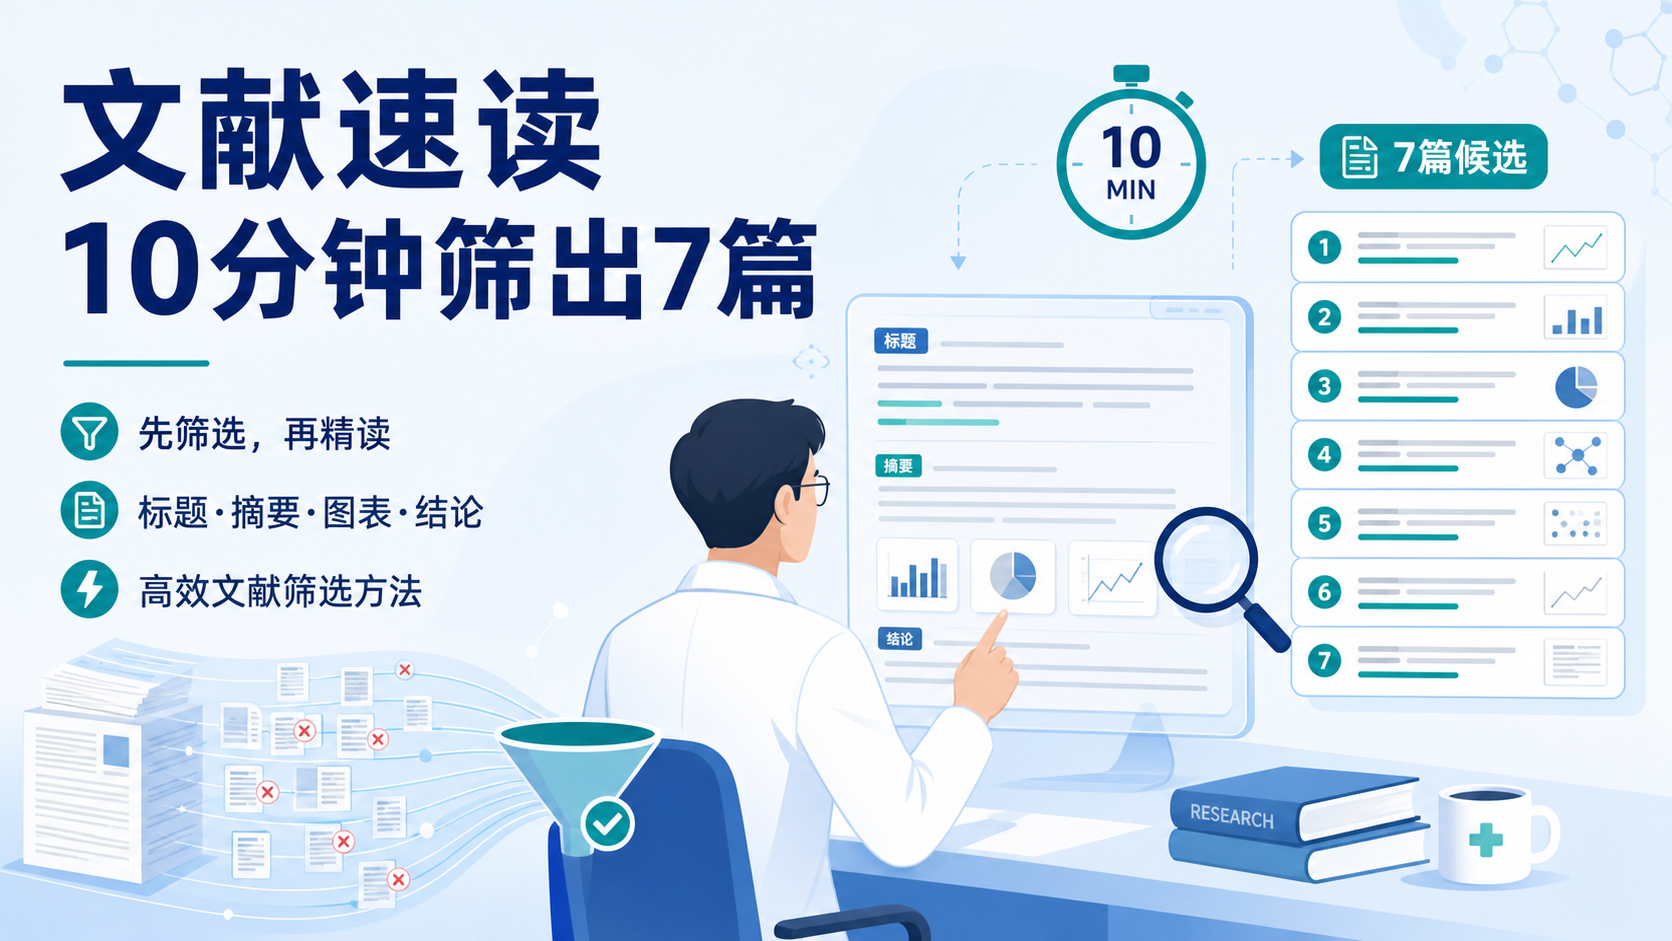
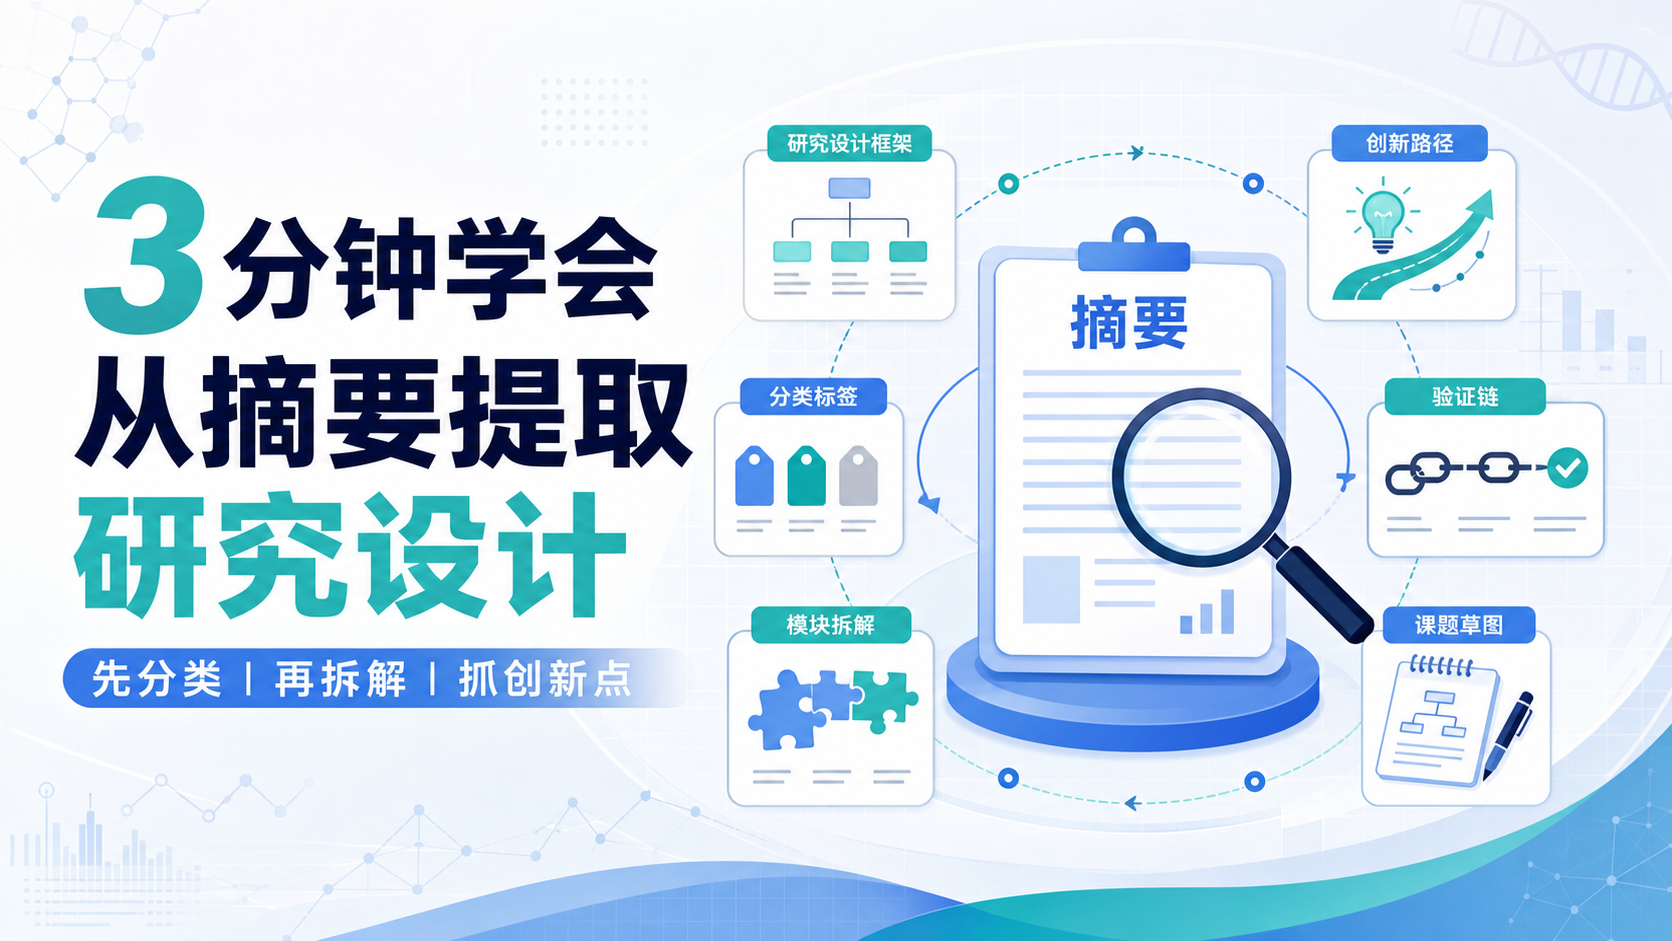
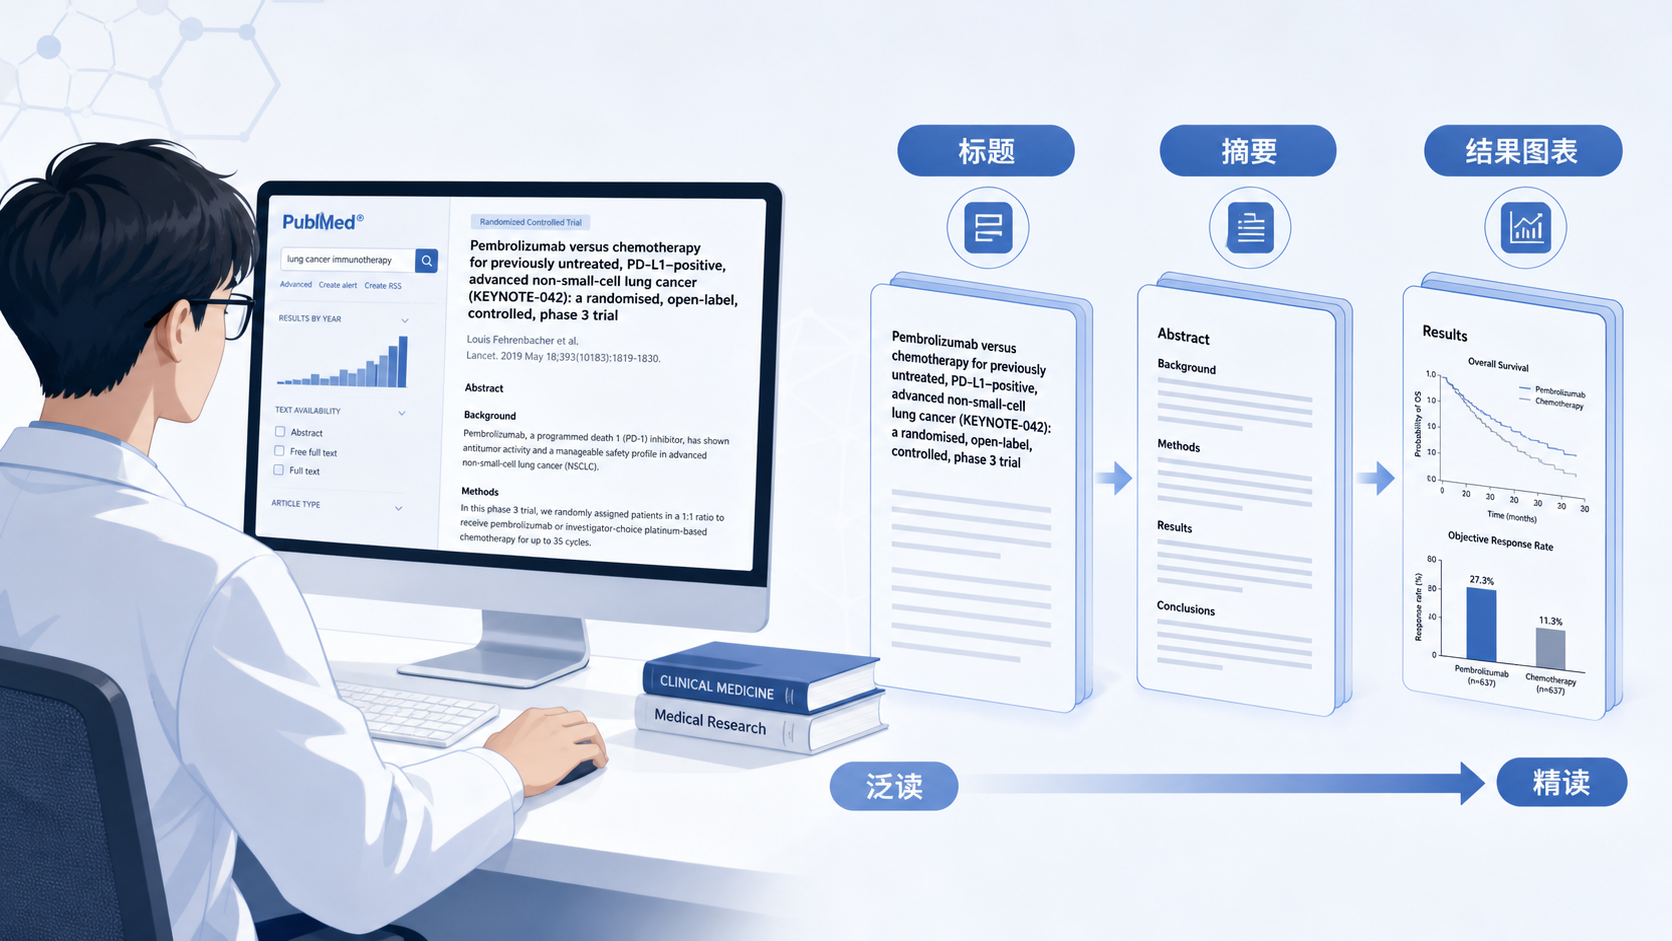
更合理的方式是,先用标题和摘要完成第一轮筛选。标题能告诉你研究方向,摘要能告诉你研究对象、方法框架和主要结论。只要和你的问题偏差较大,就不必继续下探。
2.2 精读的目标,是拆解可复用的论文逻辑
精读不是“全篇细抠”,而是围绕核心信息展开。真正值得精读的文献,通常要看清4件事。
- 作者要解决什么问题。
- 研究是怎么设计的。
- 数据支持了什么结论。
- 文章还留下了什么可深挖点。
读懂一篇SCI论文,标准不是认识每个单词,而是合上文章后,能复述出它的论证链条。 这才说明你抓住了核心。
2.3 泛读和精读的分工要明确
泛读解决“选谁”。精读解决“学什么”。
很多人效率低,就是因为把两件事混在一起。看到一篇文章就想逐句翻译,结果几个小时过去,连这篇文章值不值得学都没判断出来。
更推荐的顺序是。
- 第一步,读标题。
- 第二步,看摘要。
- 第三步,扫图表和结论。
- 第四步,再决定是否精读正文。
这样做,通常可以把大量低价值阅读提前拦截掉。
3. 结构化提炼核心结论的方法
3.1 用统一模板做信息抽取
结构化提炼的关键,是每篇文章都按同一套问题去抓信息。不要凭感觉读。建议固定成5个问题。
- 研究对象是什么。
- 核心变量是什么。
- 采用了什么设计。
- 主要结果是什么。
- 作者最重要的结论是什么。
这套模板适合临床、基础和转化研究。它的价值在于把分散信息变成可比较、可复用的知识卡片。
3.2 先看图表,再读正文
对SCI论文来说,图表往往比大段文字更能说明问题。尤其是结果部分,图1、图2、表1通常已经揭示了文章主线。
你可以先看图题、图注和坐标轴,再回到正文确认逻辑。这样能快速判断。
- 文章有没有完整闭环。
- 结果是否支持结论。
- 是否存在过度解读。
很多论文的真正质量,一眼看图就能看出大半。
3.3 把“段落阅读”改成“问题阅读”
传统阅读习惯是按段落走。高效阅读习惯是按问题走。
比如你关心的是某个信号通路在疾病中的作用,就不要沉迷于背景铺垫,而应直接锁定。
- 病例或模型是否成立。
- 通路是否被激活。
- 干预后是否逆转。
- 统计学是否支持因果推断。
这种阅读方式更接近科研思维。你不是在背文章,而是在验证作者的论证是否成立。
4. 30分钟内完成筛选的实操步骤
4.1 第一轮,标题筛选
先看标题。标题应该能让你判断研究主题、变量和方向。若标题和你的课题差异太大,直接跳过。
这一轮不要犹豫。目标不是理解全文,而是减少后续负担。
4.2 第二轮,摘要筛选
摘要要重点看3个部分。
- 研究目的。
- 方法和样本。
- 主要结论。
如果摘要里看不到清晰的研究设计,或者结论与题目不匹配,这篇文章的借鉴价值通常有限。摘要能否在1分钟内看出重点,是判断文章是否进入精读池的重要标准。
4.3 第三轮,图表筛选
保留最核心的图和表。常见顺序是。
- 先看结果图。
- 再看统计图。
- 最后看补充实验。
你需要重点判断。
- 数据是否足够支撑结论。
- 逻辑链是否完整。
- 结果有没有明显断点。
如果图表已经显示出研究主线,正文就只是补充解释。这一步能极大提高阅读效率。
4.4 第四轮,决定精读价值
最后只保留真正值得精读的文章。一般每轮筛选后,留下7到8篇候选文献已经足够。接下来再深入拆解这些文献的实验设计、数据组织和写作框架。
对于准备开题、写标书、做论文的读者来说,这一步最关键。不是读得越多越好,而是留下最像你课题的模板文献。
5. 让阅读结果真正服务科研产出
5.1 从阅读中提炼写作素材
泛读和精读的最终目的,不是“知道得更多”,而是“能写出来”。
你需要把文献中的信息转化为自己的知识资产。比如。
- Introduction里的背景链条。
- Discussion里的机制推演。
- Results里的图表组织方式。
一旦你能把这些内容结构化存档,后续写论文和标书会明显提速。
5.2 读文献要站在审稿视角
真正成熟的阅读,不只是理解作者写了什么,还要判断作者没写什么。
你要问自己。
- 证据够不够。
- 对照是否合理。
- 结论有没有夸大。
- 还有哪些实验能补强。
这种视角能提升科研判断力。也能帮助你在自己的课题设计中提前规避漏洞。
5.3 借助工具,把效率再往前推一步
如果你需要更快地完成文献筛选、信息提炼和笔记整理,可以借助专业工具提升效率。比如解螺旋提供的科研学习与文献辅助方案,适合需要快速筛选候选文献、沉淀结构化笔记的医学学习者。它的价值,不只是帮你省时间,更是帮你把泛读和精读流程标准化。
总结Conclusion
SCI论文阅读的关键,不是硬啃全文,而是学会结构化筛选。先用泛读快速判断文章价值,再对高相关文献进行精读拆解。这样才能把有限时间投入到真正有用的研究上,把阅读效率提升到一个新的层级。
如果你也想减少无效阅读,建立更稳定的文献筛选和提炼流程,可以进一步了解解螺旋。它能帮助你把“读不完、读不快、读不透”的问题,转化为更高效的科研阅读能力。

- 引言Introduction
- 1. 为什么SCI论文不能逐字硬读
- 2. SCI高效阅读技巧的核心:先泛读,再精读
- 3. 结构化提炼核心结论的方法
- 4. 30分钟内完成筛选的实操步骤
- 5. 让阅读结果真正服务科研产出
- 总结Conclusion