17
 分享
引言Introduction
qPCR引物设计看似简单,真正上手却很容易卡在转录本选择、CDS定位、特异性验证和二级结构排查。只要一步出错,后面的Ct值、熔解曲线和重复性都会受影响。 对于要高频出结果的实验室,自动化设计流程不只是提效,更是降低返工率的关键。
1. 为什么qPCR引物设计适合自动化
1.1 手工设计最常见的3个痛点
qPCR引物设计的第一步,不是直接进软件,而是先找到合适的模板序列。常见问题主要有三类。
- 转录本选错。 同一基因常有多个转录本,若不先确认目标剪接体,后面引物即使“能扩增”,也可能扩到错误区域。
- 参数不统一。 不同人设置的引物长度、Tm、GC含量阈值不一致,导致同一课题组的结果难以复现。
- 验证步骤被省略。 只看软件打分,不查3’端二聚体、发夹结构和扩增片段长度,容易埋下失败隐患。
对医学生、医生和科研人员来说,真正耗时的不是“点按钮”,而是反复切换数据库、复制序列、比对转录本和核对参数。自动化的价值在于把这些重复劳动固定成流程。
1.2 自动化流程应遵循的基本原则
一个可靠的自动化qPCR引物设计流程,至少要保留以下检查点。
- 先确认目标基因和物种。
- 锁定正确转录本,优先看CDS区域。
- 控制扩增片段长度,常用80到300 bp。
- 检查引物长度、Tm值和GC含量。
- 排查二聚体、发夹和3’端错配风险。
这不是“让软件替你做决定”,而是让软件替你完成标准化筛查。 这样得到的候选引物更容易进入实验验证阶段。
2. 从NCBI获取目标序列
2.1 先找对基因,再谈引物设计
引物设计的起点是模板序列。以NCBI为例,推荐从Gene数据库进入,而不是直接随机搜索核酸条目。
操作逻辑如下。
- 在NCBI首页搜索框中选择Gene。
- 输入目标基因名称。
- 进入对应基因页面后,确认物种是否正确。
- 在Related information中找到RefSeq RNAs。
- 优先保存目标转录本的CDS序列。
以ATG7为例,若目标是小鼠样本,就不能直接套用人源序列。物种错误会直接导致引物失效。
2.2 为什么优先看CDS区域
真核mRNA包含5’UTR、CDS和3’UTR。对于常规qPCR,CDS区域通常更稳定,也更适合作为多数表达定量实验的设计起点。
原因很直接。
- CDS区域更利于跨样本一致扩增。
- 避免过长UTR带来的结构复杂性。
- 对多数表达分析而言,CDS足以反映转录水平变化。
如果研究目标是特定剪接体,则需要先比对多个转录本,选择保守区域或特异区域。这一步决定了你测到的是“总表达”还是“特定异构体表达”。
3. 在WorkBuddy中建立qPCR引物设计流程
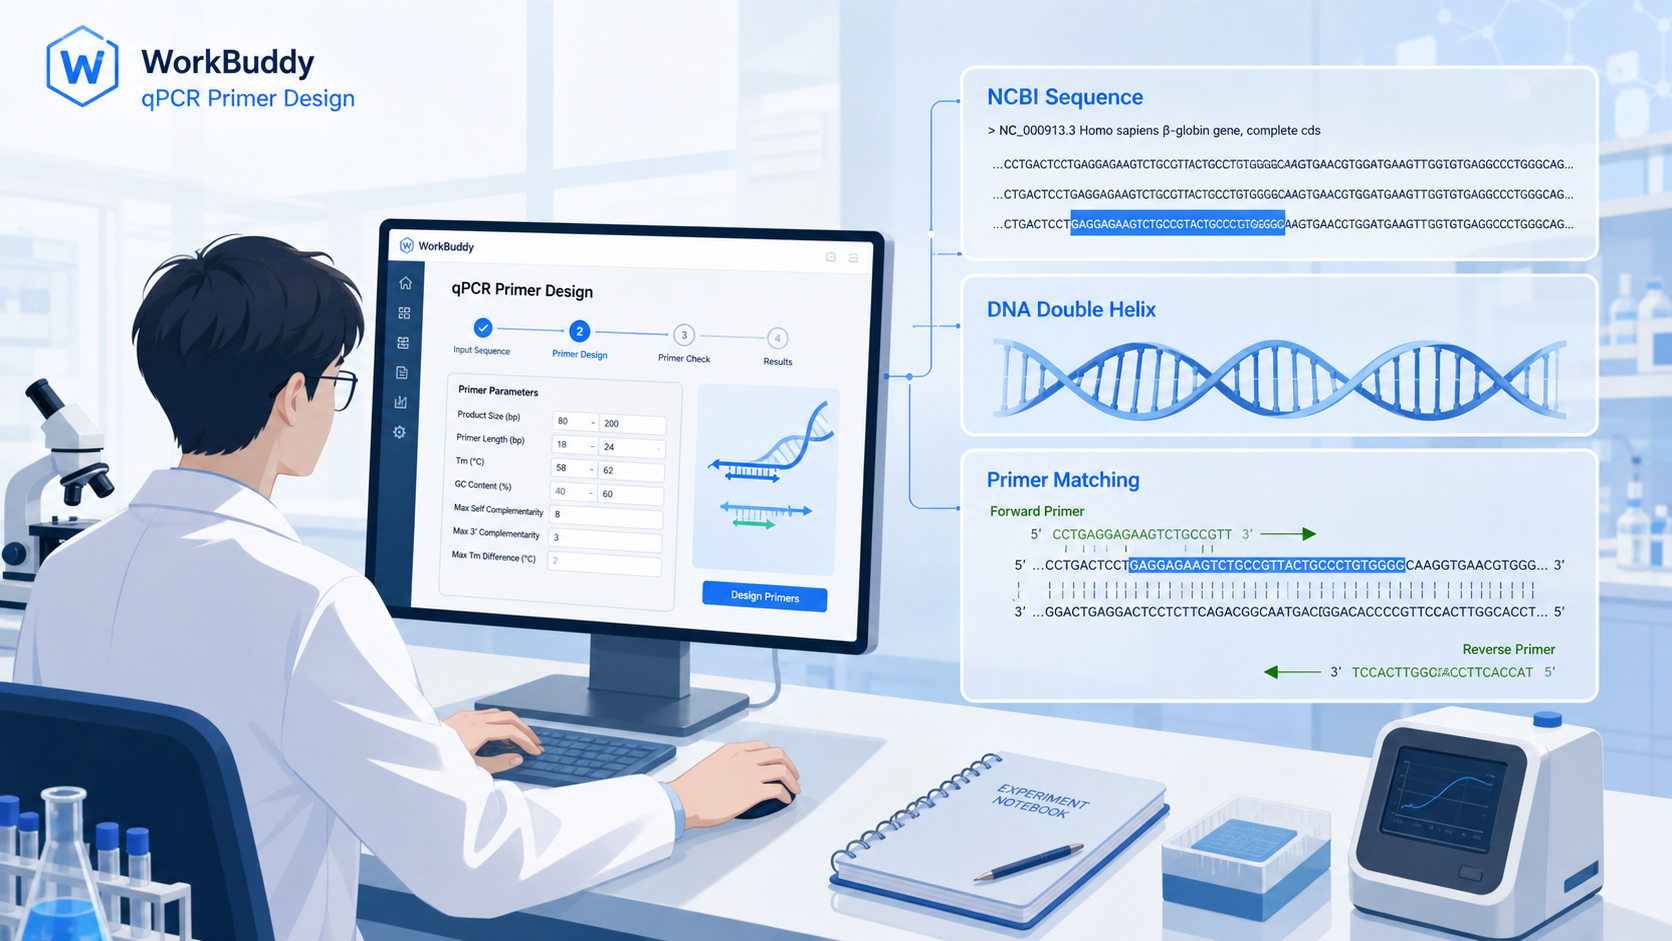
3.1 导入模板序列并启动搜索
在WorkBuddy中,建议把qPCR引物设计拆成可复用的标准步骤,而不是每次重新手工配置。
可执行的基本流程是:
- 将目标cDNA或CDS序列复制到模板区。
- 调用引物搜索模块。
- 设定正负链与兼容配对模式。
- 输入PCR产物长度范围。
- 设置基础参数后开始搜索。
如果实验室经常做同一批基因,WorkBuddy的价值在于把“模板输入—参数检查—候选筛选”变成标准化工作流。 这比每次人工点选更适合批量项目。
3.2 参数设置要点
qPCR引物设计不能只看“能不能出一对引物”,更要看参数是否符合实验逻辑。常用设置包括:
- 引物长度一般控制在18到30个碱基。
- GC含量建议在40%到60%。
- 扩增片段长度通常为80到300 bp。
- 退火温度要与整套体系匹配,避免过高或过低。
对于SYBR Green体系,扩增片段太长会影响效率,太短又可能增加非特异性风险。80到150 bp通常更常用于表达定量。 如果是探针法,片段设计还要兼顾探针位置和荧光淬灭需求。
4. 候选引物的核心质控指标
4.1 先看软件分数,再看生物学合理性
WorkBuddy或其他设计工具给出的候选引物,通常会按综合得分排序。但排序高不代表一定可用。你仍然要逐项核对。
重点看这几项。
- 长度是否合适。
- Tm是否接近。
- GC是否在合理范围内。
- 3’端是否存在明显互补。
- 是否容易形成发夹或二聚体。
对qPCR来说,3’端问题尤其重要。 因为DNA聚合酶从3’端延伸,一旦3’端互补过强,假扩增的概率会上升。
4.2 重点排查二聚体和发夹结构
引物二级结构是qPCR失败的常见原因之一。你需要特别关注两类风险。
- 引物二聚体。 上下游引物之间或同向引物之间出现互补。
- 发夹结构。 单条引物内部自互补,形成局部折叠。
在实际检查中,建议优先排查3’端相关结构。因为这类结构最容易被延伸并放大。
如果软件能输出ΔG、氢键数或类似指标,应该作为辅助判断依据。越稳定的错误配对,越可能干扰真实扩增。
5. 自动化筛选后的实验验证思路
5.1 设计完成不等于可以直接上样
很多新手会把“筛到一对引物”当成终点,其实这只是第一步。qPCR真正能否用,要靠实验验证。
建议至少做以下检查。
- 常规扩增曲线是否呈S型。
- 阴性对照是否无扩增。
- 熔解曲线是否只有单一主峰。
- 复孔之间Ct值是否稳定。
在SYBR Green体系中,单峰熔解曲线是判断特异性的重要信号。 如果低温区出现额外峰,往往提示引物二聚体。若高温区出现异常峰,则要警惕污染或非特异扩增。
5.2 从Ct值到结果解释
qPCR结果分析离不开Ct值、阈值和内参校正。若要比较基因A和基因B的表达差异,常用2^-ΔΔCt方法。这个方法的前提是扩增效率接近一致。
因此,设计阶段就要尽量保证:
- 目标基因与内参扩增效率相近。
- 产物长度接近。
- 反应体系稳定。
- 复孔离散度低。
引物设计质量,直接决定后续定量分析是否可信。 如果前端设计不稳,后端统计再漂亮也只是“表面准确”。
6. WorkBuddy如何提升qPCR设计效率
6.1 把重复劳动变成标准动作
在真实科研环境里,最耗时的往往不是设计本身,而是围绕设计的反复修正。WorkBuddy适合把下面这些动作标准化。
- 序列导入。
- 参数初始化。
- 候选引物筛选。
- 结果整理与导出。
- 多轮修改时的版本管理。
对课题组而言,这种自动化最直接的收益是减少人为遗漏。同一套标准可以被不同成员复用,减少“换个人就换一套做法”的问题。
6.2 适合批量项目和高频实验室
如果你的课题组经常做基因表达检测,或者需要同时处理多个靶点,自动化流程的价值会更明显。尤其在以下场景中更有优势。
- 多基因并行筛选。
- 多转录本比较。
- 频繁修改引物长度或Tm参数。
- 需要快速输出候选序列用于合成。
在这些情况下,WorkBuddy更像一个可复用的工作台,而不是单次计算工具。 它能把设计、筛选和整理压缩到更短时间。
6.3 用解螺旋产品把流程真正落地
如果你希望把qPCR引物设计做成稳定、可复制的标准流程,解螺旋的相关产品更适合承担这个角色。它可以帮助你把模板导入、参数设置、候选筛选和结果整理串成连续步骤,减少手工切换和重复劳动。对需要高效率出结果的实验室来说,这种流程化支持能明显降低返工率,也更利于团队统一标准。
总结Conclusion
qPCR引物设计的本质,不是“找一对能扩增的序列”,而是围绕目标转录本、扩增效率和特异性建立一套可验证的设计流程。先选对模板,再设对参数,最后严查二级结构,才是稳定出结果的关键。
对于医学生、医生和科研人员来说,WorkBuddy的意义在于把原本分散、重复、易出错的操作标准化。若你希望进一步提升设计效率、减少返工并加快实验进度,可以直接借助解螺旋,把qPCR引物设计变成真正可执行的自动化流程。

- 引言Introduction
- 1. 为什么qPCR引物设计适合自动化
- 2. 从NCBI获取目标序列
- 3. 在WorkBuddy中建立qPCR引物设计流程
- 4. 候选引物的核心质控指标
- 5. 自动化筛选后的实验验证思路
- 6. WorkBuddy如何提升qPCR设计效率
- 总结Conclusion