35
 分享
引言Introduction
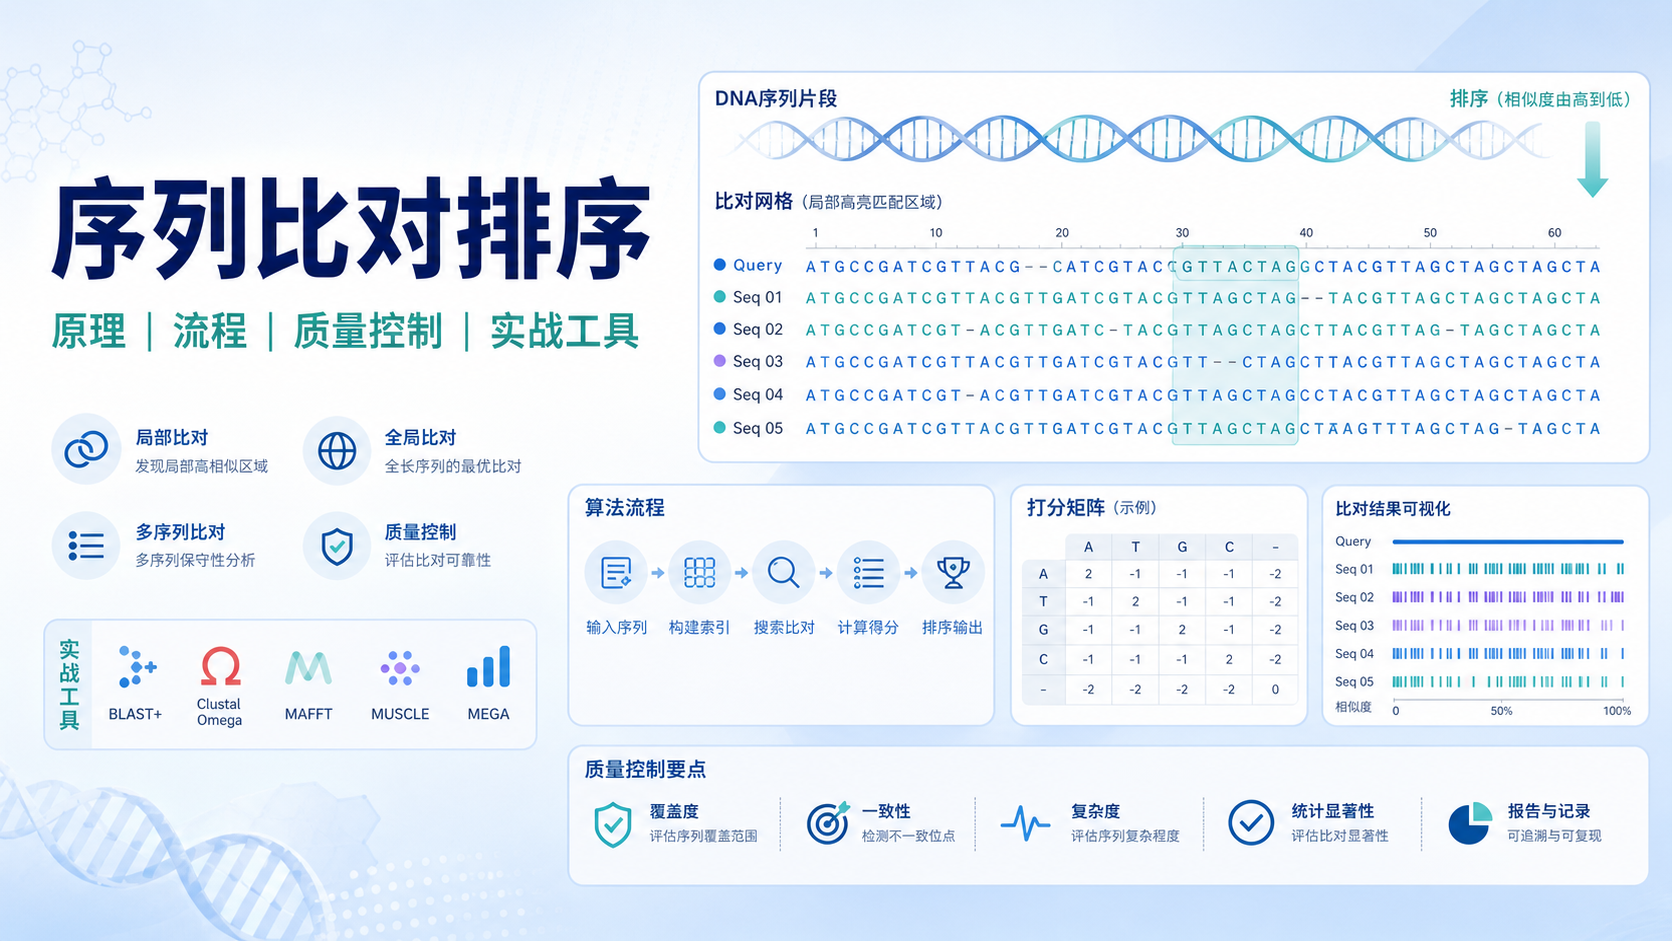
序列比对排序看似只是“把序列排整齐”,但在真实分析中,它直接影响保守位点识别、变异判断和后续系统发育分析。如果排序和比对方法选错,结果会被连锁放大,甚至误导结论。 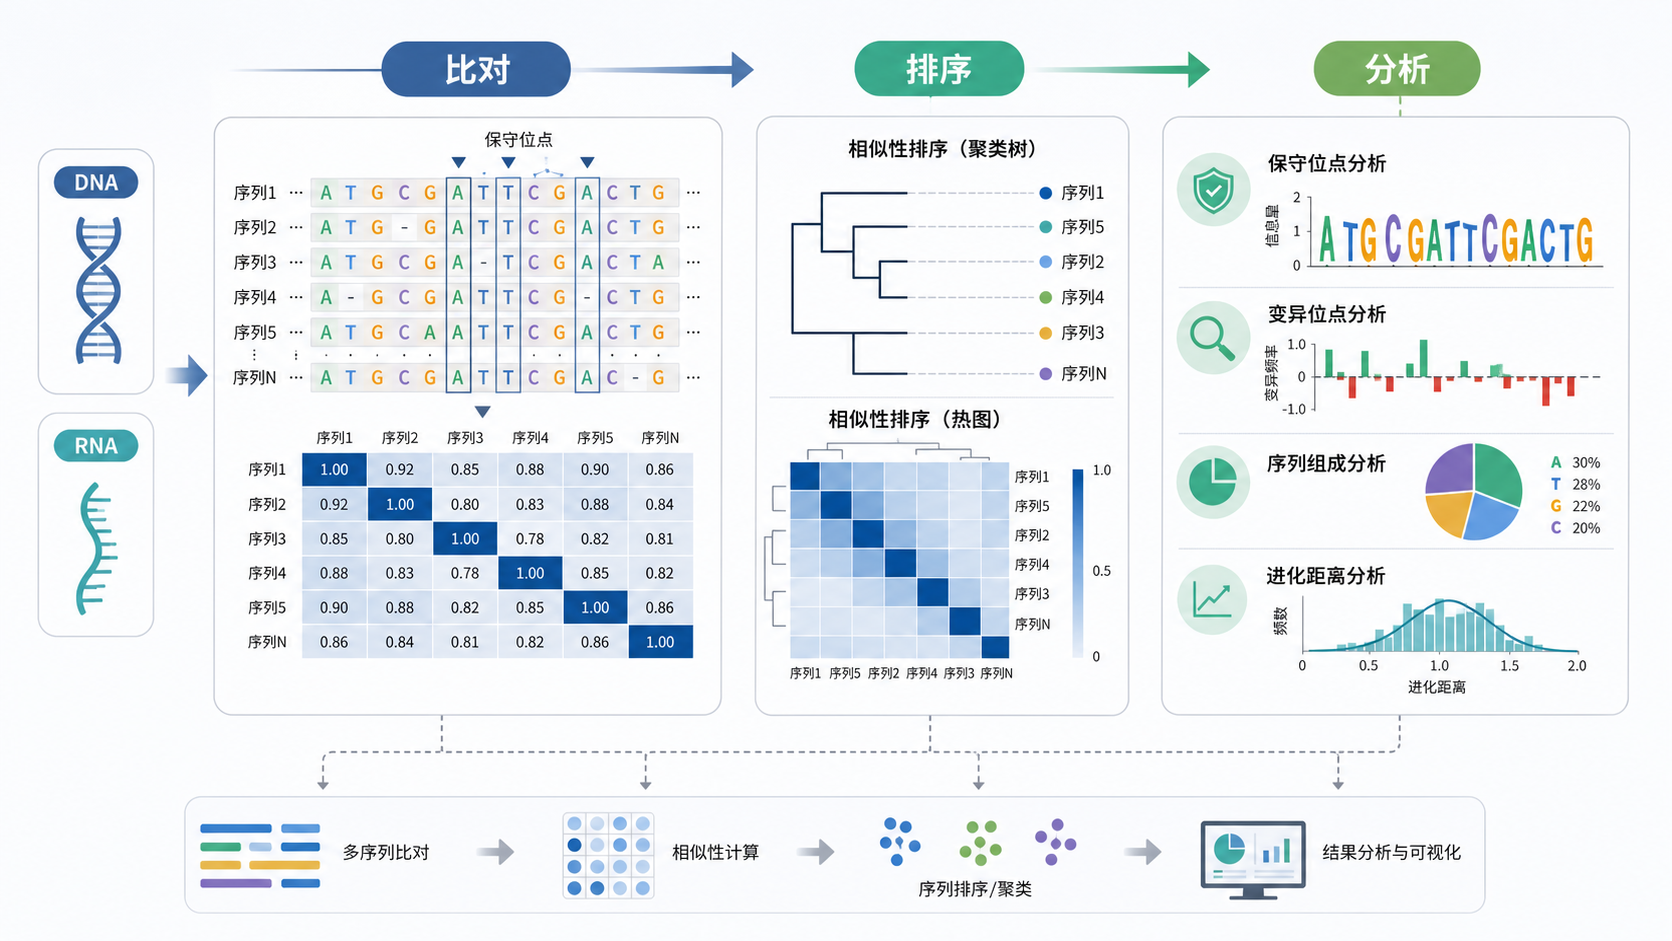
1. 先理解序列比对排序到底在做什么
1.1 比对不是简单排序,而是建立同源关系
生物信息学里的序列比对排序,核心不是“谁长谁短”或“谁在前谁在后”,而是判断不同序列之间的同源位置。排序的目标,是让同源碱基或氨基酸尽量对齐。
这一步决定了你后面能不能准确找出保守区域、插入缺失位点和突变热点。
在DNA、RNA和蛋白分析里,比对对象不同,排序逻辑也不同。
- DNA常用于变异检测、保守元件识别。
- RNA常用于转录本分析、表达相关研究。
- 蛋白比对更关注功能域和关键氨基酸位点。
1.2 为什么排序结果会影响最终结论
比对排序做得好,能把真实差异凸显出来。做得不好,就会把噪音当成信号。
比如在多序列比对中,如果gap位置放置不合理,保守位点会被打断,后续构建进化树时,分支关系可能偏移。
对科研人员来说,序列比对排序不是前处理步骤,而是结果可信度的起点。
尤其在以下场景中更敏感:
- 物种间同源基因分析。
- 病原体分型。
- 突变位点筛查。
- 引物和探针设计前的保守区确认。
2. 序列比对排序的原理基础
2.1 两类核心逻辑,局部比对和全局比对
序列比对通常分为全局比对和局部比对。两者决定了排序策略。
全局比对适合长度接近、整体同源性较高的序列。
它会尽量从头到尾对齐两条序列,适合近缘物种基因、同源转录本等分析。
局部比对适合只共享片段同源的序列。
它只找最相似的局部区域,常用于数据库搜索和片段片段之间的相似性确认。
实际分析中,排序方式必须和任务匹配。
如果序列差异大,却强行做全局比对,结果往往会产生大量不合理的gap。
2.2 打分体系决定排序质量
序列比对排序不是主观排版,而是由算法打分驱动。常见因素包括:
- 匹配得分。
- 错配惩罚。
- gap open penalty。
- gap extend penalty。
这几个参数会直接影响排序结果。
gap开罚越高,算法越不愿意引入缺口。
gap延伸罚越高,长缺口越不容易出现。
这也是为什么同一组序列,用不同软件或不同参数,排序结果可能不同。
不是谁对谁错,而是算法偏好不同。
2.3 多序列比对中的排序目标更复杂
多序列比对不只是把两条序列对齐,而是要同时兼顾多条序列之间的一致性。
它的目标是让同一位点在尽可能多的序列中对应起来。
这一步常用于:
- 构建系统发育分析基础文件。
- 识别保守motif。
- 比较不同样本的结构差异。
- 筛选适合下游实验验证的片段。
多序列比对的质量,直接决定后续共识序列和进化分析是否可靠。
3. 常用序列比对排序流程
3.1 从原始序列到可分析数据
标准流程通常包括以下步骤:
- 准备原始序列。
- 清理低质量片段或异常字符。
- 确定比对类型。
- 执行双序列或多序列比对。
- 检查排序结果。
- 导出文件用于后续分析。
这一流程看似简单,但最容易出问题的是第2步和第5步。
低质量序列、方向错误、命名混乱,都会让排序失真。
3.2 双序列比对适合先做验证
双序列比对是最基础的起点。
它适合快速确认两条序列是否同源,或检查引物、片段、变异区域是否匹配。
在实践中,建议先做双序列比对,再决定是否进入多序列比对。
这样可以先排查明显错误,比如:
- 序列方向相反。
- 序列包含多余接头。
- 起始和终止位置不一致。
- 某一条序列存在明显缺失。
3.3 多序列比对更适合群体比较
当你要分析多个样本、多个物种或多个转录本时,多序列比对更有价值。
它能帮助你看出哪些位点是保守的,哪些位点是可变的。
真正有用的排序结果,不是看起来整齐,而是能解释生物学差异。
所以在多序列比对后,必须人工检查关键位点,而不能完全依赖软件自动输出。
4. 实践中如何提高比对排序质量
4.1 先做输入质量控制
排序结果的上限,往往由输入质量决定。
建议在比对前检查以下内容:
- 序列长度是否异常。
- 是否存在大量N或未知字符。
- 是否混入反向互补序列。
- 命名是否统一。
- 是否有重复样本。
如果是RNA相关序列,还要注意转录本异构体的问题。
如果是蛋白序列,要先确认翻译框是否正确。
4.2 参数设置要和研究目的匹配
不同研究目标,对排序参数的容忍度不同。
例如:
- 找保守位点时,建议更关注精确对齐。
- 做远缘序列比较时,要允许适度gap。
- 做短片段验证时,优先避免过度引入缺口。
不要把“默认参数”当作万能答案。
默认参数适合入门,不一定适合发表级分析。
4.3 排序后要做人工审查
这一步非常重要。
软件能给出结果,但不能替你判断结果是否生物学合理。
检查重点包括:
- 关键功能位点是否对齐。
- 长gap是否出现在合理区域。
- 保守区域是否连续。
- 是否存在明显错配堆积。
- 物种或样本间排序是否符合已知关系。
如果结果与已知生物学信息明显冲突,就要回到前一步重新检查输入和参数。
5. 从工具到实践,WorkBuddy+比对排序能解决什么问题
5.1 工具价值在于减少重复劳动
在真实科研工作里,序列比对排序往往不是一次性任务,而是反复迭代。
你会不断调整样本、重新导入序列、修改参数、导出结果,再做下游分析。
WorkBuddy+比对排序的价值,就在于把这些高频操作标准化。
当流程更稳定,研究者就能把时间集中在结果判断,而不是反复处理格式和步骤。
5.2 适合高频、多轮、协作式分析场景
对于医学生、医生和科研人员来说,最耗时的通常不是“会不会比对”,而是“如何把一批序列快速整理成可分析结果”。
如果一个项目需要反复比较多个样本,统一的排序与管理流程会明显提高效率。
这类场景包括:
- 病原体序列监测。
- 基因家族成员比较。
- 突变位点初筛。
- 多批次实验数据整合。
- 团队协作中的序列版本管理。
把比对排序流程工具化,能减少人为差错,也更利于结果复核。
5.3 让分析更接近可复现标准
科研最怕的不是结果慢,而是结果不可复现。
当比对、排序、导出和记录形成稳定流程,后续复核会更容易。
这也是很多实验室越来越重视标准化分析工具的原因。
如果你正在处理大量序列,或者需要把序列比对排序纳入常规分析流程,借助 解螺旋 这类面向科研场景的产品思路,可以更快完成整理、比对和结果输出,减少重复手工操作,让你把精力放回到真正的生物学解释上。
总结Conclusion
序列比对排序不是简单的软件操作,而是决定下游分析可靠性的关键步骤。
从原理上看,它依赖同源关系判断、打分体系和gap策略。
从实践上看,它要求输入质量、参数设置和人工审查三者都到位。
想把序列比对排序做对,核心不是“点对按钮”,而是理解算法、检查结果、统一流程。
如果你希望提升序列处理效率,并减少重复劳动,不妨进一步了解 解螺旋 ,把标准化分析流程真正用起来。

- 引言Introduction
- 1. 先理解序列比对排序到底在做什么
- 2. 序列比对排序的原理基础
- 3. 常用序列比对排序流程
- 4. 实践中如何提高比对排序质量
- 5. 从工具到实践,WorkBuddy+比对排序能解决什么问题
- 总结Conclusion