24
 分享
引言Introduction
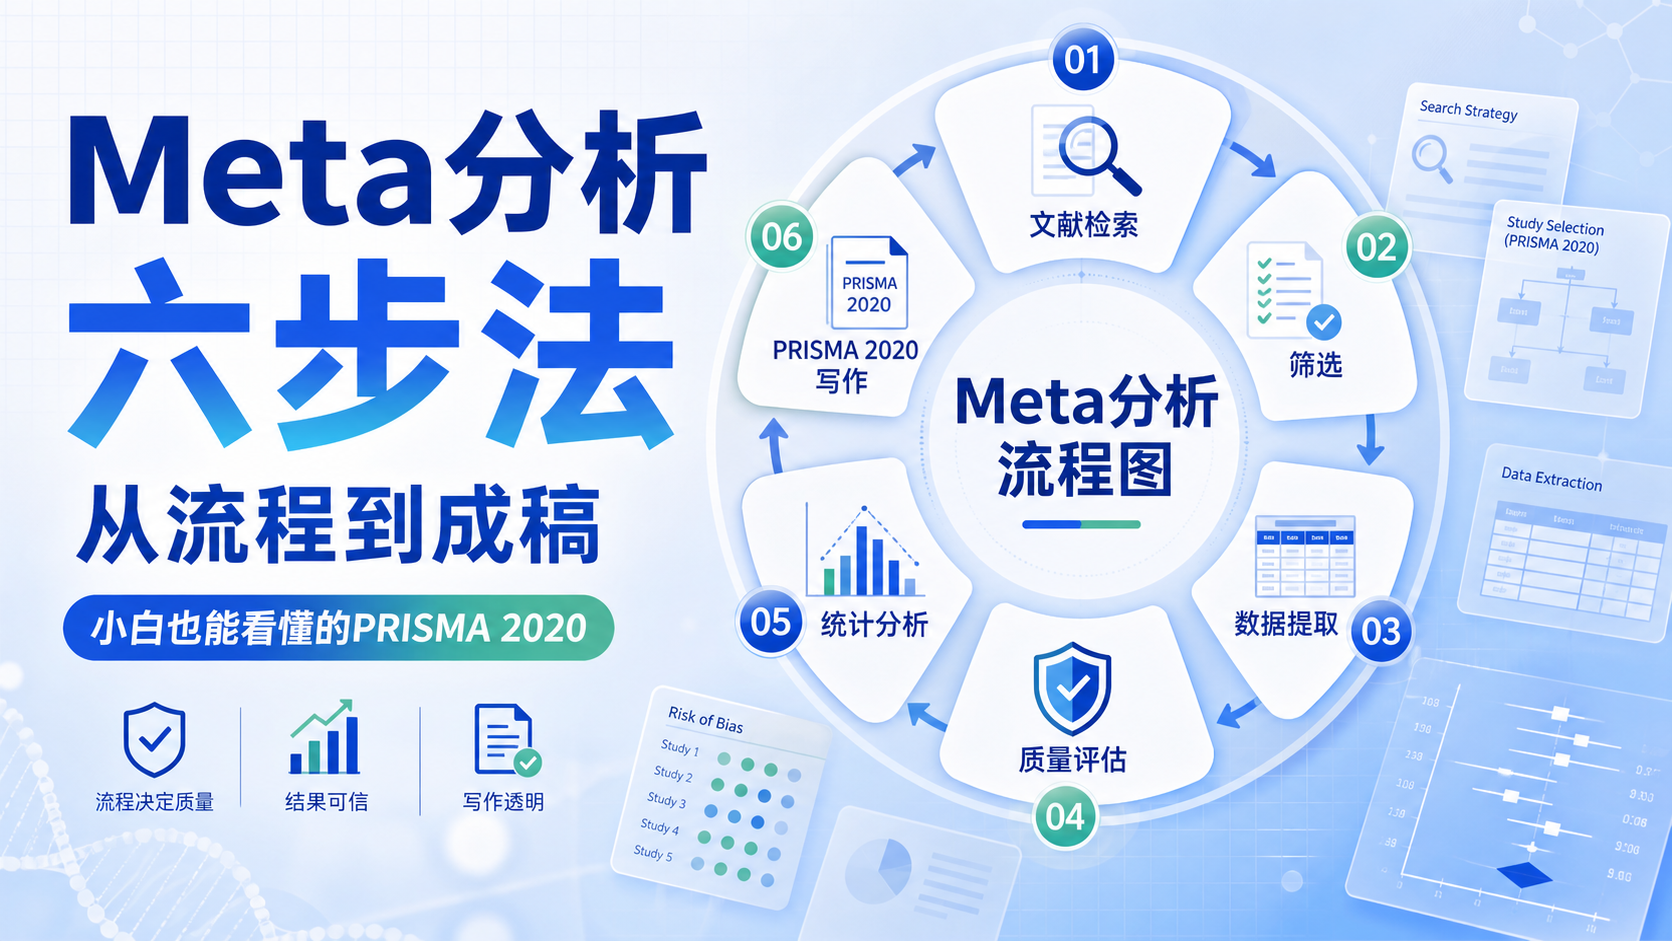
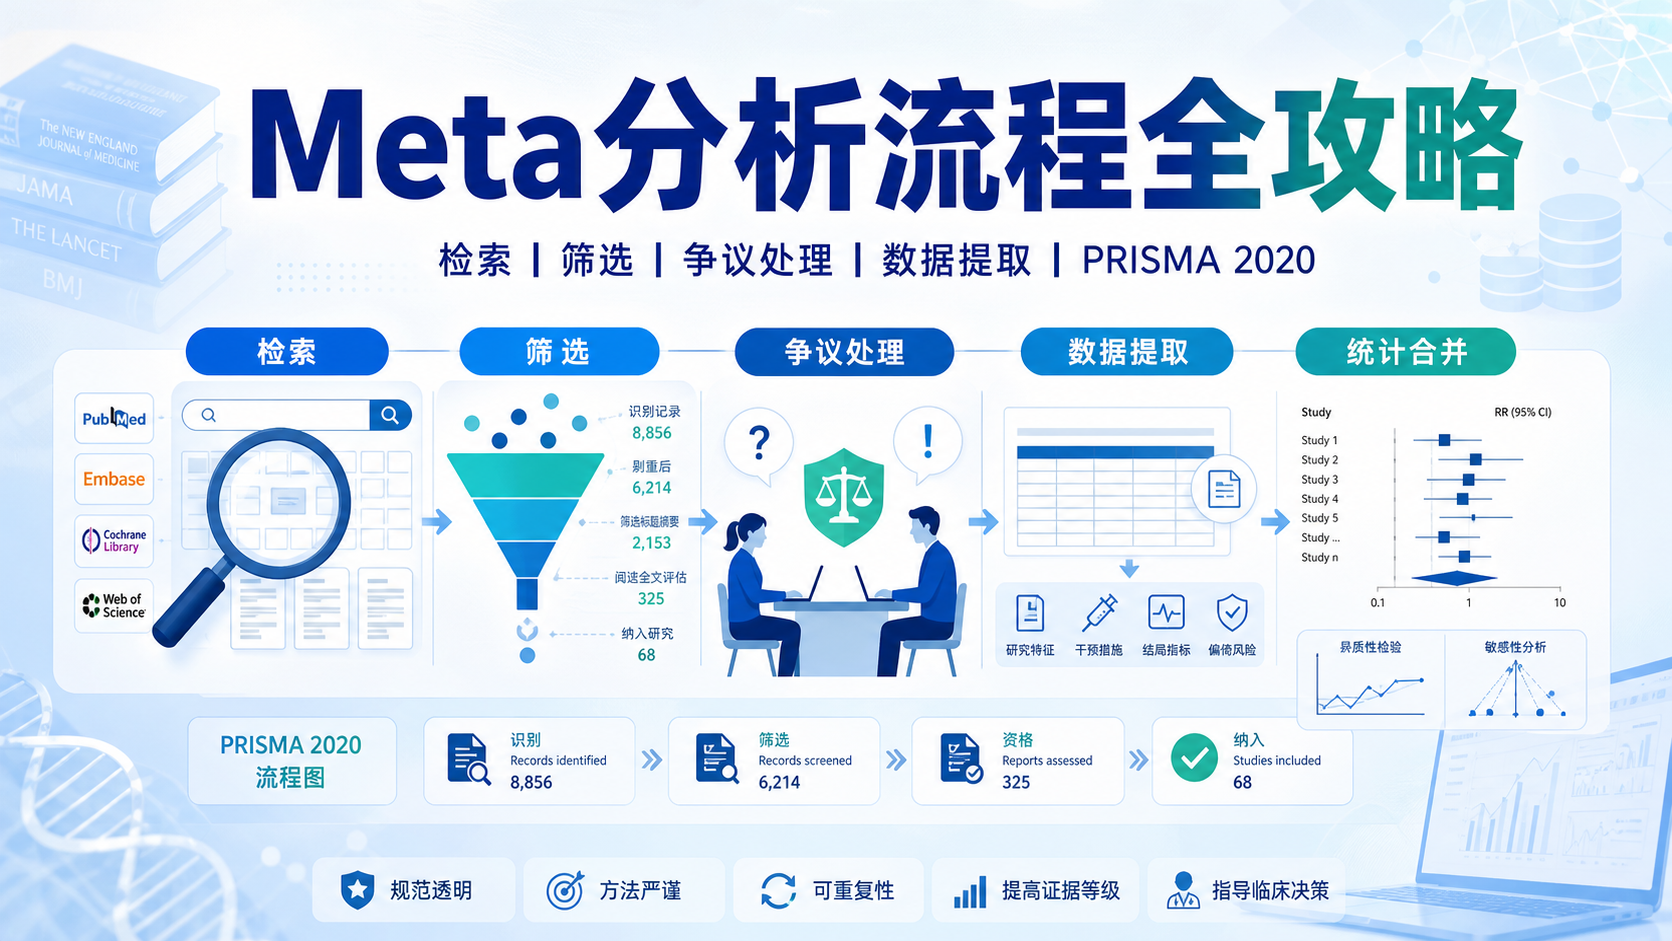
Meta分析做得慢,常常不是统计难,而是检索和筛选乱。检索式太宽,噪音太多。筛选标准不清,争议频发。真正决定效率和质量的,是一开始的检索策略和规范筛选流程。
1. 为什么检索策略决定Meta分析质量
1.1 选题之后,最先要解决的是“找全”和“找准”
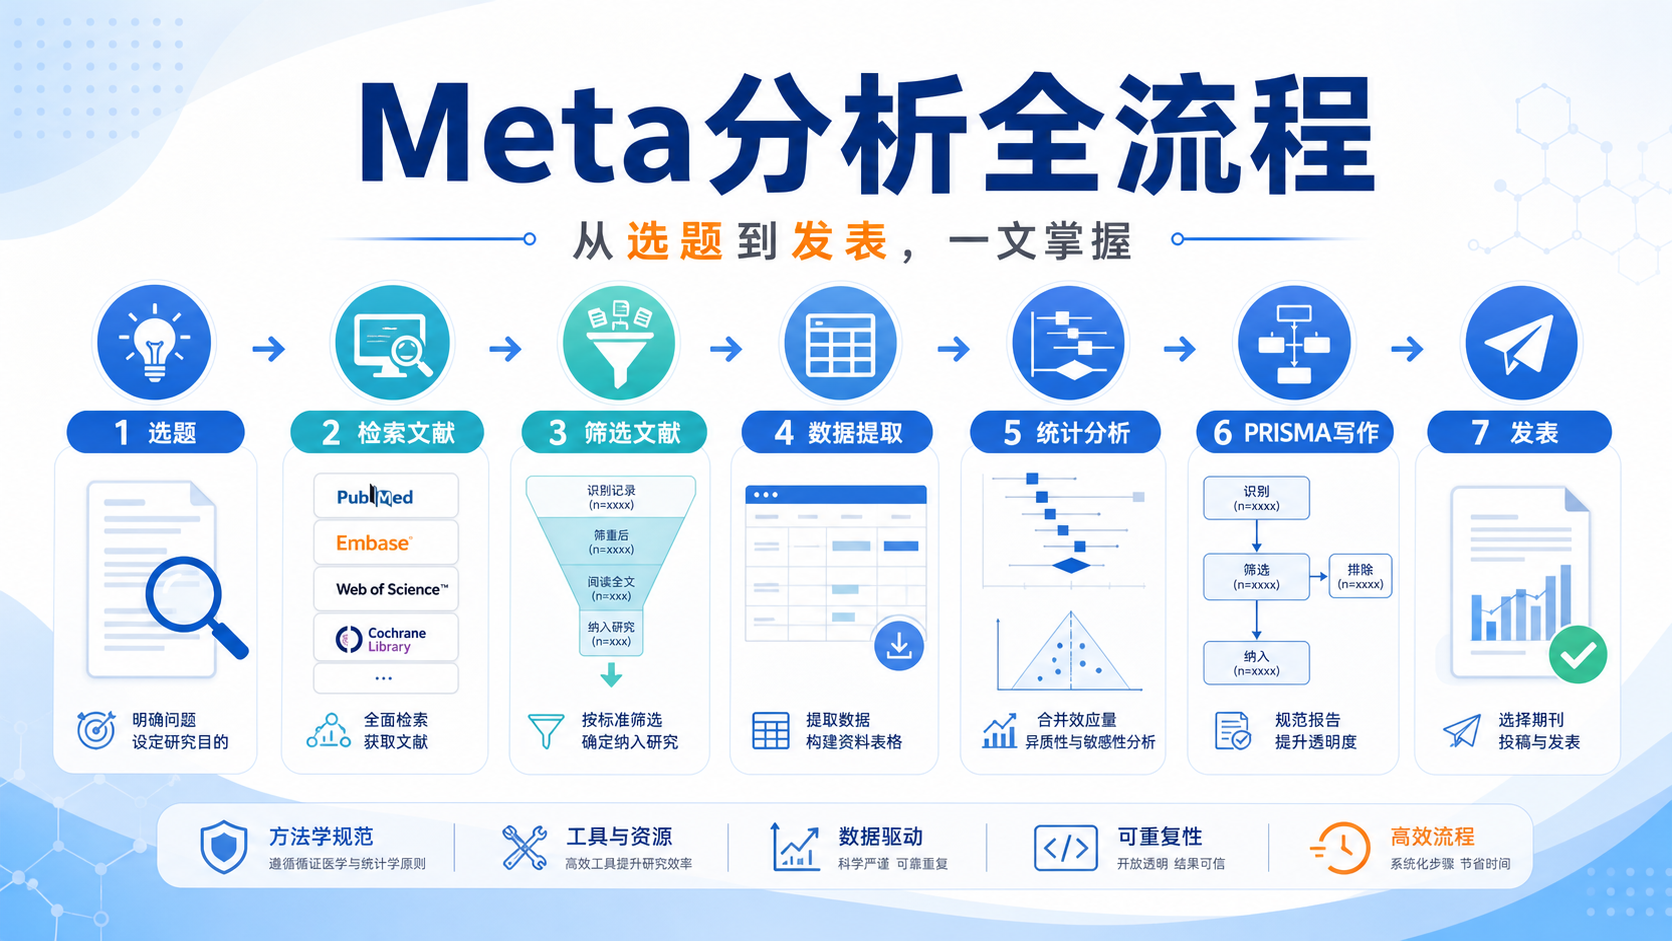
Meta分析的第一步是确定选题,但真正影响结果的,往往是第二步检索。选题通常来自临床问题,也来自文献触发。问题明确后,必须尽早设计检索词、同义词和逻辑关系。
检索式不是越复杂越好,而是越稳定越好。 如果一开始范围过宽,结果会被大量噪音淹没。后续筛选成本会显著增加。相反,过窄又会漏掉关键研究,影响纳入数量和结论可靠性。
1.2 检索策略要先聚焦,再逐步放开
实操中更推荐先从聚焦检索开始,再逐步扩展。这样可以快速判断核心文献是否被捕获,再决定是否放宽条件。
常见做法包括:
- 先限定核心疾病、干预或结局。
- 再补充同义词、缩写和MeSH词。
- 根据初步结果调整布尔逻辑。
- 必要时扩展到更广义术语,避免遗漏。
多数据库检索是基本要求。 PubMed、WOS、Cochrane 等数据库的收录侧重点不同。单一数据库很难覆盖完整证据链。对临床和系统评价类研究来说,这一步直接影响纳入研究的全面性。
1.3 检索式要保留可复现性
检索不仅是“找到文献”,更要保证别人能复现你的过程。写作时应记录:
- 数据库名称。
- 检索日期。
- 检索词和逻辑关系。
- 限定条件,如语言、年份、研究类型。
- 最终检索条数。
可复现的检索策略,是Meta分析可信度的基础。 这也是后续写方法学和PRISMA流程图时必须具备的信息。
2. 筛选流程的核心,是双人独立判断
2.1 初筛和精筛不能混为一谈
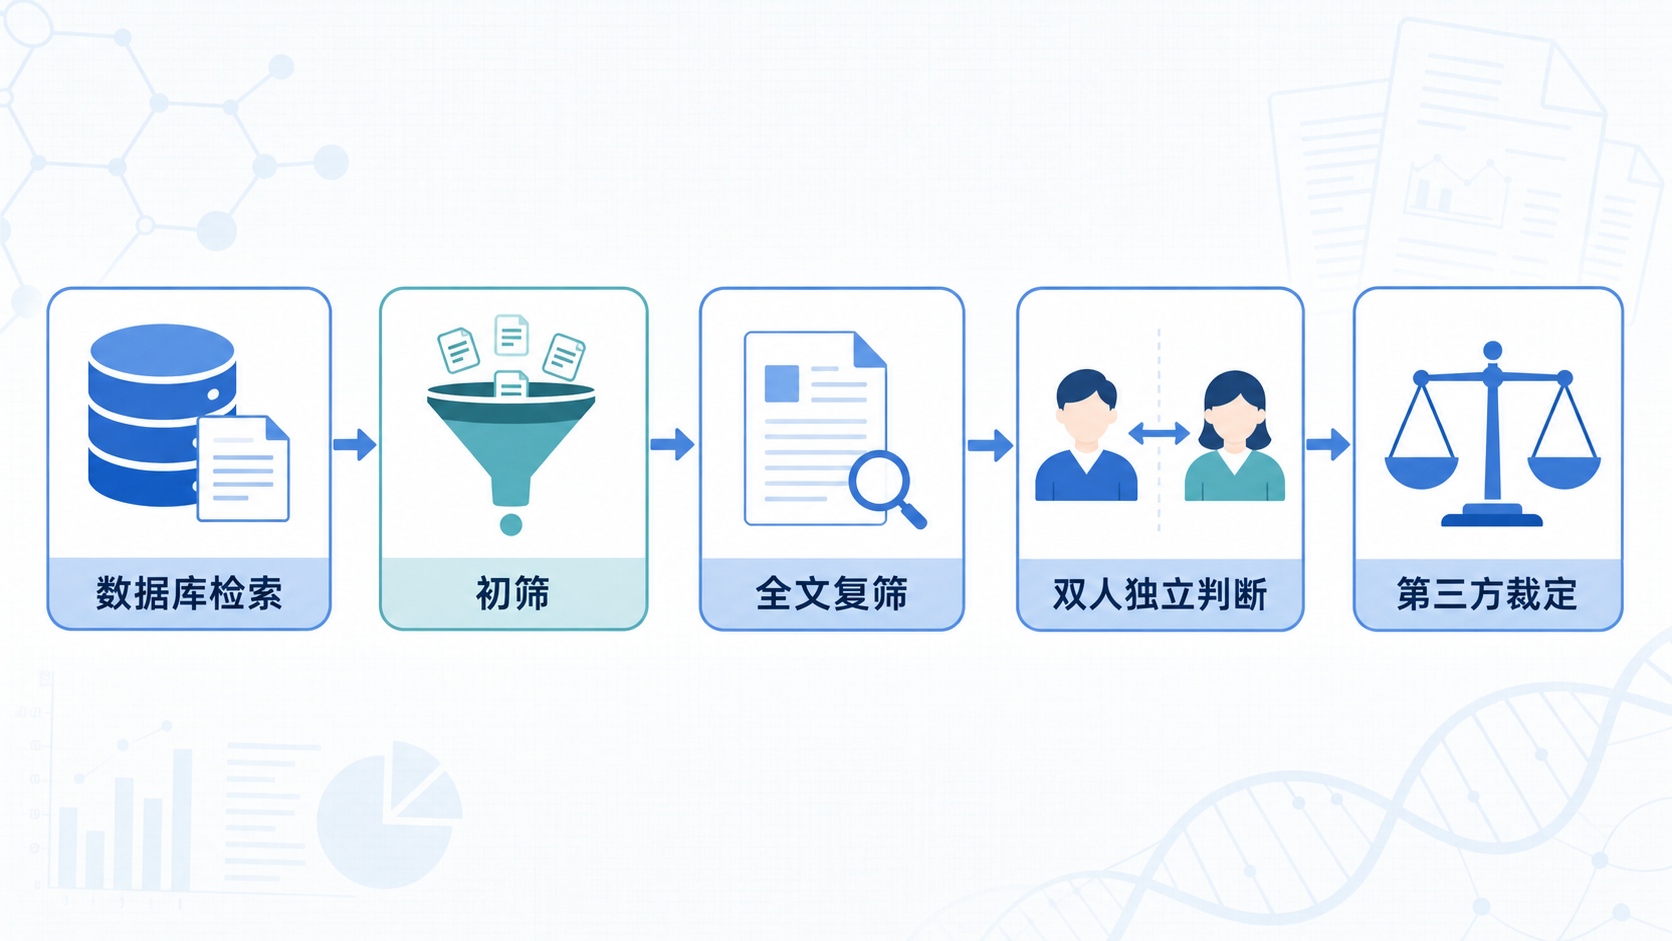
筛选通常分为两个阶段。第一阶段是题目和摘要初筛。第二阶段是全文复筛。两者关注点不同。
初筛的目标是快速排除明显不相关文献。精筛则要阅读全文,确认是否真正符合纳入标准。很多文献在标题和摘要上看起来相关,但全文并不满足研究设计、结局指标或人群要求。
临床研究中,最后纳入的文献常常只剩几篇到几十篇。初始检索量很大,但真正可用的研究数量并不高。这是正常现象,不代表检索失败。
2.2 yes、maybe、no 分类更利于一致性
筛选时,建议采用 yes、maybe、no 三类判断,而不是简单的“纳入”或“排除”。这种方式更适合双人独立筛选。
具体可理解为:
- yes,明确符合纳入标准。
- no,明确不符合纳入标准。
- maybe,信息不足,需要全文确认。
“maybe”类文献尤其重要。 它能减少因摘要信息不足造成的误排。对于系统评价和Meta分析,这类文献往往占相当比例。
2.3 双人独立筛选是标准做法
规范写法通常要求两名研究者独立完成筛选。无论是初筛还是全文复筛,都应尽量独立判断,并记录各自决策。
这样做的价值有三点:
- 降低主观偏倚。
- 提高一致性。
- 便于后续追踪争议来源。
如果没有双人独立筛选,研究的可重复性会明显下降。 这在投稿时容易被审稿人质疑,尤其是方法学较严格的期刊。
3. 争议如何处理,第三方判定为什么重要
3.1 争议是常态,不是错误
在筛选过程中出现分歧非常常见。原因通常包括:
- 摘要信息不足。
- 研究对象界定模糊。
- 干预措施定义不一致。
- 结局指标在全文中才出现。
- 同一研究有多个发表版本。
有争议并不可怕,关键是要有明确的解决机制。 这正是第三方判定存在的意义。
3.2 第三方裁定要写进方法学
当两位研究者意见不一致时,通常由第三方裁定。第三方一般是更有经验的研究者或课题负责人。
写作中建议明确说明:
- 两名研究者独立筛选。
- 发生分歧时通过讨论解决。
- 若仍无法一致,则由第三方判定。
这段流程看似简单,但它直接关系到研究透明度。PRISMA 2020强调研究流程要清晰可追溯。 只写“由研究者筛选”通常不够完整。
3.3 决策过程要留痕
建议保留每一步的记录,包括:
- 每篇文献的判断结果。
- 被排除的原因。
- 争议文献的最终结论。
- 第三方判定依据。
这样做不仅有助于写文章,也便于后续答辩、审稿回复和重复研究。对于医学生和青年医生来说,这一步能显著减少返工。
4. 数据提取与统计分析,必须建立在筛选准确之上
4.1 全文提取前,先确认结局指标
筛选通过后,不能直接进入统计。要先进行数据提取。通常需要阅读全文,提取研究对象、干预措施、随访时间和关注的 outcomes。
数据提取错误,后面的森林图再漂亮也没有意义。 所以建议同样采用双人提取并核对的方式,避免录入偏差。
4.2 统计分析要回答“能不能合并”
Meta分析不是简单拼接数据。要先判断研究之间能否合并,核心看三点:
- 研究对象是否同质。
- 干预和对照是否一致。
- 结局指标是否可比。
统计中常见内容包括:
- 森林图。
- I²异质性判断。
- 漏斗图。
- 偏倚评估。
- GRADE证据等级评分。
I²并不是越低越好,而是帮助判断异质性来源。 如果异质性高,要考虑亚组分析或敏感性分析,而不是机械合并。
4.3 PRISMA 2020 是写作底线
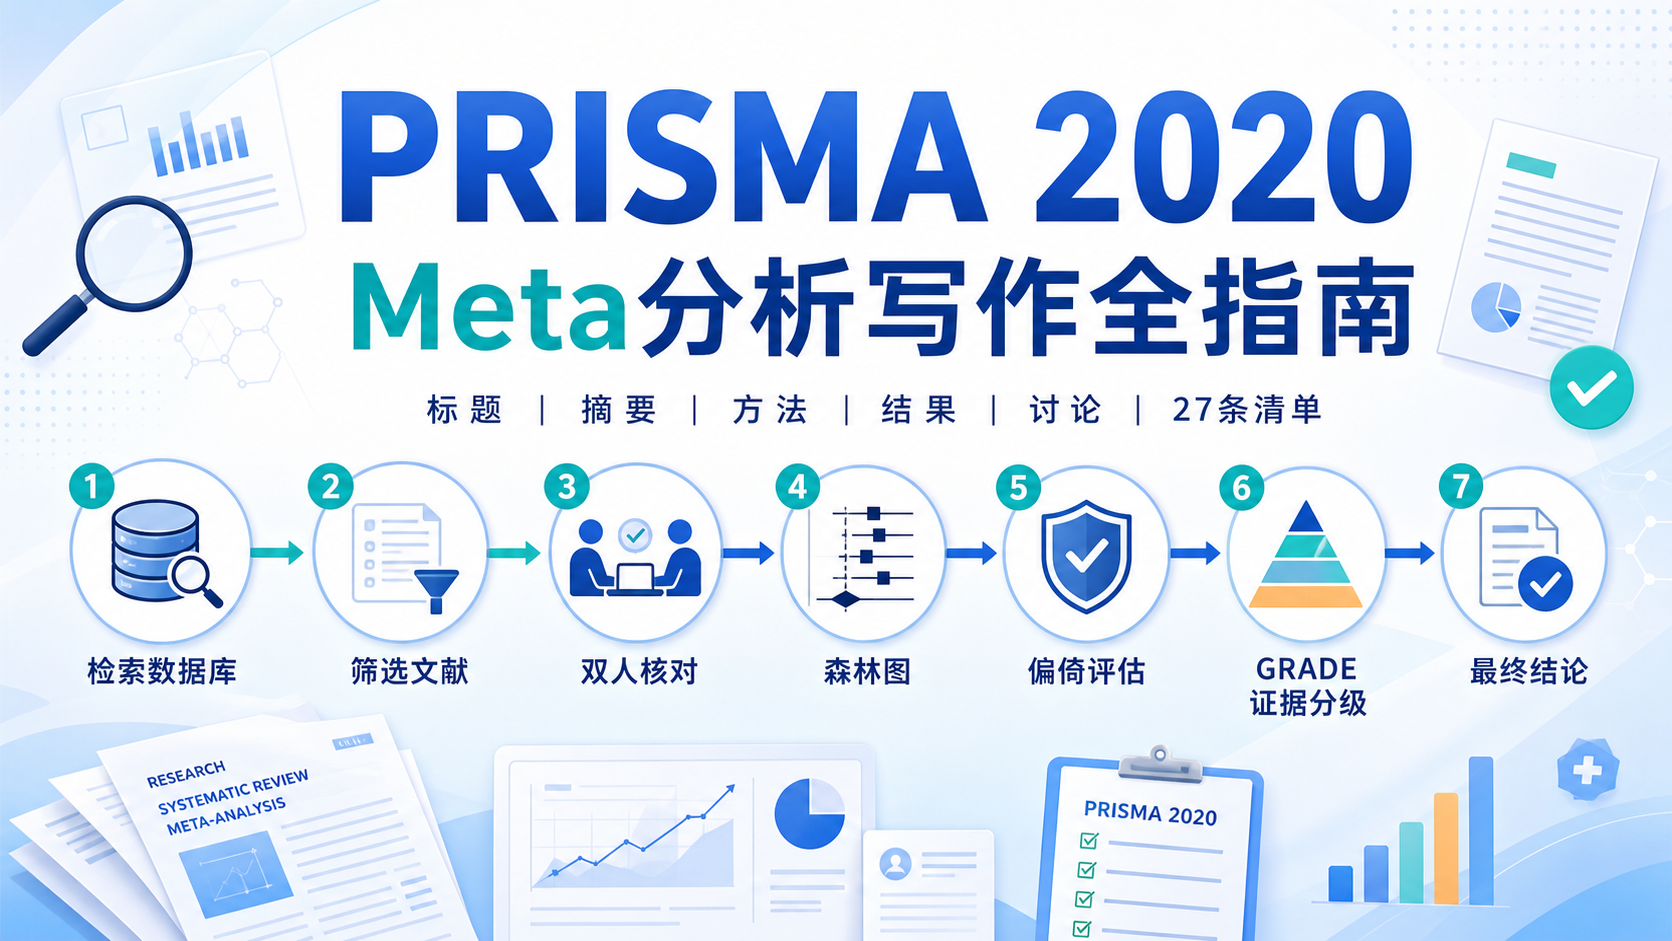
Meta分析写作时,应遵循 PRISMA 2020 的 27 条规范。它要求方法清楚、流程完整、结果透明。包括:
- 检索策略。
- 纳入排除标准。
- 筛选流程。
- 数据提取。
- 偏倚评估。
- 结果报告。
对研究生和青年医生来说,PRISMA 不是形式,而是框架。结构完整,文章才更容易被理解和接受。
5. 实操中最容易出错的几个环节
5.1 检索过宽,导致筛选负担过重
很多初学者会一次性把检索范围放得过大,结果返回大量无关文献。虽然看起来“更全面”,但实际会增加筛选时间,还容易让真正相关的文献被淹没。
更稳妥的方式是:
- 先用核心词检索。
- 查看高相关文献的关键词。
- 再补充同义词和扩展词。
- 最后优化逻辑组合。
5.2 纳入标准写得太模糊
如果纳入标准不清,筛选阶段就一定会反复争议。尤其是研究设计、干预形式、结局指标、随访时间这些条件,必须提前定义清楚。
例如:
- 是否只纳入随机对照试验。
- 是否排除回顾性研究。
- 是否限定成人或特定疾病分层。
- 是否要求某个固定结局。
标准越明确,筛选越高效。
5.3 只看摘要,不看全文
这是最常见的错误之一。摘要往往省略关键方法细节,甚至不报告全部结局。最终纳入前,必须阅读全文确认。
尤其在以下情况中更要谨慎:
- 多中心研究。
- 多结局研究。
- 分阶段发表研究。
- 中文与英文重复发表。
6. 写作时如何把流程写得更专业
6.1 方法部分要讲清“怎么做”
在论文方法部分,建议用简洁但完整的语言描述:
- 检索了哪些数据库。
- 检索时间范围。
- 使用了哪些检索词。
- 是否由两名研究者独立筛选。
- 分歧如何解决。
- 是否进行了双人数据提取。
- 是否采用标准工具进行偏倚评估。
方法写得越清楚,审稿人越容易判断研究质量。
6.2 结果部分要体现筛选数量
PRISMA流程图通常要展示:
- 检索到的总文献数。
- 去重后数量。
- 初筛排除数。
- 全文复筛排除数。
- 最终纳入数。
如果最终只纳入几篇研究,也应如实报告。数量少不等于价值低,关键是筛选标准是否合理,证据链是否透明。
6.3 讨论部分要回到证据质量
讨论部分不只解释结果,也要解释证据来源和局限。可重点回应:
- 检索是否可能遗漏研究。
- 筛选是否存在主观偏差。
- 样本量是否过小。
- 研究异质性是否较高。
- 结论是否能推广到临床实践。
这部分正是很多人搜索“meta分析讨论部分写作”时最需要的内容。讨论要围绕证据质量、偏倚风险和临床意义展开,而不是重复结果。
7. 用规范工具提升效率,减少返工
7.1 让流程标准化,才能真正提速
对医学生、医生和科研人员来说,Meta分析最耗时的往往不是统计,而是文献管理、筛选记录和结果整理。流程不标准,就会反复返工。
建议至少做到:
- 检索记录统一管理。
- 筛选标准提前确定。
- 双人独立判断。
- 分歧有第三方裁定。
- 数据提取模板固定。
7.2 解螺旋可帮助把流程做得更顺
如果你希望把Meta分析流程进一步标准化,减少检索、筛选和写作中的重复劳动,可以借助解螺旋 提供的科研支持工具与方法服务。它能帮助你更高效地梳理检索逻辑、规范筛选记录、整理方法学框架,让研究过程更清晰,也更利于后续投稿。
把流程做规范,往往比单纯追求更大的检索量更重要。 这也是提高Meta分析质量和完成效率的关键。
总结Conclusion
Meta分析的质量,往往从检索策略就已经决定。先聚焦、再扩展,多数据库覆盖,双人独立筛选,争议交由第三方判定,这套流程能显著提升研究的透明度和可重复性。真正专业的Meta分析,不是检索条数多,而是流程严谨、记录完整、结论可信。
如果你正在进行Meta分析,建议尽早建立标准化流程。需要更高效的科研支持时,也可以进一步了解解螺旋 ,让检索、筛选和写作更省时、更规范。

- 引言Introduction
- 1. 为什么检索策略决定Meta分析质量
- 2. 筛选流程的核心,是双人独立判断
- 3. 争议如何处理,第三方判定为什么重要
- 4. 数据提取与统计分析,必须建立在筛选准确之上
- 5. 实操中最容易出错的几个环节
- 6. 写作时如何把流程写得更专业
- 7. 用规范工具提升效率,减少返工
- 总结Conclusion