13
 分享
引言Introduction
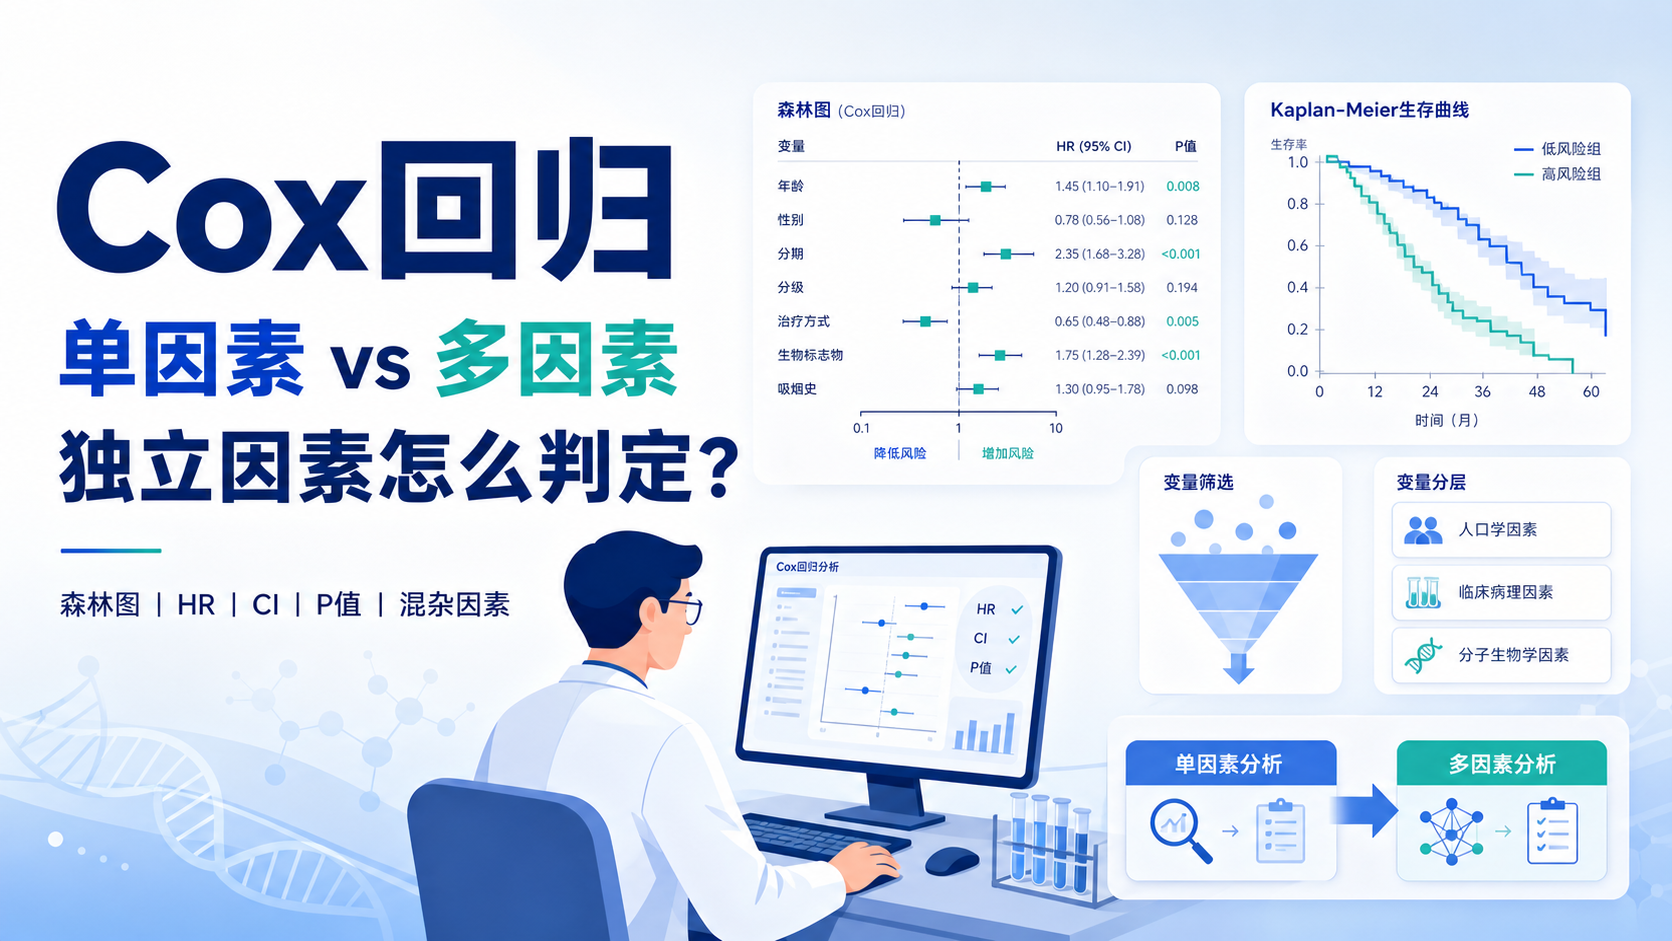
Cox回归单因素分析常被误用。只看P值,容易把混杂因素当成真实关联。对医学生和科研人员来说,真正关键的是:如何从单因素走到多因素,判断一个变量是否为独立预后因素 。这篇文章用清晰步骤讲透。
1. 为什么Cox回归必须分单因素和多因素
1.1 单因素只能回答“有关联吗”
Cox回归单因素分析的作用,是先看每个变量与生存结局是否有关。常见变量包括年龄、分期、治疗方式、基因表达等。
它的优点是直观,适合快速筛查。但它不能证明独立性 。因为一个变量显著,可能只是它和另一个强变量相关。
例如,某项治疗在单因素中提示生存更好,并不等于治疗本身有效。也可能是接受治疗的患者整体分期更早、基础状态更好。
1.2 多因素才用于判定独立因素
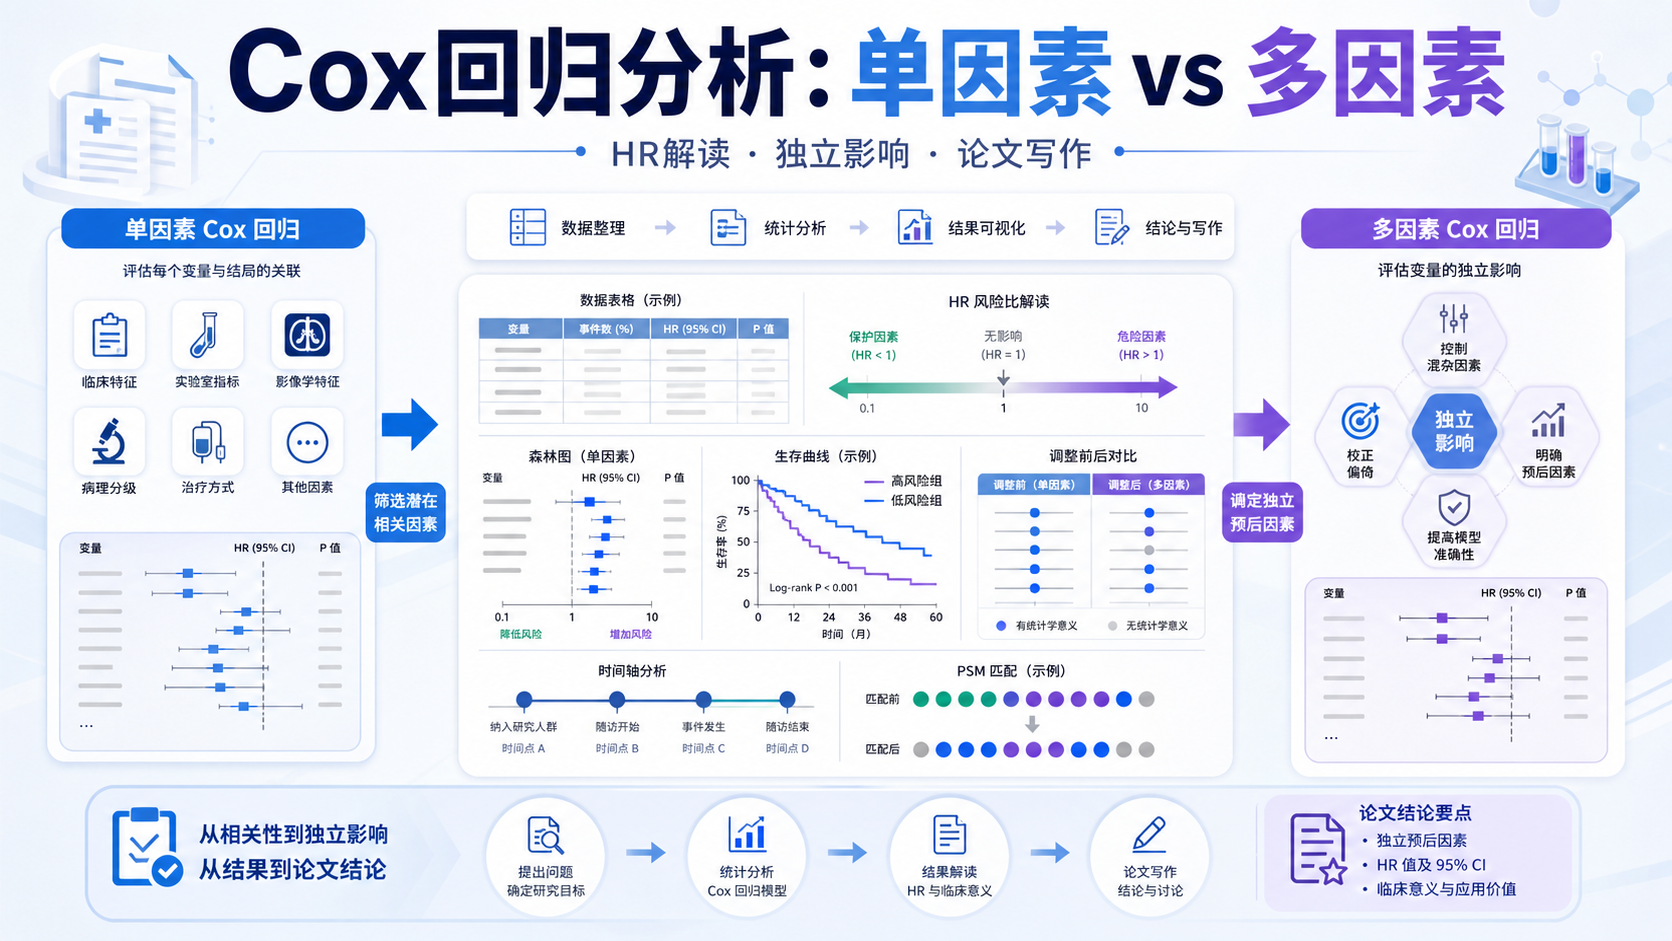
多因素Cox回归把多个变量同时放入模型。这样可以在控制混杂后,判断某变量是否仍然显著。
只有在多因素中仍然显著,才更接近“独立预后因素”的结论。
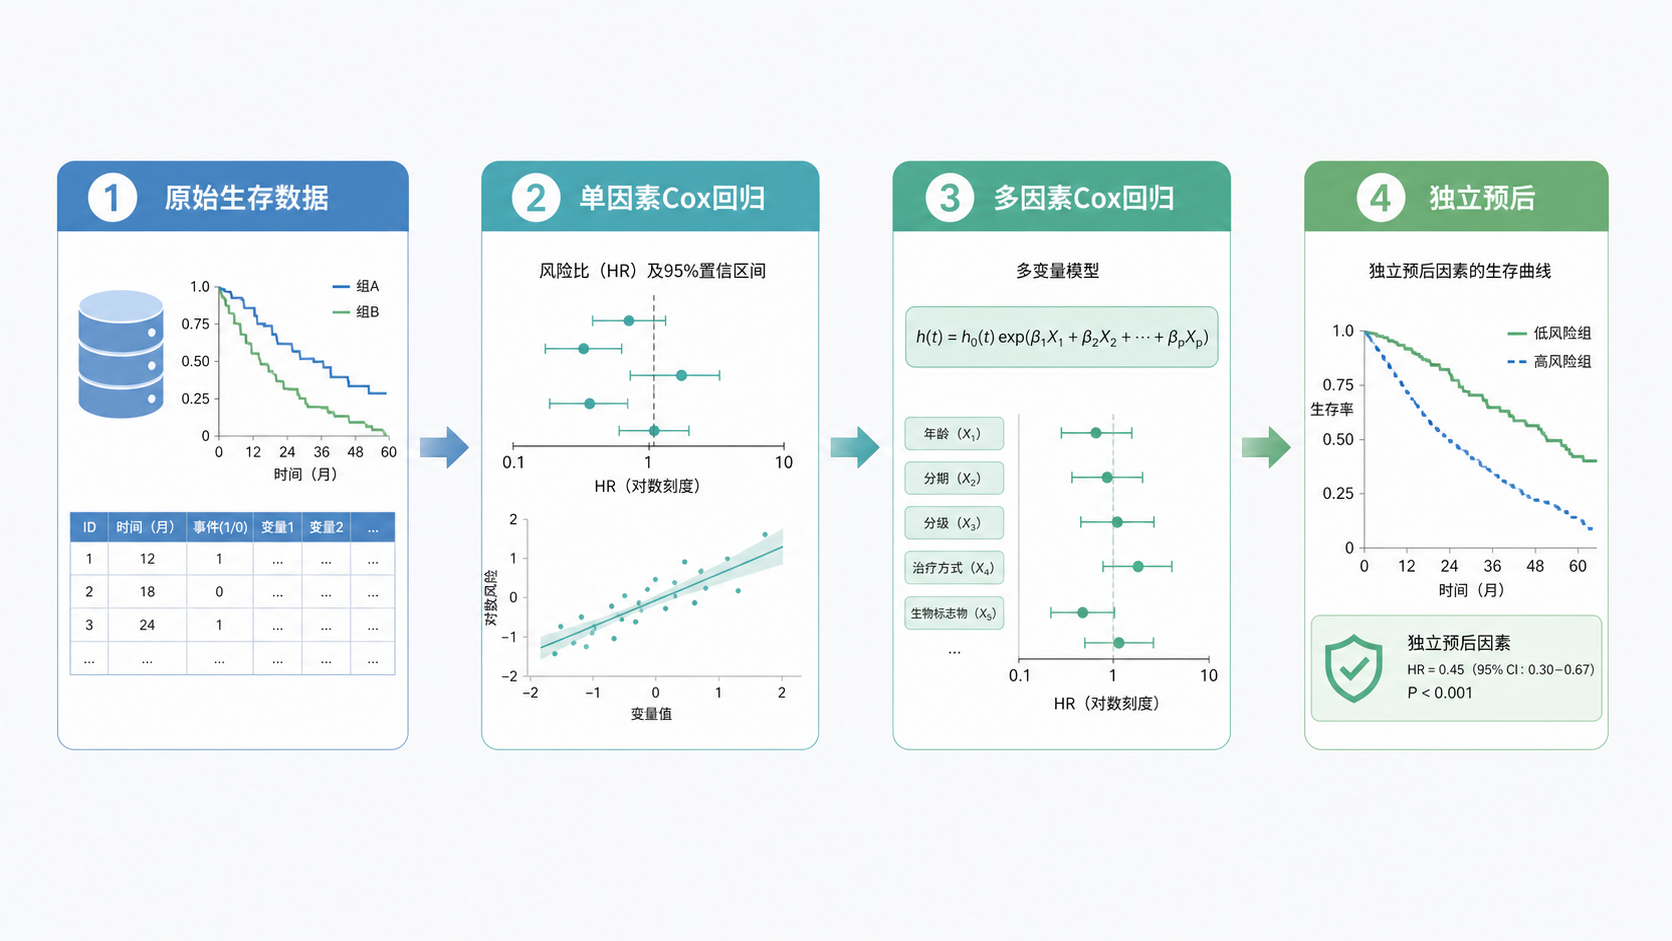
这也是论文里常见的逻辑。先做单因素筛查,再做多因素验证。两步缺一不可。对于临床研究,这比只报告一个P值更有说服力。
2. Cox回归单因素分析怎么做
2.1 明确结局变量和自变量
Cox模型的核心是生存结局。通常包括两项信息。
- 生存时间,time。
- 结局状态,status,通常用0和1表示删失和事件。
自变量可以是连续变量,也可以是分类变量。比如年龄、性别、分期、疗法、基因表达量。
如果结局信息不完整,或者时间定义不一致,结果就不可靠。
2.2 单因素Cox的基本形式
单因素Cox分析每次只放入一个变量。模型形式很简单。
Surv(time, status) ~ variable
输出重点看三个指标。
- HR,风险比。
- 95%CI,置信区间。
- P值,统计学显著性。
解释时要注意方向。
- HR > 1,提示风险升高。
- HR < 1,提示风险降低。
- 95%CI跨1,通常提示结果不显著。
单因素分析的价值,不是下结论,而是筛选候选变量。
2.3 批量分析更适合科研场景
在真实项目中,变量往往不止一个。临床变量和分子变量加起来可能有很多。
此时常见做法是批量单因素Cox回归,把每个变量逐一跑一遍,再整理成表格。
这种做法有几个好处。
- 提高效率。
- 方便比较不同变量的效应方向。
- 为后续多因素模型筛选候选项。
一般会优先保留P值较低的变量进入多因素模型,但是否纳入,还要结合临床意义。统计学显著,不等于临床上值得保留。
3. 从单因素走向多因素,如何判定独立因素
3.1 为什么单因素显著,到了多因素就消失
这是Cox回归里最常见的现象之一。
单因素显著的变量,在多因素中可能变得不显著。原因通常有三类。
- 与其他变量共线。
- 真实效应被更强的变量解释。
- 单因素中的显著性来自混杂。
这并不罕见。恰恰说明多因素模型有必要。它不是“拆台”,而是帮助你识别真正独立起作用的变量。
3.2 独立因素的判定标准
判断一个变量是否为独立预后因素,通常看三点。
- 单因素Cox中有统计学意义。
- 多因素Cox中仍然有统计学意义。
- HR方向稳定,且95%CI不跨1。
如果一个变量在多因素中仍显著,说明它的作用不是由其他协变量完全解释。
这时才可以更稳妥地写成“独立预后因素”或“独立危险因素”。
3.3 临床研究里常见的模型顺序
规范的分析顺序通常是这样的。
- 描述基线特征。
- 做单因素Cox回归。
- 将候选变量纳入多因素Cox回归。
- 必要时做亚组分析。
如果研究对象是治疗因素,比如化疗、靶向治疗、手术方式,多因素Cox尤其重要 。因为治疗选择本身往往和分期、年龄、体能状态有关。
不控制这些因素,容易高估治疗效应。
4. 实操时最容易出错的地方
4.1 把分类变量和连续变量混淆
Cox模型对变量类型很敏感。
年龄一般作为连续变量处理,但分期、性别、治疗方式通常是分类变量。
如果编码错误,结果会失真。
例如,分期如果被错误地当成连续变量,模型会默认I、II、III、IV之间存在等距关系,这未必合理。
变量类型的处理,直接决定结果解释是否成立。
4.2 样本量不足会让亚组分析不稳
亚组分析常用于进一步解释不同人群中的效应差异。
但亚组一拆分,样本量会下降,置信区间会变宽,结果更容易不稳定。
尤其是总样本只有百例左右时,亚组结果要非常谨慎。
如果样本量小,亚组中出现“显著”和“不显著”的波动,可能只是随机误差。
所以亚组分析适合补充解释,不适合替代主分析。
4.3 只看P值,不看HR和CI
这是最常见的写作误区。
P值只能说明统计显著性,不能说明效应大小。
HR和95%CI才是判断临床意义的重要依据。
举例来说,HR为0.98,即使P值显著,实际效应也可能非常有限。
相反,HR为0.40但样本较小、CI较宽,也需要谨慎解释。
科研写作里,P值、HR、CI必须一起看。
5. 论文写作中如何表达Cox回归结果
5.1 单因素部分要写得清楚
单因素Cox回归结果一般需要说明。
- 分析了哪些变量。
- 哪些变量达到显著性。
- HR、95%CI、P值分别是多少。
表格里建议统一格式。这样审稿人更容易快速判断。
如果变量很多,正文只强调关键变量,完整结果放表格。
5.2 多因素部分要突出“独立”
多因素部分的重点,不是重复单因素结果,而是回答一个问题。
在控制混杂后,这个变量还能不能独立影响生存?
因此,写作时可以直接围绕“独立预后因素”展开。
如果变量在多因素中仍显著,就说明它具有较强的解释力。
如果消失了,也要如实报告。负结果同样有价值。
5.3 结果图建议配森林图
森林图很适合呈现Cox回归。
它可以直观看出每个变量的HR、CI和显著性。
在临床论文中,森林图常与单因素和多因素表格一起出现,形成完整证据链。
图表的目的不是装饰,而是让读者一眼看懂变量效应。
6. 研究设计中如何把分析做得更稳
6.1 先定义问题,再选模型
不是所有问题都适合直接上Cox。
如果研究终点是二分类结局,更适合Logistic回归。
如果研究终点是生存时间和删失信息,才适合Cox回归。
这一步如果错了,后续再复杂的统计也没意义。
所以建模前要先明确研究终点、变量类型和数据结构。
6.2 尽量控制混杂因素
临床研究中,混杂几乎不可避免。
年龄、分期、治疗方案、合并症,都会影响生存。
因此,多因素Cox是标准配置,而不是可选项。
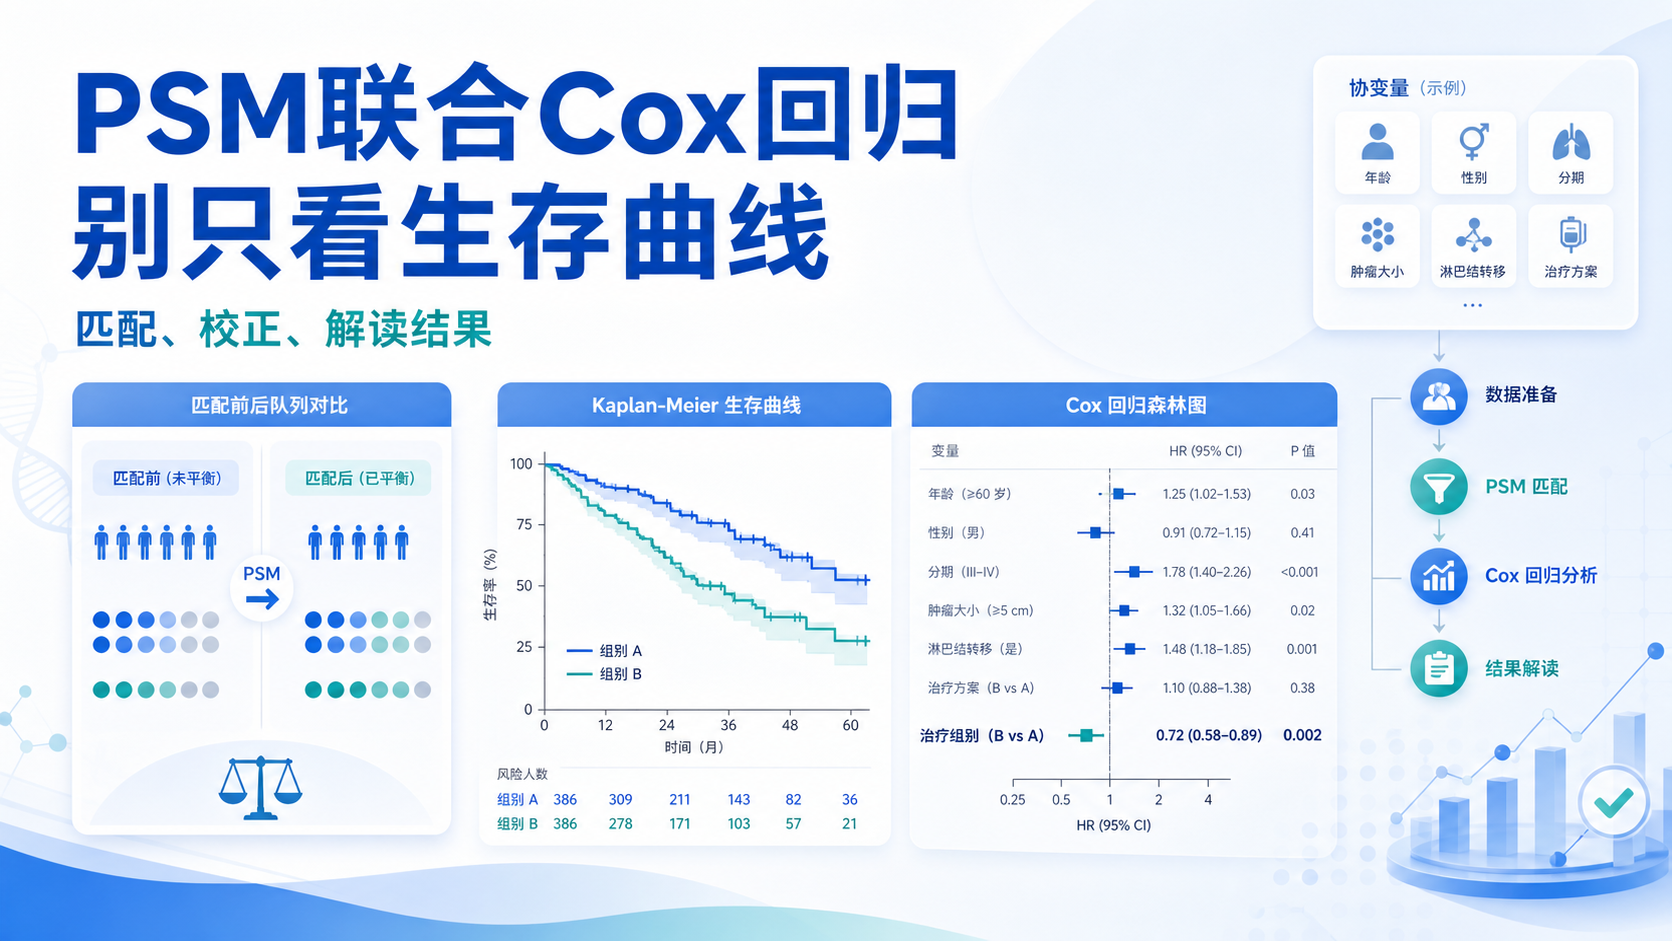
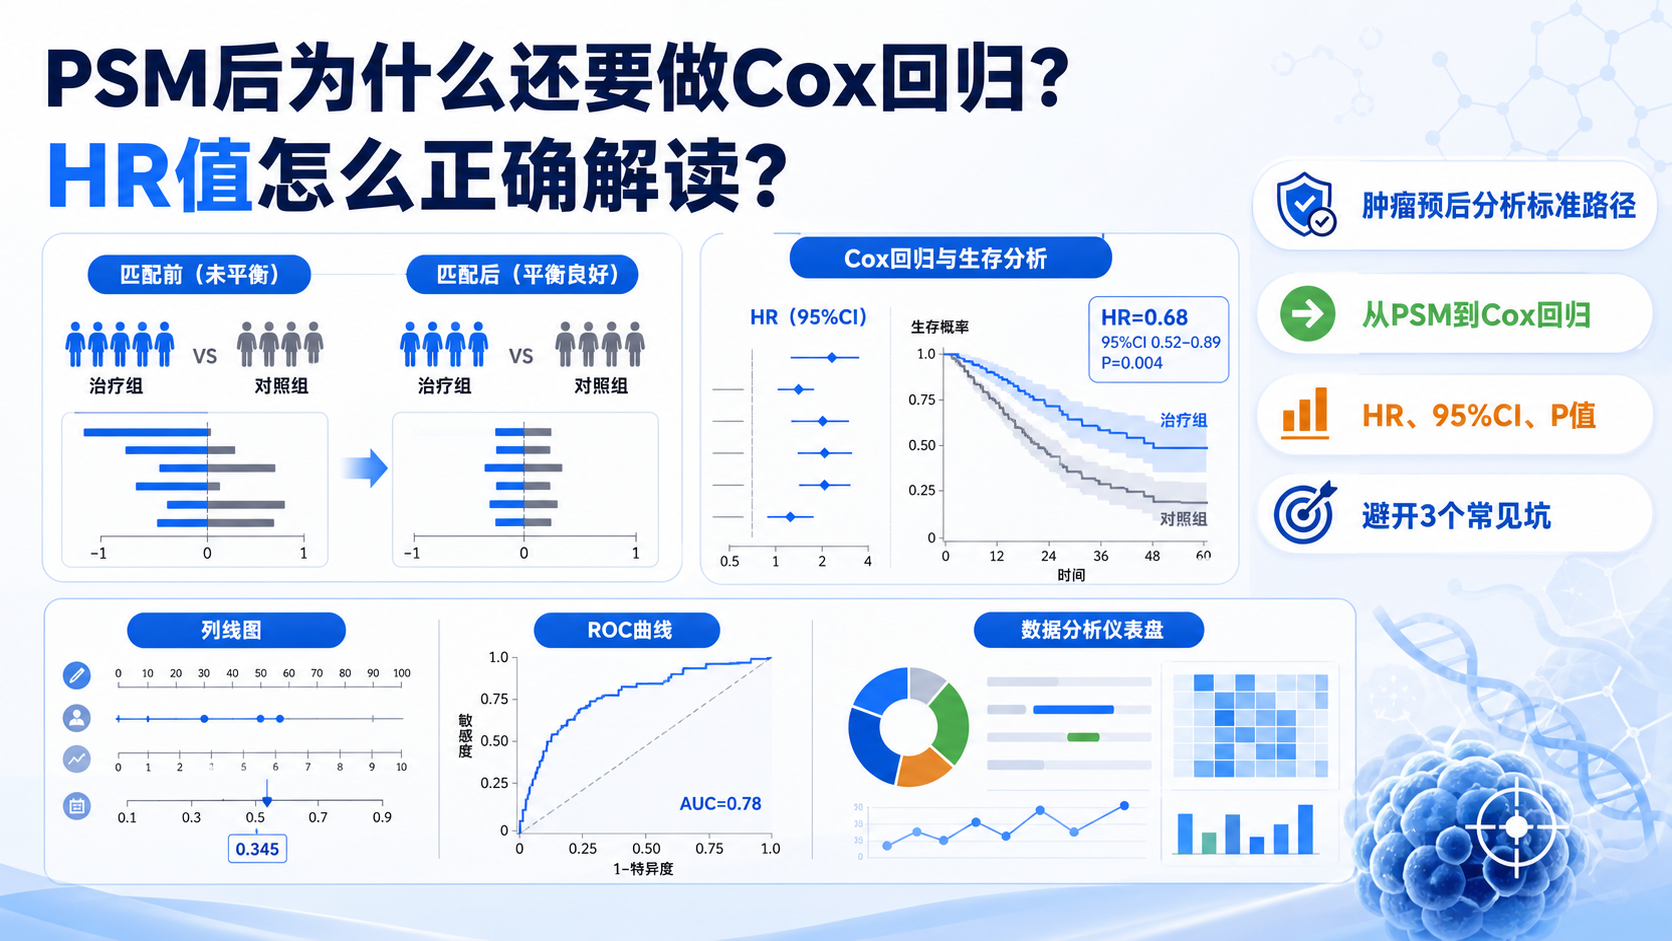
如果研究资源允许,还可以考虑倾向性评分匹配、分层分析等方法,进一步减少偏倚。
但无论采用哪种方法,核心原则不变。
先控制混杂,再谈独立效应。
6.3 用规范流程提升可信度
一篇可靠的生存分析文章,通常要满足这些条件。
- 结局定义清楚。
- 协变量选择有临床依据。
- 单因素和多因素逻辑一致。
- 结果报告完整。
- 图表与文字互相印证。
这样写出来的文章,更符合E-E-A-T要求,也更容易通过审稿。
对科研人员来说,这比单纯追求显著性更重要。
总结Conclusion
Cox回归单因素分析适合筛查候选变量,多因素Cox回归适合判定独立预后因素。前者回答“有没有关联”,后者回答“是不是独立作用” 。在临床研究中,只有把两者结合起来,才能避免混杂偏倚,得出更可信的结论。
如果你正在做生存分析、论文投稿或项目汇报,想把Cox回归结果整理得更规范,可以借助解螺旋的专业支持,提升分析效率和写作质量。

- 引言Introduction
- 1. 为什么Cox回归必须分单因素和多因素
- 2. Cox回归单因素分析怎么做
- 3. 从单因素走向多因素,如何判定独立因素
- 4. 实操时最容易出错的地方
- 5. 论文写作中如何表达Cox回归结果
- 6. 研究设计中如何把分析做得更稳
- 总结Conclusion