20
 分享
引言Introduction
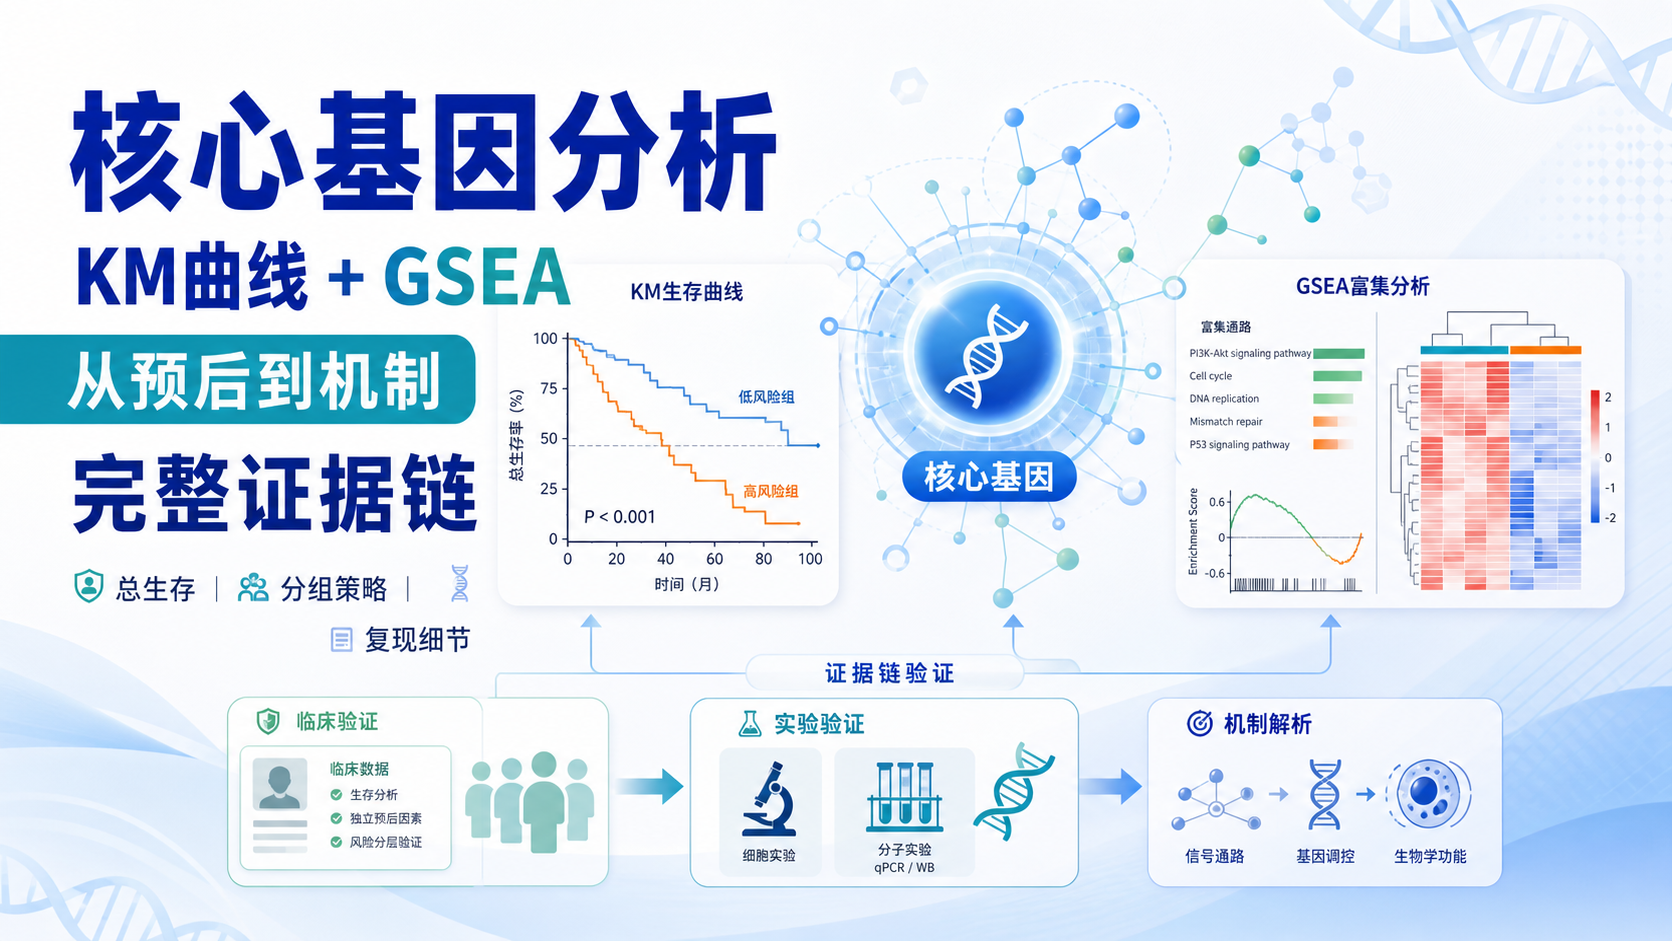
总生存KM曲线和GSEA聚类,是核心基因功能验证中最常见,也最容易出结果偏差的两步。很多研究能筛到基因,却卡在“怎么证明它和预后、通路真有关”。本文用可复现的思路,梳理KM生存分析与GSEA结果解读的关键要点。
1. 为什么核心基因分析离不开总生存KM曲线
1.1 KM曲线回答的是“这个基因是否影响患者结局”
在肿瘤转录组研究中,核心基因筛选之后,第一步通常不是直接下结论,而是看它是否与生存相关。总生存KM曲线的作用,就是把基因表达分组和患者死亡时间联系起来。
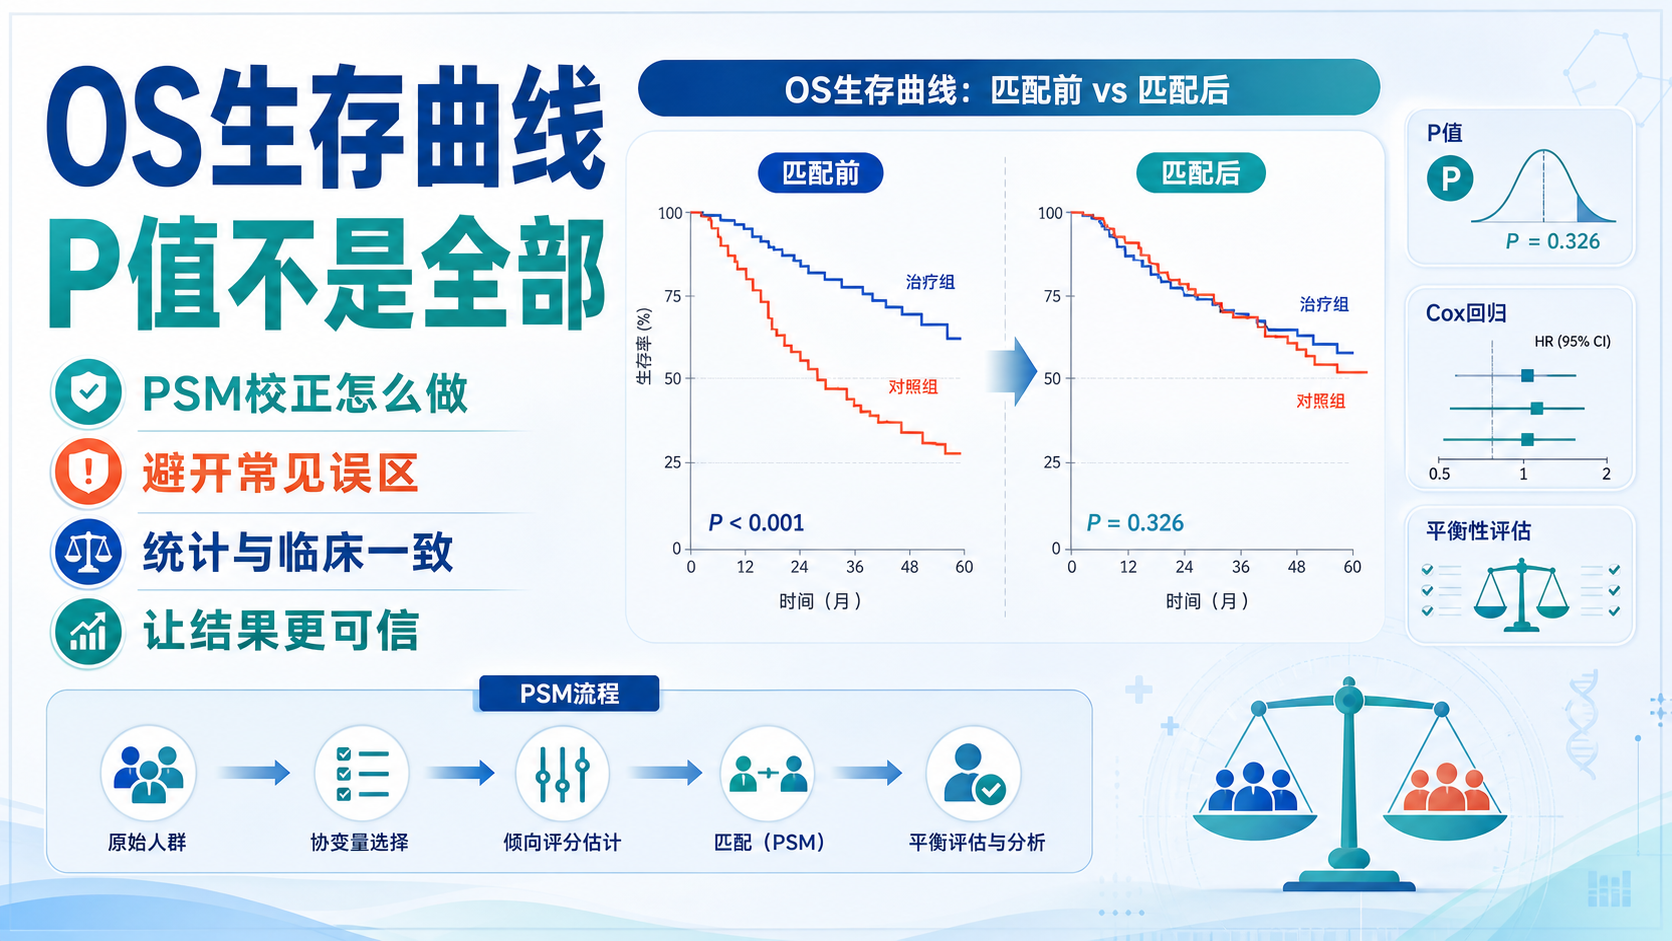
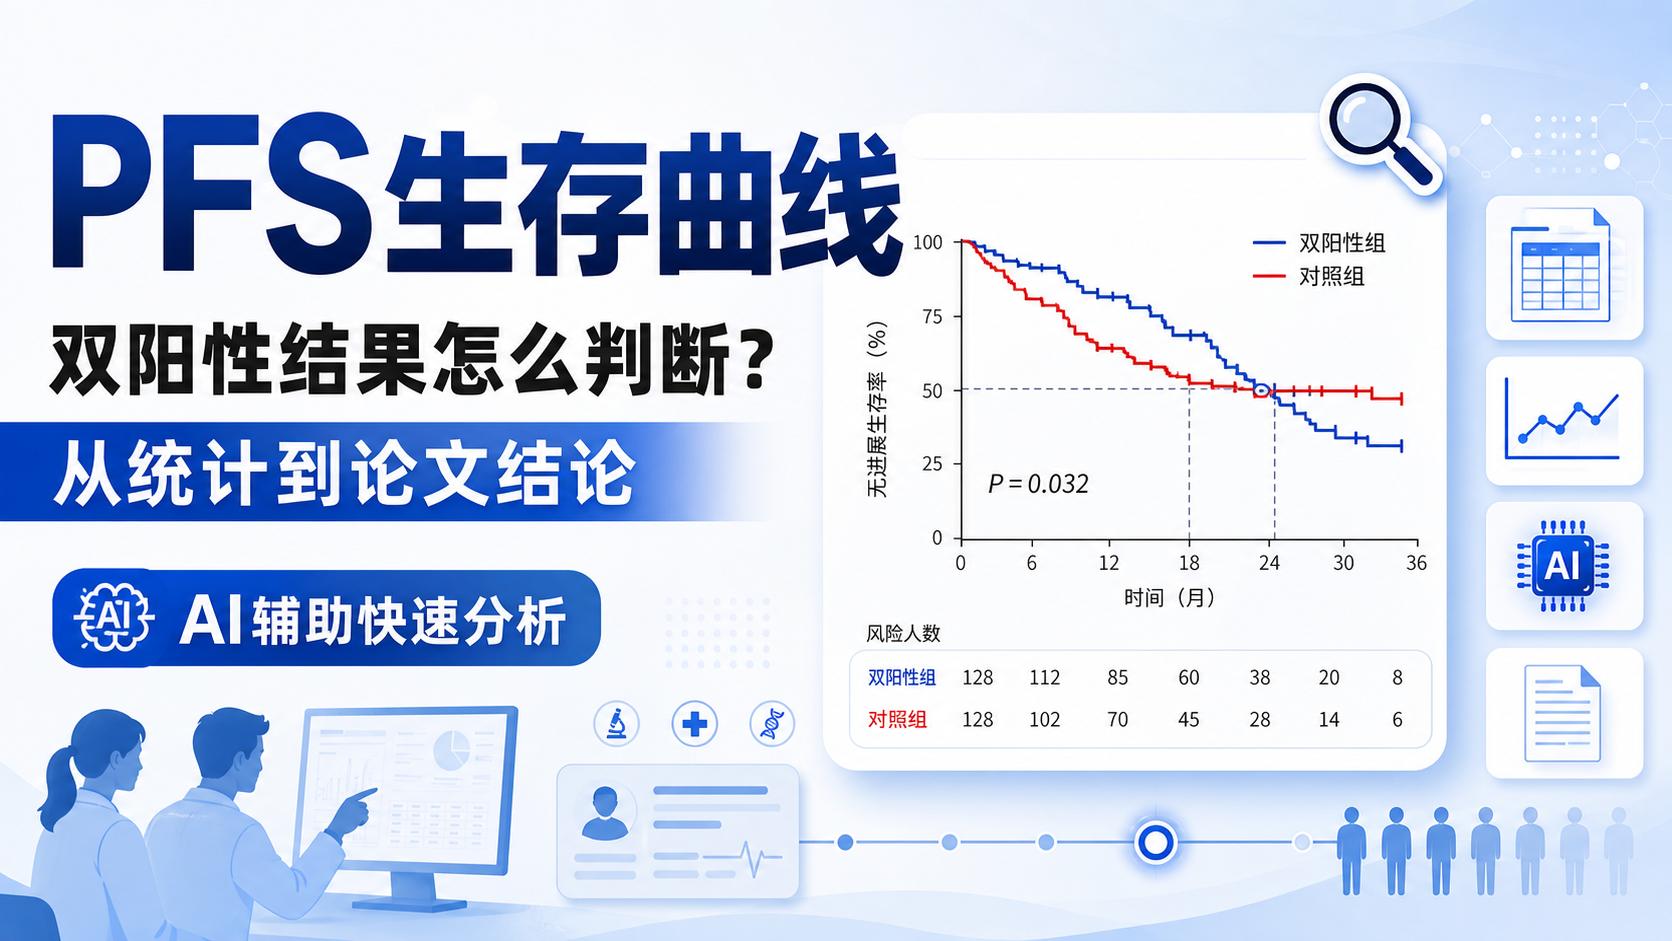
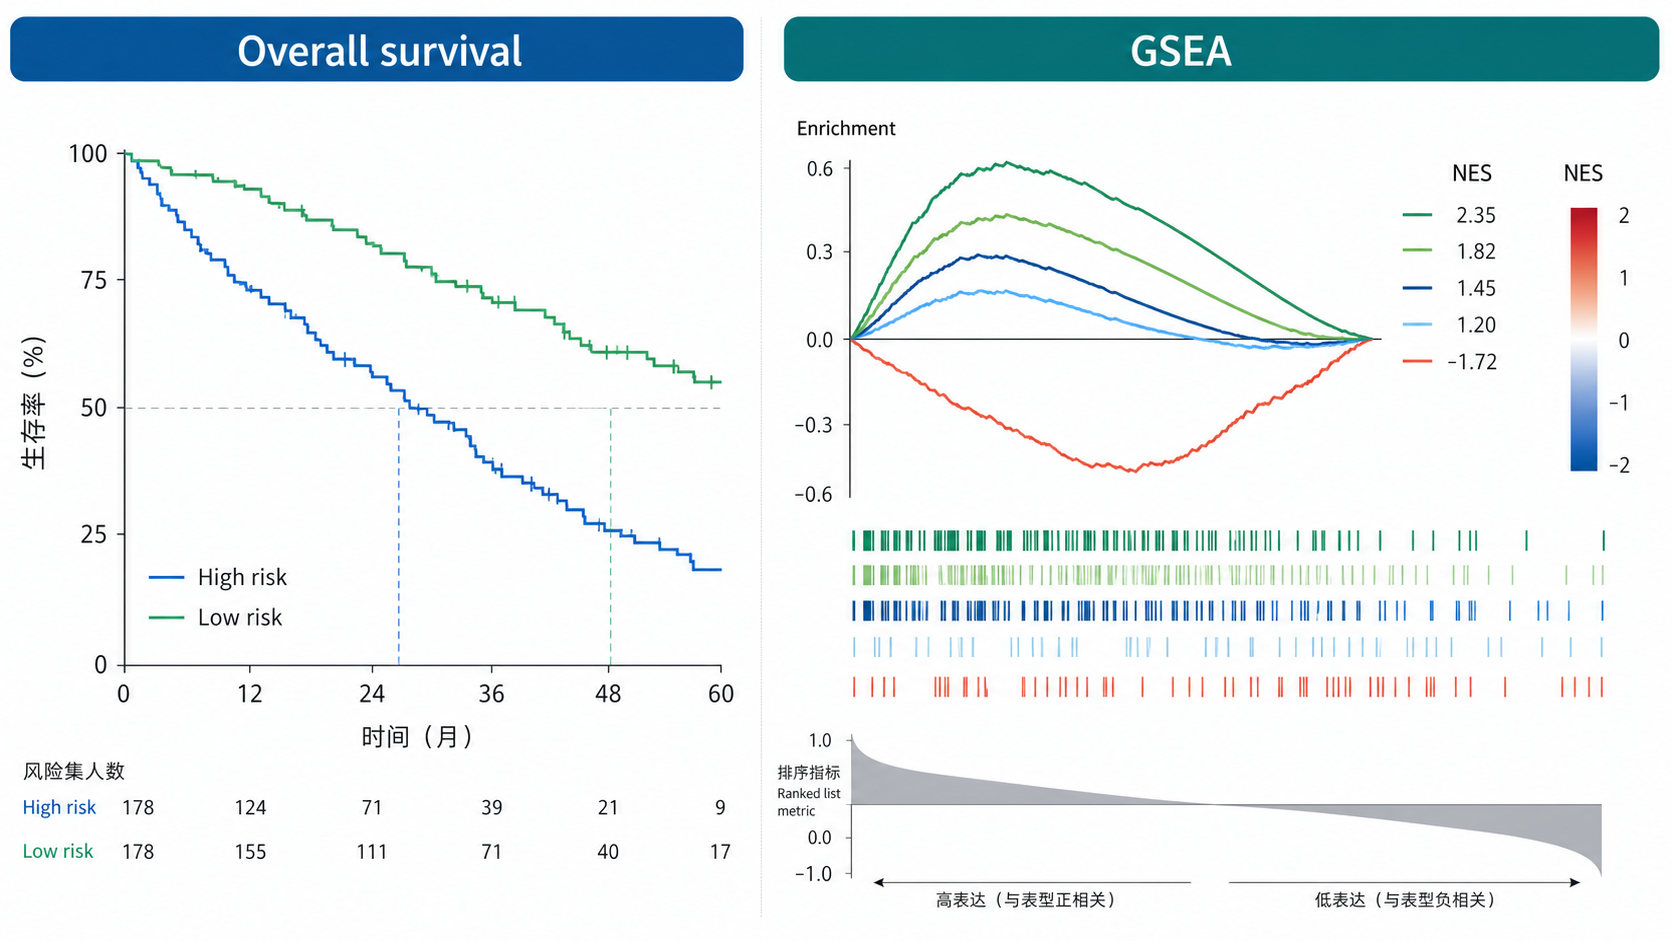
常见做法是按中位数将样本分为高表达组和低表达组,再比较两组生存差异。若曲线明显分离,并且log-rank检验有统计学意义,说明该基因可能具有预后价值。
1.2 需要重点看3个指标
KM图不是只看一条曲线。更严谨的判断至少包括以下内容。
- 曲线是否分离。 两组生存概率随时间是否明显拉开。
- P值是否显著。 常用log-rank检验,P<0.05才具备初步统计学意义。
- 样本是否足够均衡。 分组后两组样本量差距过大,结论容易不稳。
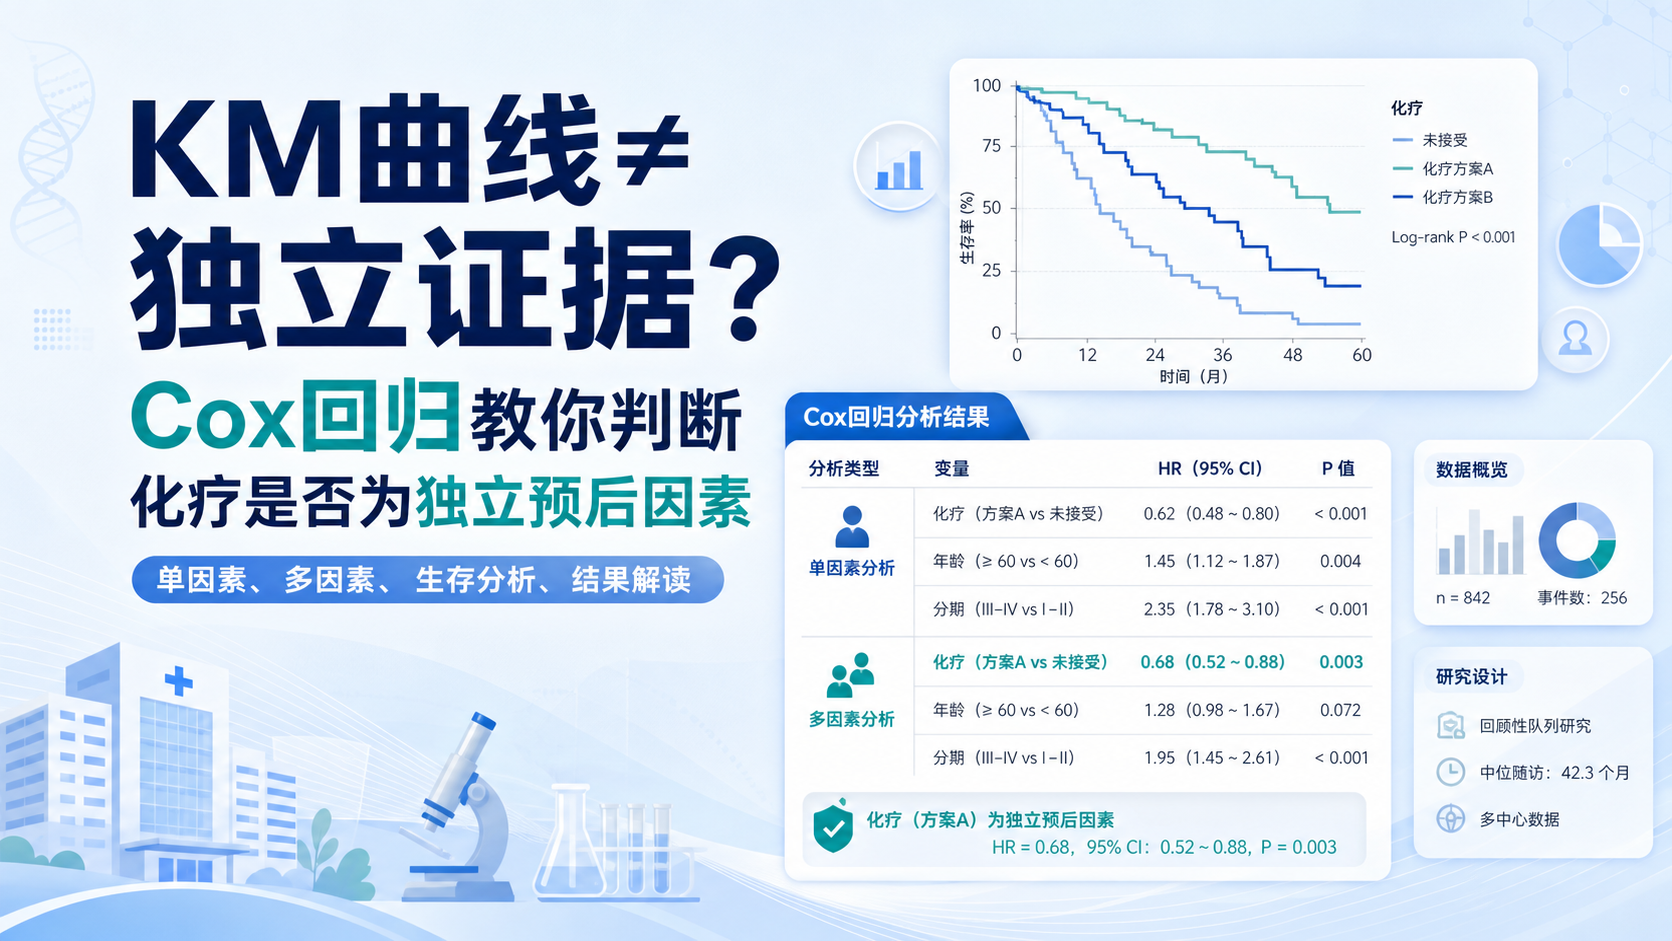
如果进一步结合单因素和多因素Cox回归,就能判断该基因是否独立于年龄、分期、分级等临床变量。这一步非常关键,因为KM曲线只能说明相关性,不能单独证明独立预后价值。
1.3 结果解释要避免两个常见误区
很多文章在KM图上容易出现两个问题。
- 只看P值,不看效应方向。 例如高表达组生存更差,才支持“风险基因”的表述。
- 只做一个分割点。 中位数分组最常见,但并不是唯一选择。若样本分布偏斜,也可考虑四分位数或最佳截点,但要避免过度拟合。
2. 核心基因做总生存KM曲线前,先完成这三步
2.1 先确认表达矩阵和临床数据能对上
KM分析最容易出错的地方,不是统计方法,而是样本匹配。
必须保证以下信息一致:
- 样本ID能一一对应。
- 生存时间单位统一,常见为天或月。
- 结局状态明确,通常是生存或死亡标记。
如果表达矩阵和临床信息没有正确合并,后面的KM曲线即使画出来,也没有可信度。
2.2 再决定分组策略
核心基因通常有三种分组方式。
- 中位数分组。 最稳妥,最常用于初筛。
- 四分位数分组。 适合样本量较大时观察剂量效应。
- 最佳截点分组。 适合探索,但必须谨慎解释。
对于医学生和科研人员来说,中位数分组最适合用于论文主图 ,因为方法透明、重复性高,审稿人也更容易接受。
2.3 再判断图形是否具有临床意义
KM曲线的价值,不只在统计学显著,还在临床可解释性。
如果高表达组在随访早期就出现明显下降,说明这个核心基因可能与肿瘤侵袭、转移或耐药相关。
如果两组只是末端轻微分离,尽管P值显著,也要谨慎,因为临床效应可能有限。
3. GSEA聚类解析:从差异基因走向机制解释
3.1 GSEA的核心优势是“看整体趋势”
和只筛差异基因的富集分析不同,GSEA不依赖单个基因是否达到阈值。它关注的是一组功能相关基因是否在排序列表中整体靠前或靠后。
这使它特别适合核心基因研究,因为很多时候,机制变化不是由某一个基因驱动,而是由整条通路协同变化。
GSEA结果中最关键的指标包括:
- NES。 归一化富集分数,用来比较不同基因集的富集强度。
- NOM p-value。 名义P值,反映富集显著性。
- FDR q-value。 多重检验校正后结果,通常更重要。
- Leading edge genes。 对富集贡献最大的核心子集。
一般来说,NES绝对值越大,说明通路偏移越明显。
3.2 经典GSEA图里要读懂哪三部分
一张标准GSEA图,通常包含三层信息。
- 上方的富集曲线。 观察峰值位置,判断通路是在排序顶部还是底部富集。
- 中间的黑色竖线。 表示该基因集成员在全部基因排序中的分布位置。
- 底部的排序统计量。 反映高低表达样本中基因的整体变化方向。
峰值靠左,通常表示该通路在高表达表型中富集。峰值靠右,则更偏向低表达表型。
3.3 聚类结果不是“好看”,而是为了找机制主题
很多文章会把GSEA结果做成热图或聚类图。这个步骤的目的,不是单纯展示,而是把相似通路归到一起。
比如细胞周期、DNA复制、修复相关通路常常聚为一类,免疫浸润、炎症反应相关通路又可能聚为另一类。
聚类的意义在于:帮助研究者从“单条通路”上升到“机制模块”。
这比零散列出几个显著通路更有解释力,也更符合E-E-A-T中的专业性要求。
4. 从KM曲线到GSEA,如何形成完整证据链
4.1 先证明“有预后价值”
总生存KM曲线回答的是:这个核心基因是否和患者结局有关。
如果高表达组和低表达组存在显著差异,就说明它不是普通背景基因,而是值得继续研究的候选标志物。
4.2 再证明“有生物学机制”
GSEA回答的是:这个核心基因为什么会影响预后。
例如,如果高表达组富集在细胞周期、DNA修复、E2F靶基因或MYC相关通路,往往提示其可能参与增殖驱动。
如果富集在免疫相关通路,则提示其可能影响肿瘤微环境。
4.3 最后补上临床和实验验证
一个完整的核心基因故事,通常要至少完成以下链条:
- 表达差异。
- 总生存KM曲线。
- Cox回归分析。
- GSEA通路富集。
- 必要时加入免疫浸润或实验验证。
只有把预后价值和通路机制连起来,文章才算真正闭环。
5. 复现这类分析时,最容易忽略的细节
5.1 统计阈值要统一
GSEA中常见的参考标准是:
- NES绝对值较大。
- NOM p-value < 0.05。
- FDR q-value尽量更低。
但阈值不是机械套用。不同数据库、不同样本量、不同分组方式,结果都会变化。解读时要结合生物学背景,而不是只盯着显著性。
5.2 图形美观不等于结果可靠
KM图和GSEA图都很容易“画得漂亮”,但这不代表结论扎实。
真正重要的是:
- 分组规则是否合理。
- 样本是否配对正确。
- 通路是否与肿瘤生物学一致。
- 是否存在过拟合风险。
5.3 文章复现要保留原始参数
无论是R包,还是在线工具,复现时都要记录:
- 数据来源。
- 分组阈值。
- 随机种子。
- 富集数据库版本。
- 校正方法。
这些细节决定结果能否被重复。
总结Conclusion
核心基因研究的关键,不只是找到差异表达,而是建立“表达变化,预后变化,机制变化”的完整证据链。总生存KM曲线用于证明临床相关性,GSEA聚类用于解释生物学机制。 两者结合,才能让核心基因的研究更有说服力。
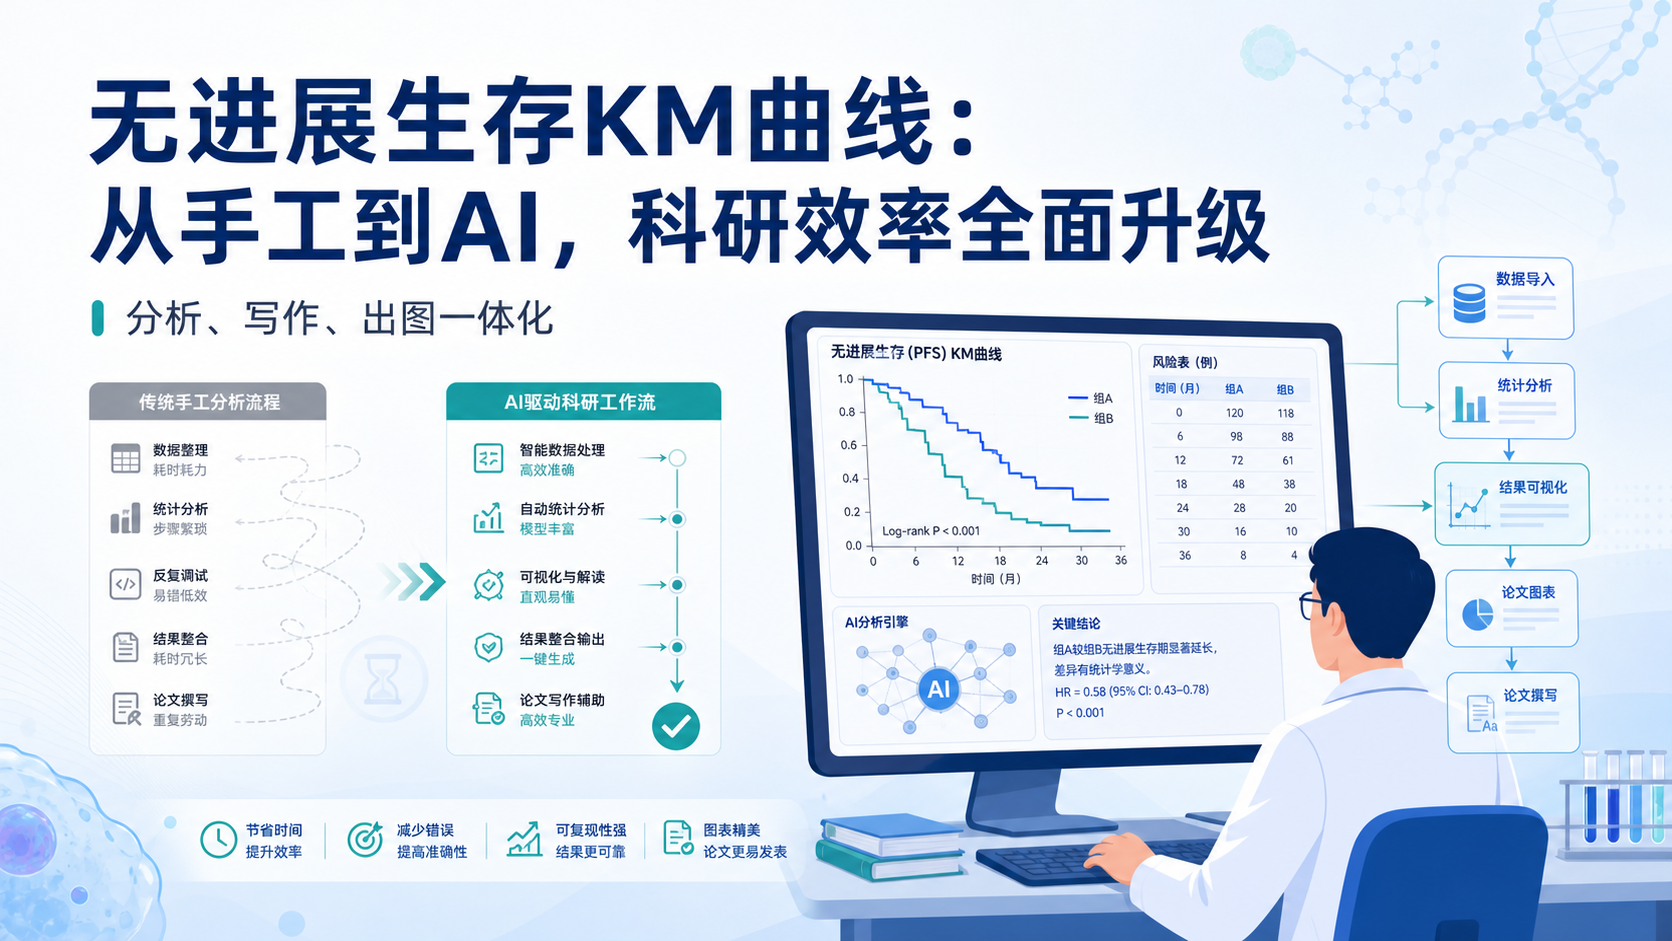
如果你正在整理单基因预后文章、复现KM曲线或GSEA结果,建议直接使用标准化流程提升效率。解螺旋 可帮助你更高效地完成数据整理、图表复现和结果解读,让核心基因分析更接近可发表标准。

- 引言Introduction
- 1. 为什么核心基因分析离不开总生存KM曲线
- 2. 核心基因做总生存KM曲线前,先完成这三步
- 3. GSEA聚类解析:从差异基因走向机制解释
- 4. 从KM曲线到GSEA,如何形成完整证据链
- 5. 复现这类分析时,最容易忽略的细节
- 总结Conclusion