26
 分享
引言Introduction
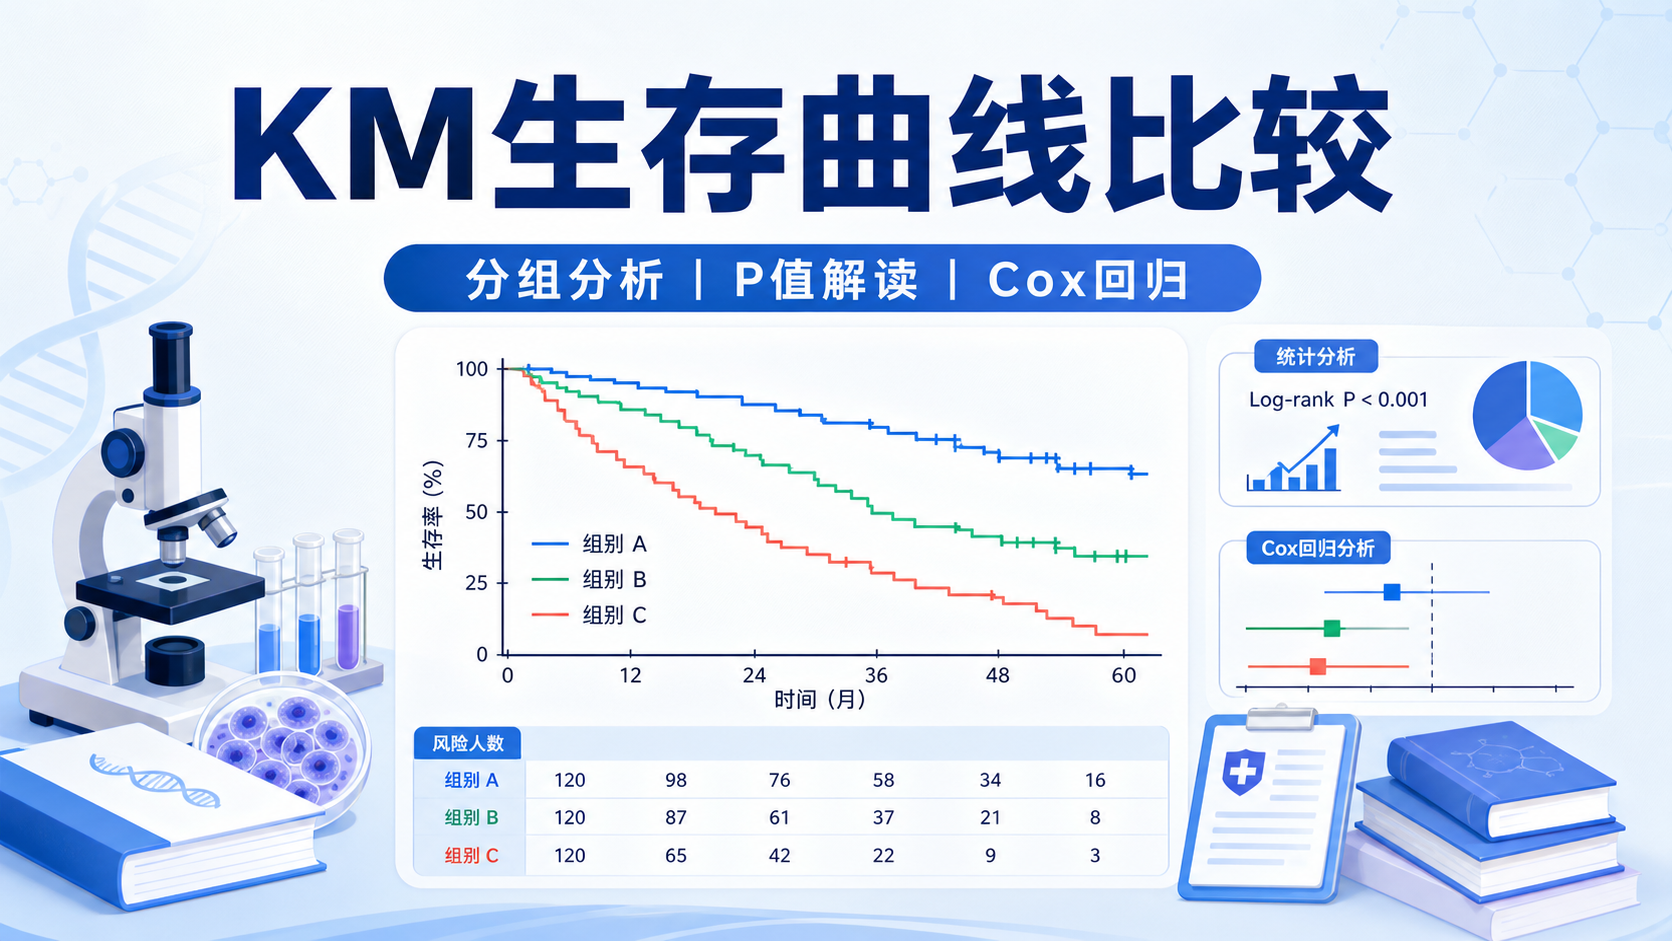
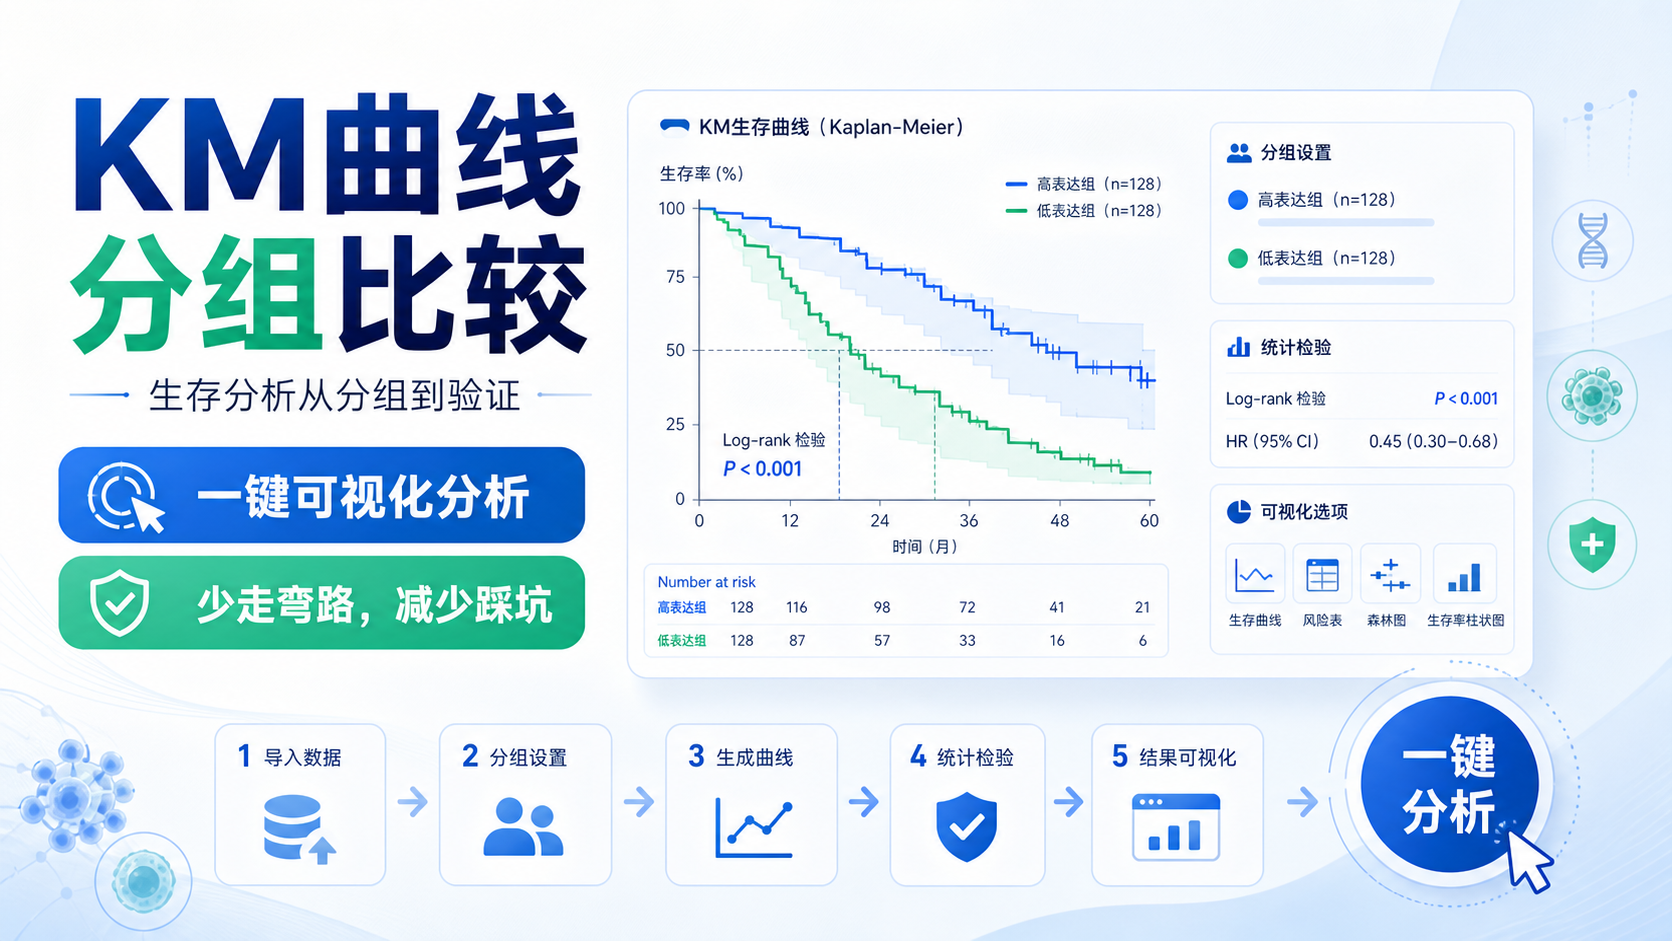
KM曲线分组比较,是生存分析里最常见,也最容易出错的一步。分组方法不当,曲线再漂亮也可能被审稿人质疑。如果你想快速完成分组、出图和组间检验,又不想反复写代码,仙桃工具能显著降低门槛。
1. KM曲线分组比较到底在做什么
1.1 生存分析的核心不是“有无”,而是“时间”
KM曲线分组比较,本质上是在比较不同组的生存概率随时间如何变化。它不是单纯看患者是否发生事件,而是同时考虑了事件发生的时间。
在临床研究中,终点可以是死亡、复发、进展、转移,甚至是某个特定结局的发生。只要研究问题包含“时间到事件”,KM曲线就有价值。
这也是它在肿瘤、预后标志物和药物疗效研究中最常用的原因。
1.2 为什么分组一步错,后面全都错
KM曲线分组比较常见的错误有三个。
- 分组阈值随意。
- 结局事件编码错误。
- 组间样本量严重不均衡。
比如把连续变量简单按中位数切分,虽然方便,但可能丢失信息。若分组边界缺乏临床或统计学依据,结果容易被认为是“数据驱动过拟合”。
对医学生、医生和科研人员来说,最重要的不是画出曲线,而是让分组逻辑经得起质疑。
2. KM曲线分组比较的标准流程
2.1 先确认数据结构是否正确
做KM曲线前,先检查三类字段。
- 生存时间,单位要统一。
- 结局状态,必须明确0和1的含义。
- 分组变量,必须来源清晰。
如果是临床随访数据,还要确认失访、退出和中止的记录方式。生存时间记录错误,比画图失败更严重。
因为它会直接影响曲线形态、log-rank检验和后续Cox回归。
2.2 再确定分组策略
常见分组方式包括以下几类。
- 中位数分组。
- 四分位数分组。
- 临床阈值分组。
- 最佳截点分组。
其中,中位数分组最常见,适合初步探索。临床阈值分组更容易解释,适合投稿和转化研究。最佳截点分组看起来“结果最好”,但必须谨慎,因为它更容易引入偏倚。
如果文章目标是发表,优先选择有临床依据的分组。
如果目标是方法学探索,再考虑数据驱动分组,但要交代方法来源和验证策略。
2.3 最后再做曲线和检验
KM曲线通常配合log-rank检验,用于判断组间生存差异是否具有统计学意义。
如果曲线不交叉,log-rank通常是合适的。
如果曲线交叉,就要谨慎,不能只看一个P值下结论。
常规分析建议同时报告:
- 每组样本量。
- 事件数。
- 中位生存期。
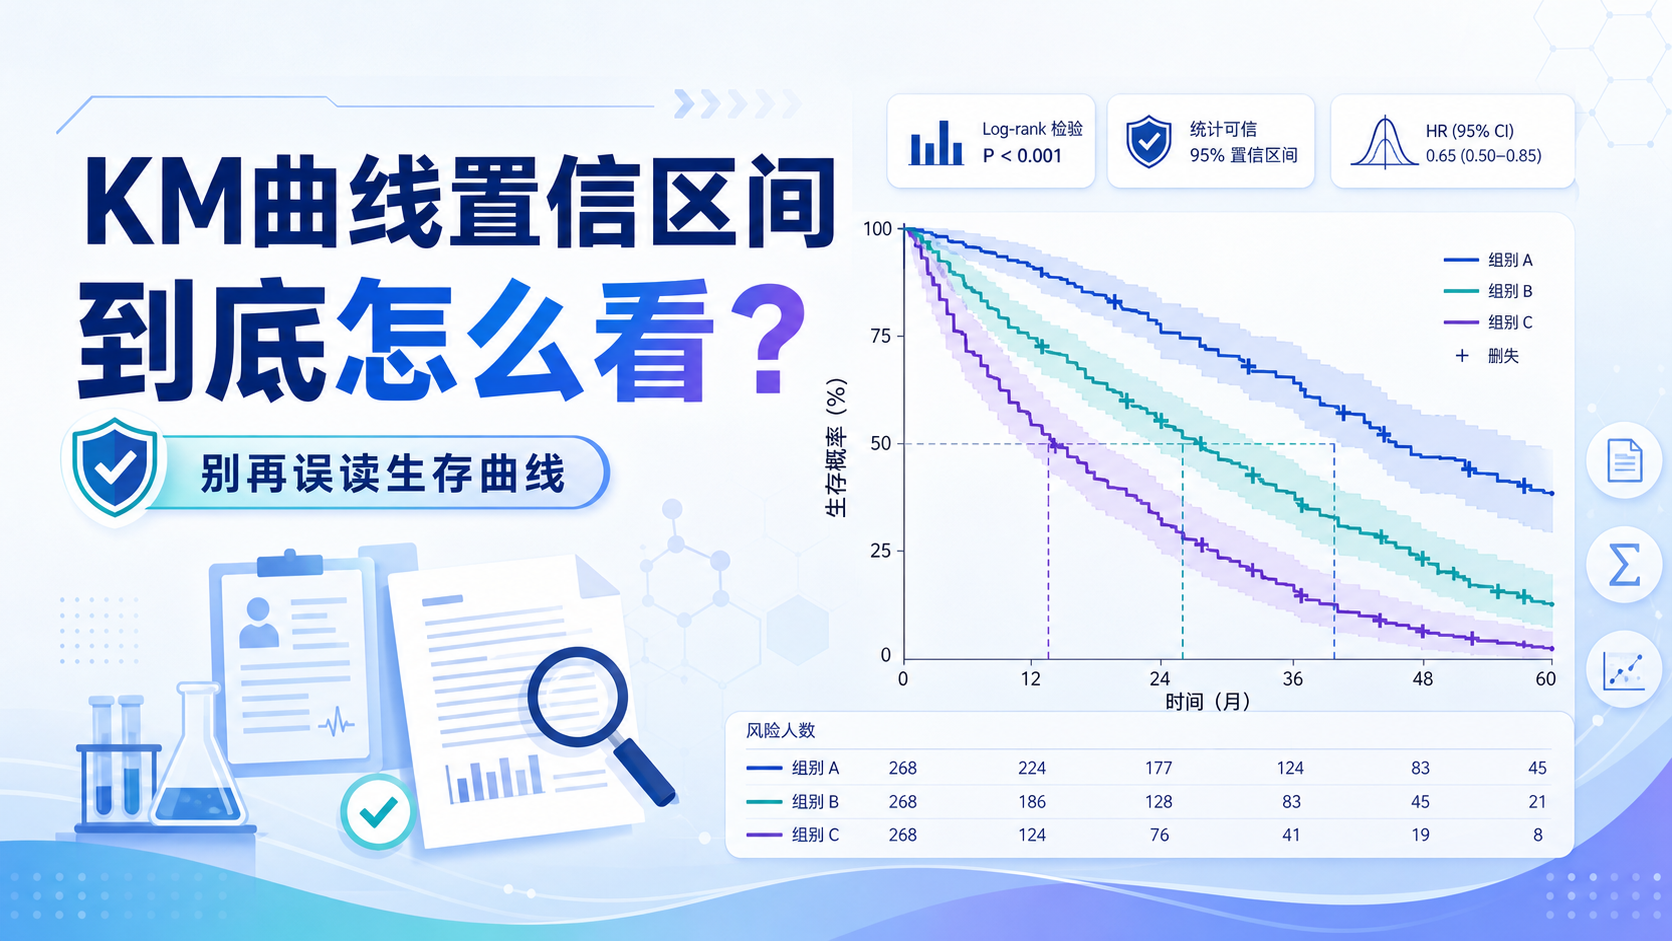
- 95%置信区间。
- log-rank P值。
完整报告比单一P值更能体现科研规范。
3. 仙桃工具如何把KM曲线分组做得更快
3.1 一键生成,减少重复劳动
仙桃工具的优势在于,它把分组比较、KM曲线和常见可视化整合到一个流程里。对于需要反复筛选变量的研究,这种设计非常实用。
从知识库信息来看,仙桃工具支持分组比较,并集成了小提琴图、柱状图、箱线图等常用图形,也支持生成KM生存分析曲线。这意味着你不用在多个软件之间来回切换。
对做预后模型、候选基因筛选、临床指标比较的人来说,效率会高很多。
3.2 可视化界面更适合非编程用户
很多临床研究者并不擅长写代码。传统方法往往要在R、Python或IDE里反复调参,学习成本高,报错也多。
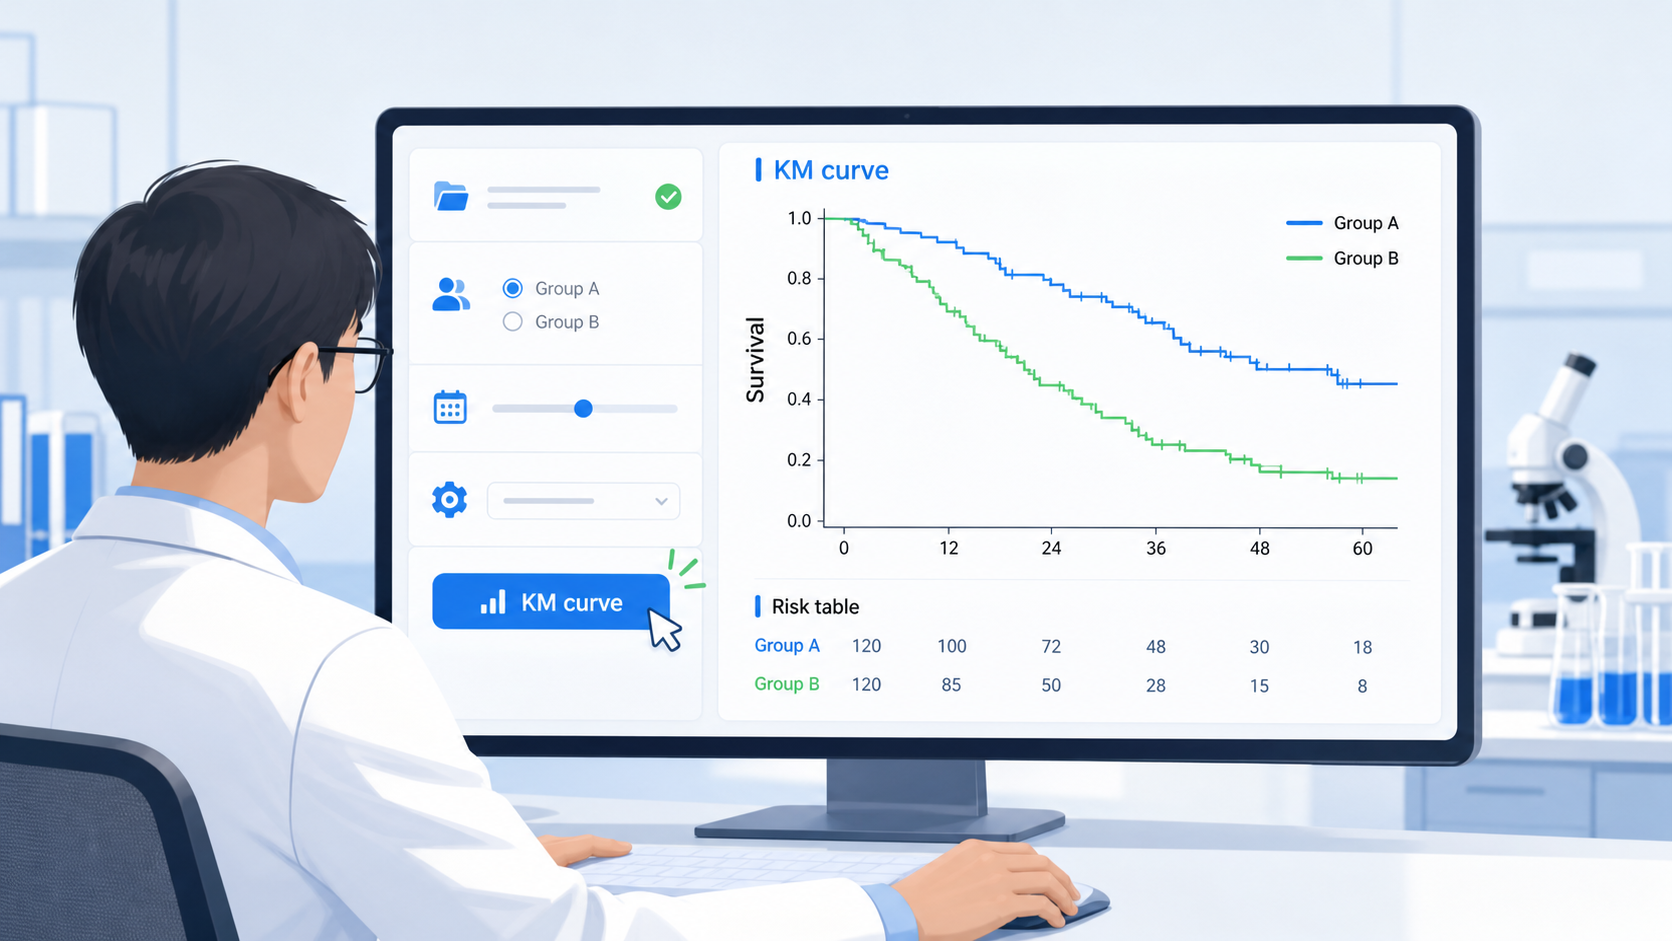
而仙桃工具的价值,在于它把复杂的分析步骤做成更直观的交互式流程。
你只要输入数据,选择分组方式,下达分析指令,系统就能拆分任务、执行并生成结果文件。结果会直接输出到对应文件夹,便于查看差异列表、Top基因和图表。
这类流程尤其适合教学、课题预实验和多变量快速筛选。
3.3 收藏功能适合高频重复分析
很多科研任务不是做一次就结束。
同一批数据,往往要换不同阈值、不同终点、不同分组方式重新跑。
仙桃工具提供收藏功能,方便下次快速使用。这个设计对高频分析很重要。它能减少重复配置步骤,也能降低人为操作失误。
对需要批量做KM曲线分组比较的用户来说,这种效率提升非常明显。
4. KM曲线分组比较时,审稿人最看重什么
4.1 分组依据是否合理
审稿人通常会问三个问题。
- 这个分组为什么这样切。
- 是否存在人为筛选最优结果。
- 结果能否重复。
如果你用最佳截点,一定要说明方法来源。
如果你用中位数分组,要说明这是探索性分析。
如果你有明确临床阈值,更容易被接受。
分组逻辑比图形本身更重要。
4.2 曲线是否存在交叉
知识库中提到,当生存曲线不交叉时,KM和Cox分析通常适用。
但当曲线交叉时,审稿人可能会要求使用其他方法,比如two-stage或landmark分析。
这很关键。因为交叉曲线提示不同时间段里,变量对结局的影响可能不一致。
如果还强行用普通log-rank检验,结论可能不稳健。
所以在做KM曲线分组比较时,要先看图,再谈统计。
不要只盯着P值。
4.3 是否补充多因素验证
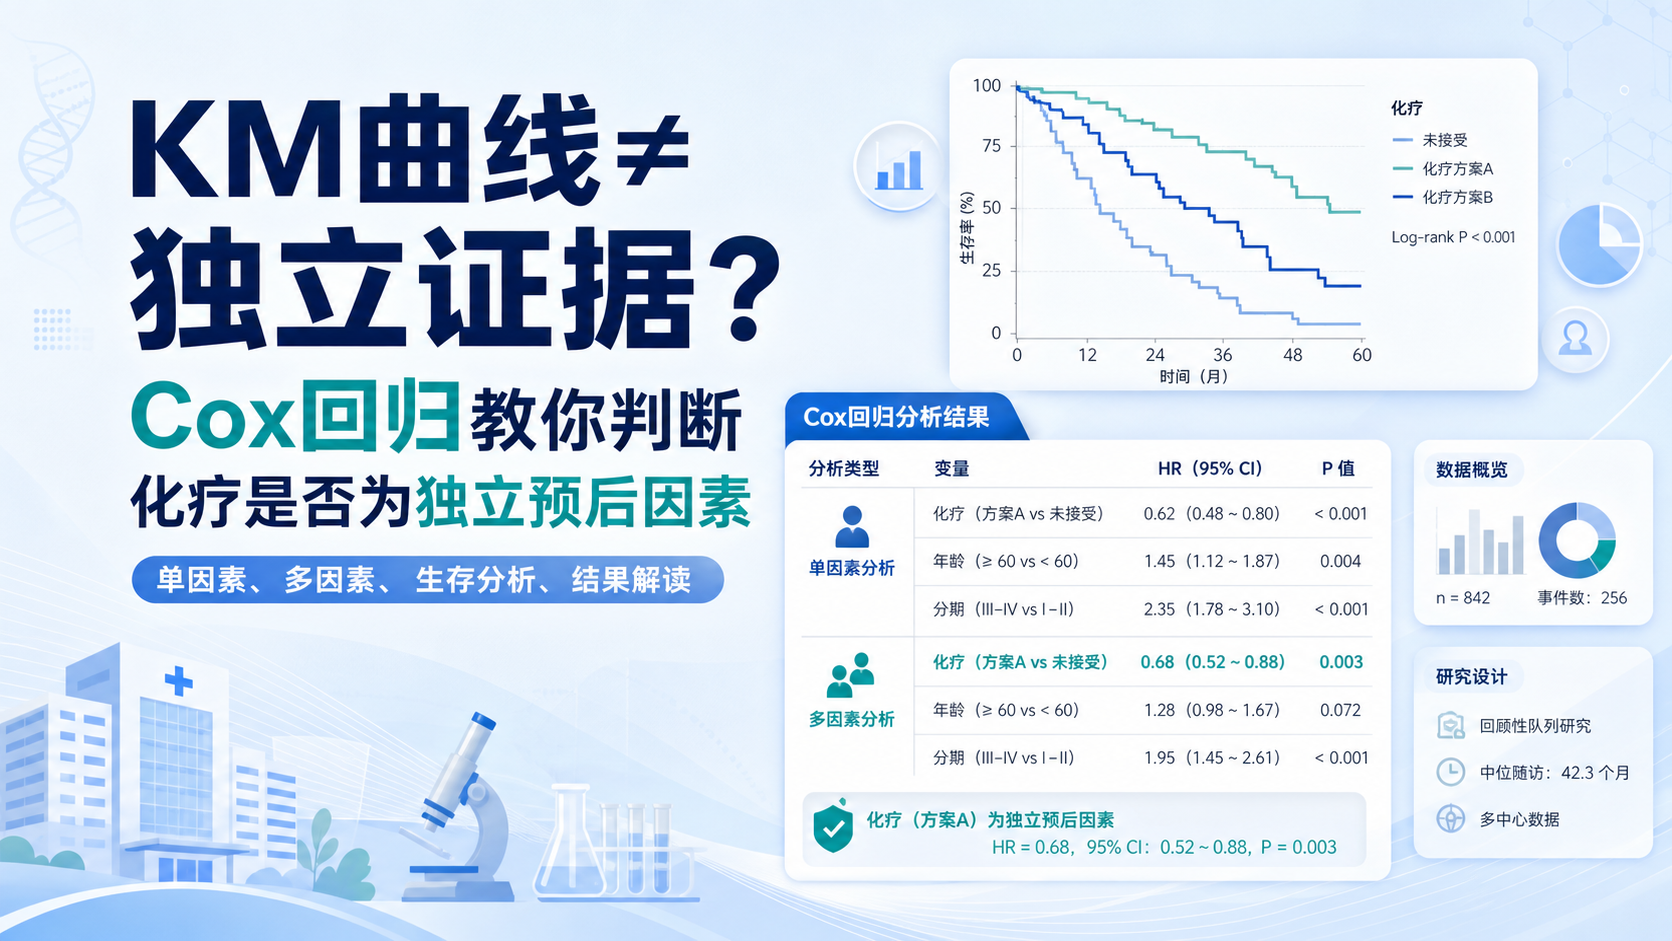
KM曲线分组比较只能说明“组间有差异”。
它不能证明这个变量是独立危险因素。
如果要提高文章可信度,通常还要接着做Cox回归。
单因素分析看关联,多因素分析看独立性。
这样结论才更完整。
5. 适合哪些科研场景
5.1 肿瘤预后研究
这是KM曲线最典型的应用场景。
比如比较高低表达组、不同分型组、不同治疗反应组的生存差异。
对于肺癌、乳腺癌、肝癌等常见肿瘤研究,KM曲线分组比较几乎是标配。
它能快速展示标志物与预后的关系,也能作为文章图1或图2的核心证据。
5.2 临床指标分层分析
很多临床变量都可以做分组比较,比如年龄、分期、炎症指标、实验室参数等。
但前提是分组合理,且样本量足够支撑分析。
如果变量是连续型,建议先考虑临床解释,再决定是否离散化。
盲目切分连续变量,往往会损失统计效率。
5.3 机器学习和多组学筛选后的验证
在差异分析或模型筛选之后,KM曲线常用于验证候选基因或候选特征是否真正具有预后价值。
这一步非常适合与可视化工具结合。
仙桃工具支持一键生成生存分析图,并能配合其他分组图一起使用。
这对做多组学文章、构建签名模型、筛选关键基因都很实用。
6. 实际操作中最容易踩的坑
6.1 样本量太小
KM分析适合小样本,但不是样本越小越好。
如果某组事件数太少,曲线会不稳定,置信区间会变宽,结论也更弱。
一般来说,组间样本量不要差得过于悬殊。
否则即使P值显著,解释起来也会很困难。
6.2 事件定义不统一
同一篇文章里,事件定义必须统一。
不能前面说是总生存,后面又混入无进展生存。
否则曲线没有可比性。
写作时要明确:
- OS,整体生存。
- PFS,无进展生存。
- DFS,无病生存。
终点定义清楚,是KM曲线分组比较的前提。
6.3 结果只画图,不解释
很多初学者喜欢“先出图再说”。
但审稿人更关心的是:
- 为什么这样分组。
- 差异是否稳健。
- 是否有生物学或临床解释。
图只是一部分,解释才是论文的核心。
7. 为什么现在更适合用可视化工具完成生存分析
7.1 从“写代码”转向“描述任务”
知识库里提到了一种新的AI coding模式。
用户不必手写每一步代码,只需给数据并下达指令,系统就能拆解任务、执行并生成结果。
这对生信和临床科研都很有意义。
因为很多人真正缺的不是想法,而是把想法快速变成可发表结果的能力。
自然语言驱动的数据分析,正在降低科研门槛。
7.2 仙桃工具的价值在于流程化
仙桃工具不仅能做KM曲线分组比较,还能把相关图形整合起来。
从探索、比较到出图,流程更连贯。
从使用体验看,这种工具特别适合教学、预实验和批量分析。
如果你正在处理临床队列、转录组数据或预后模型验证,仙桃工具可以帮助你更快完成图表输出。
它把“会不会写代码”从分析门槛里移开了。
总结Conclusion
KM曲线分组比较的关键,不只是画出一条漂亮的生存曲线,而是做到分组合理、事件定义清楚、统计方法匹配。对于医学生、医生和科研人员来说,掌握这些原则,才能让结果更可信,也更容易通过审稿。
仙桃工具把分组比较、KM生存分析和常用可视化整合到一起,适合需要高频出图和快速验证结果的科研场景。如果你希望减少重复操作、提升出图效率,并把更多精力放在研究问题本身,建议直接试用解螺旋的仙桃工具。

- 引言Introduction
- 1. KM曲线分组比较到底在做什么
- 2. KM曲线分组比较的标准流程
- 3. 仙桃工具如何把KM曲线分组做得更快
- 4. KM曲线分组比较时,审稿人最看重什么
- 5. 适合哪些科研场景
- 6. 实际操作中最容易踩的坑
- 7. 为什么现在更适合用可视化工具完成生存分析
- 总结Conclusion