55
 分享
引言Introduction
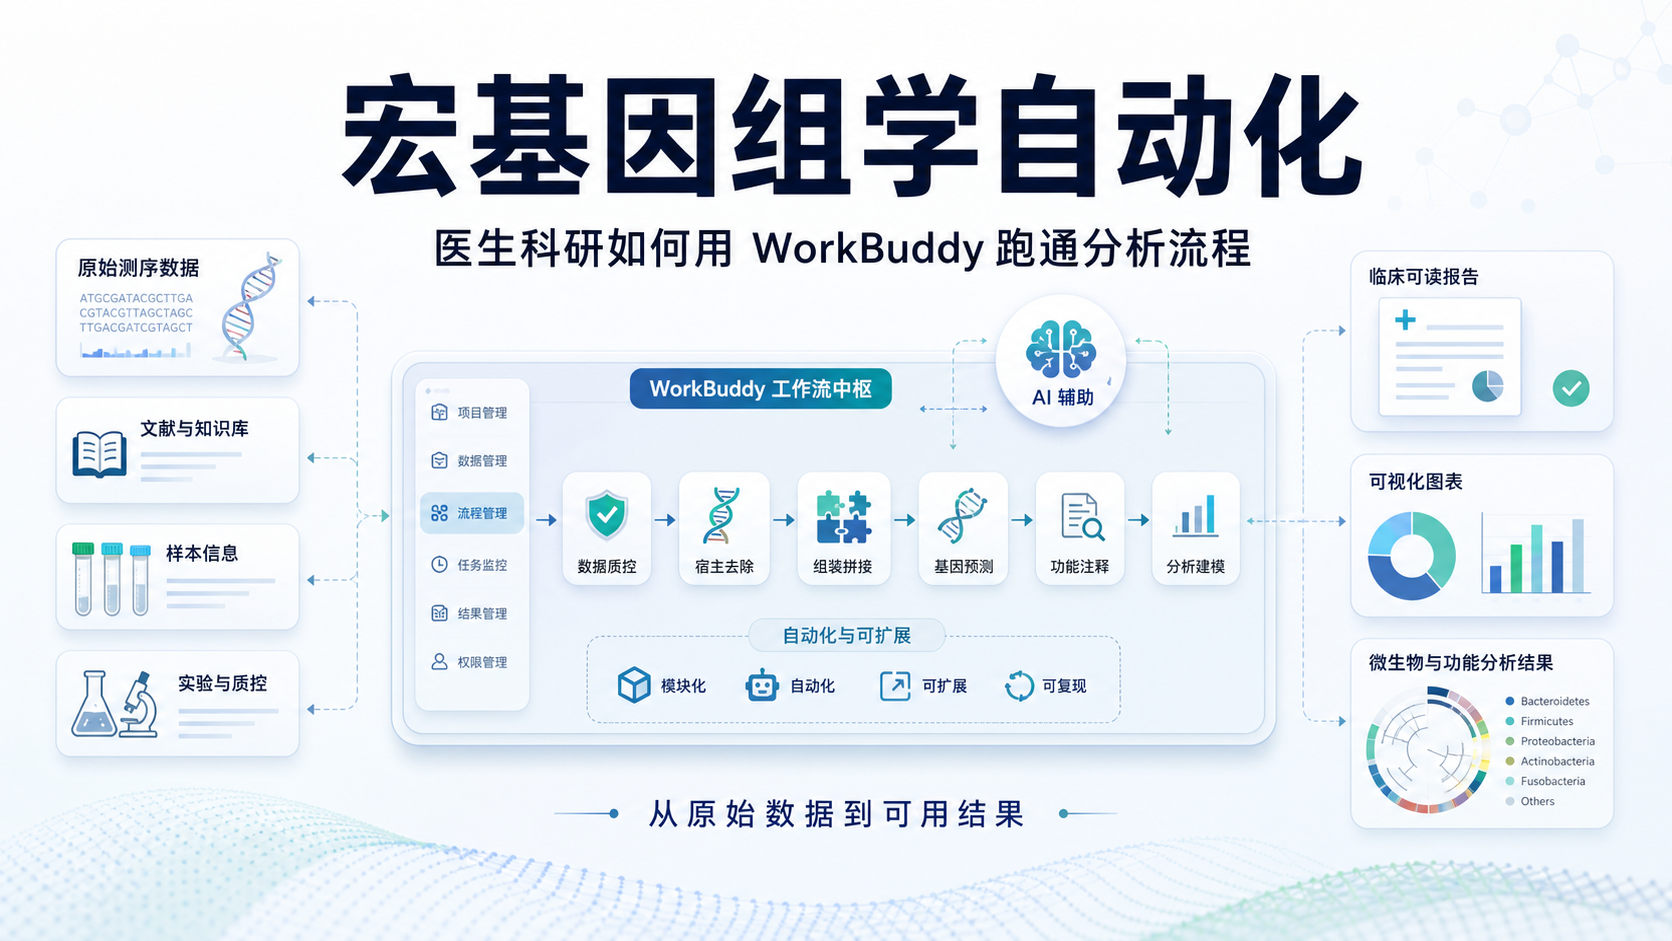
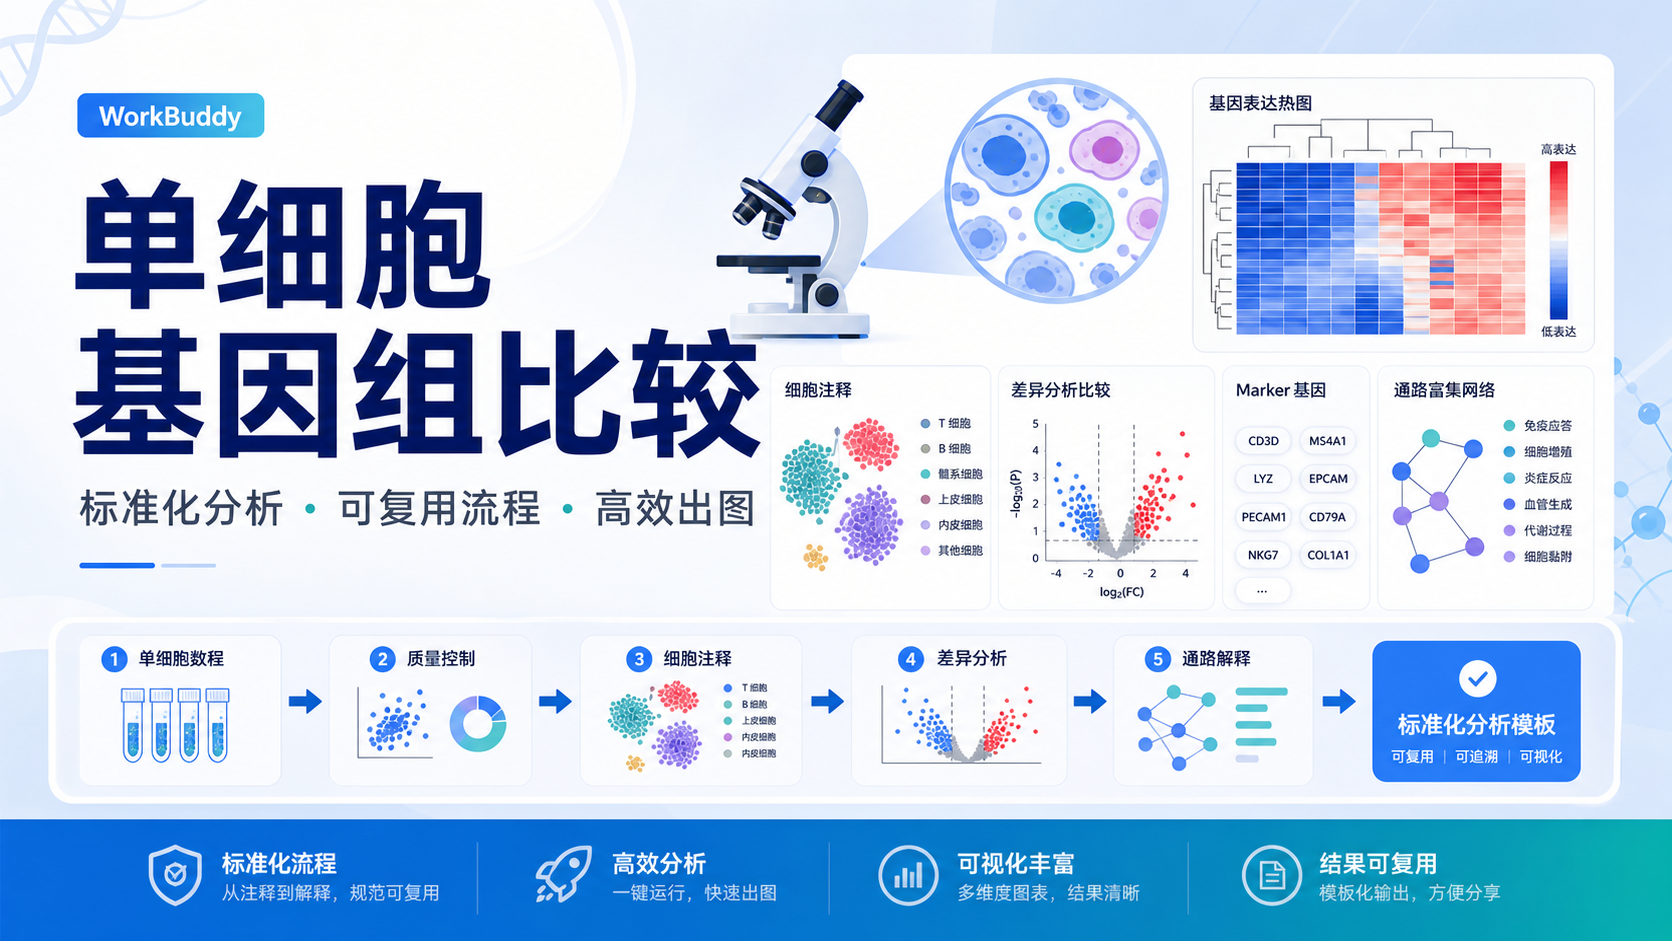
单细胞转录组数据越来越多,但很多人卡在“如何快速比较多个基因组/样本差异”这一步。手工整理耗时,分析套路不统一,结果还难复用。WorkBuddy基因组比较的价值,就在于把分散的数据分析步骤,变成可追踪、可复用的标准流程。
1. 为什么单细胞基因组比较需要新范式
1.1 传统流程的三个痛点
单细胞转录组分析不是缺工具,而是缺流程。很多项目从 Seurat 聚类开始,到差异基因、marker、通路富集,再到图表整理,步骤分散在多个软件和脚本里。对于医学生、医生和科研人员来说,最耗时的往往不是计算,而是重复整理、重复筛选和重复解释 。
更现实的问题是,不同实验室的分析口径不一致。有人做细胞群比较,有人做组间比较,有人只看单个基因表达。比较对象一旦选错,后续结论就可能偏离真实生物学问题。 这也是单细胞数据最常见的误区之一。
1.2 比较的核心不是“画图”,而是“定义问题”
基因组比较在单细胞场景里,真正关键的是先定义比较单位。常见有三种:
- 同一细胞类型在不同组之间比较。
- 同一细胞亚群在处理前后比较。
- 不同聚类之间比较,用于寻找特征 marker。
其中,最有临床和科研意义的,通常是同一细胞类型在疾病组与对照组之间的比较。 例如,B 细胞在治疗前后是否出现免疫激活、迁移、代谢重编程,这类问题比“B 细胞和所有其他细胞比”更有解释力。
1.3 WorkBuddy的意义在于标准化分析套路
从现有知识库看,WorkBuddy 的优势并不是简单生成一个最终结果,而是先提炼分析套路,再向下游延伸到研究方案、学习计划和结果复用 。这比只给出一个静态工作台更灵活。对于新手,它降低了起步门槛。对于高手,它减少了重复劳动。
这就是单细胞转录组分析的新范式:不是一次性作图,而是把分析逻辑沉淀成可复用流程。
2. WorkBuddy基因组比较在单细胞分析中的位置
2.1 从聚类到比较,决定结果上限
在单细胞分析中,聚类只是起点。实际研究里,真正需要回答的是“哪些细胞在变化,为什么变化”。如果只停留在聚类和可视化,通常只能说明“存在差异”,不能解释“差异来自哪里”。
知识库中的案例显示,常见流程会先得到 9 类或 12 类细胞,再通过重命名细胞类型、比较不同组别、寻找差异基因和保守 marker 来推进分析。比较分析的质量,直接决定后续 marker、富集和预后建模的可信度。
2.2 正确的比较对象,决定生物学解释是否成立
差异分析不是越多越好,而是越准越好。单细胞里常见的正确做法是:
- 在同一细胞类型内比较疾病组与对照组。
- 在同一亚群内比较治疗前后。
- 在同一聚类内比较不同处理条件。
不建议直接把一个细胞类型和“其他所有细胞”混在一起做生物学结论。因为这类比较会把细胞组成差异、测序深度差异和表达比例差异混进来。如果比较对象不统一,得到的“差异基因”未必代表疾病效应。
2.3 WorkBuddy适合把比较流程固定下来
WorkBuddy 的价值,在于它可以把“比较对象选择、差异阈值设定、结果筛选、下游富集”串成一条链。对研究者来说,这意味着项目管理更清晰。对课题组来说,这意味着分析口径更统一。
尤其在多批次、多样本的单细胞项目中,标准化流程可以显著减少沟通成本。同一套比较逻辑可以被重复用于不同队列、不同疾病和不同组织。
3. 单细胞基因组比较的关键步骤
3.1 先做细胞注释,再做比较
比较之前,必须先完成细胞注释。知识库中提到的做法包括:
- 用
renameIdents重命名细胞类型。 - 直接根据提取的细胞类型赋值给
Idents(alldata)。 - 统计各细胞类型数量,判断是否存在某类细胞过少的问题。
这一步不是形式主义。如果细胞注释不准确,后续的差异分析、marker 识别和通路解释都会失真。
3.2 差异分析要关注阈值,而不是只看显著性
在单细胞差异分析中,常用指标包括:
- p 值。
- log fold change。
- 细胞表达比例
pct.1和pct.2。
知识库提到,差异结果表会同时给出 p 值、logFC 以及表达比例。这个信息很重要。因为单细胞数据中,一个基因是否真正有意义,不能只看显著性,还要看它在多少比例细胞中表达。
常见做法是设置 min.pct 和 logfc 阈值,再进行筛选。这样得到的结果更稳定,也更适合后续验证。
3.3 选择合适的方法提升稳健性
除了常规差异分析,知识库里还提到可使用 MAST 或 DESeq2。两者适用于不同分析需求:
- MAST 更适合单细胞表达的零膨胀特征。
- DESeq2 更适合计数数据框架,但需要注意 assay 设置。
方法不是越多越好,而是要和数据结构匹配。 在单细胞项目里,这一点尤其重要。因为错误的方法选择,会直接影响差异基因列表和后续生物学解读。
4. 从差异基因到marker,再到通路解释
4.1 新marker的鉴定决定细胞亚型的分辨率
单细胞项目常常不是“有没有差异”,而是“能不能分清更细的亚型”。这时,新 marker 的鉴定非常关键。知识库中提到可用 FindConservedMarkers 寻找保守 marker,再结合原有 marker 如 CD79a、MS4A1 做对比。
这类流程的意义在于,找到在多个条件下都稳定存在的标志物,而不是只在单个样本里偶然出现的基因。
4.2 可视化不是结论,但能验证结论
完成筛选后,常用的验证方式包括:
FeaturePlot看空间分布。- 小提琴图看表达差异。
- 热图看聚类特征。
- 柱状图看比例变化。
这些图不是为了“好看”,而是为了确认基因是否真的在目标细胞中富集。如果图像和统计结果不一致,就要回头检查比较对象和参数设置。
4.3 富集分析要建立在正确差异集上
差异分析之后,常常会进一步做 GO 富集。知识库中提到可基于上调、下调或按 p 值筛选基因进行富集,并下载富集结果与基因列表。
这里最重要的一点是,富集分析的质量上限,取决于前面的差异基因质量。 如果差异基因本身比较混乱,GO 结果再漂亮也难以支撑可靠结论。对于医学生和科研人员来说,这一步必须建立在严谨的前置筛选上。
5. WorkBuddy基因组比较如何提升效率与复用性
5.1 把“分析套路”变成可调用模板
上游知识库明确提到,WorkBuddy 加上自研 skill 的优势,是比固定 AI 应用和工作台更灵活。它不只是给出一个结果,而是可以提炼分析套路,进一步生成研究方案和学习计划。
这意味着一个单细胞项目可以从“结果导向”转向“流程导向”。 对团队协作尤其重要。因为不同成员可以沿着同一个分析骨架继续推进,而不是重复搭建环境、重复解释参数。
5.2 适合从新手到专家的不同使用场景
新手常见问题是“知道有结果,但不知道下一步怎么做”。高手常见问题是“每次都在重复相同操作,但没有沉淀”。WorkBuddy 的价值就在于中间层。
它能帮助用户把以下步骤串联起来:
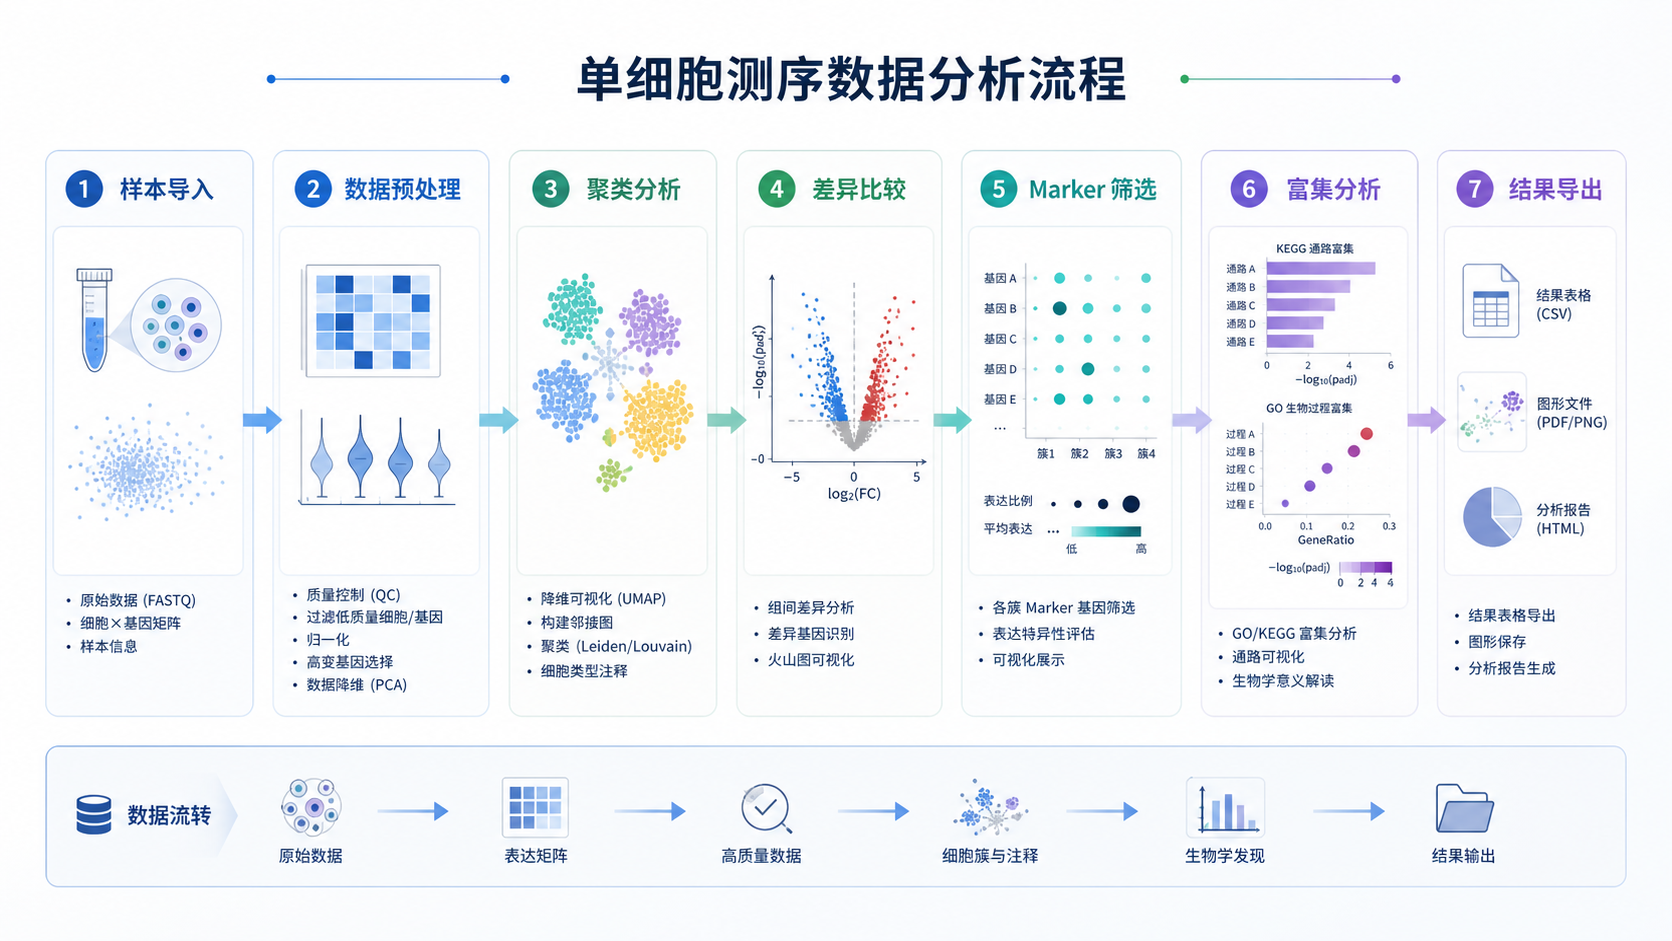
- 导入数据。
- 完成聚类与注释。
- 设定比较组。
- 筛选差异基因。
- 做 marker 和富集。
- 导出 PDF 归档。
这是一套真正可复用的单细胞比较工作流。
5.3 让结果更容易沉淀为论文素材
科研写作最怕的是图表分散、结果难追踪。知识库提到,完成分析后可以将所有结果生成 PDF 文档。对论文、汇报和组会非常实用。
对实际项目而言,这意味着:
- 结果可以快速归档。
- 图表可以统一管理。
- 分析路径可以回溯。
- 复现实验更容易。
当分析流程稳定后,论文产出效率会明显提高。
6. 结论:基因组比较的未来,是标准化与可复用
单细胞转录组分析正在从“会不会做”进入“怎么做得更稳、更快、更可复现”的阶段。WorkBuddy基因组比较的真正价值,不只是帮你出图,而是帮你建立一套可复用的比较范式。 它把细胞注释、差异分析、marker 筛选、富集解释和结果归档串成完整链路,更适合医学生、医生和科研人员在真实项目中使用。
如果你希望把分散的单细胞分析步骤,变成标准化、可追踪、可复用的工作流,可以进一步了解 解螺旋 。借助其工具和流程能力,很多原本重复、低效的分析环节,可以更快沉淀为可交付成果。

- 引言Introduction
- 1. 为什么单细胞基因组比较需要新范式
- 2. WorkBuddy基因组比较在单细胞分析中的位置
- 3. 单细胞基因组比较的关键步骤
- 4. 从差异基因到marker,再到通路解释
- 5. WorkBuddy基因组比较如何提升效率与复用性
- 6. 结论:基因组比较的未来,是标准化与可复用