10
 分享
引言Introduction
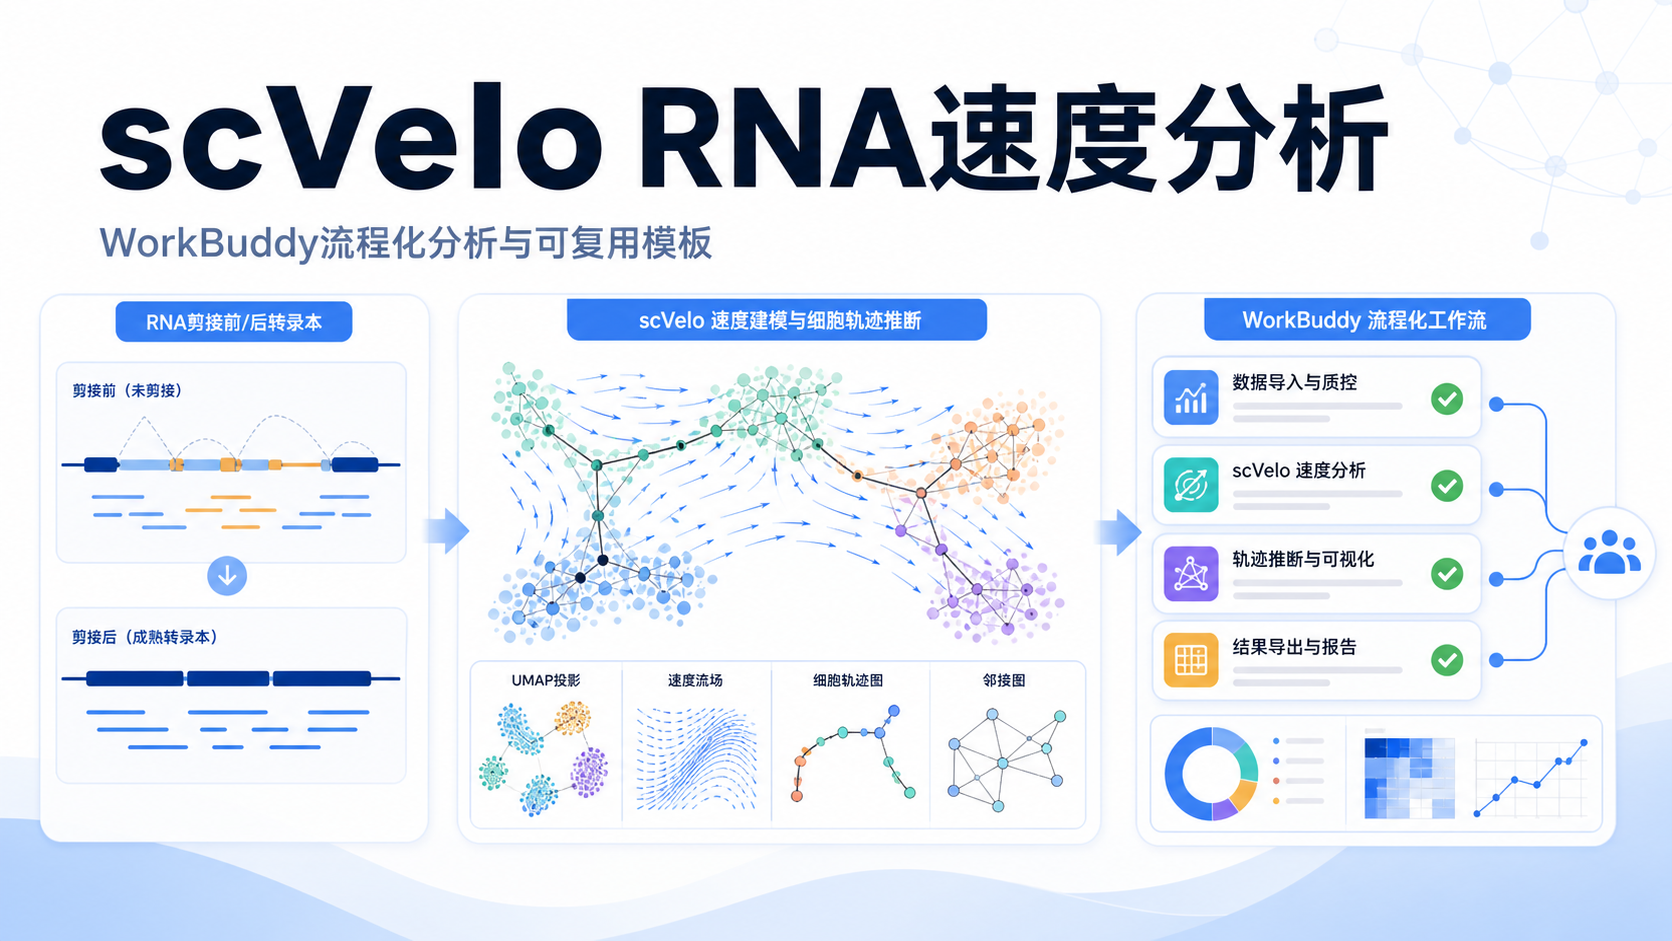
单细胞转录组里,很多人都想看“细胞下一步会去哪里”。但传统 RNA 速度分析门槛高,代码、参数、流程复现都容易出错。如果你还在为 scVelo 的环境配置、分析步骤和结果解释耗时,这篇文章可以直接帮你梳理全流程。
1.scVelo 为什么适合做 RNA 速度分析
1.1RNA 速度回答的核心问题
RNA 速度本质上是在单细胞层面推断转录动态。它通过比较未剪接与已剪接转录本,估计基因表达的变化方向。它回答的不是“当前表达多少”,而是“表达正在往哪里变”。
这类信息对发育、分化、肿瘤异质性和免疫细胞状态转换都很重要。比如在肿瘤研究中,研究者常想判断某一亚群是否正向侵袭性状态转变。在发育研究中,则常关注细胞是否沿着祖细胞到成熟细胞的方向推进。
1.2scVelo 的优势与局限
scVelo 是目前应用很广的 RNA 速度分析框架之一。它支持稳态模型和动态模型,能更细致地拟合转录变化。与早期 velocity 方法相比,scVelo 对细胞状态转变的刻画更强,也更适合复杂样本。
但它也有明显门槛。分析前需要正确处理 loom 或 AnnData 数据结构,还要完成邻接图、spliced/unspliced 矩阵、参数设定和可视化。对不熟悉 Python 或单细胞流程的人来说,最容易卡在三点:
- 数据格式不匹配。
- 参数不清楚。
- 结果图能出,但不一定能解释。
2.WorkBuddy 在 scVelo 流程里的作用
2.1把复杂代码流程变成可调用任务
根据现有知识库,WorkBuddy 的核心价值不是“现写一段不可控的代码”,而是调用固定工具和稳定流程来完成分析 。这点对 RNA 速度分析尤其重要。因为分析流程本身是固定的,数据也是固定的,真正需要的是可复现、可审核的执行方式。
对于 scVelo 来说,WorkBuddy 可以把原本分散的步骤串起来,例如:
- 导入单细胞对象。
- 检查 spliced 与 unspliced 矩阵。
- 构建邻接图。
- 计算 RNA 速度。
- 生成速度流图与轨迹图。
- 输出结果并保存分析记录。
这类流程化处理,比单次生成代码更适合科研场景。 因为科研里最重要的是结果可信、步骤可追溯、输出可复查。
2.2为什么“可验证”比“会生成”更重要
知识库中提到,AI 现写代码虽然方便,但存在同样提示下结果不一致的问题。对懂代码的人,这可以通过审核和测试解决。但对不懂代码的人,这种不确定性会直接影响分析结论。
RNA 速度分析尤其如此。因为它依赖矩阵、邻接图和参数设置,一步错,后面速度矢量和流向图都可能偏离真实生物学含义。WorkBuddy 更适合的方向,是把 scVelo 这类分析变成固定流程、固定模块、固定输出。
2.3适合哪些研究场景
WorkBuddy 与 scVelo 的组合,适合这些高频任务:
- 单细胞分化轨迹推断。
- 肿瘤细胞状态转移分析。
- 免疫细胞活化和耗竭轨迹。
- 发育生物学中的谱系方向判断。
- 药物干预前后的动态变化比较。
如果研究问题本身需要“方向性”和“动态性”,RNA 速度分析就很有价值。
3.scVelo RNA速度分析的标准流程
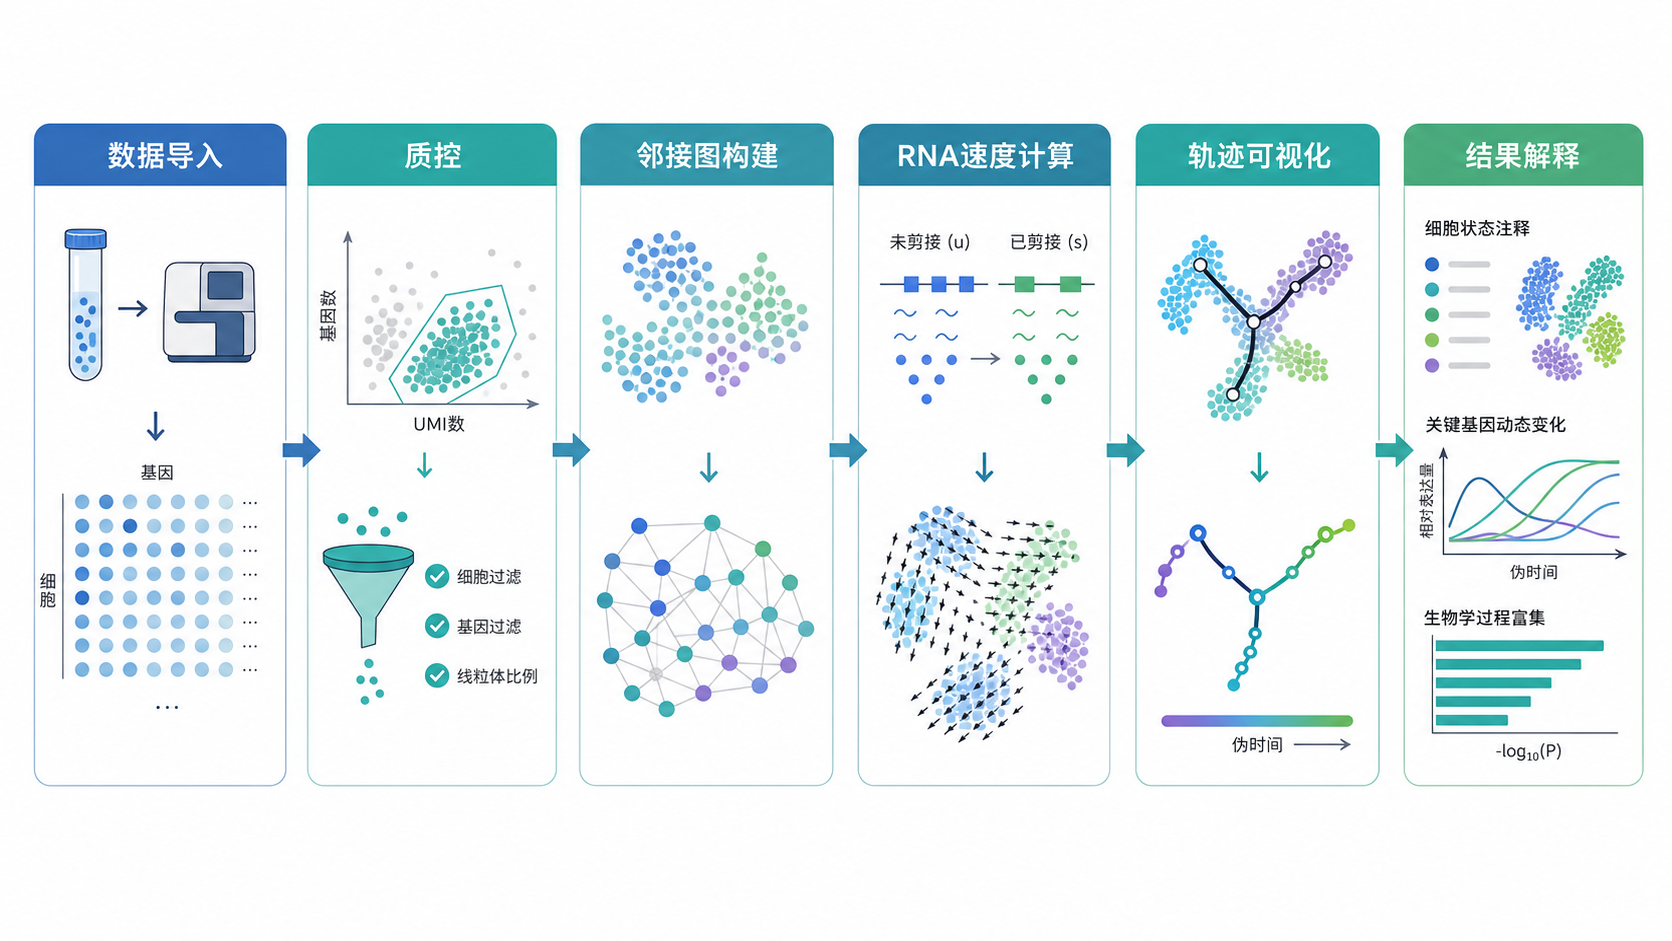
3.1从原始数据到可分析对象
scVelo 的第一步不是直接出图,而是准备好可用的数据对象。通常需要单细胞表达矩阵,以及对应的 spliced 和 unspliced 信息。若数据来源于 10x Genomics、Cell Ranger 或已有预处理对象,关键是确认格式完整、注释一致。
在实际研究中,建议先检查:
- 基因命名是否统一。
- 细胞条形码是否完整。
- spliced/unspliced 矩阵是否可用。
- 低质量细胞是否已过滤。
- 批次效应是否会影响轨迹判断。
数据前处理决定后续速度结果是否可信。
3.2速度估计与邻接图构建
进入 scVelo 后,常规流程包括计算邻接图、估计转录动力学参数,再推断速度向量。邻接图决定了细胞之间的局部关系,速度估计则决定细胞状态变化方向。
这一步中最重要的是保持参数一致性。比如邻居数过少,可能导致局部结构不稳定。邻居数过多,又可能稀释真实轨迹信号。因此,参数选择不能只看默认值,要结合数据分辨率和生物学问题。
3.3常见可视化输出
scVelo 常见输出包括:
- velocity embedding stream。
- velocity graph。
- latent time。
- 根细胞与终末细胞推断。
- 基因层面的速度动力学图。
这些图不仅用于展示,也用于验证。比如速度流是否与已知分化方向一致,latent time 是否与 marker 基因变化趋势相符。如果图像方向和已知生物学规律明显冲突,就要回头检查数据和参数。
4.在 WorkBuddy 中做 scVelo,需要关注哪些关键点
4.1流程稳定性
知识库强调,固定代码和固定流程比“每次现写”更可靠。对 scVelo 来说,这意味着分析应尽量标准化。包括输入格式、参数配置、图形输出和结果保存方式,都应形成模板。
这样做有两个好处:
- 便于复现。
- 便于多项目复用。
对于科研团队来说,这比单次完成一个漂亮图更重要。因为论文复核、组会汇报和后续扩展都需要重复执行。
4.2结果解释必须回到生物学问题
RNA 速度不是独立结论,它必须和细胞类型、marker 基因、通路富集和实验设计结合。比如:
- 祖细胞是否朝分化终末状态推进。
- 肿瘤细胞是否出现 EMT 倾向。
- 免疫细胞是否从活化走向耗竭。
只有把速度方向放回具体疾病模型中,结果才有解释力。
如果只看图,不看生物学背景,容易把技术信号误判成机制发现。
4.3多人协作场景下的价值
科研中常见问题是:分析做完了,但别人接不上。WorkBuddy 的优势在于可以把流程、配置和记录保留下来。知识库中也提到,客户端迁移时只需复制配置文件即可继续使用。对于团队协作,这意味着更低的交接成本。
这对临床研究尤其重要。因为项目周期长,人员变动频繁。能复用的分析模板,比个人经验更能保障项目连续性。
5.从单次分析到可复用模板
5.1把 scVelo 流程固化为分析套路
知识库提到,系统会提炼“分析套路”,并把它变成研究方案、学习计划或标准模板。这个思路非常适合 scVelo。因为 RNA 速度分析看似复杂,本质上却是固定逻辑链条。
一个可复用模板至少应包括:
- 数据输入与质控。
- 速度计算。
- 轨迹与流向可视化。
- 关键基因动力学分析。
- 结果解释与报告输出。
把流程固化后,新手能少走弯路,高手能提高效率。
5.2适合和其他单细胞分析联动
scVelo 通常不是孤立使用。它常与 Seurat、聚类、差异分析、GO 富集和细胞通讯分析联动。先确定细胞群,再看状态变化方向,会比单独做速度图更完整。
例如可以先做:
- 聚类和细胞注释。
- 差异基因筛选。
- 轨迹和速度方向分析。
- 重点基因的动态验证。
- 富集分析解释机制。
这样能把“方向”与“功能”连接起来。 这也是很多高质量单细胞文章常见的写法。
5.3让非代码用户也能参与分析
知识库里有一个很关键的判断:零代码工具本质上是零代码,但会用的人会更强。原因很简单,懂分析逻辑的人知道应该看什么,知道参数如何调整,也知道什么时候切换到更高阶模式。
这正是 WorkBuddy 这类工具的价值。它不是替代研究者,而是把复杂流程包装成可执行任务,让医学生、医生和科研人员更容易进入 scVelo 这种分析。
总结Conclusion
scVelo 擅长回答细胞“向哪里走”的问题,但它的价值建立在规范的数据准备、稳定的流程和可解释的结果之上。WorkBuddy 的意义,不是替代专业判断,而是把 scVelo 的分析流程变得更稳定、更可复现、更适合科研协作。
如果你正在做单细胞发育轨迹、肿瘤状态转变或免疫动态分析,建议把 RNA 速度分析纳入标准流程。想把复杂分析真正落地,可以了解解螺旋的 WorkBuddy,让 scVelo 从“难操作”变成“可复用”。

- 引言Introduction
- 1.scVelo 为什么适合做 RNA 速度分析
- 2.WorkBuddy 在 scVelo 流程里的作用
- 3.scVelo RNA速度分析的标准流程
- 4.在 WorkBuddy 中做 scVelo,需要关注哪些关键点
- 5.从单次分析到可复用模板
- 总结Conclusion