24
 分享
引言Introduction
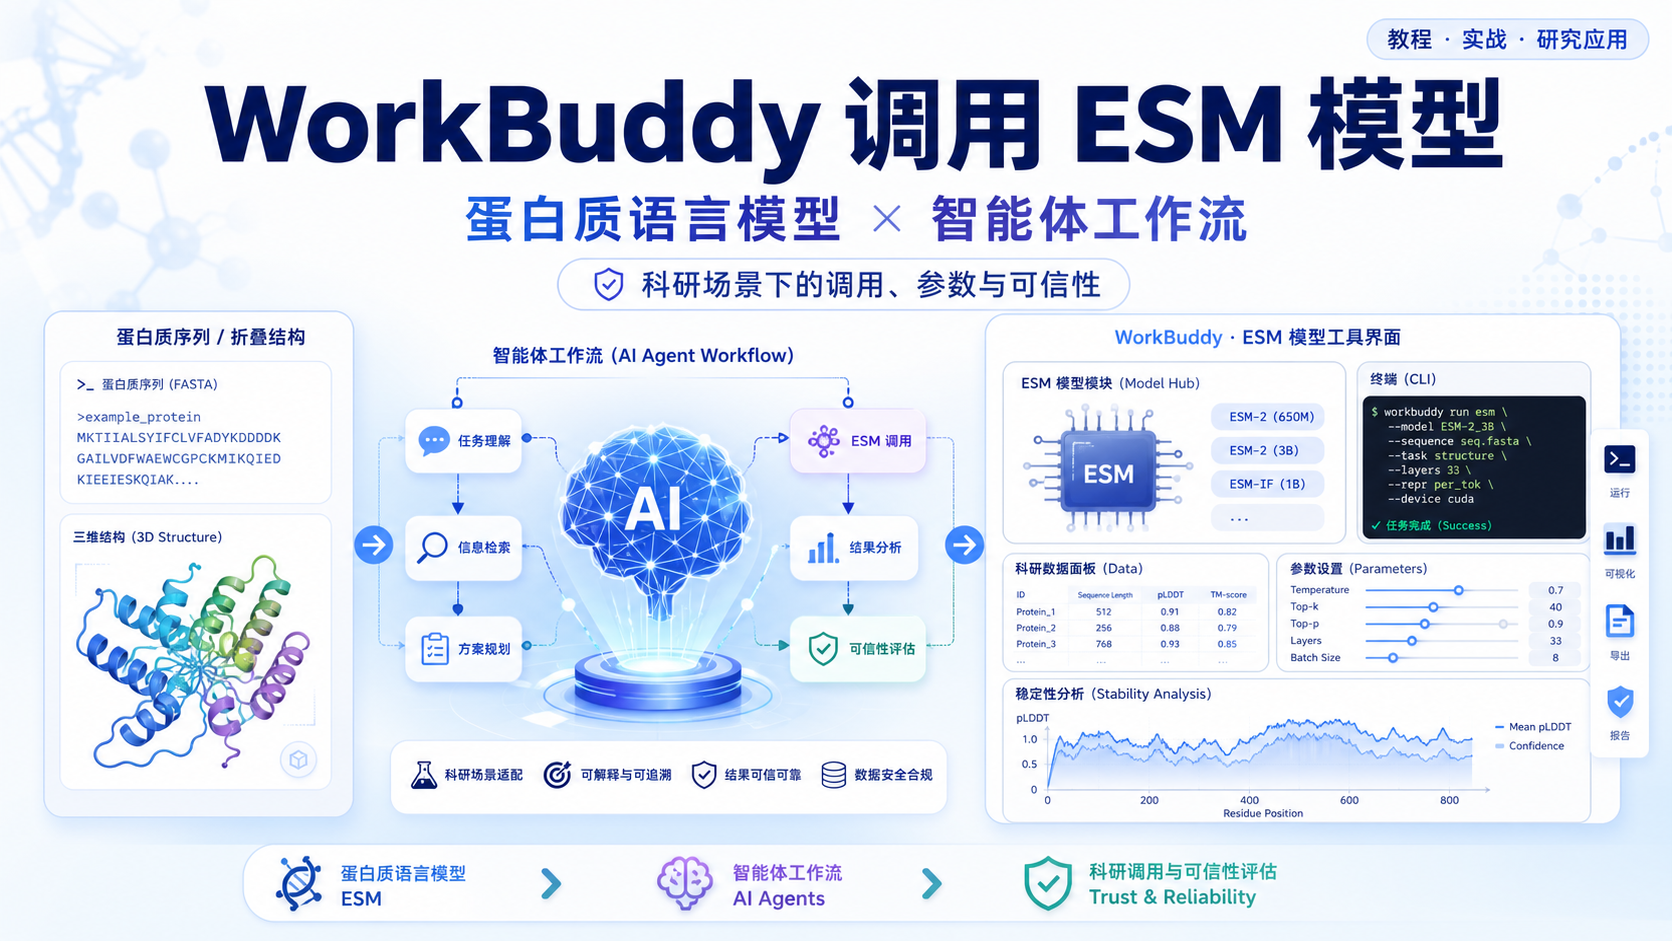
很多医学生和科研人员都遇到过同样的问题。蛋白质序列分析想自动化,但代码门槛高,结果又容易受流程影响。如果只是“能跑”,不代表结果稳定可靠。 WorkBuddy 这类智能体工具,正是为了解决“不会编程,也想调用模型做分析”的痛点。
1.WorkBuddy调用ESM模型的核心逻辑
1.1 为什么不直接写代码调用
在蛋白质语言模型应用里,最常见的难点不是“有没有模型”,而是“怎么稳定地用起来”。直接写代码调用 API,理论上很灵活,但对非代码背景用户并不友好。流程配置、参数传递、环境依赖、结果解析,任何一步出错,都会影响输出。
更现实的做法,是让大模型通过工具或包去完成分析。 这样可以减少手写代码带来的波动,也更便于复用标准化流程。对于科研场景来说,稳定性往往比一次性跑通更重要。
1.2 WorkBuddy在这里扮演什么角色
WorkBuddy的价值,不是替代ESM模型本身,而是充当“调用入口”和“任务执行器”。它更像一个可以操作电脑、连接工具链的智能体客户端。用户只要把目标说清楚,例如“调用ESM做蛋白质序列嵌入分析”,系统就可以按照配置去执行。
这意味着,WorkBuddy解决的是工作流问题,不是重新发明模型。 对实验室和团队来说,这种方式更适合做标准化任务。比如批量序列处理、特征提取、结果整理,流程更清晰,交付也更稳定。
1.3 ESM模型适合什么任务
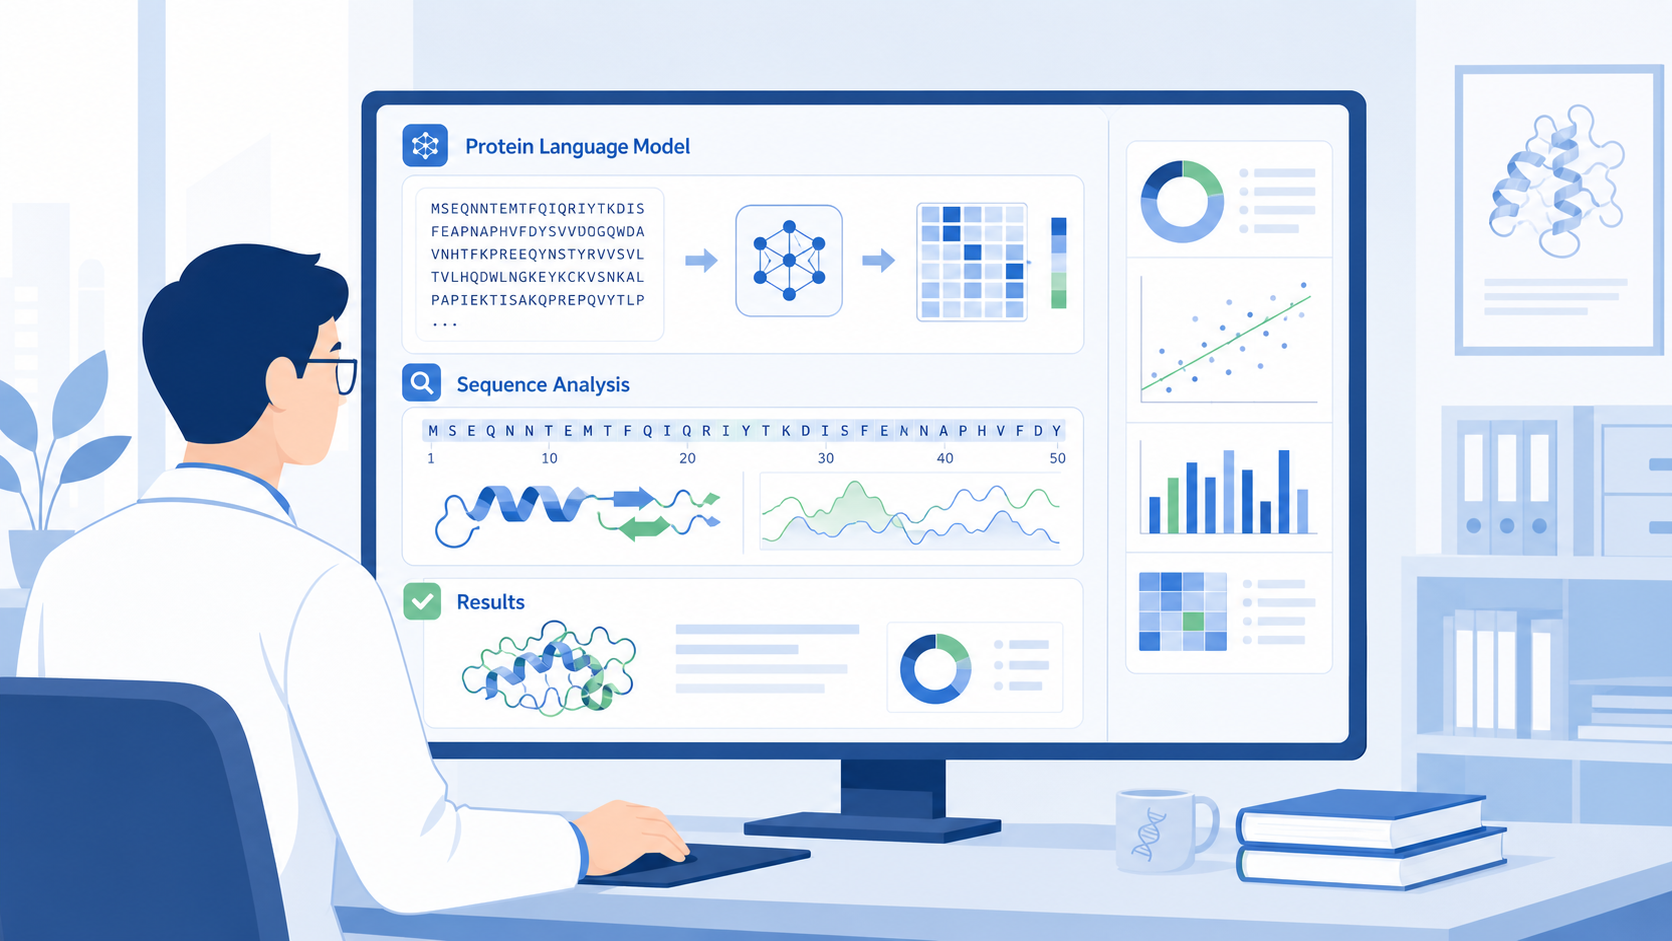
ESM蛋白质语言模型本质上是基于蛋白序列训练的表示学习模型,常用于提取序列特征、预测结构相关性质、辅助功能分析等任务。它的核心优势在于,可以把氨基酸序列转成有信息密度的向量表示,为后续建模提供基础。
常见应用包括:
- 蛋白质序列embedding提取。
- 功能分类前的特征构建。
- 变异效应分析。
- 下游机器学习模型输入。
如果你的目标是把蛋白质序列转成可分析的特征,ESM是非常典型的选择。 但前提是,调用方式要稳定,流程要规范。
2.WorkBuddy调用ESM的实际方式
2.1 准备调用环境
从现有知识库信息看,WorkBuddy支持通过API Key连接外部能力,也支持调用自定义模型或工具链。实际使用时,第一步不是直接跑模型,而是先明确你的运行环境和权限。
你需要关注三件事:
- 是否具备可用的模型访问权限。
- 是否已经配置好API Key或对应凭据。
- 是否有可被WorkBuddy识别的工具或包。
对科研用户来说,最重要的是把“模型调用”和“实验流程”分开管理。 前者是工具接入,后者是分析逻辑。这样后续修改参数时,不会把整个流程弄乱。
2.2 通过工具包或CLI进行调用
知识库中提到,当前更推荐让大语言模型调用包来完成分析,而不是完全依赖手写代码。对于WorkBuddy场景,这意味着你可以把ESM相关任务封装成可执行工具,再由WorkBuddy发起调用。
可行的逻辑通常是:
- 先准备蛋白质序列输入。
- 再由WorkBuddy触发对应工具包。
- 工具包内部完成ESM推理。
- 最后输出embedding、分数或结果表格。
这种方法的关键,不是“界面是否漂亮”,而是“输出是否可复现”。 对论文前期探索、标书预实验、课题筛选都很重要。
2.3 模型选择和参数设置
从上游信息可知,WorkBuddy官方支持多种模型,也允许接入自定义模型。虽然ESM本身属于蛋白质语言模型,不等同于通用聊天模型,但在实际工作流里,常需要一个智能体层去调度任务。
建议注意以下几点:
- 输入序列格式要统一。
- 批量样本要有唯一编号。
- 参数版本要记录。
- 输出结果要保留原始文件。
科研流程里,版本控制和日志记录比“跑得快”更重要。 一次分析如果没有记录模型版本和参数,后续很难复现。
3.科研场景下的关键问题
3.1 为什么“能跑”不等于“可信”
知识库里有一个非常重要的提醒。若分析过程高度依赖代码临时拼接,准确性可能不稳定,结果也会不一样。这个问题在蛋白质语言模型应用里尤其明显。因为输入数据、截断长度、批处理方式、结果聚合方式,都会影响最终输出。
所以,ESM调用的第一原则是标准化。
如果同样的序列,每次得到的结果都不一致,那这个流程就不适合直接用于科研结论。
3.2 如何提高结果稳定性
要让WorkBuddy调用ESM更可靠,可以从流程上控制:
- 固定输入格式,避免序列写法混乱。
- 固定模型版本,避免不同权重造成偏差。
- 固定预处理规则,例如是否去除非标准氨基酸。
- 固定输出字段,便于后续统计。
- 保留日志,方便复核。
稳定的流程,往往来自最朴素的工程规范。 对医学生和科研人员而言,这比单纯追求“自动化”更实际。
3.3 适合哪些研究阶段使用
WorkBuddy调用ESM,更适合以下阶段:
- 课题前期探索。
- 候选蛋白筛选。
- 初步特征提取。
- 批量结果整理。
- 标书或文章中的方法验证。
它不一定适合直接替代全部生信流程,但很适合做“前端调度”和“流程整合”。也就是说,它更像一个科研工作台,而不是单一算法。
4.从蛋白质语言模型到智能体工作流
4.1 为什么智能体会成为趋势
上游知识库提到,当前已经从“chat对话”进入到“agent工作”时代。这个判断在科研工具链里非常明显。过去我们是人手动操作软件,现在更希望由智能体去调度工具、执行步骤、整理结果。
对ESM这类模型来说,智能体的意义在于:
- 降低调用门槛。
- 减少重复劳动。
- 统一工作流入口。
- 方便团队协作。
未来竞争的重点,不只是模型能力,而是模型能否被高效地嵌入真实工作流程。
4.2 WorkBuddy适合谁用
如果你是以下人群,WorkBuddy会更有价值:
- 不会代码,但需要做蛋白分析的人。
- 想把ESM接入现有工作流的人。
- 需要批量处理样本的实验室成员。
- 想提高方法复现性的科研人员。
对这类用户来说,最重要的不是掌握复杂语法,而是把任务描述清楚,把流程固定下来。WorkBuddy的优势就在于,它把“工具使用”变成了“任务管理”。
总结Conclusion
WorkBuddy调用ESM蛋白质语言模型,核心不是炫技,而是把蛋白质序列分析变成可复现、可管理、可交付的流程。对于医学生、医生和科研人员来说,真正有价值的是稳定输出,而不是一次性的跑通。 通过工具包、API或标准化流程,WorkBuddy可以帮助你更高效地完成ESM相关任务,尤其适合前期探索和批量分析。
如果你希望把这类科研流程做得更稳、更顺、更适合团队协作,可以进一步关注解螺旋 提供的生物医学AI工作流方案,让模型调用从“会用”走向“用得规范”。

- 引言Introduction
- 1.WorkBuddy调用ESM模型的核心逻辑
- 2.WorkBuddy调用ESM的实际方式
- 3.科研场景下的关键问题
- 4.从蛋白质语言模型到智能体工作流
- 总结Conclusion