25
 分享
引言Introduction
代谢模型听起来复杂,很多医学生和科研人员第一步就卡在环境配置、代码调用和结果解释。尤其是想把 COBRApy 用起来时,常常不是模型不会建,而是流程太碎、工具太散,最后难以真正落地。WorkBuddy+COBRApy 的组合,正是为了解决“会看文献,却难以快速做出可复现分析”的痛点。 
1.WorkBuddy+COBRApy是什么,适合解决什么问题
1.1 COBApy在代谢研究中的位置
COBRApy 是 Python 生态中常用的约束基础重建与分析工具。它适合做代谢网络建模、通量平衡分析、基因敲除模拟、目标代谢物优化等任务。对于生物医学研究而言,它的价值不在“画图”,而在于把代谢机制转化为可计算的问题。
但COBRApy的门槛并不低。 研究者通常需要先完成模型读取、反应检查、边界条件设置,再进行 FBA、FVA 或敲除分析。每一步都可能影响结论。对非计算背景用户来说,最耗时的往往不是算法本身,而是前期整理与步骤衔接。
1.2 WorkBuddy能补上的不是算法,而是流程
WorkBuddy 的优势,不是替代 COBRApy,而是把“人要手动做的琐碎流程”串起来。根据给定材料,它更强调灵活调用技能,能够承接文献提取、分析套路梳理、研究方案延展等任务。这意味着它更适合把“读懂问题”到“开始动手”之间的空白补上。
在代谢模型场景中,这种能力尤其重要。研究者经常面对以下问题:
- 文献中出现大量代谢通路,但不知道该如何转成模型假设。
- 模型需要结合疾病背景,但实验设计与计算分析分离。
- 代码能跑,但缺少清晰的分析链条和结果归纳。
WorkBuddy 更像一个流程组织者,COBRApy 则是执行代谢建模的核心工具。 两者结合后,能显著降低从概念到结果的转换成本。
2.从文献到代谢模型,怎么把问题拆开
2.1 先明确建模对象,再谈工具调用
代谢模型不是一上来就跑代码。第一步应先定义研究问题。比如,是关注肿瘤糖酵解重编程,还是脂代谢异常,或是线粒体相关代谢通路变化。问题不同,模型边界、目标函数和约束条件都不同。
一个清晰的建模起点通常包括四项:
- 研究对象。细胞系、组织样本,还是公共数据库模型。
- 生物学问题。生长速率、关键代谢物、敲除效应,还是药物干预。
- 数据来源。文献、组学数据、表型数据,还是实验测定。
- 分析终点。通量变化、必需反应、候选靶点,还是可视化结果。
没有这四步,COBRApy 只能变成“跑脚本”,很难变成“做研究”。
2.2 WorkBuddy适合做前期结构化整理
根据上游知识库中的思路,WorkBuddy 强调“上传材料后提炼分析套路”,并可进一步延展为研究方案。放到代谢模型研究中,这个能力可以用于:
- 从综述或原始论文中提取代谢轴。
- 梳理疾病相关代谢通路。
- 归纳关键酶、转运体、交换反应。
- 形成可执行的建模假设。
这一步的核心价值,是把文献语言转成模型语言。 比如,把“肿瘤细胞葡萄糖摄取增强”转成“提高葡萄糖摄取边界,评估糖酵解通量变化”。把“脂肪酸氧化下降”转成“限制相关反应通量,观察生长率和替代通路补偿”。
2.3 代谢问题最怕的是假设不清
很多代谢模型失败,不是因为 COBRApy 不好用,而是因为研究假设模糊。常见错误包括:
- 目标函数设得过泛。
- 边界条件与真实生理状态不一致。
- 只看单一通量,不看系统补偿。
- 忽略模型版本、注释和组织特异性。
WorkBuddy 的价值,是帮助研究者先把问题写清楚,再进入 COBRApy 的计算阶段。 这样结果更容易解释,也更容易写进论文方法学部分。
3.COBRApy上手的关键步骤
3.1 从模型导入开始
COBRApy 常见起点是导入已有模型。研究中更常用的是成熟的全局模型或组织特异性模型,而不是从零构建。上手时应关注:
- 模型是否有完整代谢反应注释。
- 是否存在无效循环。
- 交换反应是否合理。
- biomass 反应是否适用于当前研究对象。
模型质量,直接决定分析质量。 如果基础模型存在缺陷,后面的 FBA 和敲除分析会产生误导。
3.2 常用分析任务要分层处理
在实际研究里,COBRApy 最常见的任务可分为三层:
- 基础层。查看模型信息、反应、代谢物和基因。
- 分析层。执行 FBA、FVA、pFBA、基因敲除。
- 解释层。结合通路、生物学背景和实验结果解读通量变化。
其中,FBA 主要用于寻找在约束条件下的最优通量分布。FVA 用于看每个反应在最优解下的波动范围。敲除分析则适合筛选关键基因或关键反应。这三类分析组合使用,才更接近真实生物系统。
3.3 结果不能只看数值,还要看生物学合理性
代谢模型的结果常见误区,是只盯着一个目标值,比如生长率、ATP 产量或某个代谢物输出。事实上,更重要的是看结果是否符合已知生物学规律。
建议至少检查:
- 是否出现不合理的无限通量。
- 关键反应是否符合组织特异性。
- 敲除后模型是否仍有补偿路径。
- 通量变化是否与转录组或蛋白组趋势一致。
如果结果和已知机制明显冲突,先查模型和约束,而不是先解释生物学。
4.WorkBuddy+COBRApy如何组成一条更顺的研究链
4.1 先提炼分析套路,再映射到建模步骤
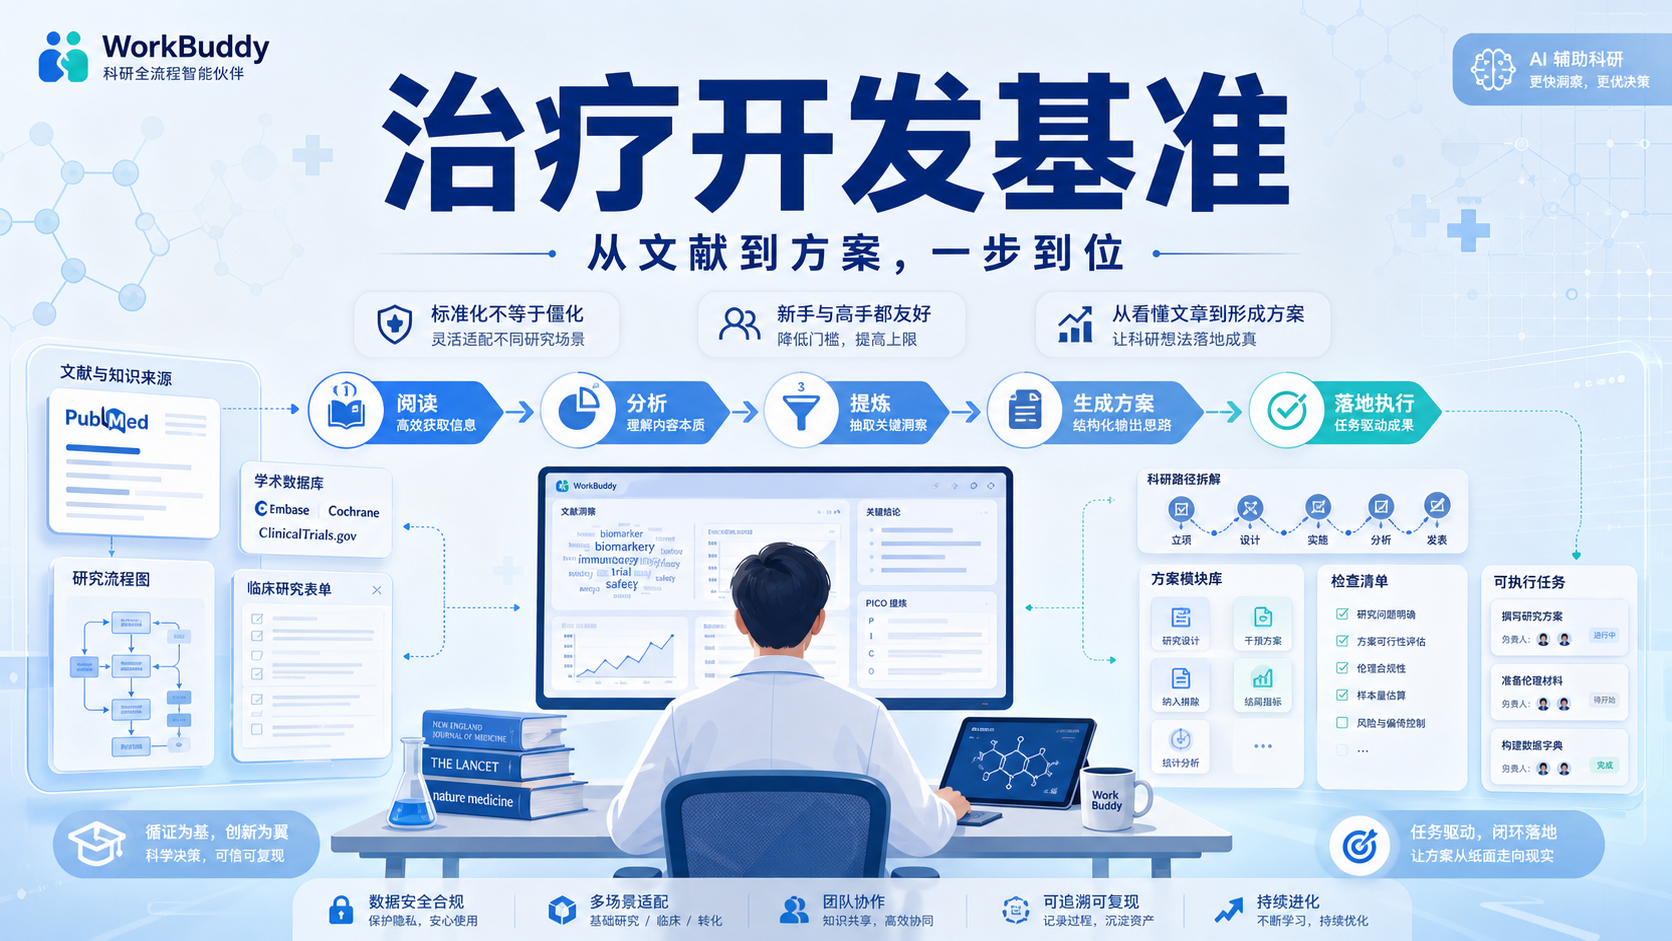
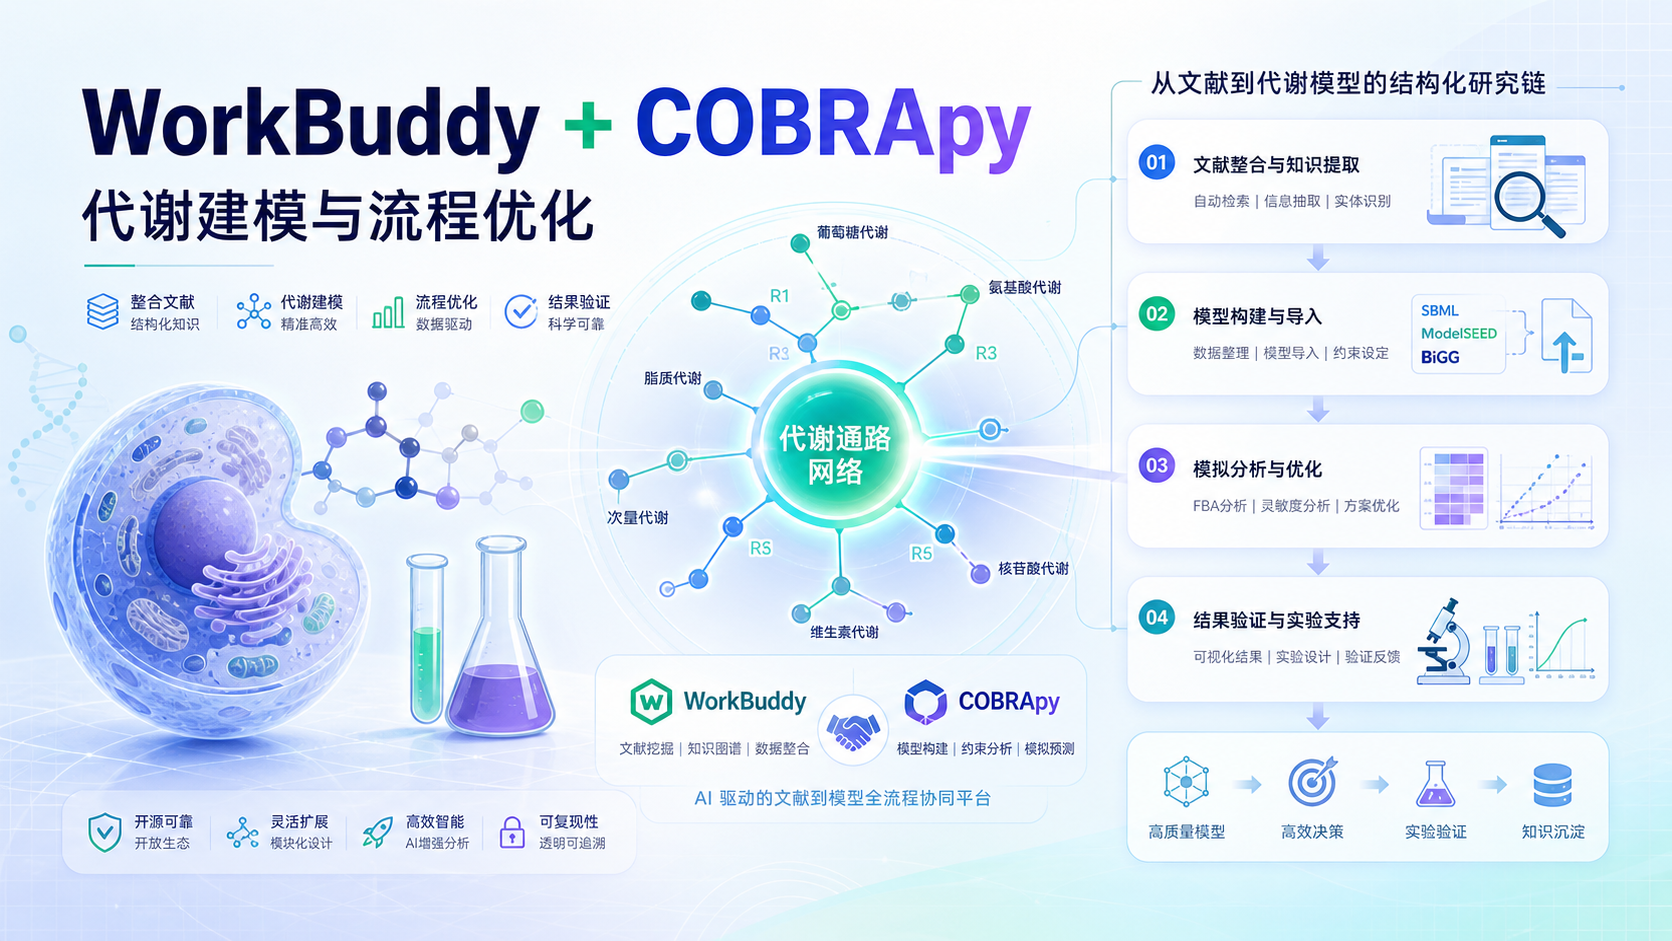
上游知识库反复强调一个核心能力:先从材料中提炼分析路线,再进一步转成研究方案。这个逻辑放到代谢模型中非常适合。因为很多课题并不是缺工具,而是缺“怎么走”的路线图。
一个实用的工作流可以这样走:
- 用 WorkBuddy 整理文献,提取疾病相关代谢机制。
- 确定候选通路和关键酶。
- 在 COBRApy 中导入合适模型。
- 设置约束条件与目标函数。
- 做 FBA、FVA 和敲除分析。
- 结合组学数据筛选靶点。
- 输出图表和可复现代码。
这条链路的好处,是把读文献、做模型、写结果连成一体。
4.2 适合做哪些生物医学问题
WorkBuddy+COBRApy 的组合,特别适合以下场景:
- 肿瘤代谢重编程分析。
- 免疫细胞活化相关代谢变化。
- 代谢酶缺失后的系统代偿研究。
- 药物干预下的通量变化预测。
- 生信数据驱动的关键靶点筛选。
这些问题的共同点是,既需要生物医学判断,也需要结构化计算分析。 单靠代码不够,单靠阅读也不够。两者配合,效率更高。
4.3 对新手和高手的价值不一样
对新手来说,最大收益是减少试错。对高手来说,最大收益是提高批量处理和方案组织效率。上游材料中提到,复杂技能可以通过装载和调用方式来扩展,适合灵活嵌入不同任务。这个特点放在代谢研究里很实用,因为不同课题往往只是在参数和问题定义上变化。
换句话说,WorkBuddy 负责把“杂乱的信息”整理成“可执行步骤”,COBRApy 负责把步骤变成“可计算结果”。
5.实际应用时要注意的几个细节
5.1 模型质量优先于计算速度
很多人一开始就想跑结果,但代谢模型最怕“快而不准”。应优先确认:
- 反应注释完整。
- 物质命名统一。
- 交换边界设置合理。
- 目标函数与研究问题一致。
模型没理顺,算得越快,偏差越大。
5.2 结果解释要结合实验验证
代谢模型的价值不在于替代实验,而在于缩小实验范围。比较稳妥的策略是:
- 先用 COBRApy 筛出候选反应。
- 再结合表达数据或文献验证。
- 最后设计针对性实验。
这种“计算优先筛选,实验后验证”的路径,更适合论文写作,也更符合转化研究思路。
5.3 记录分析过程,保证可复现
无论是科研还是教学,代谢模型都必须可复现。建议保留:
- 模型版本。
- 约束参数。
- 目标函数设置。
- 代码与输出结果。
- 关键解释依据。
可复现不是附加项,而是代谢建模的基本要求。
总结Conclusion
WorkBuddy+COBRApy 的真正价值,不是让代谢建模“自动化到无需思考”,而是把从文献整理、问题定义到模型分析的流程变得更顺、更清晰。对医学生、医生和科研人员来说,这种组合能显著降低入门门槛,也能提升研究方案的组织效率。如果你正在做生物医学代谢模型,却总是卡在“怎么从文献走到代码”,可以借助解螺旋,把复杂流程拆解成可执行步骤,快速把想法落到COBRApy分析中。

- 引言Introduction
- 1.WorkBuddy+COBRApy是什么,适合解决什么问题
- 2.从文献到代谢模型,怎么把问题拆开
- 3.COBRApy上手的关键步骤
- 4.WorkBuddy+COBRApy如何组成一条更顺的研究链
- 5.实际应用时要注意的几个细节
- 总结Conclusion