25
 分享

引言Introduction
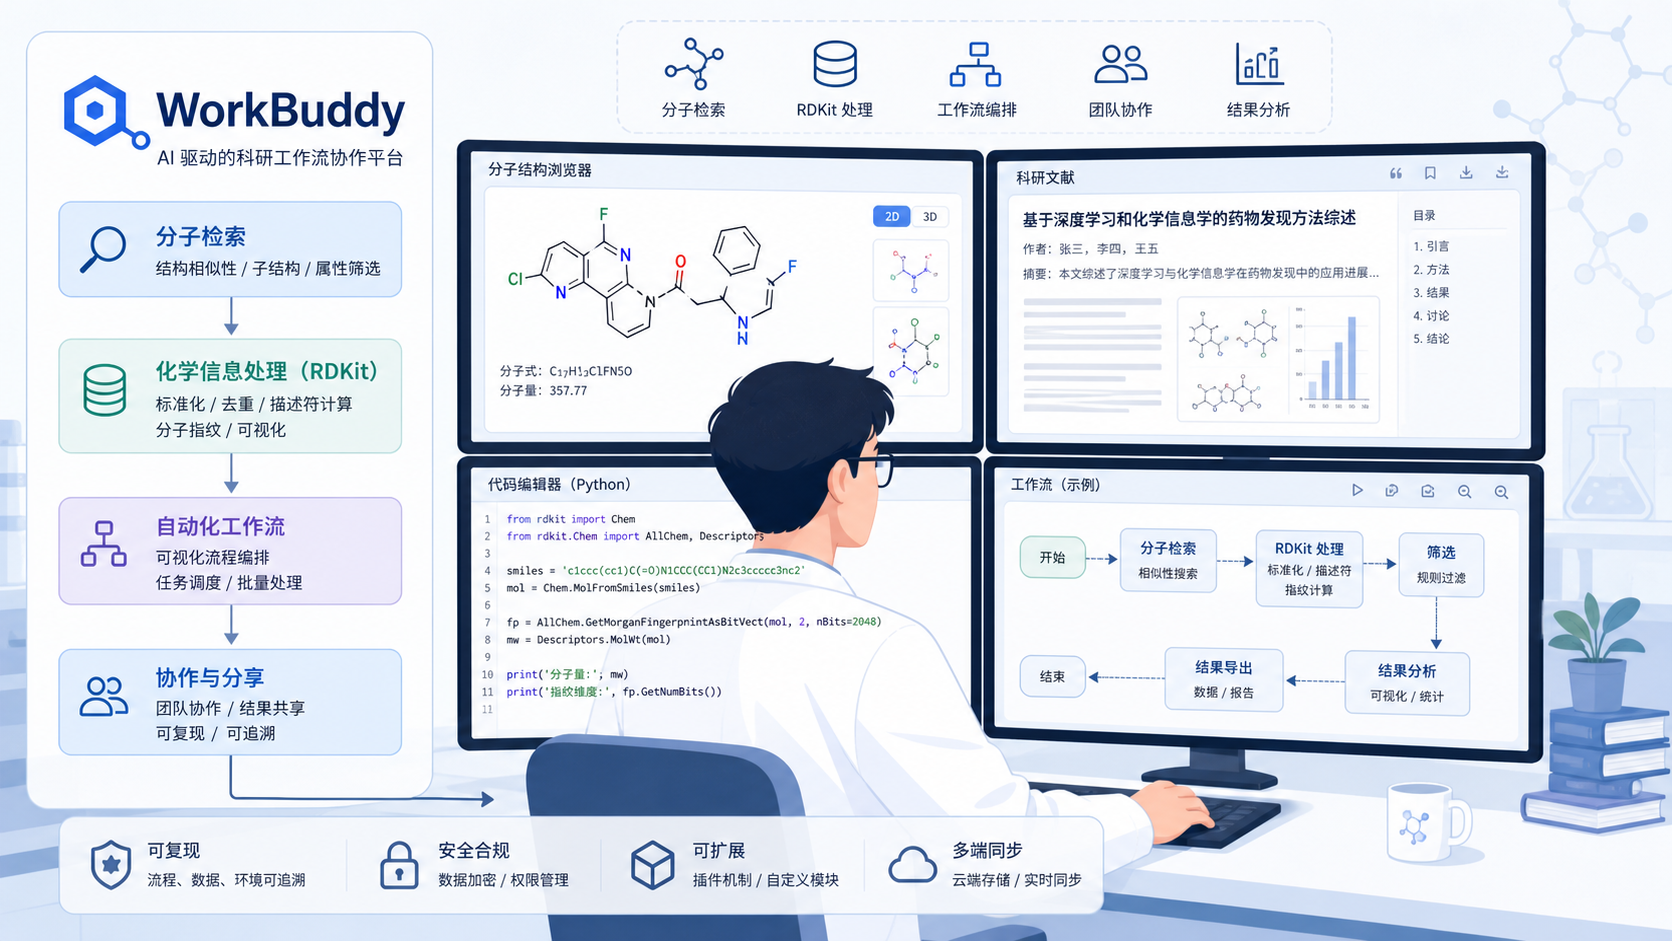
化学信息学的难点,不在“有没有数据”,而在“怎么快速把数据变成可用结论”。对医学生、医生和科研人员来说,文献筛选、分子处理、结构分析、方案设计,往往最耗时间。WorkBuddy结合RDKit,可以把很多重复操作压缩到可执行流程里。
1. 为什么化学信息学需要更高效的工作流
1.1 传统化学信息学的三类痛点
化学信息学不是单纯会写代码就够了。很多项目卡在前处理阶段。比如分子标准化、格式转换、子结构检索、性质计算,这些工作都很碎。
更现实的问题是,研究者经常要在多个工具之间切换。文献在一个平台,分子数据在另一个平台,分析脚本又在本地。切换越多,效率越低,出错概率越高。
对初学者来说,门槛主要有三点。
- 代码环境配置复杂。
- 数据格式不统一。
- 分析思路和实验问题脱节。
1.2 为什么WorkBuddy适合接入RDKit流程
RDKit是化学信息学中非常常用的开源工具包,适合做分子描绘、指纹计算、相似性分析、反应处理和基础机器学习前处理。它的优势是功能全,但前提是你得把流程搭起来。
WorkBuddy的价值,不是替代RDKit,而是把“找文献、整理问题、组织步骤”这件事前置。 这对做课题的人很关键。因为很多失败并不是算法不够,而是问题定义不清。
如果你先用WorkBuddy梳理研究目标,再调用RDKit处理分子信息,效率会明显更高。特别适合下面这些任务。
- 从文献中提取分子机制。
- 从候选化合物中做相似性筛选。
- 为SAR分析准备标准化数据。
- 设计化学信息学课题框架。
2. WorkBuddy如何提升RDKit项目效率
2.1 从文献到分子,再到方案
化学信息学项目最常见的起点,是一篇文献或一个分子。很多人会先盯着结构式看很久,却不知道下一步做什么。WorkBuddy更适合先做“问题拆解”。
你可以直接让它完成以下任务。
- 提取文献中的核心分子、靶点和实验条件。
- 汇总同类分子的结构差异。
- 生成可验证的分析步骤。
- 帮你把机制假设转成课题设计。
这一步的意义在于,把“读懂”转成“可执行”。 对科研而言,这比单纯生成摘要更有价值。
2.2 用于RDKit前处理的典型场景
RDKit真正发挥作用,往往从数据清洗开始。比如SMILES格式修正、去盐、规范化、去重、计算分子描述符。这些操作如果手工做,很容易遗漏。
WorkBuddy在这里的作用,是帮助你明确流程顺序。比如先标准化,再做指纹,再做聚类,最后进入建模。这样比边做边改更稳。
常见流程可以概括为:
- 输入分子列表。
- 统一结构格式。
- 过滤无效或重复分子。
- 计算基本理化性质。
- 进入相似性或分类分析。
流程清楚,后面的RDKit代码才有意义。
2.3 把“会用工具”变成“会做项目”
很多研究者会误以为,掌握某个工具就等于掌握整个方向。其实不是。化学信息学更看重的是问题链条。
例如:
- 为什么选这些分子。
- 为什么用这个描述符。
- 为什么比较这一组结构。
- 为什么要做这个统计分析。
WorkBuddy的优势是,它能把这些问题提前问出来。你在正式跑RDKit之前,就知道自己要输出什么。这能显著减少返工。 对课题设计、文章写作、答辩汇报都很重要。
3. RDKit在化学信息学中的实战价值
3.1 结构处理与基础分析
RDKit最常用的第一步,是结构处理。对很多项目来说,这一步决定了后续分析是否可靠。
常见任务包括:
- 读取SMILES、SDF等格式。
- 生成二维结构图。
- 计算分子量、LogP、TPSA等性质。
- 识别官能团和子结构。
这些结果不是“附加项”,而是后续分析的基础。如果结构输入有问题,后面的任何结论都可能失真。
3.2 指纹、相似性与聚类
在药物发现、先导化合物筛选、天然产物分析中,分子相似性分析非常常见。RDKit可以计算分子指纹,再做Tanimoto相似性比较。这个方法适合快速判断候选分子之间的结构接近程度。
对于大规模化合物库,聚类分析也很实用。它能帮助你看出哪些分子属于同一结构簇,哪些分子更值得优先验证。
如果研究目标是缩小筛选范围,RDKit的指纹分析几乎是必备步骤。
3.3 为机器学习和SAR分析准备数据
化学信息学和机器学习经常联动。但机器学习前最重要的一步,仍然是数据准备。RDKit可以生成描述符、指纹和分子特征矩阵,为后续建模服务。
常见应用包括:
- 活性预测。
- 分类模型构建。
- QSAR/SAR分析。
- 候选分子优先级排序。
这里要注意,模型结果再漂亮,也离不开前期数据质量。RDKit解决的是“可用特征”问题,WorkBuddy解决的是“研究问题”问题。两者结合,才形成闭环。
4. 一个更适合科研人员的组合方式
4.1 先用WorkBuddy建立研究框架
如果你正在做化学信息学课题,建议先让WorkBuddy做三件事。
- 总结研究背景和文献空白。
- 提取可分析的分子信息。
- 生成清晰的实验或计算步骤。
这样做的好处是,你不会一上来就陷入代码细节。先定问题,再定工具,效率更高。
4.2 再用RDKit执行可重复分析
框架定好后,再用RDKit做结构处理、性质计算和相似性分析。这个阶段强调的是可重复性。因为科研不是一次性演示,而是要能复现。
你可以围绕下面的顺序推进。
- 数据导入。
- 结构校验。
- 标准化处理。
- 特征提取。
- 结果可视化。
- 结论回扣研究问题。
这种方式适合课题开题、基金申请、论文方法学部分,也适合组会展示。
4.3 让AI工具服务于科研流程,而不是替代思考
需要明确一点。AI和化学信息学工具都不能替代研究者判断。它们更适合做重复劳动和信息整合。
真正决定项目质量的,还是三个问题。
- 假设是否清楚。
- 数据是否可靠。
- 分析是否可解释。
如果这三个问题成立,WorkBuddy加RDKit就能把你的工作效率推上一个台阶。
5. 如何把效率真正落到结果上
5.1 适合哪些人先用
这个组合特别适合以下人群。
- 刚入门化学信息学的医学生。
- 做药物研发或分子机制研究的医生科研人员。
- 需要快速整理文献和分子数据的课题组成员。
- 准备开题、投稿或基金申请的研究者。
如果你已经知道自己要做什么,但总被“查资料、整理分子、写步骤”拖慢,WorkBuddy会很合适。它能帮你先把任务拆开,再接上RDKit的分析能力。
5.2 典型应用的价值
从实际科研角度看,这种组合能带来三类收益。
- 减少重复劳动。
- 提升方案清晰度。
- 提高分析可复现性。
尤其是当你需要同时处理文献、分子、机制和图表时,效率提升会非常明显。以前要反复切换工具,现在可以更连贯地推进。
5.3 用解螺旋把流程接起来
如果你希望把化学信息学真正做成稳定流程,解螺旋提供的工具和课程资源,可以帮助你把文献、知识库和科研分析串联起来。当WorkBuddy负责信息整理,RDKit负责分子计算,解螺旋则能进一步把方法、案例和工具落到实际科研任务中。 这对想提升开题、写作和项目推进效率的人,帮助很直接。
总结Conclusion
化学信息学的核心,不只是会用工具,而是把问题、数据和分析串成闭环。WorkBuddy适合前端整理与研究设计,RDKit适合结构处理与分子分析。 两者结合,可以显著提升文献处理、分子筛选和课题设计效率。
对医学生、医生和科研人员来说,最有价值的不是“学会更多软件”,而是把科研流程变得更清晰、更可重复、更高效。如果你想进一步把这些能力落地,可以关注解螺旋,把文献、工具和方法整合到同一个科研工作流中。

- 引言Introduction
- 1. 为什么化学信息学需要更高效的工作流
- 2. WorkBuddy如何提升RDKit项目效率
- 3. RDKit在化学信息学中的实战价值
- 4. 一个更适合科研人员的组合方式
- 5. 如何把效率真正落到结果上
- 总结Conclusion