13
 分享
引言Introduction
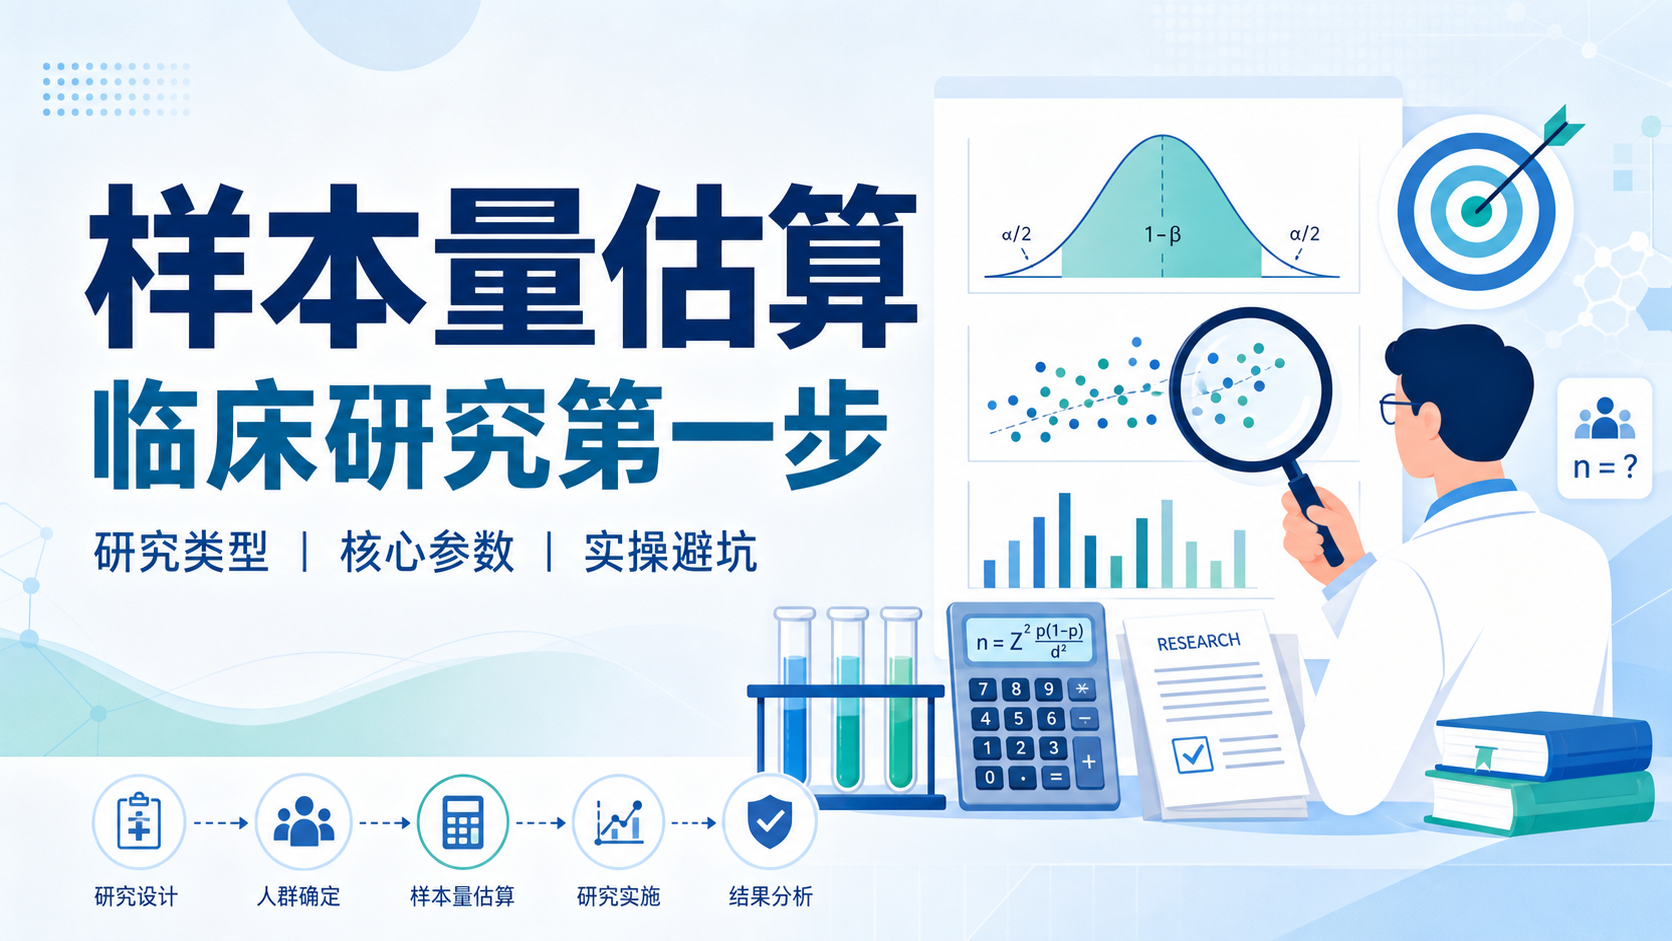
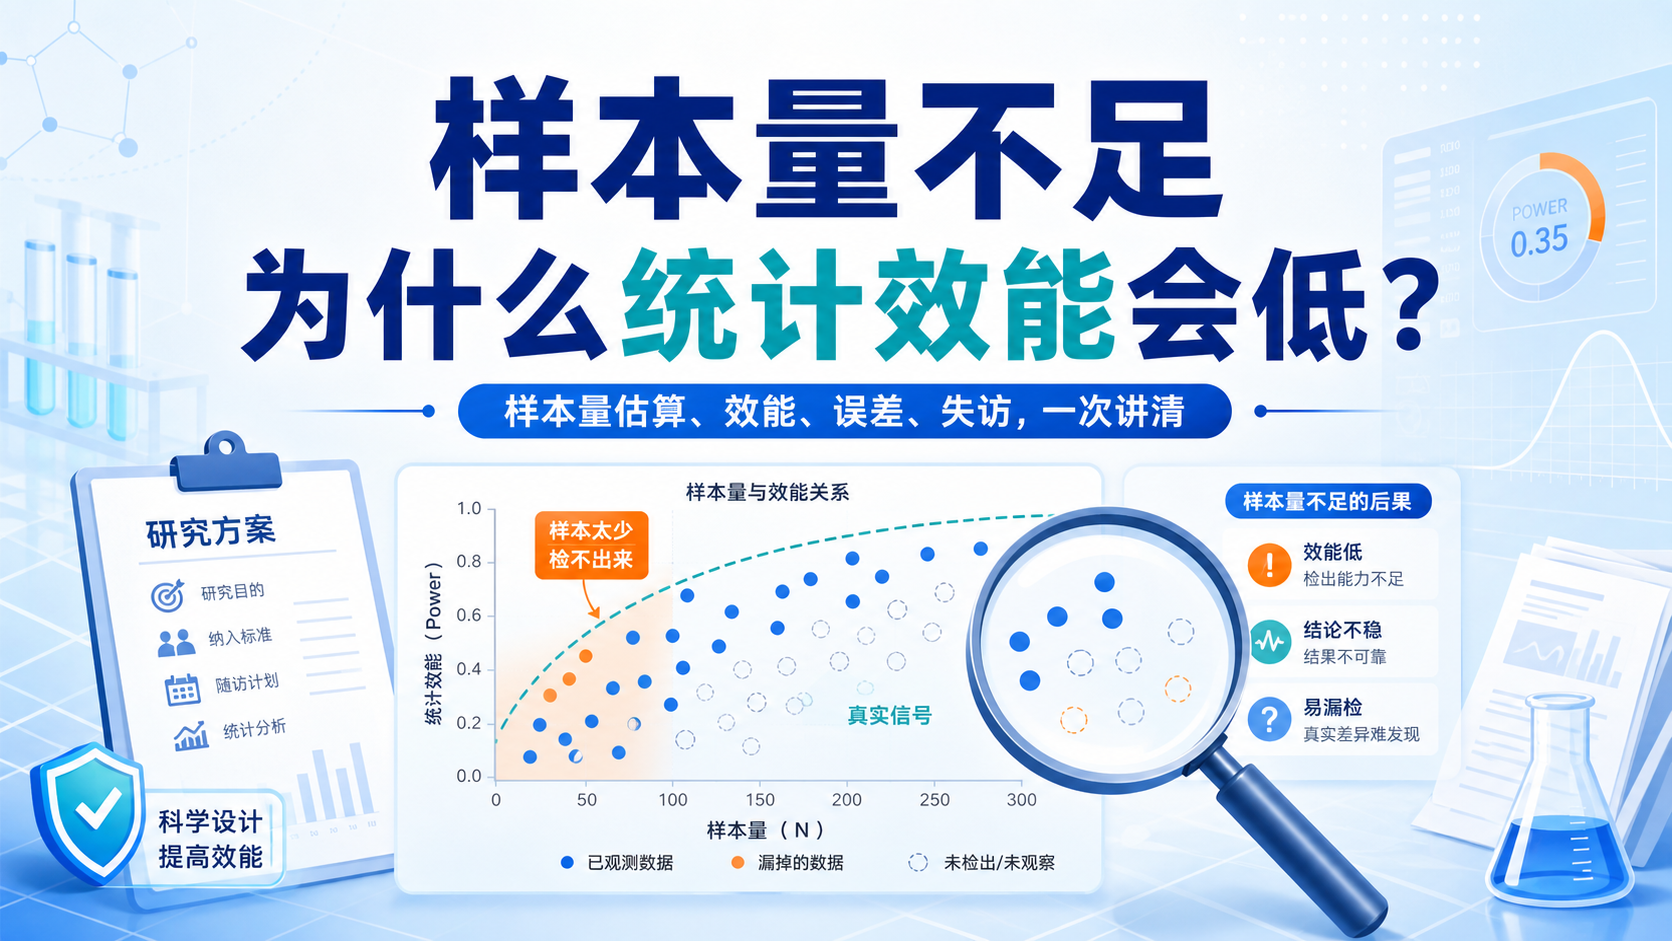
样本量不足,最直接的后果就是统计效能低。结果可能“做出来了”,却检不出真实差异,最后只能得到阴性结论。对医学生、医生和科研人员来说,这不是技术细节,而是研究成败的起点。样本量估算不是补作业,而是研究设计的核心。 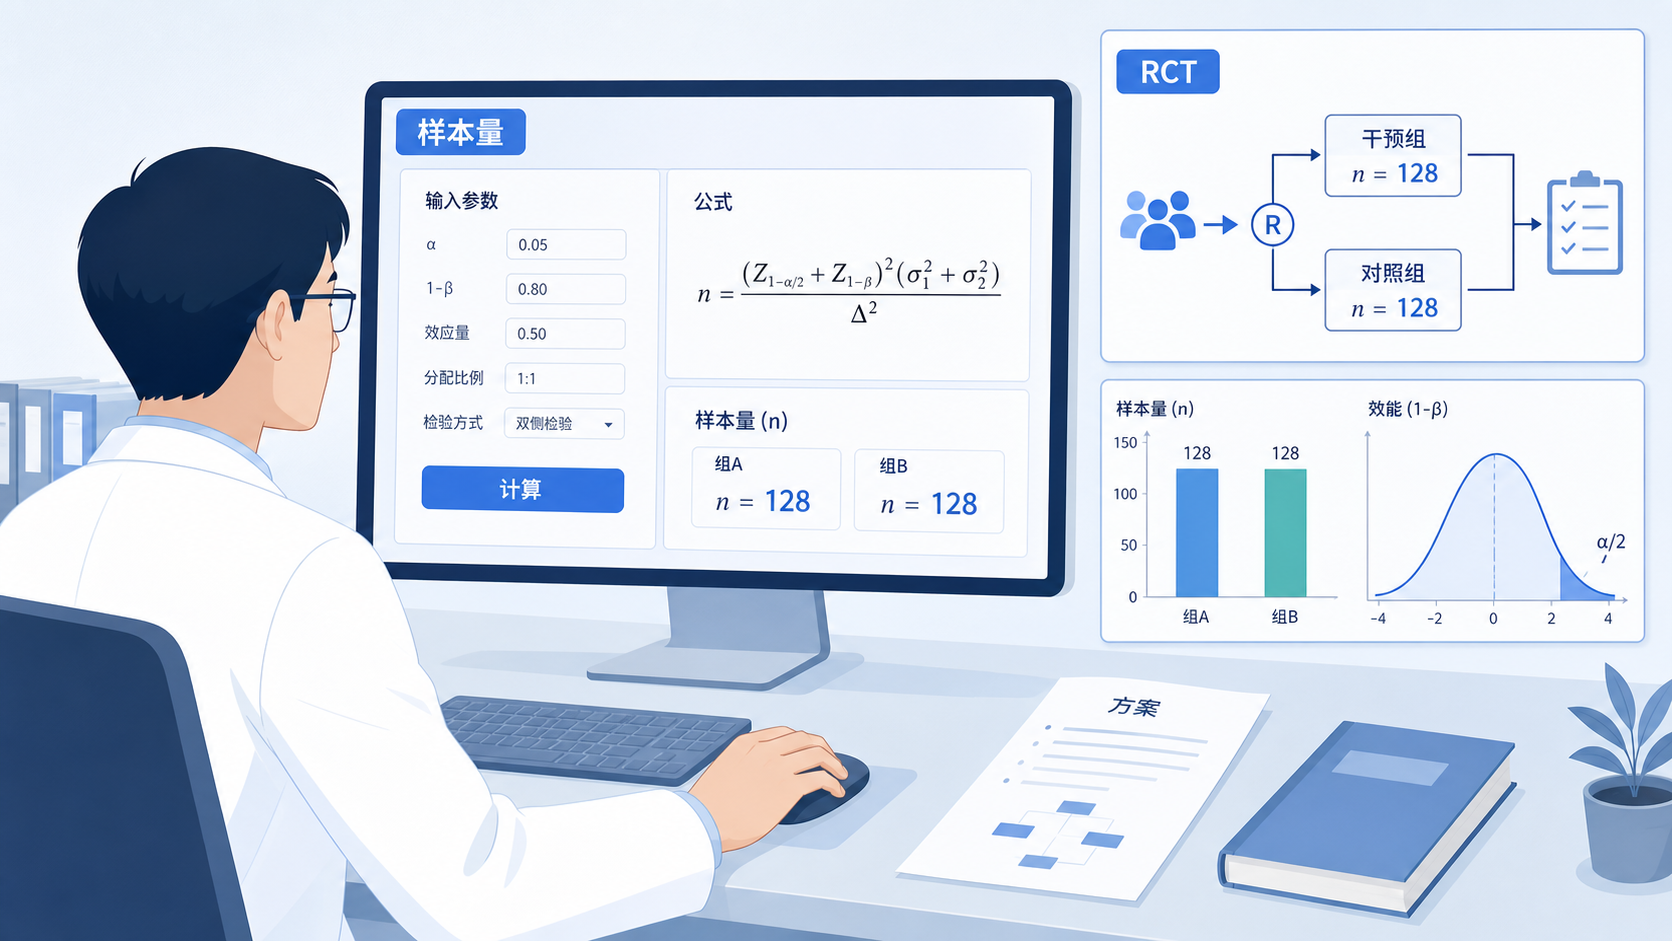
1. 为什么样本量不足会导致统计效能低
1.1 统计效能低,本质上是“检不出来”
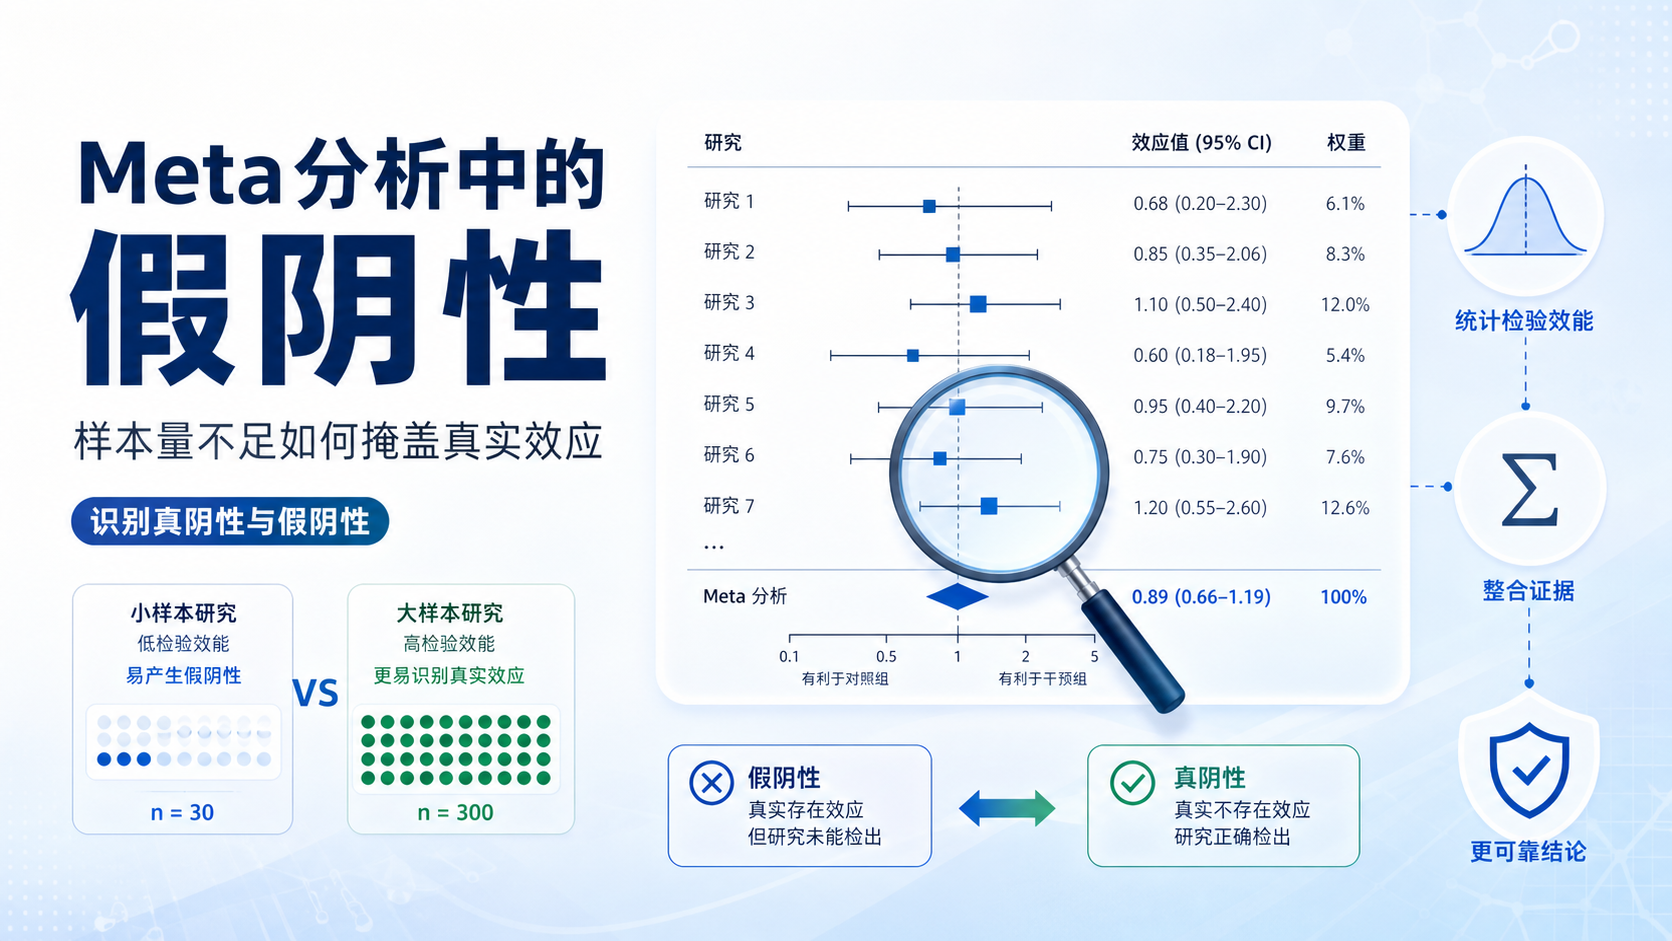
统计效能,通常指 power,也就是 1-β。它表示在真实存在差异时,研究有多大概率把差异检出来。样本量越小,效能越低,二类错误越高。 这意味着你可能把“真的有差异”误判为“没有差异”。
在临床研究里,这类问题非常常见。比如两组药物疗效相差并不大,如果样本量不足,检验结果可能不显著。但这不等于两药真的没有差异,只能说明研究没有足够能力识别差异。
1.2 小样本不仅影响显著性,也影响可信度
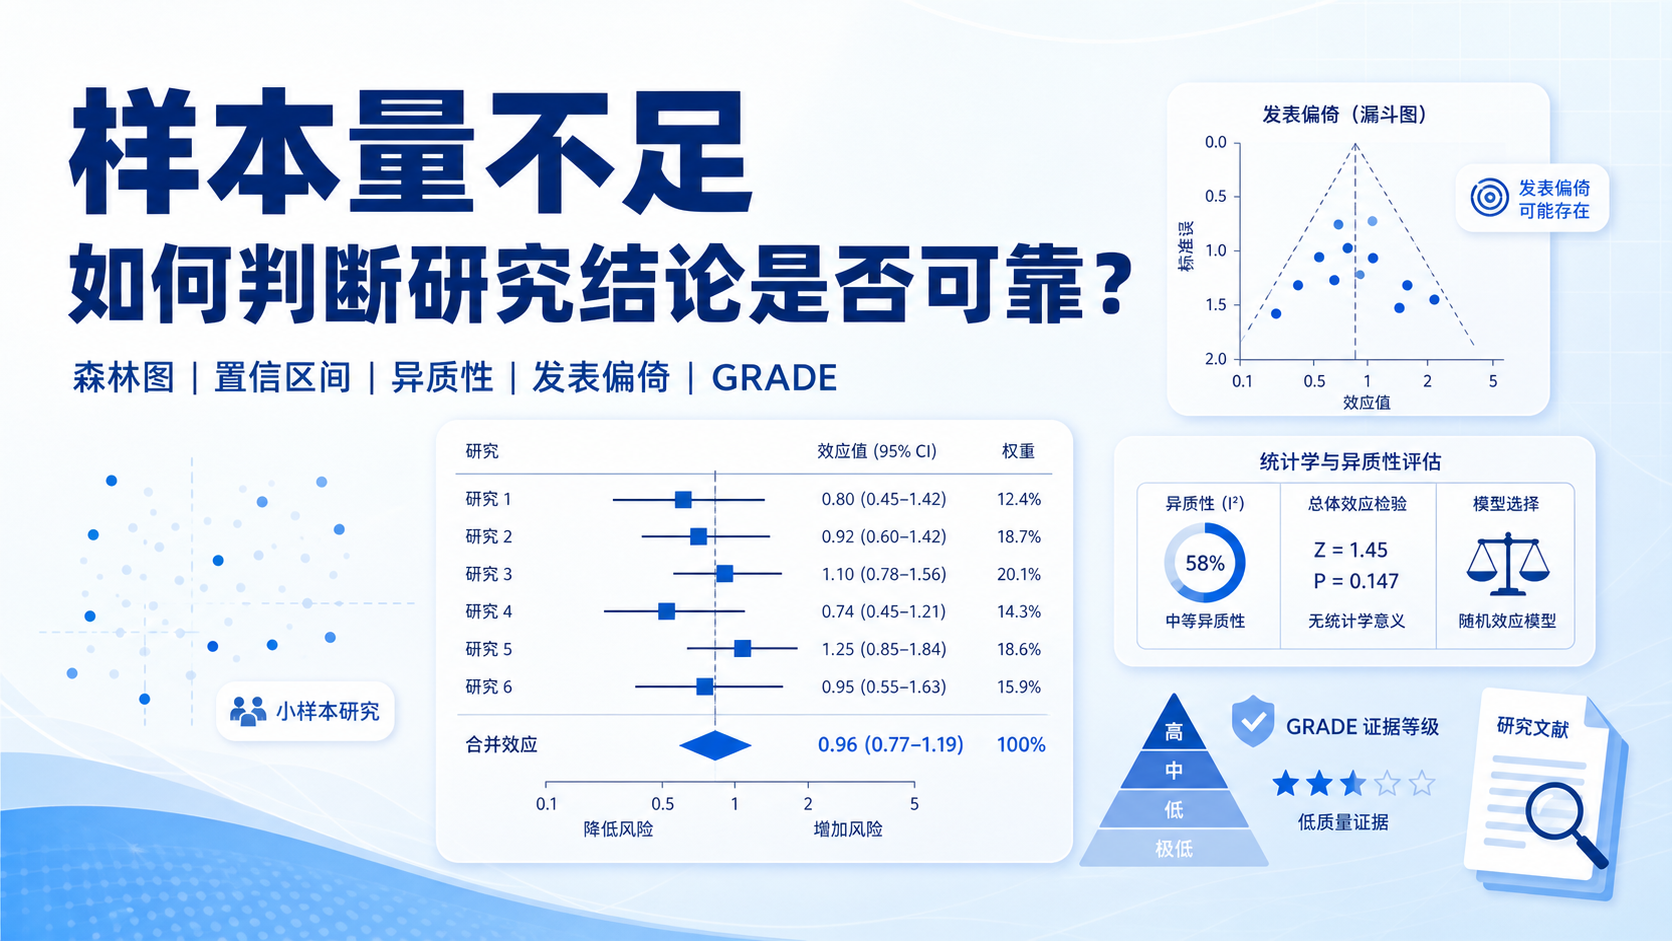
样本量不足会带来两个问题。第一,估计值不稳定,置信区间更宽。第二,结果容易受偶然波动影响。同样的研究设计,小样本更容易出现“今天阳性,明天阴性”的不稳定结论。
对于RCT而言,这种风险尤其重要。因为随机分组后,研究者通常希望通过设计保证组间可比。如果样本太少,随机误差可能放大,组间基线失衡的概率也会上升,后续分析更复杂。
1.3 低效能研究常见于哪些场景
常见场景包括以下几类。
- 罕见病研究,病例获取困难。
- 单中心研究,入组速度慢。
- 预试验直接当正式研究使用。
- 研究目的过多,但样本没有同步增加。
- 只按经验判断样本量,没有正式计算。
只要研究问题明确,样本量估算就必须前置。 如果在研究结束后才补算,往往只能解释,不能真正补救。
2. 样本量估算前,先明确研究目的和设计
2.1 先问“研究要回答什么问题”
样本量不是一个孤立数字,它取决于研究目的。你是想比较两组均数差异,还是比较率的差异,还是做优效、非劣效或等效判断,计算逻辑都不同。
例如:
- 比较两组率差异,用率的假设检验思路。
- 比较两组均数差异,用均数比较思路。
- 生存结局,用生存分析思路。
- 非劣效试验,要先设定非劣效界值。
研究目的不同,样本量公式就不同。 这一步如果错了,后面算得再精细也没有意义。
2.2 再明确结局指标类型
结局指标大致分为三类。
- 计量资料,比如血压、HbA1c、住院天数。
- 计数资料,比如是否复发、是否死亡、是否缓解。
- 时间结局,比如无病生存期、总生存期。
不同变量类型对应不同统计方法。比如连续变量常用 t 检验或方差分析,二分类变量常用卡方检验,时间变量常用 KM 法和 Cox 回归。变量类型决定统计方法,也决定样本量估算路径。
2.3 样本量不是越大越好
很多初学者会认为样本量越大越稳妥,但这并不完整。样本量过大也会增加成本,延长入组时间,甚至把很小的差异放大到临床上并不重要。
所以样本量估算要平衡三件事:
- 统计学可检出性。
- 临床意义。
- 现实可行性。
真正合理的样本量,是“够用且不过量”。
3. 关键参数怎么设定,才不容易把效能算低
3.1 显著性水平 α 要先定
大多数临床研究中,α 常取 0.05。它表示允许把真的当成假的的概率。α 越小,所需样本量越大。
如果采用双侧检验,通常比单侧检验需要更多样本。原因很简单,双侧检验把显著性分散到两端,检验更严格,入组量也要相应增加。
3.2 把握度 power 不要设得太低
临床研究中常见把握度设为 0.80 或 0.90。也就是希望有 80% 或 90% 的概率检出真实差异。如果 power 设得太低,比如低于 0.75,研究结论就更容易被质疑。
这也是为什么很多阴性研究并不一定说明“没有效应”,而可能只是“样本量不够”。
3.3 效应量不能拍脑袋
效应量是样本量计算中最敏感的参数之一。比如两组均数差、两组率差、优效或非劣效界值,都会显著影响样本量。
一个经验原则是,效应量最好来自以下来源:
- 既往高质量文献。
- 同类研究的真实数据。
- 预实验结果。
- 临床上可接受的最小差异。
如果效应量设得过大,样本量会被人为压小。 这会直接造成统计效能低。
3.4 容许误差越小,样本量越大
对于横断面研究,尤其是患病率或均数估计,容许误差是核心参数。容许误差越小,对精度要求越高,样本量越大。
例如,若要估计某病患病率,允许误差从 5% 缩到 2%,所需样本量会显著上升。这个关系不是线性的,而是快速增加的。精度要求每提高一步,样本量成本都会明显上升。
4. 不同研究设计下,如何避免样本量不足
4.1 横断面研究,重点看精度
横断面研究常用于估计患病率、暴露率或均数。此时样本量估算主要关注置信区间宽度和容许误差。
如果研究对象异质性较大,最好适当放大样本量。因为总体波动越大,标准差越大,所需样本量也越大。
4.2 病例对照研究,先看暴露比例
病例对照研究中,样本量常与暴露比例、比值比 OR、病例和对照比例有关。这里最容易出问题的是,把 OR 设得过于乐观,导致样本量过小。
建议优先参考同类文献中的暴露率,而不是凭经验估计。暴露比例估得越准,样本量越接近真实需求。
4.3 队列研究和RCT,重点是结局发生率
前瞻性研究常常依赖结局事件发生率。若事件太少,即使总样本不少,实际有效信息也不足。
对于RCT,除了主要终点,还要考虑:
- 失访率。
- 依从性下降。
- 中途退出。
- 实际招募损耗。
通常应在理论样本量基础上增加一定比例的预留量。不加预留,最后入组数往往会低于目标值。
5. 提升统计效能的实用策略
5.1 优先优化设计,而不是事后补救
如果研究还没启动,最有效的策略不是后期多做分析,而是前期把设计做对。包括明确主要终点、减少不必要分组、控制变量数量。
研究目标越分散,样本量压力越大。聚焦一个主要问题,往往比同时回答多个问题更容易获得足够效能。
5.2 尽量减少无效损耗
样本量足够,并不代表有效样本足够。缺失数据、失访、测量错误、纳排标准执行不一致,都会把有效样本“吃掉”。
建议提前做三件事:
- 完善 CRF 设计。
- 统一研究者培训。
- 预设数据清洗规则。
这能明显减少后期无效数据比例。
5.3 必要时采用分层或协变量调整
当研究存在明显异质性时,简单粗暴地堆样本并不一定最优。合理的分层设计、协变量调整、回归分析,有时能在不大幅增加样本的前提下提高检出效率。
但要注意,多因素模型不是样本量不足的万能补丁。 如果事件数太少,模型仍然不稳定。
5.4 先做敏感性分析
正式立项前,可以做几个情景假设。
- 预期效应量大一点。
- 预期效应量小一点。
- 失访率高一点。
- 失访率低一点。
这样可以看出样本量对关键参数有多敏感。若轻微变化就导致样本量差异巨大,说明研究设计本身就需要再校正。
6. 容易被忽视的三个误区
6.1 把“够发表”当成“够效能”
有些研究只是因为能写文章,就直接开始做。但发表不等于有足够统计把握度。能发出来,不代表结论可靠。
6.2 用最终样本量反推结论
有些作者会在研究结束后,反过来根据已有样本去解释样本量“刚好够”。这种做法说服力有限。样本量估算应在研究启动前完成。
6.3 忽视失访和无应答
横断面研究、前瞻性研究、临床试验都可能面临数据损耗。若不预留,最终纳入样本数会低于计划值,效能自然下降。
样本量表面上达标,不代表有效样本达标。
7. 结语:把样本量算准,才能把研究做稳
统计效能低,往往不是分析方法不够高级,而是样本量起点就偏了。对临床研究来说,样本量估算要先于统计分析,且必须围绕研究目的、结局类型、效应量、α、power 和损耗率综合判断。
真正可靠的研究,不是事后解释得漂亮,而是设计阶段就把样本量算对。 如果你希望把样本量估算、统计方法选择和研究设计一次性理清,可以借助专业团队支持。解螺旋可帮助你把研究问题拆解成可计算、可实施、可发表的方案,减少样本量不足带来的统计效能低问题。
- 引言Introduction
- 1. 为什么样本量不足会导致统计效能低
- 2. 样本量估算前,先明确研究目的和设计
- 3. 关键参数怎么设定,才不容易把效能算低
- 4. 不同研究设计下,如何避免样本量不足
- 5. 提升统计效能的实用策略
- 6. 容易被忽视的三个误区
- 7. 结语:把样本量算准,才能把研究做稳