18
 分享
引言Introduction
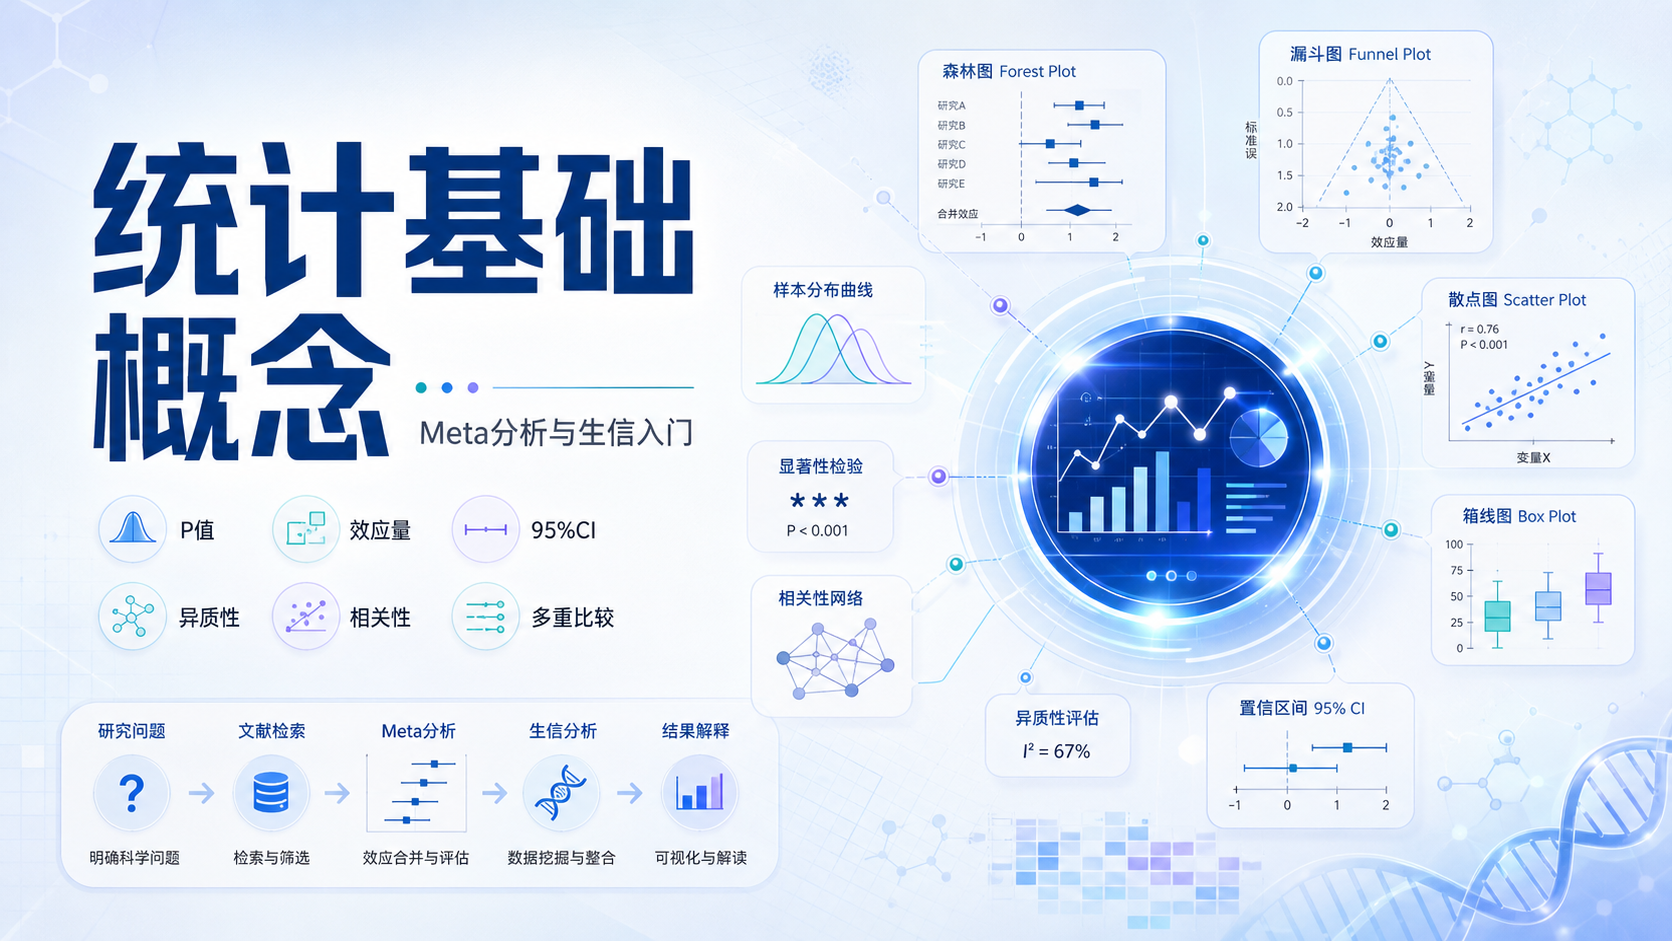
Meta分析和生信入门,最容易卡在统计概念。很多人不是不会做,而是不知道何时选OR、RR、HR,何时看I²,何时判断异质性,最后图和结论都不稳。先把统计基础概念吃透,后面的检索、筛选、分析和写作才有框架。
1.Meta分析与生信为什么都离不开统计基础概念
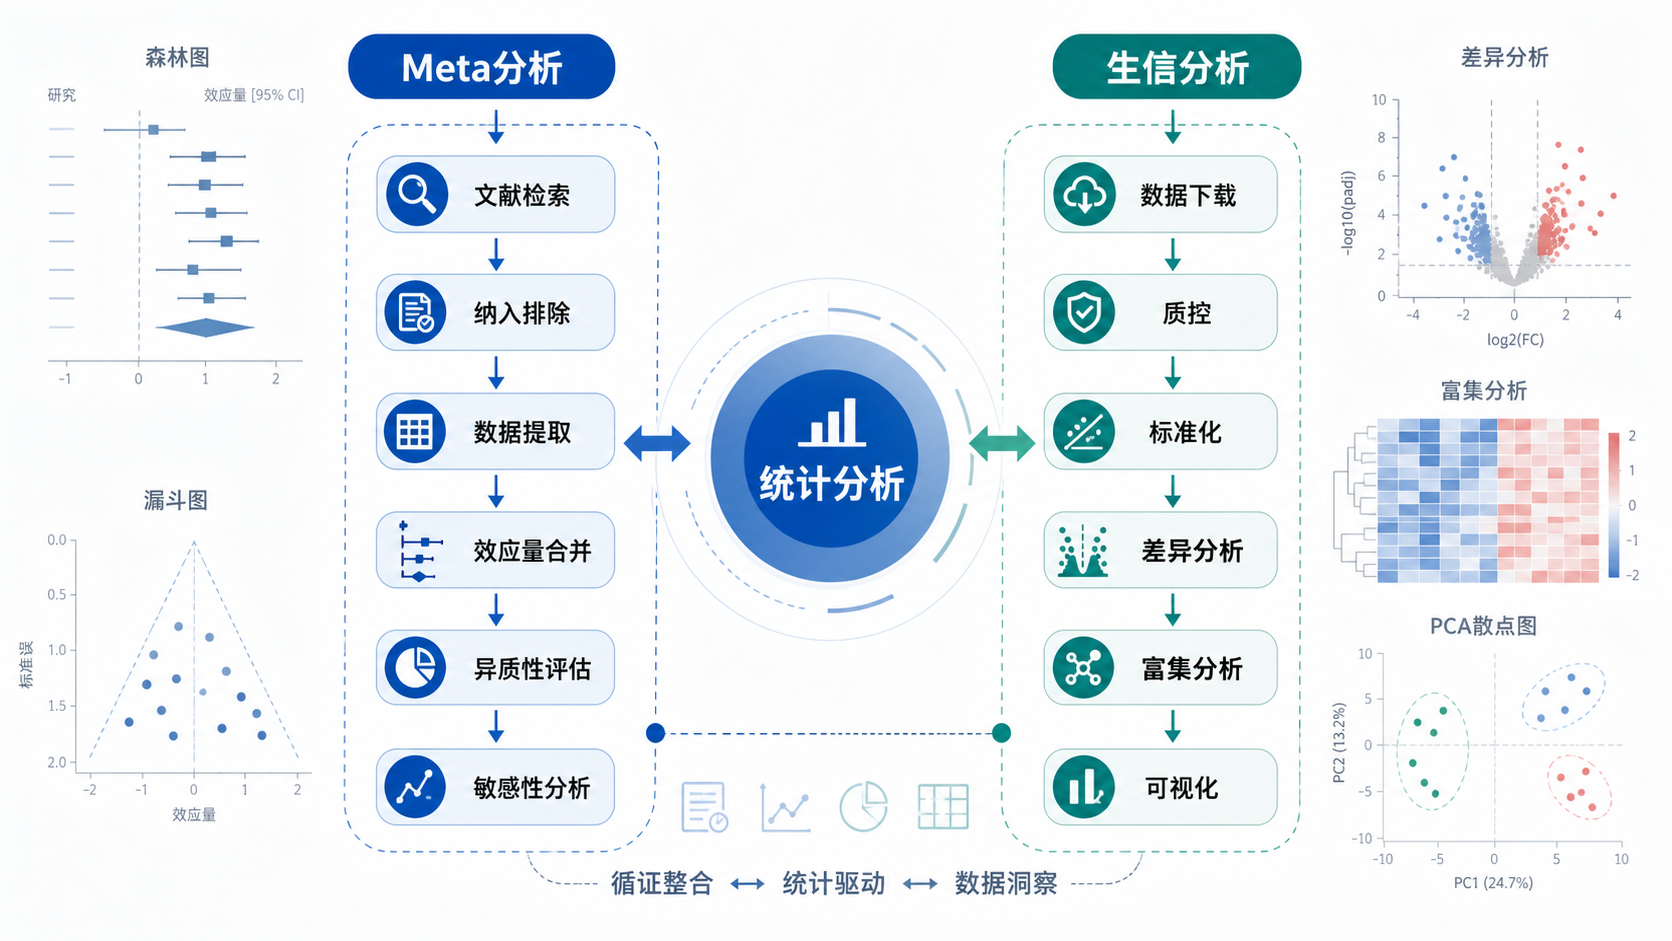
Meta分析本质上是“合并证据”。生信分析本质上是“从大规模数据中找规律”。两者路径不同,但都依赖统计学把数据变成结论。没有统计基础概念,研究就容易停留在图形堆叠,而不是证据整合。
对医学生、医生和科研人员来说,最常见的痛点有三个。
- 指标看不懂。
OR、RR、HR、MD、SMD,经常混用。 - 图不会读。
森林图、漏斗图、火山图、P值、置信区间,各自代表什么不清楚。 - 结论不敢下。
异质性大时怎么解释,偏倚存在时怎么处理,很多人没有判断框架。
在Meta分析中,统计概念直接决定结论是否可信。比如同样是“治疗有效”,若结局是二分类事件,常用OR或RR。若结局是连续变量,则常用MD或SMD。若关注生存结局,则常见HR。指标选错,结论方向都可能偏。
在生信中,统计概念同样关键。差异分析、聚类分析、相关性分析、富集分析、预后模型,都离不开统计假设、显著性阈值、效应量和多重检验校正。能画图不等于能解释图,能出结果不等于能形成可信证据。
2.Meta分析中最先要掌握的统计概念
2.1 效应量是什么,为什么比P值更重要
效应量是“结果有多大”。P值是“这种结果是否可能由随机误差造成”。二者不是一回事。Meta分析真正关注的是效应量,而不是只看P值。
常见效应量包括:
- OR,优势比,常用于病例对照研究和二分类结局。
- RR,相对风险,常用于队列研究和临床结局。
- HR,风险比,常用于生存分析。
- MD,均数差,适合同一量纲的连续变量。
- SMD,标准化均数差,适合不同量纲但同类指标的连续变量。
理解它们的核心方法,是先看研究问题,再看结局类型。
如果结局是“发生与否”,优先考虑OR或RR。
如果结局是“时间到事件”,通常看HR。
如果结局是“数值高低”,再考虑MD或SMD。
2.2 95%置信区间代表什么
置信区间反映估计的不确定性。
区间越窄,说明估计越稳定。
区间越宽,说明样本信息不足,结果波动更大。
在Meta分析里,很多人只盯着合并效应值,却忽略95%CI。实际上,如果95%CI跨过无效线,结论往往就不能说“显著” 。
比如OR的无效线通常是1,MD和SMD的无效线通常是0。
这对临床判断很重要。
统计显著不等于临床有意义。
一个结果即使P<0.05,如果效应量很小,临床价值也可能有限。
2.3 异质性是什么意思
异质性是Meta分析的核心概念之一。它表示纳入研究之间是否“像同一类证据”。异质性高,说明研究结果差异大,不能简单合并。
常用判断包括:
- I² ,衡量异质性比例。
- Q检验 ,判断差异是否超出随机波动。
一般来说,I²越高,异质性越强。
但不能机械套用阈值。
I²只是提示,不是裁判。
异质性来源常见于:
- 人群差异。
年龄、疾病分期、基础病不同。 - 干预差异。
剂量、疗程、方案不同。 - 结局定义差异。
随访时间、终点事件定义不同。 - 方法学差异。
研究设计、偏倚风险不同。
因此,异质性不是“坏事”,而是提醒你去找原因。
亚组分析、敏感性分析、随机效应模型,都是处理异质性的常见工具。
3. 生信分析中最常见的统计基础概念
3.1 显著性检验和多重比较
生信里最常见的是差异分析。
例如RNA-seq、单细胞、蛋白组、甲基化数据,都会比较“组间差异”。
这里最关键的是显著性检验。
通常会同时看:
- log2FC,变化倍数。
- P值,原始显著性。
- FDR或调整后P值,多重比较校正结果。
在高通量数据里,只看P值很危险。
因为一次分析往往同时检验成千上万个基因。
如果不做多重校正,假阳性会明显增加。
所以,生信研究更常强调FDR。
这也是为什么文章方法部分经常要写清楚阈值,如FDR < 0.05,|log2FC| > 1。
这些不是装饰,而是决定结果可信度的门槛。
3.2 分布、抽样与样本量
统计基础概念里,分布和样本量非常重要。
很多生信数据默认并不服从正态分布。
很多临床变量也存在偏态、离群值、批次效应。
因此,不能想当然地用均值和标准差解释一切。
要先判断数据特征,再选方法。
比如:
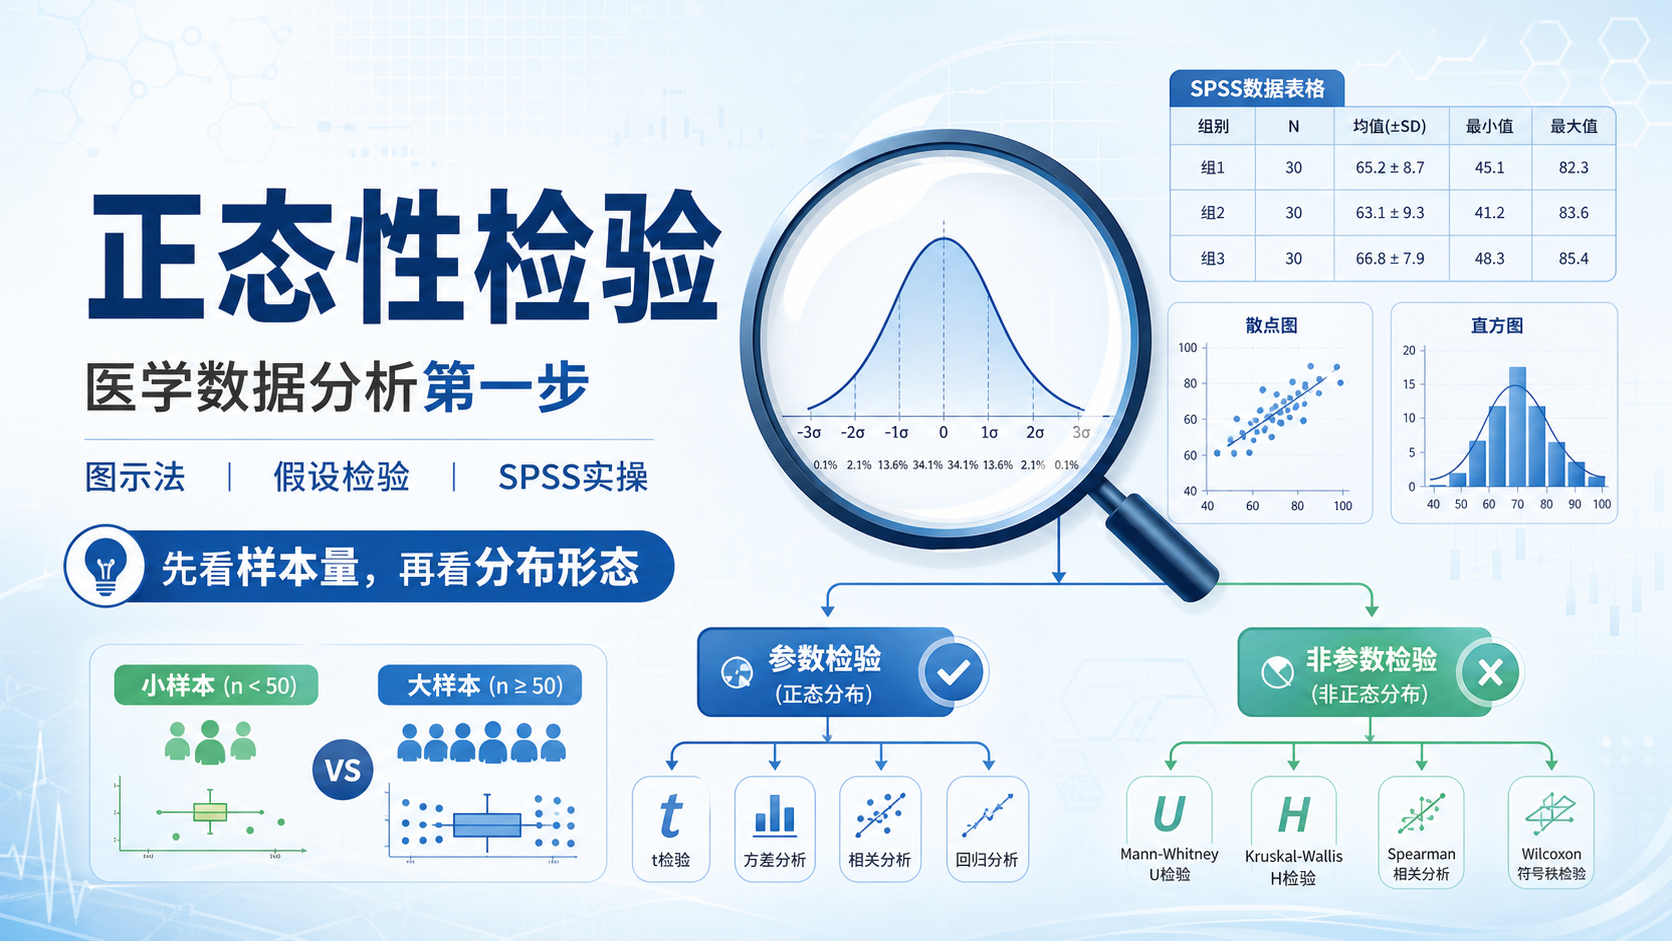
- 正态分布时,可考虑t检验。
- 非正态分布时,可考虑秩和检验。
- 分类变量可考虑卡方检验或Fisher精确检验。
样本量也决定稳定性。
样本太少,容易过拟合。
样本足够,结果更稳健。
这也是为什么外部验证数据集在生信研究中非常重要。训练集能发现规律,验证集才能说明规律可复现。
3.3 相关性不等于因果关系
这是统计基础概念里最容易被误解的一点。
相关性只能说明两个变量一起变化,不能证明谁导致谁。
在生信中,某基因与预后相关,不代表它一定是致病驱动因子。
在Meta分析中,某干预与结局相关,也不自动等于因果关系成立。
结论必须和研究设计匹配。
如果是观察性研究,要谨慎解释。
如果是随机对照试验,因果推断更强。
如果只是数据库分析,更要避免过度推论。
4. 从统计概念到研究流程,怎么真正用起来
4.1 先定问题,再定指标
Meta分析和生信入门,都不是先做图,而是先定义问题。
问题不同,统计策略就不同。
可以按这个顺序思考:
- 研究对象是谁。
- 结局是什么。
- 数据类型是什么。
- 该用什么统计量。
- 是否需要分层或校正。
例如,Meta分析如果研究“某药是否降低死亡率”,核心结局是二分类事件,统计量就要围绕RR或OR。
如果研究“某基因是否影响生存”,就要考虑HR。
如果研究“治疗后指标变化多少”,则要考虑MD或SMD。
4.2 结果要会读,也要会写
统计结果不是只给自己看的。
写作时必须把统计含义说清楚。
建议至少交代四点:
- 效应量是什么。
- 置信区间是多少。
- 是否存在异质性。
- 结果是否经过校正或敏感性检验。
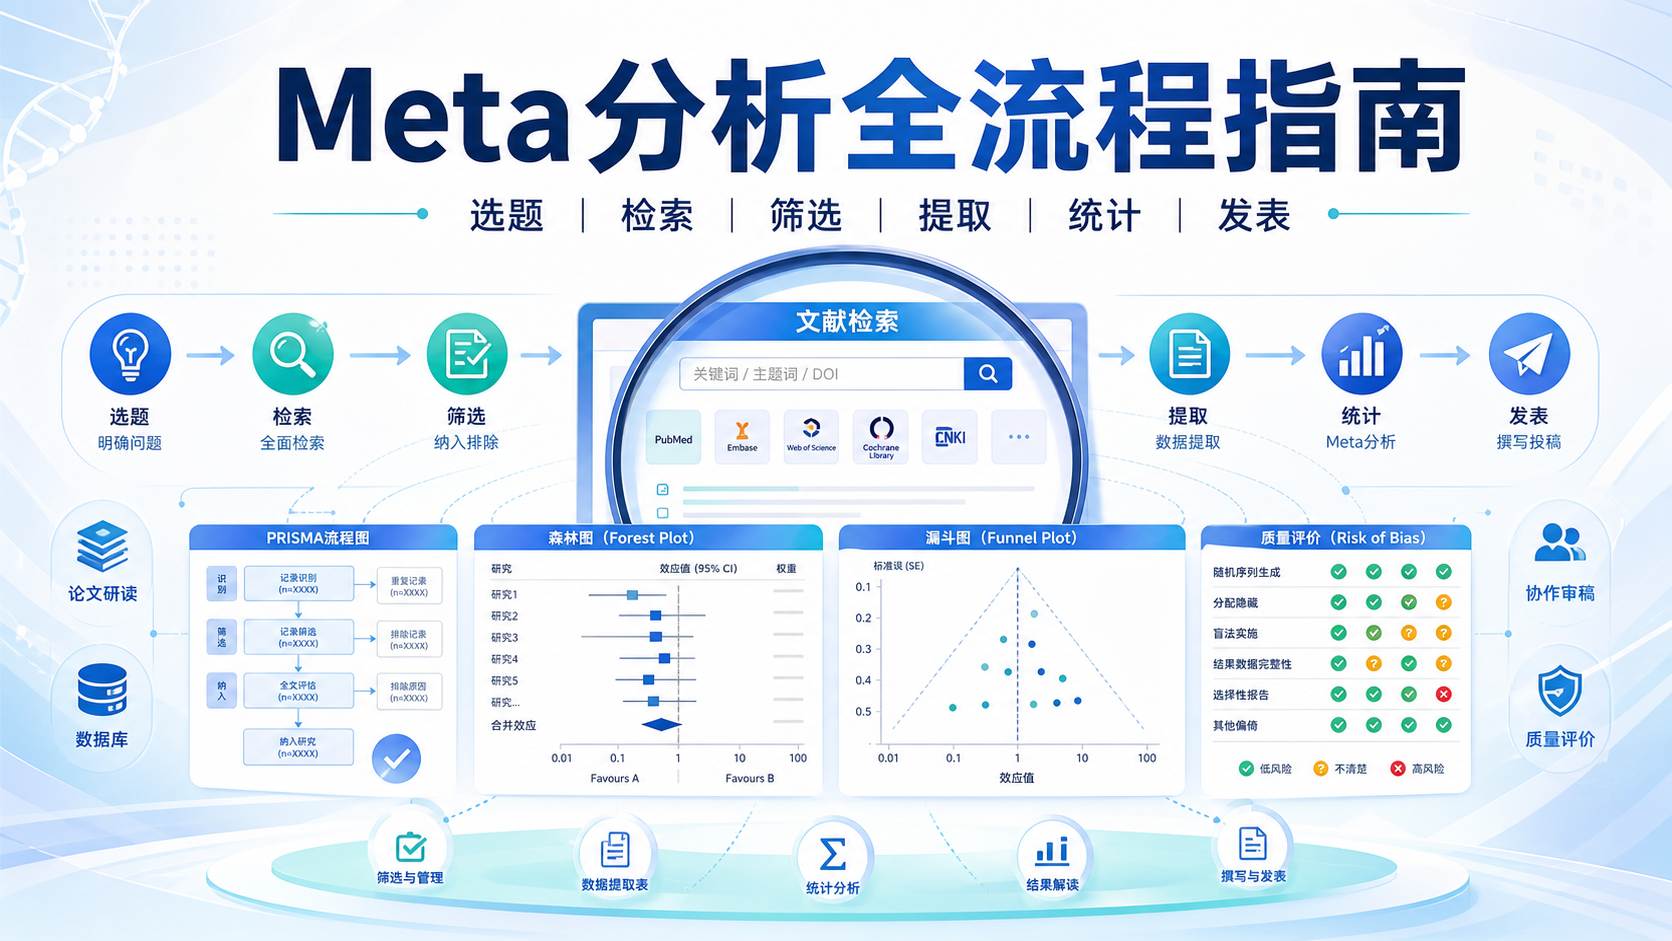
在Meta分析中,PRISMA 2020强调透明报告。
在生信中,也应说明数据来源、筛选标准、统计阈值和验证方法。
报告越清楚,研究越容易复现,可信度越高。
4.3 图表背后必须有统计逻辑
森林图不是“越多越好”。
漏斗图也不是“画出来就代表没有偏倚”。
火山图、热图、ROC曲线、KM曲线,同样不是装饰图。
你需要理解:
- 森林图看效应方向和合并结果。
- 漏斗图看发表偏倚可能性。
- 火山图看差异大小与显著性。
- KM曲线看不同分组的生存差异。
- ROC曲线看模型或指标的区分能力。
图只是结果的可视化,统计逻辑才是结论的基础。
5. 统计基础概念如何帮助你少走弯路
对初学者来说,最实用的建议不是“多做题”,而是先建立统计框架。
你只要把几个问题想明白,后续学习会快很多:
- 这是分类变量还是连续变量。
- 是横断面、队列,还是随机试验。
- 是单组比较,还是多组比较。
- 是关联分析,还是生存分析。
- 是否存在批次效应、混杂因素和多重比较。
一旦框架清晰,Meta分析和生信就不再是碎片化操作,而是可解释、可复现的研究流程。
如果你希望把统计概念真正落到项目里,解螺旋可以帮你把检索、筛选、数据提取、统计分析和论文写作串成一条线。对于Meta分析和生信初学者来说,这种结构化支持能显著降低试错成本,也更容易把结果做实、把文章写顺。
总结Conclusion
Meta分析与生信入门,表面上是方法学习,核心上是统计基础概念的建立。你需要先分清效应量、P值、置信区间、异质性、多重比较和相关性这些关键问题,再进入具体操作。统计框架越清晰,研究越稳,结论越可信。
如果你正在准备Meta分析或生信项目,建议从统计概念开始梳理,再进入检索、筛选、分析和写作。想让项目更快落地,可以关注并使用解螺旋,让研究流程更规范,少走弯路。
- 引言Introduction
- 1.Meta分析与生信为什么都离不开统计基础概念
- 2.Meta分析中最先要掌握的统计概念
- 3. 生信分析中最常见的统计基础概念
- 4. 从统计概念到研究流程,怎么真正用起来
- 5. 统计基础概念如何帮助你少走弯路
- 总结Conclusion