10
 分享
引言Introduction
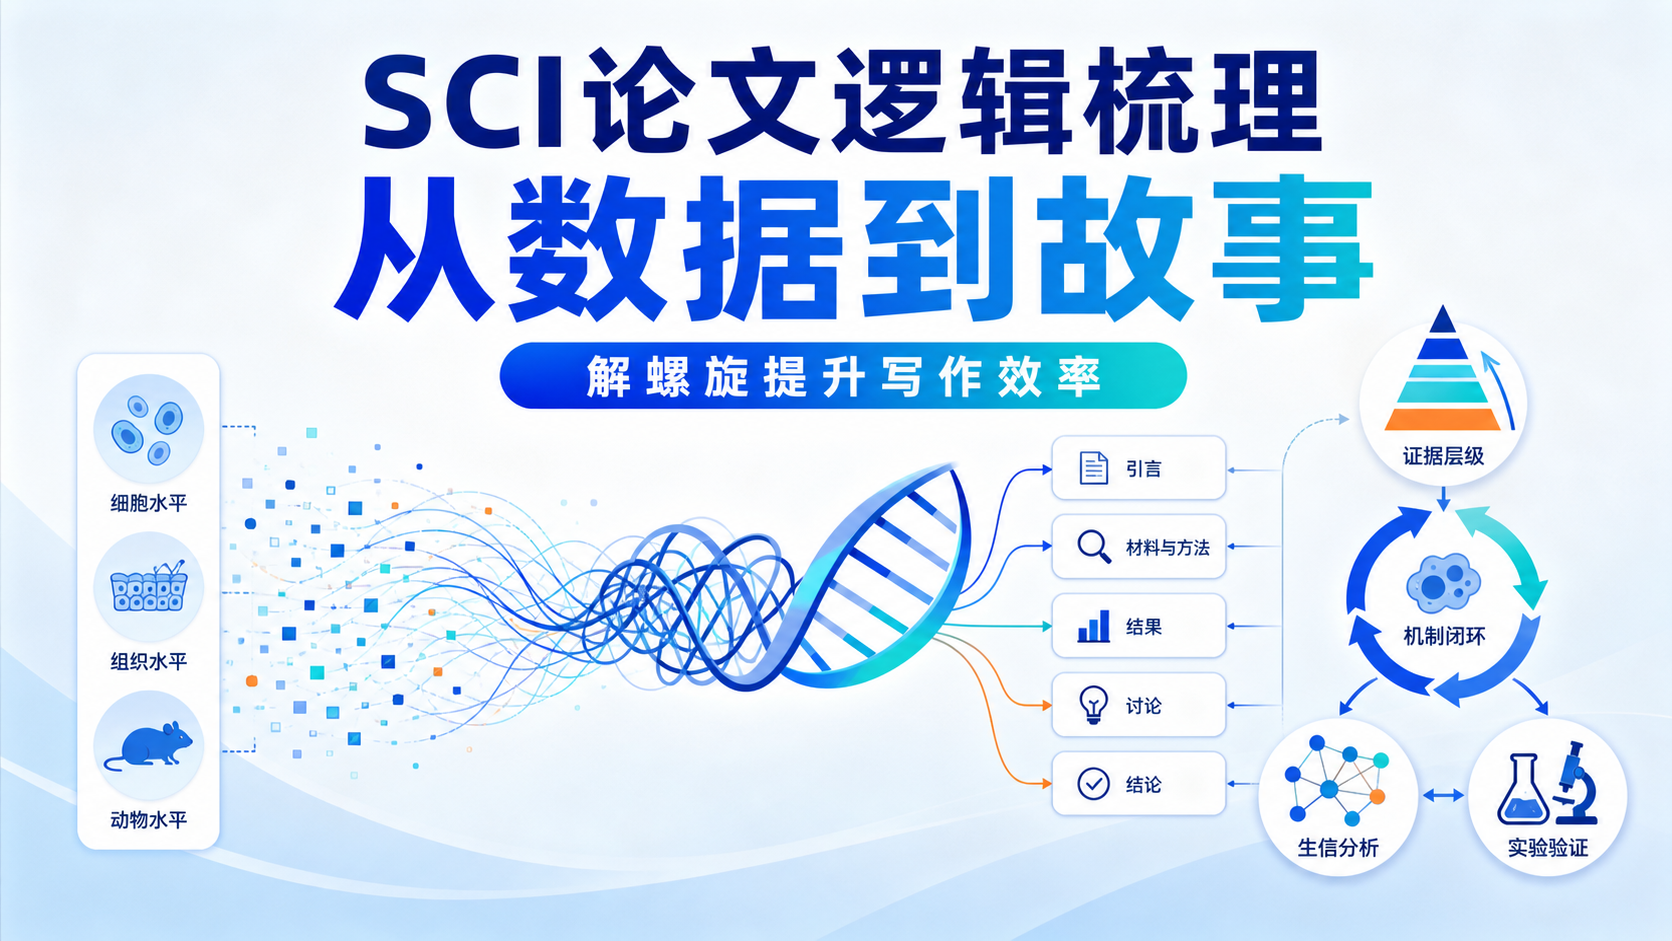
很多SCI论文不是数据不够,而是数据之间没有形成清晰的逻辑链 。结果是图很多,故事却散。对医学生、医生和科研人员来说,真正的难点不是“做实验”,而是把数据转化成可验证、可推进、可发表的科学叙事。
1. 为什么SCI论文首先要做逻辑梳理
1.1 数据多,不代表故事强
一篇基础研究论文常见的数据来源包括细胞、动物、组织标本和生信分析。这些数据本身并不自动构成结论,必须先判断它们各自承担什么论证任务。 否则,文章会出现“每张图都对,但整篇文章不成立”的问题。
从文献阅读和写作的角度看,数据最容易被误用的地方有两个。
第一,是把相关性数据写成因果。
第二,是把机制数据写成现象描述。
这两类错误在SCI论文里非常常见,也最影响审稿人对文章严谨性的判断。
1.2 逻辑梳理的本质,是先定证据角色
同一组数据,在不同位置承担的论证任务完全不同。
组织标本更适合回答“是否相关”。
细胞实验更适合回答“是否影响表型”。
分子机制实验更适合回答“为什么会发生”。
动物实验则用于补强细胞层面的因果链。
生信分析通常用于提供候选分子、通路线索,帮助建立研究起点或机制方向。
如果不先区分这些角色,后续写作就会失去层次感。论文看起来像实验汇报,而不是科学论证。
2. 按证据层级重构论文结构
2.1 组织水平:先建立相关性
组织水平数据通常来自患者样本、病理切片、临床数据库或原位检测。它的核心任务不是证明机制,而是回答:这个分子、通路或表型,是否与疾病相关。
这类数据常见的写法是:
- 疾病组与对照组存在差异。
- 指标与临床分期、预后或严重程度相关。
- 原位表达与病理表型一致。
需要注意的是,组织水平数据通常只能支持相关性,不能直接推出因果关系。
这是写SCI论文时最容易被忽略的一点。很多文章在这一层就开始过度解读,导致逻辑跳跃。
2.2 细胞水平:先证明功能,再进入机制
细胞实验一般分为两层。
一层是功能验证。
一层是机制拆解。
功能验证解决的是“有没有影响”。例如增殖、迁移、侵袭、凋亡、炎症反应、氧化应激等表型变化。通常需要做一正一反 ,即上调和下调都观察到对应变化。这样论证才完整。
机制层面的难点更高。因为这里涉及信号通路、调控关系、蛋白互作、转录调节或RNA网络。机制不是简单再测一个指标,而是要证明‘谁调控谁,怎么调控’。
如果只有现象,没有调控关系,故事就停在表面。
2.3 动物水平:把细胞结论拉回整体系统
动物实验的任务,是把细胞层面的发现放回到生理系统中验证。
常规做法通常是验证以下内容:
- 单变量是否影响疾病表型。
- 机制链条在体内是否成立。
- 干预后是否能逆转表型。
但要注意,动物实验通常用于验证调控和表型,不是完整解析交互位点的最佳场景。
如果要在动物水平证明精确交互位点,往往需要更复杂的转基因模型。对大多数课题来说,这并不是必要条件。
3. 真正决定故事质量的是机制闭环
3.1 机制链条必须能回推
高质量SCI论文的核心,不是“我观察到了变化”,而是我能把变化一层层回推到源头。
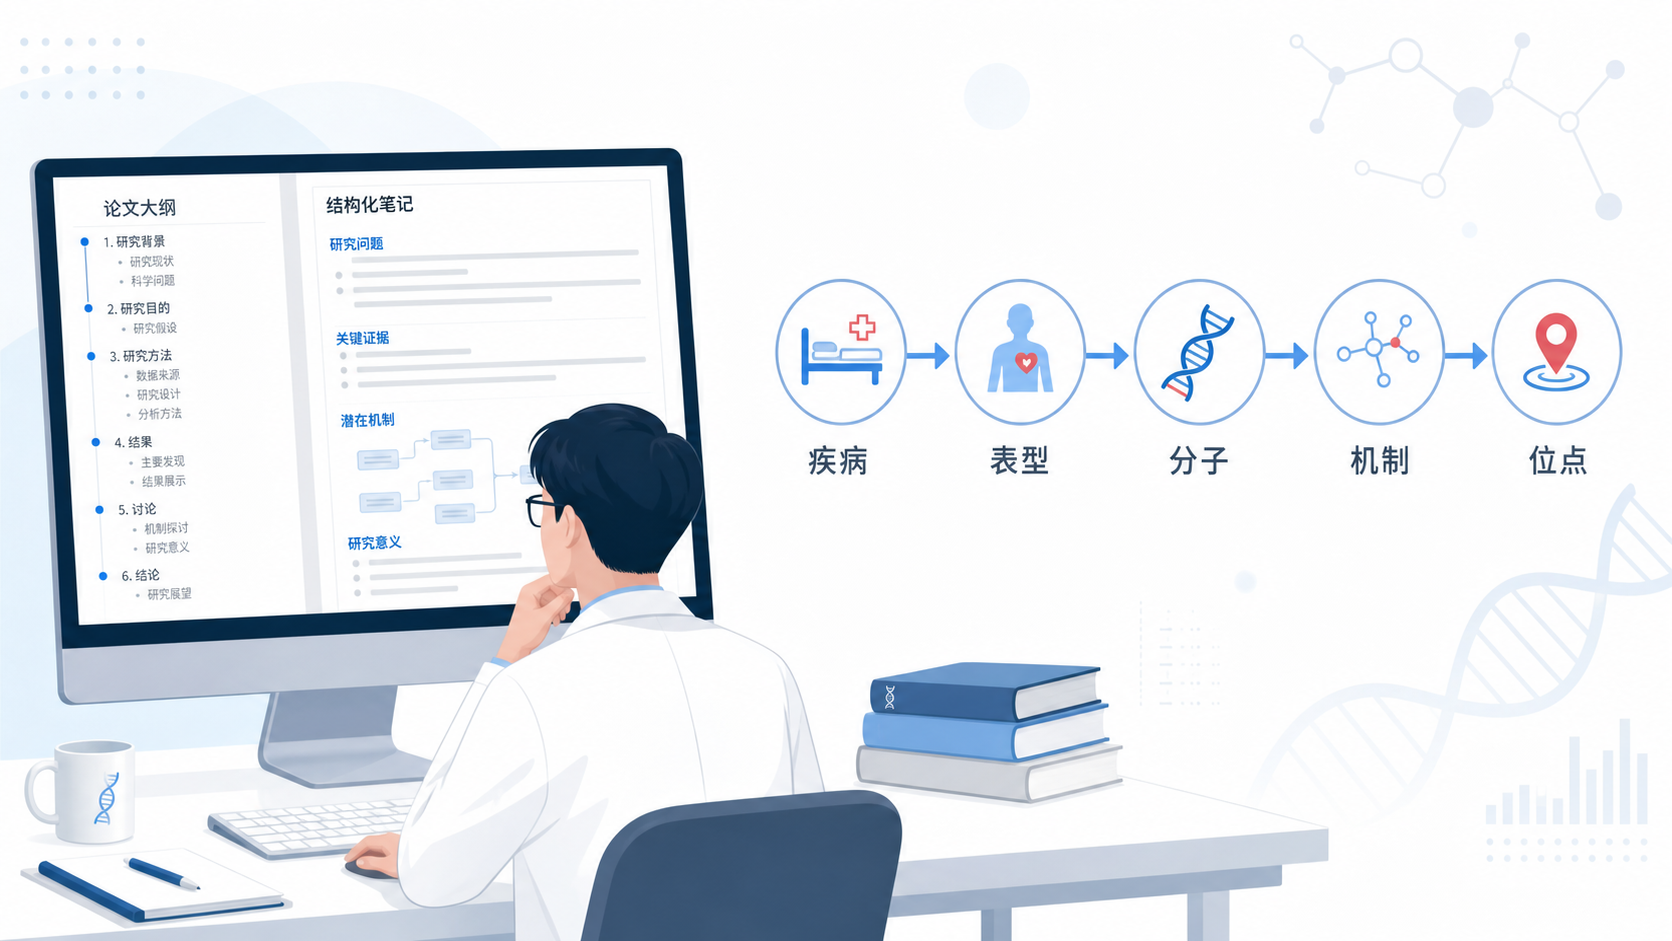
一篇完整的基础研究文章,通常需要回答这几个问题:
- 疾病为什么会出现。
- 表型为什么会改变。
- 哪个分子参与了改变。
- 该分子通过什么调控关系起作用。
- 调控依赖什么交互作用。
- 交互作用是否存在位点基础。
这就是从宏观到微观的逻辑递进。
没有位点,交互不够硬。没有交互,调控不成立。没有调控,表型变化就缺少机制支撑。
3.2 回复实验是机制成立的关键
在机制研究中,回复实验非常关键。
如果你做了敲低或过表达,却没有做回复,审稿人很容易认为证据链不闭合。
例如:
- 敲低后表型变弱。
- 再恢复关键分子后,表型被救回。
- 这说明该分子确实位于调控链的核心位置。
回复实验的价值,在于证明“因果关系可逆”。
这比单纯展示一个阳性结果更有说服力,也更符合E-E-A-T中的专业性与可信度要求。
3.3 交互位点决定机制是否“做全”
很多文章只做到了“有互作”或“有调控”,但没有进一步定位位点。
这会让机制停留在半套。
位点解析的意义在于证明:
- 互作不是偶然的。
- 该结构域或特定位点是必要的。
- 突变后,互作消失。
- 互作消失后,调控和表型也随之失效。
这是一种从结构到功能的严谨闭环。
对SCI论文来说,这类数据通常能显著提升论证密度。
4. 生信分析如何服务论文逻辑
4.1 生信不是装饰,而是线索来源
在当前医学研究中,生信分析已经成为常见入口。
它的作用不是替代实验,而是帮助回答两个问题:
- 研究主变量怎么找。
- 机制候选怎么筛。
生信数据本质上服务于“起点”和“方向”。
它可以告诉你哪些分子值得验证,哪些通路值得深入,哪些临床差异值得解释。
常见使用场景包括:
- 从公开数据库筛选差异分子。
- 通过富集分析寻找通路方向。
- 结合预后分析确定候选主变量。
- 为细胞和动物实验提供假设基础。
4.2 但生信不能替代实验验证
这一点必须强调。
生信可以提出假设,但不能独立完成机制闭环。
没有实验验证的生信结果,只能算线索,不能算结论。
因此,论文写作时要避免把生信结果写得过满。正确做法是:
- 用生信确定候选。
- 用实验验证表达和功能。
- 用机制实验确认调控关系。
- 用动物实验增强体内可信度。
这样,故事链才完整。
5. 从数据到故事的标准转化路径
5.1 先搭框架,再填数据
SCI论文逻辑梳理最有效的方法,是先搭框架,再决定放什么数据。
不是先有图,再去拼故事。
而是先有假设,再看每类数据是否承担了相应职责。
可按以下顺序整理:
- 临床或疾病问题是什么。
- 核心表型是什么。
- 可能的关键分子是谁。
- 该分子如何影响表型。
- 机制是否存在调控关系。
- 调控是否依赖交互位点。
- 体内是否可重复。
只要这条链能闭合,论文就具备了基本的故事骨架。
5.2 写作时用“证据递进”而不是“结果堆砌”
很多初学者的论文问题,不是实验少,而是表达顺序不对。
正确的写法应该是证据递进:
- 先讲问题。
- 再讲相关性。
- 再讲功能。
- 再讲机制。
- 再讲验证。
- 最后回到疾病意义。
如果直接堆结果,读者会失去方向。
如果每一步都在回答前一步的问题,文章就会非常顺。
6. 用解螺旋提升SCI论文逻辑梳理效率
6.1 让数据更快变成可发表的故事
对于很多医学生和科研人员来说,最大痛点不是不会做实验,而是不知道怎么把实验组织成论文逻辑 。
这时,最需要的是一套可复用的梳理方法,而不是零散经验。
解螺旋的价值,就在于帮助你快速识别:
- 哪类数据对应哪一层证据。
- 哪些结果是相关性。
- 哪些结果是功能验证。
- 哪些结果是机制闭环。
- 哪些结果还缺回复或位点解析。
当你能用统一标准拆解数据时,写作效率会明显提高,返工率也会下降。
6.2 结语前的关键建议
如果你正在做课题整理,建议先别急着写结果。
先做三件事:
- 画出论文逻辑链。
- 给每张图标注证据角色。
- 检查是否缺少回复、位点或体内验证。
很多论文不是败在数据少,而是败在逻辑断点。
把断点补上,文章就更接近一篇完整、严谨、可发表的SCI论文。
总结Conclusion
SCI论文逻辑梳理的核心,不是把数据罗列出来,而是把数据组织成一条可验证的科学故事线。从组织相关性,到细胞功能,再到分子机制、交互位点和动物验证,每一层都要服务于下一层。 只有这样,论文才真正做到从数据走向结论,从结果走向故事。
如果你希望更高效地完成选题拆解、证据分层和论文框架搭建,建议借助更系统的方法工具。解螺旋可以帮助你把零散数据快速梳理成清晰的论文逻辑,减少返工,提高成稿质量。
- 引言Introduction
- 1. 为什么SCI论文首先要做逻辑梳理
- 2. 按证据层级重构论文结构
- 3. 真正决定故事质量的是机制闭环
- 4. 生信分析如何服务论文逻辑
- 5. 从数据到故事的标准转化路径
- 6. 用解螺旋提升SCI论文逻辑梳理效率
- 总结Conclusion