6
 分享
引言Introduction
SCI论文里的数据误差,往往不是“一个数字写错”这么简单。它可能来自实验、统计、作图,甚至是结果表述不严谨。如果不提前识别源头,后续修改成本很高,甚至影响论文可信度。 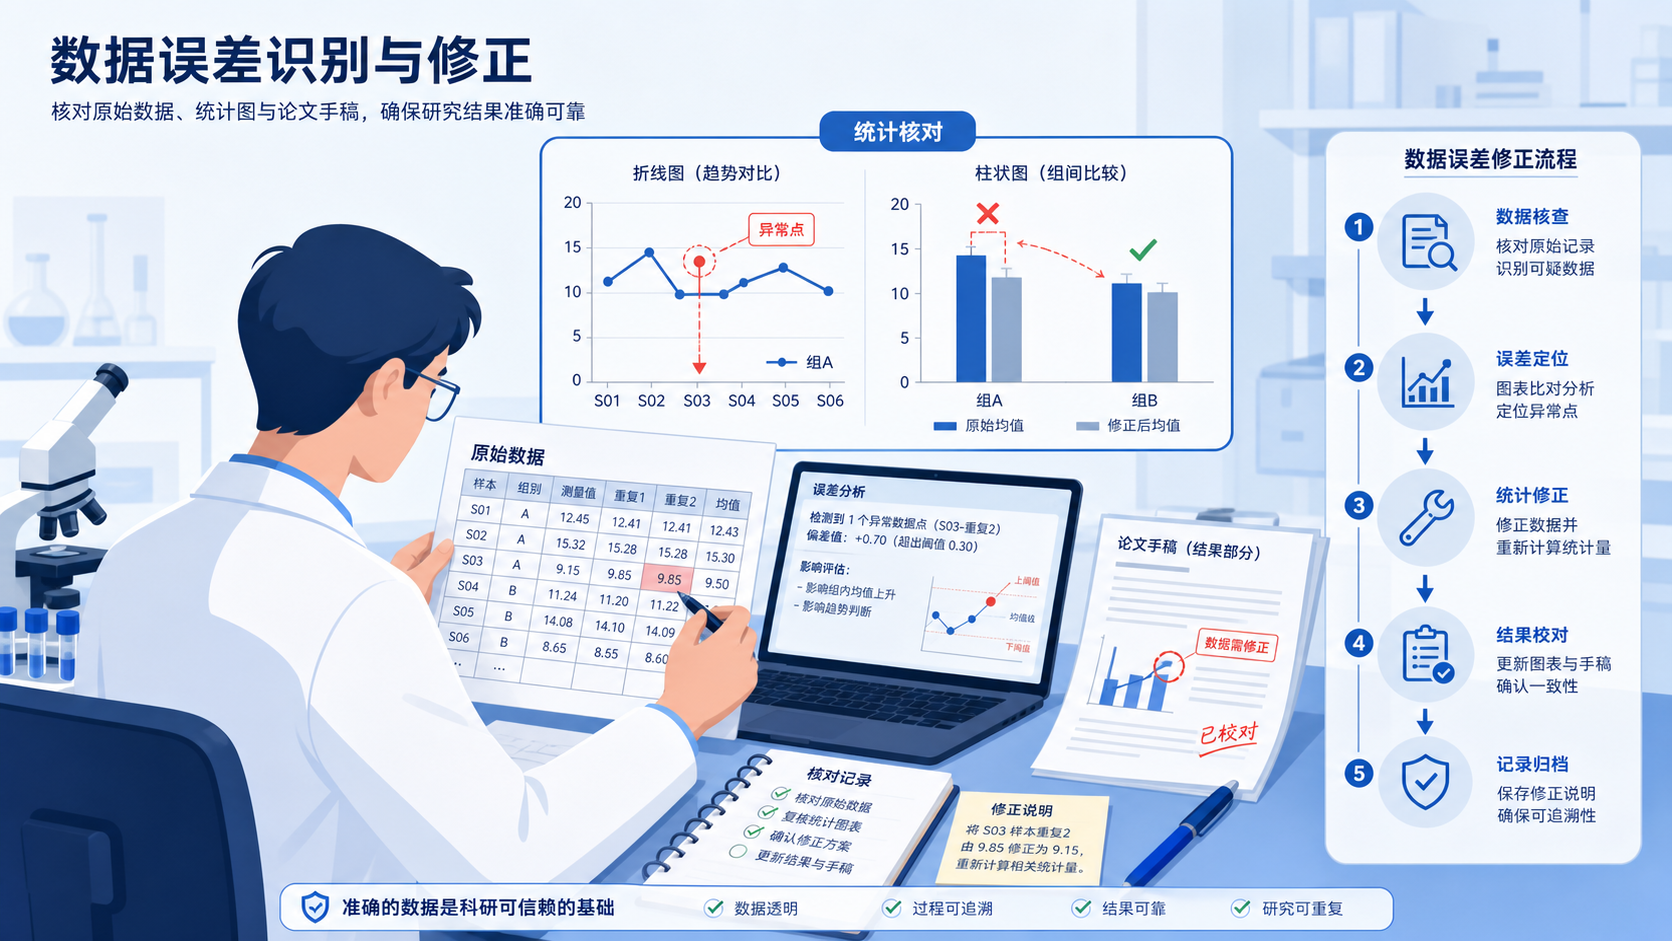
1. 数据误差从哪里来
1.1 实验环节的误差
数据误差最常见的来源,是实验本身。样本混淆、试剂批次差异、仪器校准偏移、操作时间不一致,都会把真实信号“拉歪”。
在基础研究中,这类误差尤其隐蔽。比如细胞计数受成像阈值影响,qPCR受内参选择影响,Western blot受曝光时间影响。同一批样本,不同操作者得到的结果不一致,往往不是生物学差异,而是操作波动。
1.2 统计环节的误差
很多论文的问题,不在原始数据,而在统计处理。常见情况包括:
- 分组定义前后不一致。
- 漏掉异常值处理说明。
- 误把均值和中位数混用。
- 选择不恰当的检验方法。
例如,数据明显偏态,却直接使用t检验。或者重复测量数据被当作独立样本处理。这类错误会直接影响P值和结论方向。
1.3 结果表述中的误差
结果部分的误差,常常表现为语言和逻辑错误。知识库中提到,结果写作要避免高阶、含混词汇,要注意时态、单复数和主谓一致。比如:
- 不要用模糊词代替明确结论。
- “our data demonstrates”应注意主语和谓语一致。
- “cells increased”不如“the number of cells increased”准确。
结果写作不是修辞比赛,而是证据呈现。表达不清,本身就是一种误差。
2. 如何识别数据误差的类型
2.1 先分清是随机误差还是系统误差
随机误差通常表现为离散分布,重复实验之间有波动,但总体方向稳定。系统误差则更危险,它会持续把结果推向同一个方向。
如果你发现所有实验组都比预期高,或者所有对照组都偏低,就要优先怀疑系统误差。常见原因包括:
- 仪器未校准。
- 试剂失效。
- 计算公式写错。
- 录入模板错误。
随机误差影响精度,系统误差影响准确度。
2.2 用原始数据回溯问题
判断误差,不能只看最终图表。必须回到原始记录。建议按以下顺序检查:
- 原始实验记录。
- 数据录入表。
- 统计脚本或软件设置。
- 作图文件。
- 论文中的最终表述。
如果论文图中数值和原始表格不一致,先查转录过程。若统计结果和原始数据逻辑不符,再查分析方法。回溯链条越完整,越容易定位误差源。
2.3 关注“看起来合理”的错误
最容易遗漏的,往往是表面上很合理的错误。比如:
- 误把百分比写成倍数。
- 折线图坐标轴单位遗漏。
- 图注和正文结论不一致。
- 标题中缩写使用不规范,读者无法判断对象。
知识库强调,题目和结果都要突出重点,避免过于宽泛和冗余。这个原则同样适用于数据分析。越是看起来顺手的表达,越要核对定义。
3. 结果部分如何减少误差放大
3.1 模块化写结果,减少串错
结果撰写最怕一段话塞入太多信息。建议按实验模块拆分,每个小节只回答一个问题。这样更容易发现数据来源、变量和结论是否匹配。
例如:
- 先写表型变化。
- 再写机制验证。
- 最后写补充分析。
这种结构能减少“上一段的数据,被下一段引用错”的问题。模块化写作,是控制数据误差传播的第一步。
3.2 统一时态、主语和单位
结果部分通常用一般过去式。数据、蛋白、mRNA、细胞数这些名词要统一单复数。单位也要前后一致,比如ng/mL、μM、cells/well。
常见错误包括:
- 主语和谓语不一致。
- 单复数混乱。
- 同一指标在不同图中单位不同。
- 图例和正文写法不统一。
这些问题看似是语法错误,实质上会造成数据理解偏差。一篇SCI论文,表达错误常常就是数据误差的外显形式。
3.3 让结论和证据强度匹配
不要把相关性结果写成因果结论,不要把探索性数据写成定论。尤其在结果部分,要避免过度解释。
更稳妥的写法是:
- “suggested”用于提示趋势。
- “indicated”用于描述结果支持。
- “demonstrated”只用于证据足够充分时。
结论强度必须跟证据等级匹配。 这是避免结果误导读者的核心原则。
4. 严谨规避数据误差的实操策略
4.1 建立三层核对机制
建议在写作和投稿前建立三层核对:
- 第一层,实验者自检。
- 第二层,同组成员复核。
- 第三层,独立审阅原始数据和图表。
这三层核对能明显降低转录错、统计错和表述错。尤其在多图、多组、多终点研究中,多人交叉检查比单人反复修改更有效。
4.2 统一数据管理模板
为了避免人工错误,建议从一开始就统一模板:
- 样本编号固定。
- 分组名称固定。
- 统计口径固定。
- 图表命名固定。
- 缩写首次出现时写全称。
如果一个项目里同一指标出现多个版本,很容易在投稿时混淆。模板化管理不是形式主义,而是降低误差率的基础设施。
4.3 投稿前做“反向检查”
所谓反向检查,就是从结论倒推数据。先看最后一句结论,再去找支持它的图、表和统计值。
重点核对三件事:
- 结论是否真的被数据支持。
- 图注是否准确对应正文。
- 统计显著性是否与文字描述一致。
如果结论、图表和统计三者不闭环,就说明仍有误差风险。
5. 出现数据误差后怎么办
5.1 小错误要及时更正
如果只是拼写、标点、轻微排版错误,且不影响结论,通常不必过度处理。但如果是图表排版、数值录入或统计逻辑错误,就应尽快更正。
知识库提到,严重排版错误或数据问题需要向编辑说明并提供依据。态度要诚恳,说明错误位置、影响范围和修正内容。越早更正,越能减少后续误解。
5.2 不要回避问题
很多研究者担心承认错误会影响文章形象。实际上,真正影响信誉的,往往是隐瞒错误。科研传播最重要的是可追溯和可验证。
如果读者或审稿人指出问题,应立即回查原始数据、脚本和图表。能修正的修正,不能修正的明确说明。诚信处理,比强行辩解更符合学术规范。
5.3 用专业工具降低重复错误
在实际写作中,很多错误并非研究能力不足,而是流程缺少规范化工具。比如结果段落的术语不统一、主谓一致错误、标题冗余、数据描述不清,都会让论文质量打折。
这也是很多研究者会选择专业平台辅助写作和校对的原因。像解螺旋 这类科研写作支持工具,适合帮助你在结果撰写、术语统一、逻辑梳理和规范表达上做前置检查。把低级错误挡在投稿前,才是最高效的误差控制。
总结Conclusion
SCI论文的数据误差,来源通常包括实验、统计、作图和文字表达四个层面。要真正降低风险,关键不是事后补救,而是从源识别开始,建立原始数据回溯、三层核对和结论反向检查机制。数据准确,结果才可信,论文才有学术说服力。
如果你正在处理结果撰写、图表核对或投稿前修订,建议尽早建立标准化流程,也可以借助解螺旋 提升写作和校对效率。让错误止步于草稿阶段,才是SCI论文稳妥发表的关键。
- 引言Introduction
- 1. 数据误差从哪里来
- 2. 如何识别数据误差的类型
- 3. 结果部分如何减少误差放大
- 4. 严谨规避数据误差的实操策略
- 5. 出现数据误差后怎么办
- 总结Conclusion