27
 分享
引言Introduction
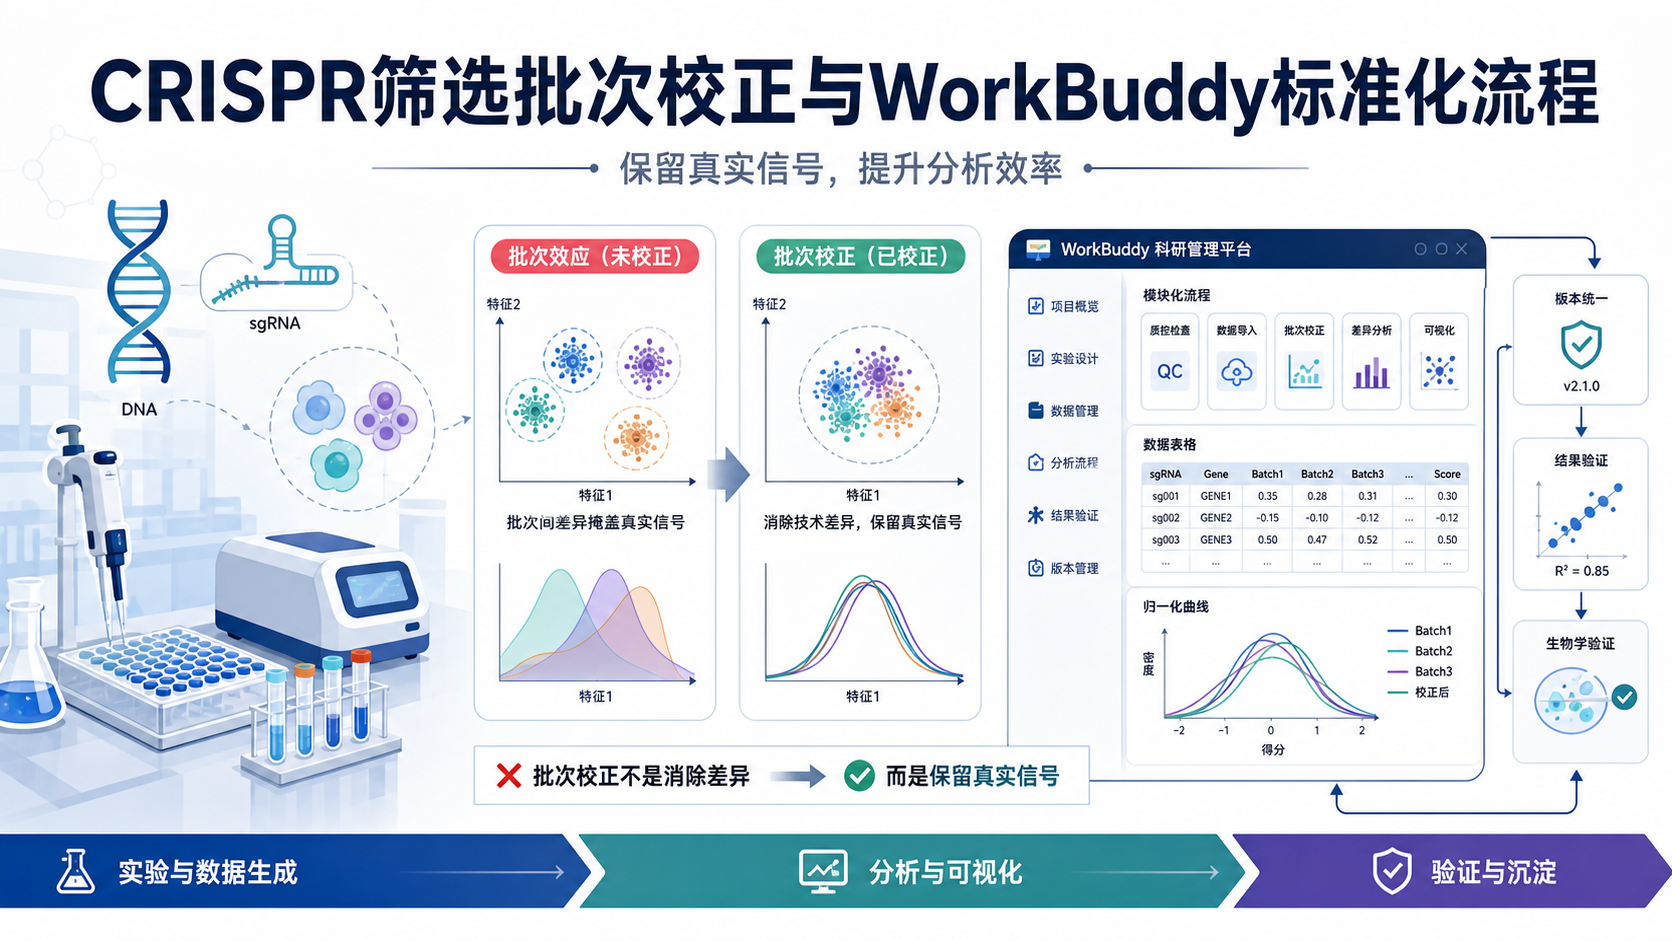
CRISPR筛选最常见的痛点,不是“不会做”,而是不同批次之间结果漂移,导致命中基因不稳定、重复性差、后续验证难 。对医学生、医生和科研人员来说,真正影响文章质量的,往往就是这一步的批次校正与流程管理。
1. 为什么CRISPR筛选必须做批次校正
1.1 批次效应会直接改变筛选结论
CRISPR筛选通常依赖sgRNA丰度变化来判断基因是否影响表型。但现实中,不同批次的文库构建、病毒滴度、感染效率、细胞状态和测序深度都可能引入系统偏差 。这会让同一个sgRNA在不同批次中呈现不同富集或耗竭趋势。
如果不做校正,常见问题包括:
- 假阳性升高,非真实命中被误判为候选基因。
- 假阴性增加,真实信号被批次噪音淹没。
- 多批次整合后,重复实验相关性下降。
对于筛选类研究,批次效应不是边缘问题,而是决定结果能否发表的核心问题 。
1.2 批次校正的目标不是“消除差异”,而是保留真实信号
批次校正的原则很明确。它不是把所有样本强行拉平,而是尽量去除技术偏差,保留生物学差异 。
这意味着你需要先区分两类变量:
- 技术变量,例如批次、建库日期、测序平台、操作人员。
- 生物学变量,例如处理组、对照组、时间点、药物剂量。
如果把生物学差异误当作批次校正掉,结果会失真。反之,如果把技术偏差保留下来,命中基因会被污染。
所以,批次校正的关键,是在分析前就完成变量分层和批次标注 。
2. WorkBuddy如何把CRISPR筛选流程标准化
2.1 先把筛选流程拆成可管理模块
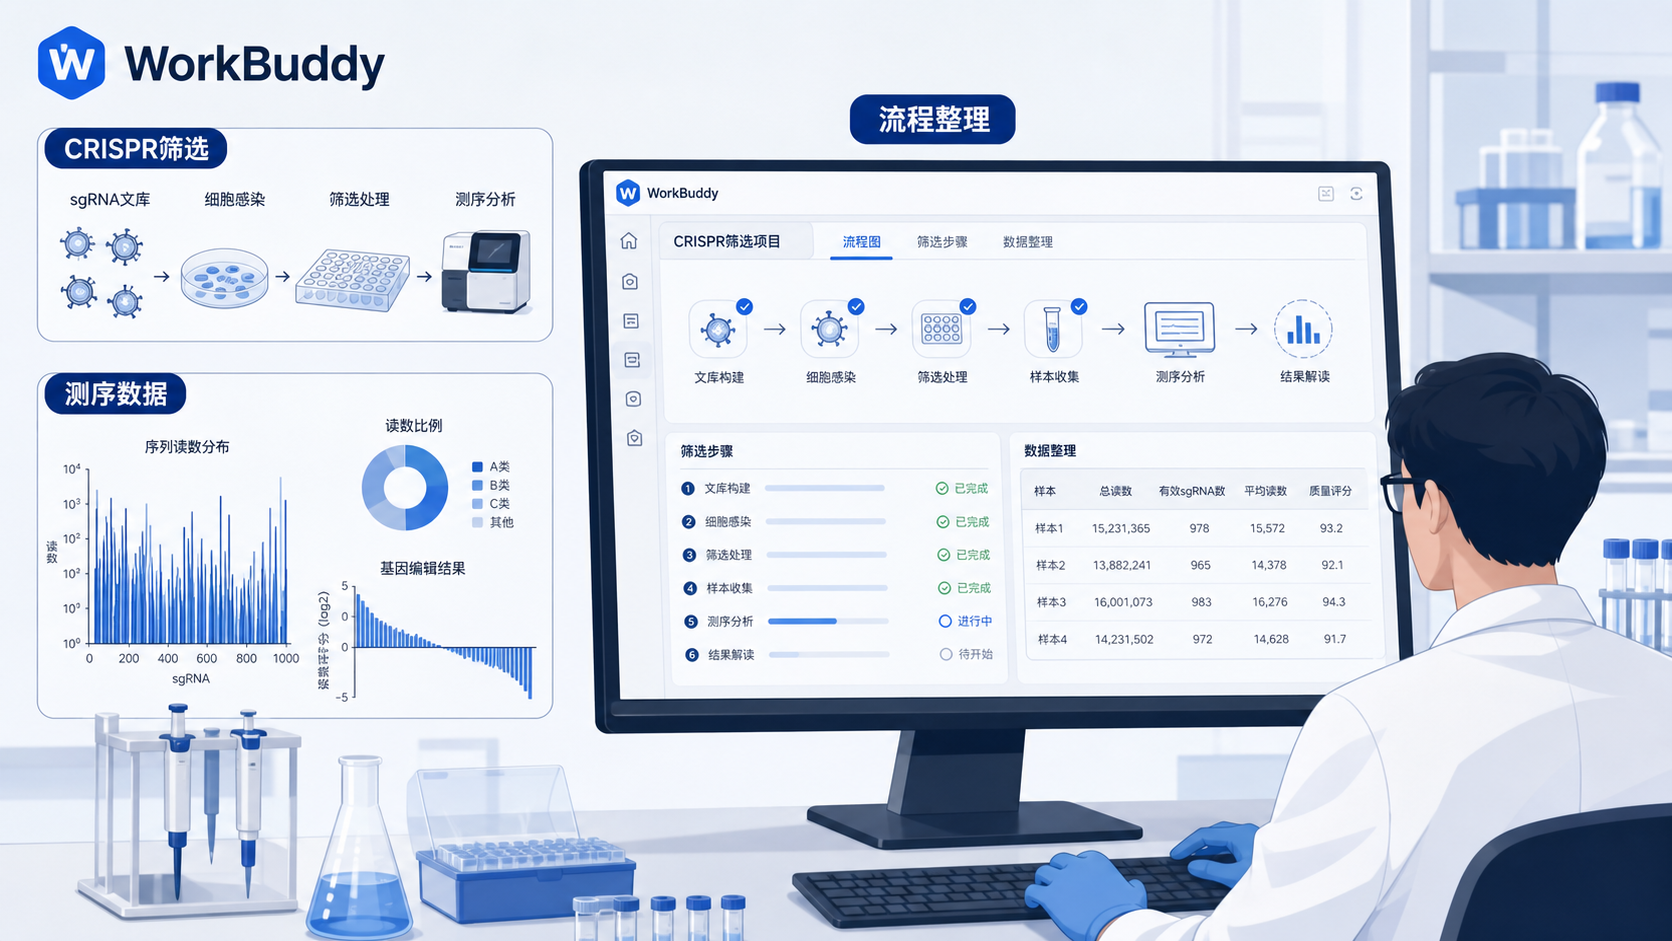
CRISPR筛选项目最容易出问题的地方,不是统计模型,而是前期流程杂乱。WorkBuddy的价值在于,把整个项目拆成标准模块,便于记录、追踪和复现。
一个完整的筛选项目,至少应拆成以下几步:
- 文库信息登记。
- 批次编号建立。
- 细胞感染与药筛记录。
- 基因组DNA提取。
- 测序数据导入。
- 批次校正与归一化。
- 命中基因筛选。
- 验证实验设计。
把流程结构化后,后续分析才有资格谈批次校正。
因为很多“分析失败”,本质上是前期元数据缺失。
2.2 WorkBuddy适合记录哪些关键字段
在CRISPR筛选中,建议在WorkBuddy里固定记录以下信息:
- 文库名称与版本。
- sgRNA总数。
- 载体系统。
- 细胞系名称。
- MOI。
- 筛选压力条件。
- 采样时间点。
- 批次编号。
- 测序平台与读长。
- 原始FASTQ文件路径。
- 分析脚本版本。
这些字段看似琐碎,但它们决定了后续是否能追溯某个结果来自实验变化,还是来自批次偏差 。
对科研团队而言,这种标准化也能降低交接成本。
3. CRISPR筛选批次校正的实战步骤
3.1 第一步,先做样本质量检查
在进入校正之前,必须先完成质控。否则批次校正会把坏数据“修饰”成看起来正常的数据。
建议先检查:
- 测序深度是否均衡。
- sgRNA覆盖度是否足够。
- 对照组是否出现异常掉落。
- 重复样本相关性是否过低。
- 低丰度sgRNA是否大量缺失。
如果基础质控不过关,批次校正没有意义。
尤其在 pooled screen 中,若文库覆盖不足,后续统计结果会明显偏移。
3.2 第二步,建立批次信息矩阵
批次校正的前提,是把每个样本的元数据写清楚。
最少要包含三类变量:
| 样本信息 | 示例 | 作用 |
|---|---|---|
| 生物学条件 | 对照、药物处理、敲除组 | 保留真实效应 |
| 技术批次 | Batch 1, Batch 2 | 校正系统偏差 |
| 测序信息 | 平台、深度、读长 | 排查技术波动 |
没有标准化元数据,批次校正模型就无法正确分离信号。
这一步在WorkBuddy里最适合通过模板化表单完成,避免人工手填遗漏。
3.3 第三步,进行数据归一化
CRISPR筛选数据本质上是计数数据。常见做法是先做归一化,再做批次校正。
归一化的目的,是减少测序深度和文库复杂度差异的影响。
常见处理思路包括:
- 计算每个sgRNA的原始counts。
- 按样本总reads进行标准化。
- 转换为log尺度或相对丰度。
- 再进入批次校正步骤。
顺序不能反。先归一化,再校正,通常比直接校正原始counts更稳妥。
因为原始计数同时混杂了深度差异和批次效应。
3.4 第四步,选择合适的批次校正策略
批次校正没有单一万能方法。要根据数据结构选策略。
常见思路包括:
- 当批次是明确分组变量时,可使用线性模型思路处理。
- 当批次效应较复杂时,可考虑基于主成分的校正。
- 当样本量充足且批次结构清晰时,可用专门的批次矫正算法。
但无论方法如何,核心原则一致:
校正后要重新检查样本聚类、重复相关性和批次分离是否下降。
建议用以下三个指标验证:
- PCA/UMAP上批次分离是否减弱。
- 同组重复样本相关性是否提升。
- 命中基因排名是否更稳定。
如果校正后批次消失了,但生物学分组也被抹平,说明模型过度校正。
4. WorkBuddy如何提升CRISPR筛选的分析效率
4.1 用WorkBuddy统一分析版本
CRISPR筛选的分析链条长。常见问题不是不会分析,而是不同人用不同脚本、不同参数、不同版本软件 ,最后导致结果不可复现。
WorkBuddy在这里的价值是:
- 统一记录分析路径。
- 固定参数版本。
- 追踪每次修改记录。
- 方便团队协作和复盘。
这对发表文章非常重要。
因为审稿人最关注的,不只是结果是否显著,还包括结果能否重复 。
4.2 把命中筛选和功能验证连起来
批次校正完成后,真正有价值的不是“校正图”,而是后续命中基因是否稳定。
建议在WorkBuddy中同步记录:
- Top hits名单。
- 不同批次的一致性。
- 多算法交集结果。
- 候选基因的通路注释。
- 验证实验优先级。
这样可以把筛选结果直接转化为实验决策,而不是停留在一张火山图上。
批次校正的最终目标,是让你筛出更可信的候选基因。
5. 常见错误与实战建议
5.1 不要把低质量批次硬合并
如果某一批次存在明显低覆盖、感染失败或测序异常,最优先的处理不是“强行校正”,而是判断是否应剔除。
质量太差的数据,校正后也可能仍然污染整体结果。
5.2 不要忽略sgRNA层面的异常
有些问题不是整批样本异常,而是少数sgRNA异常丰富或异常缺失。
这类异常可能来自:
- 合成偏差。
- 扩增偏好。
- 测序偏倚。
- 靶位点特殊结构。
所以分析时不能只看基因层面,也要回到sgRNA层面核查。
5.3 不要跳过重复验证
筛选结果经过批次校正后,仍然要看重复一致性。
重复样本一致性差,说明校正或实验本身仍有问题。
对高质量文章来说,这一步往往决定说服力。
总结Conclusion
CRISPR筛选的核心难点,不只是找到命中基因,而是在多批次条件下保住真实信号 。批次校正要建立在清晰元数据、规范归一化和合理模型选择之上。WorkBuddy的优势,在于把筛选、记录、校正、验证串成一条可追溯的流程,减少人为遗漏,提高团队协作效率。
如果你正在做CRISPR筛选项目,想把批次管理和分析流程做得更规范,可以借助解螺旋 的工作流工具与科研支持方案,快速搭建更稳健的筛选分析框架。
- 引言Introduction
- 1. 为什么CRISPR筛选必须做批次校正
- 2. WorkBuddy如何把CRISPR筛选流程标准化
- 3. CRISPR筛选批次校正的实战步骤
- 4. WorkBuddy如何提升CRISPR筛选的分析效率
- 5. 常见错误与实战建议
- 总结Conclusion