10
 分享
引言Introduction
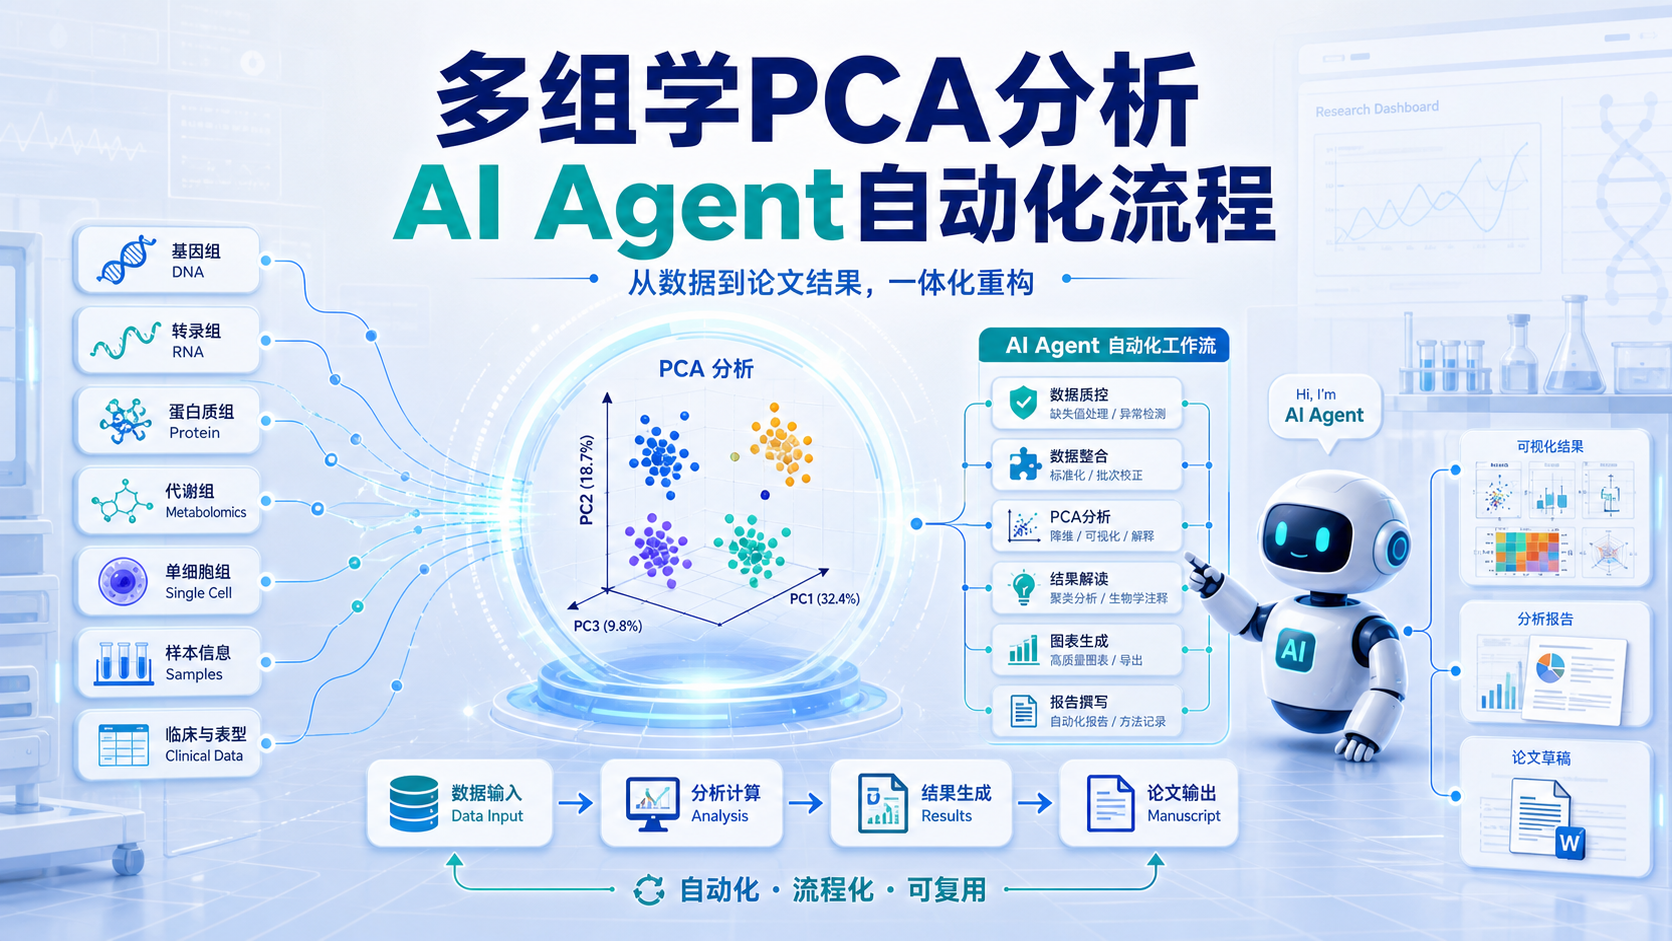
PCA分析常被用来做多组学质量控制、样本聚类和异常点识别,但真正耗时的不是画图,而是前期整理、批量统计、结果解释和写入论文。如果数据散、变量多、流程长,单靠人工很容易卡在每一步。
1. 为什么多组学PCA分析越来越依赖自动化
1.1 PCA分析在多组学中的核心作用
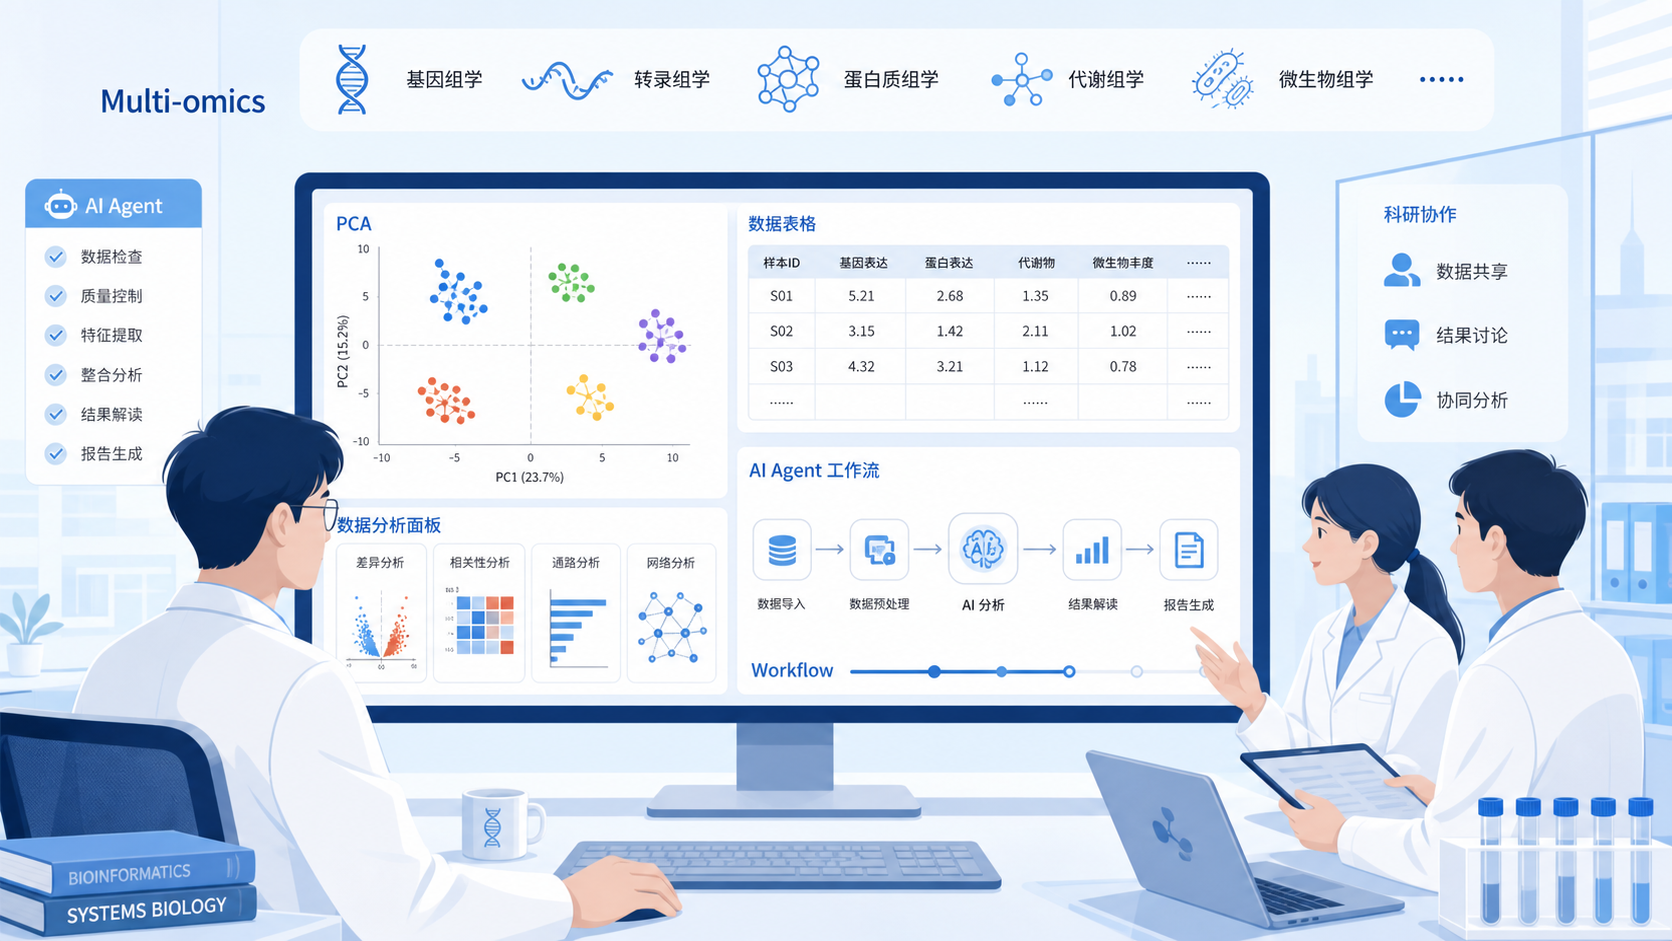
PCA分析是多组学研究里最常见的降维方法之一。它把高维数据压缩到几个主成分上,帮助研究者快速看出样本是否分组清晰、批次效应是否明显、异常样本是否存在。
在转录组、蛋白组、代谢组和单细胞相关分析中,PCA通常出现在质控环节。它不是最终结论,但它往往决定后续分析是否可信。
如果样本在PCA图上明显分离,研究者会进一步检查差异来源。若样本混杂,则可能提示批次校正不足、归一化不充分,或实验设计本身存在问题。
1.2 人工做PCA分析的主要痛点
传统PCA分析看似简单,实际流程并不短。常见步骤包括:
- 数据清洗和缺失值处理。
- 选择合适的标准化方法。
- 批量运行PCA并检查解释方差。
- 调整图形参数,输出可发表图片。
- 撰写结果描述,补充方法学说明。
每一步都需要重复确认。 对多组学数据来说,样本数、特征数和批次信息往往更复杂。尤其当一个课题涉及多个队列、多个平台和多个时间点时,人工操作很容易出现版本混乱、图表不一致和描述遗漏。
2. AI Agent如何重构PCA分析流程
2.1 从“人找工具”变成“工具找任务”
AI Agent的价值,不是替代研究者判断,而是把散落的操作串成一条连续工作流。研究者只需输入任务目标,例如“完成某组多组学数据的PCA分析并生成结果图”,Agent就可以自动执行数据读取、预处理、建模和出图。
这种模式特别适合科研中的重复任务。比如:
- 自动识别数据格式。
- 自动调用R、Python或现成分析脚本。
- 自动生成PCA图、方差解释率和样本注释图。
- 自动保存中间结果,便于追溯。
AI Agent的本质是流程编排。 它把“做什么”“先做什么”“出错后怎么处理”变成可执行的步骤,而不是让研究者在多个软件之间来回切换。
2.2 PCA分析中哪些环节最适合自动化
PCA分析本身属于典型的数据问题,因此很适合被自动化。实际中最适合交给AI Agent的部分包括:
2.2.1 数据整理与标准化
多组学数据常来自不同平台。表达矩阵、临床表型、样本分组信息可能分散在多个文件中。Agent可以先统一列名、补全元数据、检查缺失值,再按预设规则进行标准化。
这一步很关键。PCA对尺度非常敏感。 如果不先处理量纲差异,结果可能只是反映数值范围,而不是生物学差异。
2.2.2 自动出图与参数记录
Agent可以自动完成PCA散点图、椭圆分组图、载荷图等常用可视化,并记录关键参数,例如是否中心化、是否标准化、使用了哪些主成分、前两个主成分解释了多少方差。
这对论文写作很重要。因为审稿人常会追问方法细节。只给一张图不够,必须能追溯。
2.2.3 结果初稿生成
AI可以基于图和统计结果生成结果段落初稿,例如描述样本是否分离、是否存在离群点、主要变异来源是什么。但这一步只能作为初稿。 最终表述仍需研究者结合实验背景、批次设计和临床信息审核。
3. 多组学PCA分析的自动化路径怎么搭建
3.1 先明确输入和输出
任何自动化都不能从“空任务”开始。做PCA分析前,必须先定义清楚输入与输出。
输入通常包括:
- 原始表达矩阵或特征矩阵。
- 样本分组信息。
- 批次、时间点、处理条件等元数据。
- 分析语言和输出格式要求。
输出通常包括:
- PCA图。
- 方差解释率。
- 样本聚类结果。
- 方法描述文本。
- 可直接用于论文或补充材料的文件。
输入越规范,自动化越稳定。 这也是科研流程能否被AI接管的关键前提。
3.2 让Agent串联R语言和文本生成
在临床研究和生信分析中,R语言仍是非常重要的工具。它可以完成数据清洗、统计分析和可视化。对于PCA分析,常见做法就是由R负责计算,AI负责解释和写作。
一个更高效的路径是:
- Agent读取原始数据。
- 自动调用分析脚本完成PCA。
- 生成结果图和统计摘要。
- 将结果转写成论文语言。
- 按期刊格式整理图注和方法。
这样做的好处,是把“分析”和“写作”连接起来。 研究者不必反复导出、粘贴、改图、补文字,整体效率会明显提升。
3.3 自动化不等于全自动发表
这一点必须说清楚。AI Agent可以显著加速PCA分析,但不能替代学术判断。比如:
- 主成分选择是否合理。
- 分组差异是否具有生物学意义。
- 是否存在批次效应被误判为真实信号。
- 是否需要进一步做PERMANOVA、差异分析或相关分析验证。
自动化负责“做得快”,专家负责“判得准”。 这是当前最现实、也最可靠的分工方式。
4. 从PCA图到论文结果,如何提高可发表性
4.1 论文里PCA分析不能只写“样本分离明显”
很多论文的PCA描述过于简单,常见表达是“各组样本分离明显”。这种写法太空。审稿人真正关心的是:
- 分离是否稳定。
- 哪个主成分贡献了主要差异。
- 是否与临床分组一致。
- 异常点是否已处理。
好的PCA结果描述,必须同时回答“看到了什么”和“为什么重要”。 例如,应结合实验背景说明分组差异是否符合预期,或者是否提示新的生物学信号。
4.2 结果写作应包含的关键信息
一段合格的PCA结果描述,通常建议覆盖以下内容:
- 数据来源和样本数量。
- PCA前是否进行了标准化或批次校正。
- 前两个主成分解释的方差比例。
- 样本是否按分组聚类。
- 是否存在离群样本及其处理方式。
如果是多组学联合分析,还要补充说明不同组学之间是否呈现一致趋势。一致性越高,结果越有说服力。 但如果不同组学信号不一致,也不应回避,反而可能提示更复杂的机制。
4.3 论文质量提升的关键,不只是图好看
PCA图只是结果的表面。真正决定论文质量的,是分析链条是否闭环。也就是:
- 数据来源是否清楚。
- 处理流程是否可复现。
- 参数是否完整记录。
- 结果解释是否有生物学依据。
AI Agent的优势就在这里。它能把分析过程自动留痕,把图、表、代码和文字绑定在一起。这样不仅方便投稿,也方便答审稿意见。
5. 解螺旋如何帮助把PCA分析做成可复用流程
5.1 面向科研场景的工具化支持
对于医学生、医生和科研人员来说,最缺的往往不是一个PCA图,而是一套可复用的流程。解螺旋提供的价值,就是帮助用户把PCA分析从“单次操作”变成“标准流程”。
当你面对多组学数据时,可以借助其科研AI工具思路,把数据整理、分析运行、图表输出和结果初稿串联起来,减少重复劳动。这样,研究者就能把更多时间放在课题设计、机制判断和论文修订上。
5.2 把时间留给真正重要的科研判断
AI Agent能解决的是速度问题,但科研真正难的,仍然是问题定义和结果解释。解螺旋的意义,不是让你跳过科研,而是让你更快进入高价值判断环节。
如果你正在做多组学PCA分析,或者需要把分析结果快速整理成论文初稿,解螺旋这类工具能明显降低流程阻力。尤其在毕业、投稿、标书和课题申报的紧张节点,它能帮助你把重复性工作压缩到更短时间内完成。
总结Conclusion
多组学PCA分析的核心,不只是画一张图,而是完成从数据清洗、降维、解释到论文表达的完整链条。AI Agent最适合介入的,就是这些重复、标准化、可追踪的数据流程。 它能提升效率,减少手工错误,并让结果更快进入可发表状态。
但自动化不等于替代判断。研究者仍需把控标准化方法、主成分解释、批次效应识别和生物学意义阐释。对于希望提升科研效率的人来说,最现实的路径是让AI做执行,让自己做决策。
如果你想把PCA分析真正变成可复用、可投稿、可写入论文的流程,可以进一步了解解螺旋 ,把科研中的重复劳动交给工具,把时间留给更重要的学术判断。
- 引言Introduction
- 1. 为什么多组学PCA分析越来越依赖自动化
- 2. AI Agent如何重构PCA分析流程
- 3. 多组学PCA分析的自动化路径怎么搭建
- 4. 从PCA图到论文结果,如何提高可发表性
- 5. 解螺旋如何帮助把PCA分析做成可复用流程
- 总结Conclusion