23
 分享
引言Introduction
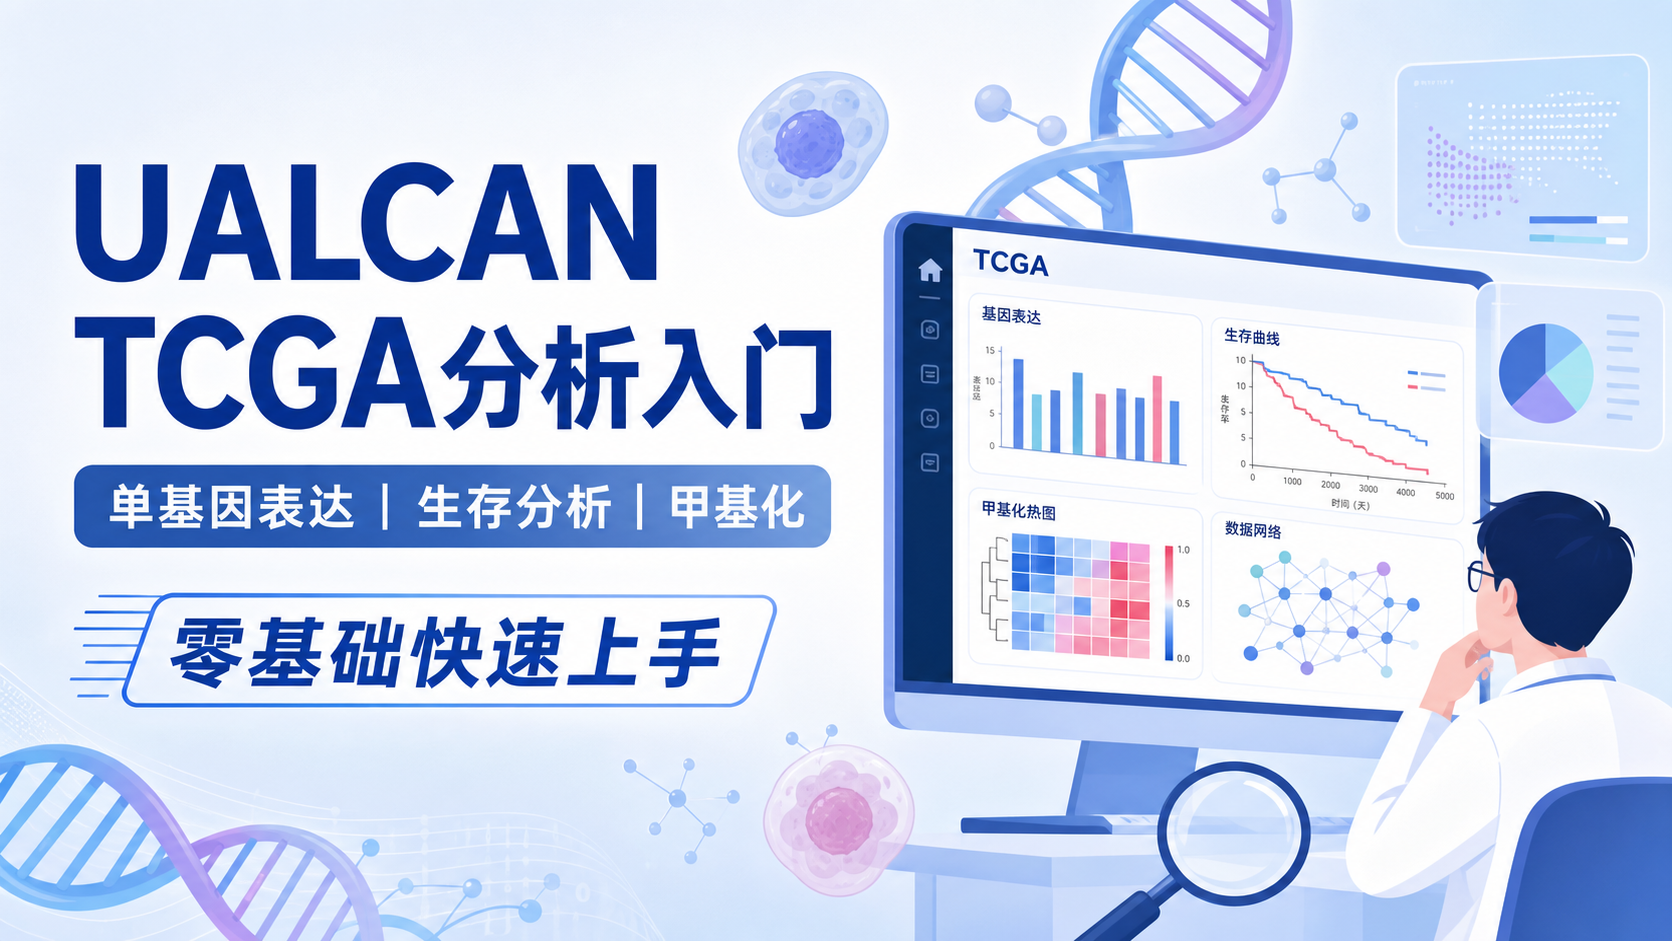
UALCAN是做TCGA预后和表达分析时最省时的在线工具之一。它适合零基础快速验证基因假说,也适合科研人员做初筛和补充分析。 如果你常被“不会编程、想看生存曲线、想比较肿瘤与正常差异”卡住,这篇文章可以直接帮你上手。

UALCAN的优势不是替代R语言,而是把复杂的TCGA分析流程压缩成可视化操作。 对于医学生、医生和科研人员,这意味着更快得到可解释结果,更适合文献预研、课题立项和结果验证。
1.UALCAN是什么,适合解决什么问题
1.1 UALCAN的核心定位
UALCAN是一个面向癌症组学数据的交互式分析平台,主要整合了TCGA、MET500、CPTAC和CBTTC等公开数据。它的设计目标很明确,让用户用最少的操作完成基因表达、临床分层和生存分析。
从科研流程看,UALCAN更像一个“快速筛选器”。你可以先判断某个基因在肿瘤中是否异常表达,再看它是否与预后相关,最后再决定是否进入后续机制实验或队列验证。
1.2 它为什么适合零基础
UALCAN不要求你先写代码,也不要求你先搭建本地环境。对于刚接触生信的人,这一点非常关键。很多项目卡在第一步,不是因为问题难,而是因为数据获取和分析门槛太高。
用UALCAN做TCGA分析,最常见的价值是三类。
- 先看某个基因是否在肿瘤中上调或下调。
- 再看该基因是否影响总生存率或临床分层结果。
- 最后评估甲基化、蛋白表达或泛癌差异。
1.3 常见使用场景
在实际研究中,UALCAN常用于以下任务。
- 候选基因初筛。
- 单基因生存分析。
- 肿瘤与正常组织表达比较。
- 启动子甲基化相关分析。
- 泛癌表达趋势观察。
如果你的研究目标是“先判断一个基因值不值得继续做”,UALCAN非常合适。 如果目标是最终发表高质量机制文章,UALCAN更适合做前期证据,而不是唯一证据。
2.如何进入UALCAN并选择TCGA分析
2.1 主页入口与基本结构
UALCAN主页结构清晰。顶部一般可见Home、Tutorial、TCGA、CPTAC、CBTTC等入口。对于大多数肿瘤转录组分析,直接点击TCGA即可进入分析界面。
进入后,你会看到基于TCGA数据的分析模块。常见内容包括表达分析、生存分析、甲基化分析以及泛癌分析。这意味着一个页面就能完成从表达到预后的基础验证。
2.2 先确认你要分析的数据类型
在TCGA分析页,最常用的是Gene analysis。对于蛋白编码基因、miRNA和lncRNA,UALCAN都提供了对应入口,但功能并不完全相同。课程中已经明确提示,做功能基因集检索时,TCGA Gene analysis是核心入口。
实际操作时,建议先明确三个问题。
- 你要看单基因,还是基因集。
- 你要分析哪个癌种。
- 你要看表达,还是生存。
2.3 高效使用的基本原则
不要一上来就点结果。先把问题定义清楚。
例如同一个基因,在肝癌、肺癌、乳腺癌中的表达和生存结论可能完全不同。不同临床亚型下,结果也可能不同。只有先限定癌种和终点,结果才有解释价值。
3.UALCAN在线使用的核心步骤
3.1 单基因表达分析怎么做
以TCGA Gene analysis为例,进入后可以通过输入基因名或选择Gene class进行检索。若是单基因验证,直接输入基因符号即可。若是基因集筛查,则可以用逗号分隔多个基因后提交。
操作逻辑很简单。
- 打开TCGA分析页。
- 选择TCGA Gene analysis。
- 输入目标基因名,或选择功能基因集。
- 选择癌种。
- 点击Explore查看结果。
最实用的是看肿瘤组与正常组的表达差异。 如果基因在多个样本中持续上调或下调,说明它具备更强的后续研究价值。
3.2 生存分析怎么做
UALCAN的生存分析页面会输出曲线图和分组信息。你可以直接观察高表达组与低表达组的生存差异。对于医学生和科研人员而言,这一步是判断候选基因是否具有临床意义的关键。
建议按这个顺序做。
- 先选癌种,如肝癌或肺癌。
- 再输入基因名。
- 然后查看总生存信息。
- 最后结合P值和曲线分离度判断结果。
如果曲线分离明显,而且统计学显著,就说明这个基因更值得进入下一步验证。 但要注意,生存结果是相关性,不等于因果关系。
3.3 甲基化和外部链接怎么辅助解释
UALCAN的一大优点是,它不只给出表达或生存,还会提供启动子甲基化分析和外部数据库链接。这里的意义在于帮助你快速形成机制假说。比如表达下调是否可能与启动子高甲基化相关。
此外,页面还会链接到GeneCards、PubMed、TargetScan、人类蛋白质图谱和GTEx等资源。这让你能在一个入口内完成“数据观察”和“文献回溯”。
4.用UALCAN做TCGA分析时,最容易忽略的细节
4.1 样本量和统计解释
在UALCAN中,不同癌种的正常样本数并不一致。课程内容里也提到,某些正常样本少于10个的癌种不会被高亮显示。这个细节很重要,因为它直接影响结果稳定性。
所以看到结果时,不要只盯着P值。还要看样本量和分组是否合理。样本量小,结论的可靠性通常也会下降。
4.2 红色、蓝色和阴影代表什么
在基因列表或泛癌分析中,UALCAN会用颜色和阴影提示结果状态。通常红色表示生存分析有意义,蓝色表示无意义。阴影则常提示表达有统计学意义,颜色方向反映上调或下调。
理解这些视觉标记很重要。它能帮助你快速定位值得深入研究的癌种,而不是在大量结果中逐个点开。
4.3 结果适合怎么写进论文
如果你准备把UALCAN结果写入论文或汇报,建议使用标准表达方式。
- 某基因在某癌种中显著高表达。
- 高表达组与低表达组在OS上存在差异。
- 启动子甲基化与表达呈相关趋势。
- 结果需结合独立队列或实验验证。
这样写更符合科研语言,也更容易通过导师或审稿人的质询。
5.三个在线数据库怎么配合使用更高效
5.1 UALCAN、GEPIA2和KM Plotter各自擅长什么
如果只靠一个平台,很容易得到片面的结论。更高效的方法是交叉验证。UALCAN适合快速看表达和分层。GEPIA2适合单基因和多基因生存分析。KM Plotter则在预后分析中更细,尤其适合做芯片、mRNA测序和miRNA的生存验证。
这种组合的价值在于:
- UALCAN先筛出候选基因。
- GEPIA2复核单基因和多基因生存。
- KM Plotter进一步确认预后稳健性。
5.2 为什么这比单纯查文献更高性价比
文献检索能告诉你别人研究过什么,但不能直接回答你当前样本里的问题。在线数据库的优势在于,它能让你在几分钟内完成一个初筛闭环。对于课题设计,这种效率非常高。
尤其在临床研究早期,导师往往最需要的是“这个基因有没有潜力”。UALCAN正好适合回答这个问题。
5.3 适合建立怎样的分析流程
推荐你这样安排。
- 用UALCAN看表达差异。
- 用UALCAN看生存和甲基化。
- 用GEPIA2或KM Plotter交叉验证。
- 再去做实验或独立队列分析。
这条路径成本低,反馈快,也更符合科研决策逻辑。
5.4 解螺旋如何帮你把“会看”变成“会做”
如果你希望把UALCAN从“看结果”提升到“真正用于课题设计和文章产出”,可以借助解螺旋的数据库教程和课程体系,把TCGA、GEPIA2、KM Plotter等工具串成完整分析链路。这样你不仅能快速完成ualcan在线使用,还能把初筛结果自然过渡到后续验证,减少试错成本。
总结Conclusion
UALCAN的价值,在于它把TCGA中的表达、预后和甲基化分析变成了低门槛、可视化、可交叉验证的流程。对于零基础用户,它是最快的入门工具。对于科研人员,它是高性价比的假说验证平台。
如果你正在做课题、写论文或寻找候选生物标志物,建议先用UALCAN完成第一轮筛选,再结合GEPIA2和KM Plotter做复核。想系统掌握这套流程,欢迎进一步了解解螺旋。
- 引言Introduction
- 1.UALCAN是什么,适合解决什么问题
- 2.如何进入UALCAN并选择TCGA分析
- 3.UALCAN在线使用的核心步骤
- 4.用UALCAN做TCGA分析时,最容易忽略的细节
- 5.三个在线数据库怎么配合使用更高效
- 总结Conclusion