9
 分享

引言Introduction
列线图绘制并不只是“画图”。对医学生、医生和科研人员来说,它决定了预测模型能否真正用于临床。如果只会回归分析,却不会把结果转化为可解释、可验证的工具,模型的临床价值就会大打折扣。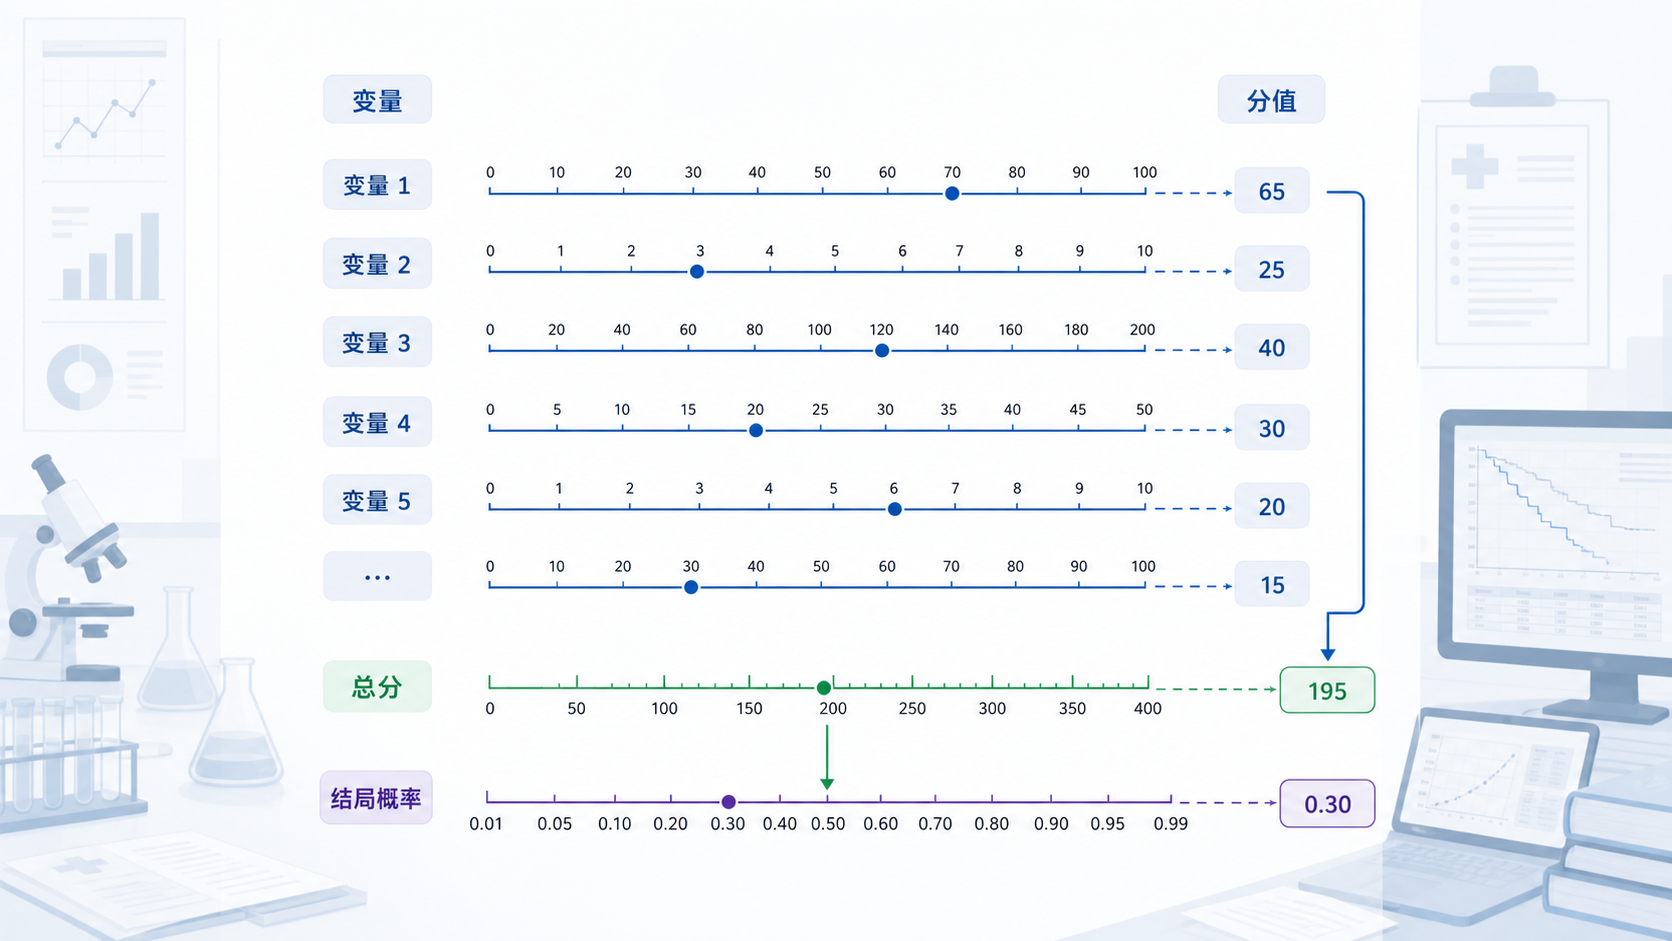
1. 列线图是什么,为什么临床研究常用它
1.1 从回归方程到可视化预测工具
列线图,也叫诺莫图,建立在多因素回归分析基础上,常见于Logistic回归和Cox回归研究。它的核心作用,是把复杂的回归方程转换成直观图形。
每个变量对应一个评分。所有评分相加后,再映射到结局概率。
这意味着,研究者不再只报告OR值或HR值,而是能直接给出某个个体的风险预测值。
在临床研究中,这种形式很重要。因为医生关心的不只是“是否相关”,还关心“这个患者到底有多大概率发生事件”。列线图正好补足了这一点。
1.2 为什么它适合医学场景
列线图的优势在于可解释性强,便于沟通,也更利于临床决策。尤其在以下场景中应用广泛:
- 疾病发生风险预测。
- 术后并发症评估。
- 生存时间预测。
- 个体化治疗决策支持。
如果模型只能停留在统计显著,而不能转化为临床可用工具,它的价值就有限。
列线图的意义,就是把“统计结果”变成“临床工具”。
1.3 列线图的本质是加权评分系统
列线图不是凭空生成的图。它本质上来自多因素模型中各变量的回归系数。系数越大,说明该因素对结局影响越强,分值通常也越高。
举个简单逻辑。
同样是一个二分类结局,某个因素若显著增加风险,它在列线图上的刻度会更长,分值更高。最后总分越高,结局发生概率越大。
这也是为什么在构建列线图前,必须先完成高质量的变量筛选和回归建模。
2. 列线图绘制前,模型必须先站得住
2.1 变量筛选不能只看“显著”
很多初学者在列线图绘制前,直接把全部变量塞进模型。这样往往会导致模型臃肿、共线性增加、稳定性下降。
更常见的做法是先进行单因素分析,再进入多因素模型。部分研究还会结合LASSO回归筛选协变量,以减少冗余变量。
列线图不是变量越多越好,而是变量越精越好。
变量应满足三个条件:
- 与结局有明确关联。
- 数据质量可靠。
- 在临床上可获得、可解释。
2.2 结局变量要定义清楚
列线图用于预测什么,必须在研究开始前定义清楚。是发病、死亡、并发症,还是某个时间点的生存率,这会直接影响后续模型类型。
例如:
- 二分类结局,常用Logistic回归列线图。
- 生存结局,常用Cox回归列线图。
如果结局定义模糊,后面的ROC、校准曲线、DCA都缺乏基础。模型再漂亮,也无法弥补研究设计的缺陷。
2.3 数据处理决定模型稳定性
绘制列线图前,还要检查缺失值、异常值和变量编码。分类变量要转为factor,连续变量要确认量纲和分布。
实践中常见的规范流程包括:
- 清理缺失值。
- 统一变量编码。
- 检查分布是否极端偏态。
- 评估多重共线性。
- 再进行模型拟合。
这一步做扎实,后续图形才更可信。
3. 列线图绘制的核心流程
3.1 先拟合模型,再生成nomogram
在R语言中,常用rms包完成列线图绘制。典型流程是先设置datadist,再用lrm或cph拟合模型,最后调用nomogram函数生成列线图。
常见逻辑如下:
- 用
datadist()整理数据分布信息。 - 用
lrm()拟合Logistic模型。 - 用
nomogram()生成列线图对象。 - 用
plot()绘制图形。
先有模型,后有列线图。
这一步不能颠倒。列线图只是模型的可视化表达,不是独立分析工具。
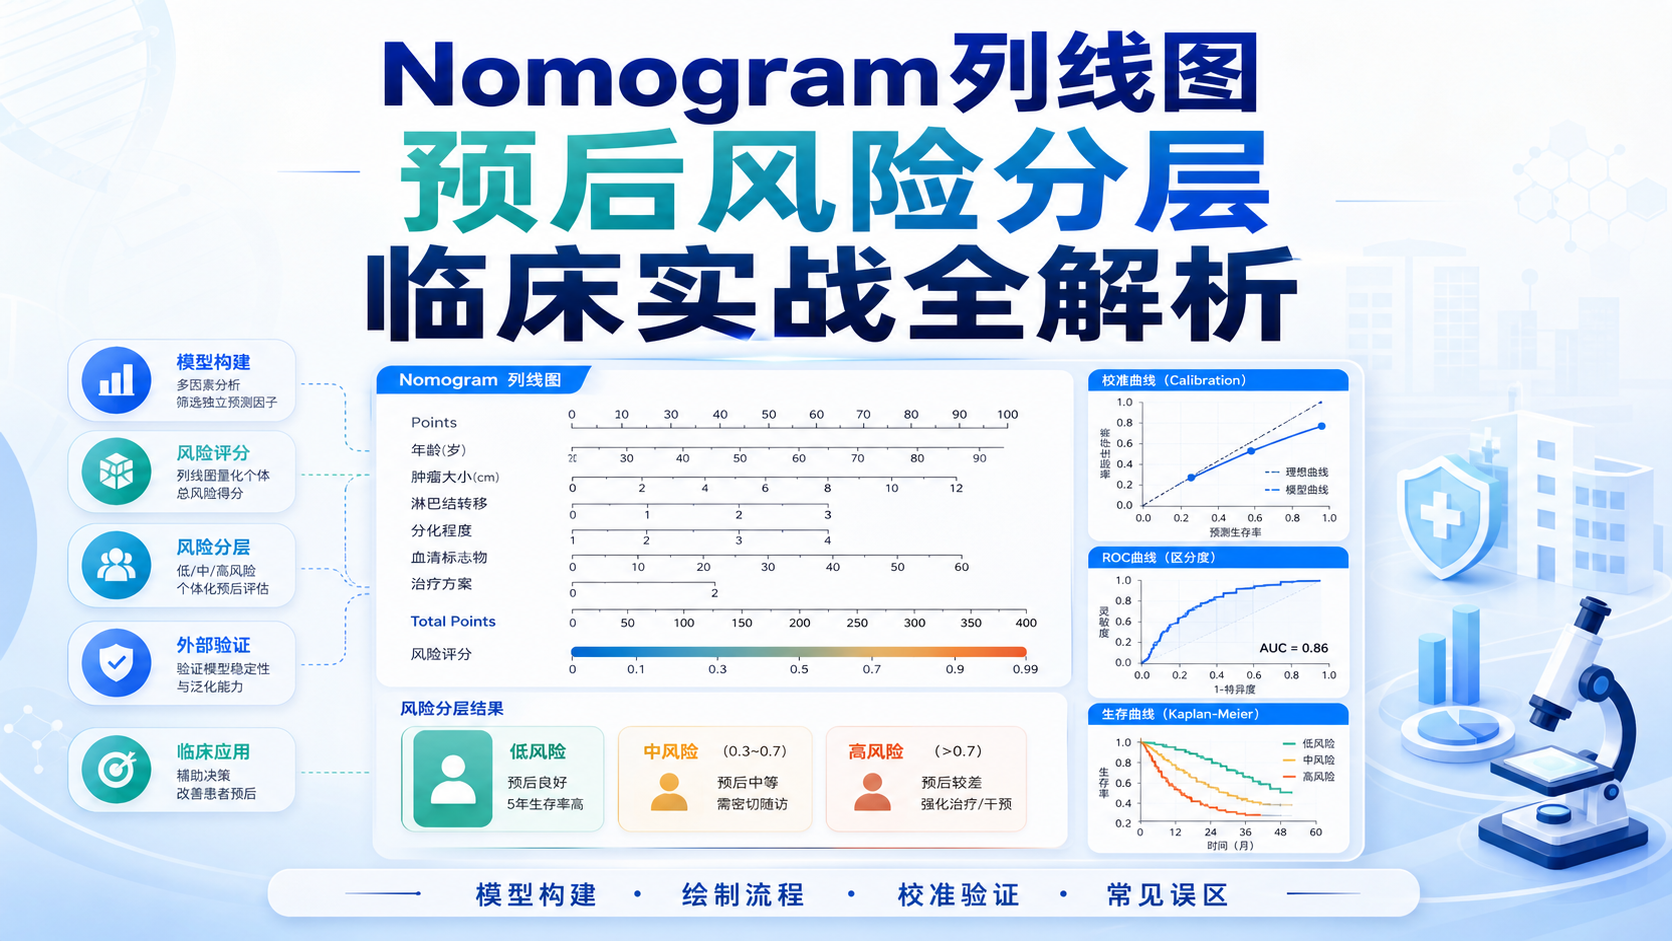
3.2 如何理解列线图上的每一条线
列线图通常包含以下几部分:
- 最上方是Points,表示单项得分。
- 中间是各预测变量。
- 下方是Total Points,总分。
- 最底部是结局概率或生存概率。
解读时,步骤很固定:
- 找到患者对应的变量取值。
- 读取每个变量对应分值。
- 将所有分值相加。
- 在总分轴上找到位置。
- 对应到结局概率轴,得到预测结果。
例如,某患者若年龄、疾病分级和某实验室指标都提示高风险,总分就会明显升高,对应的结局概率也会更高。
3.3 列线图适合做个体化预测
列线图最大的优势,是把群体模型用于个体判断。
这在肿瘤预后、术后并发症和慢病管理中尤其有用。
它的价值不是替代医生,而是帮助医生更快做出更一致的判断。
在临床沟通中,分值化展示也更容易让团队成员理解风险差异。
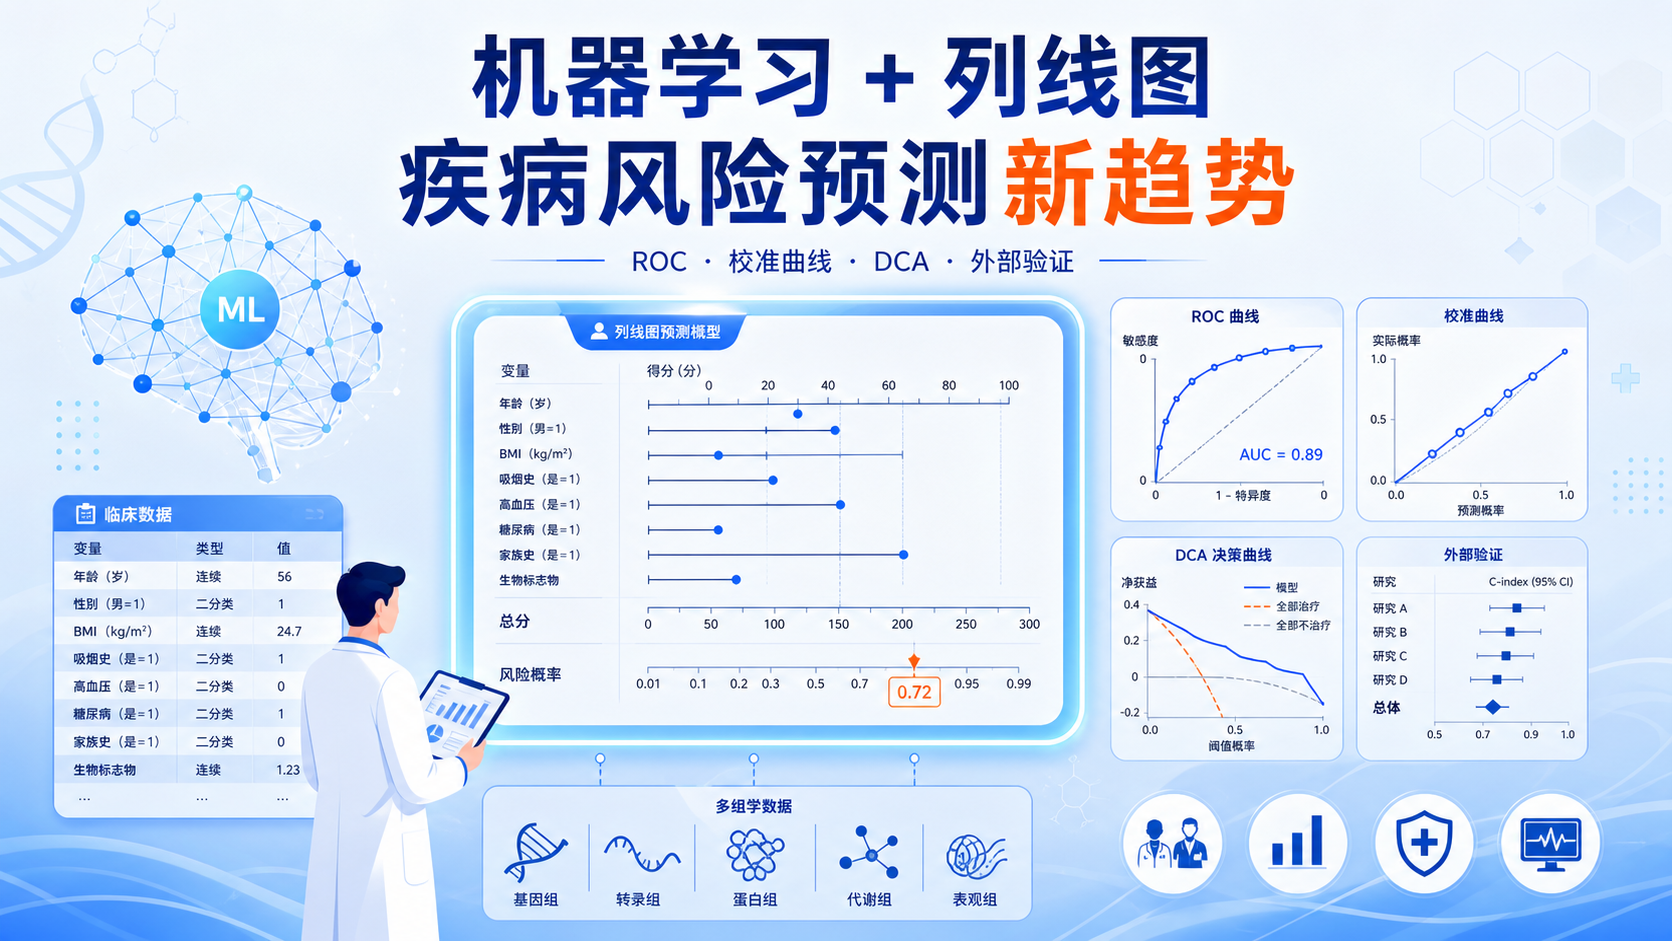
4. 列线图绘制后,必须做三类验证
4.1 ROC曲线看区分度
ROC曲线反映模型区分高风险和低风险个体的能力,AUC越高,区分度越好。
一般来说:
- AUC > 0.7,可认为有一定区分能力。
- AUC > 0.8,通常提示区分度较好。
- AUC越接近1,模型越理想。
但要注意,AUC高不等于模型一定能临床使用。
它只回答“能不能分开”,不回答“预测准不准”。
4.2 校准曲线看预测是否接近真实
校准曲线用于比较预测概率和实际发生率。理想情况下,曲线应尽量贴近45度线。
这一步非常关键。因为临床预测模型不但要“区分开”,还要“预测准”。
如果校准曲线明显偏离45度线,说明模型存在系统性偏差。即便AUC不低,也可能不适合临床应用。
4.3 DCA曲线看临床净获益
DCA,决策曲线分析,评价的是模型是否真正能带来临床收益。它考虑了真阳性收益和假阳性损失。
DCA的核心问题是:
- 在某个阈值概率下,用模型决策是否值得。
- 模型是否比“全部干预”或“全部不干预”更优。
好的列线图,不只是统计学上漂亮,还要在DCA上显示出更高净获益。
这才说明它具有真实的临床转化价值。
5. 列线图绘制常见问题与改进思路
5.1 模型不显著,不等于不能画图
有些研究在构建后发现,变量并不都显著,列线图的表现也一般。
这时不要急于美化图形掩盖问题。
应优先检查:
- 样本量是否不足。
- 变量筛选是否合理。
- 结局定义是否过宽。
- 是否存在共线性。
- 外部验证是否缺失。
图形好看不代表模型可靠。
这是很多初学者最容易忽略的问题。
5.2 训练集表现好,不代表外部有效
在预测模型研究中,只看训练集结果远远不够。
真正有价值的是验证集,最好还有外部验证。
原因很简单。
模型在本地数据上表现好,可能只是过拟合。到了新数据集,AUC和校准可能明显下降。
因此,规范研究通常需要:
- 内部验证。
- 外部验证。
- 多中心验证。
这决定了列线图是否能从“论文图”走向“临床工具”。
5.3 图形美化要服务于信息传达
列线图绘制中,适度美化是必要的,但不能影响可读性。字号、刻度、变量顺序、总分轴长度,都应围绕临床使用体验来优化。
图的目标是让医生快速读懂,而不是追求视觉复杂。
这也是高质量科研图形的重要标准。
6. 从方法到落地,如何提高列线图研究质量
6.1 研究设计要和临床问题匹配
一个好的列线图,首先来自一个好的临床问题。
比如:
- 哪些因素能预测术后并发症?
- 哪些指标能预测短期死亡风险?
- 哪些变量能帮助分层管理高危患者?
问题明确,模型才有意义。
否则再复杂的统计方法,也只是形式化处理。
6.2 统计分析要完整
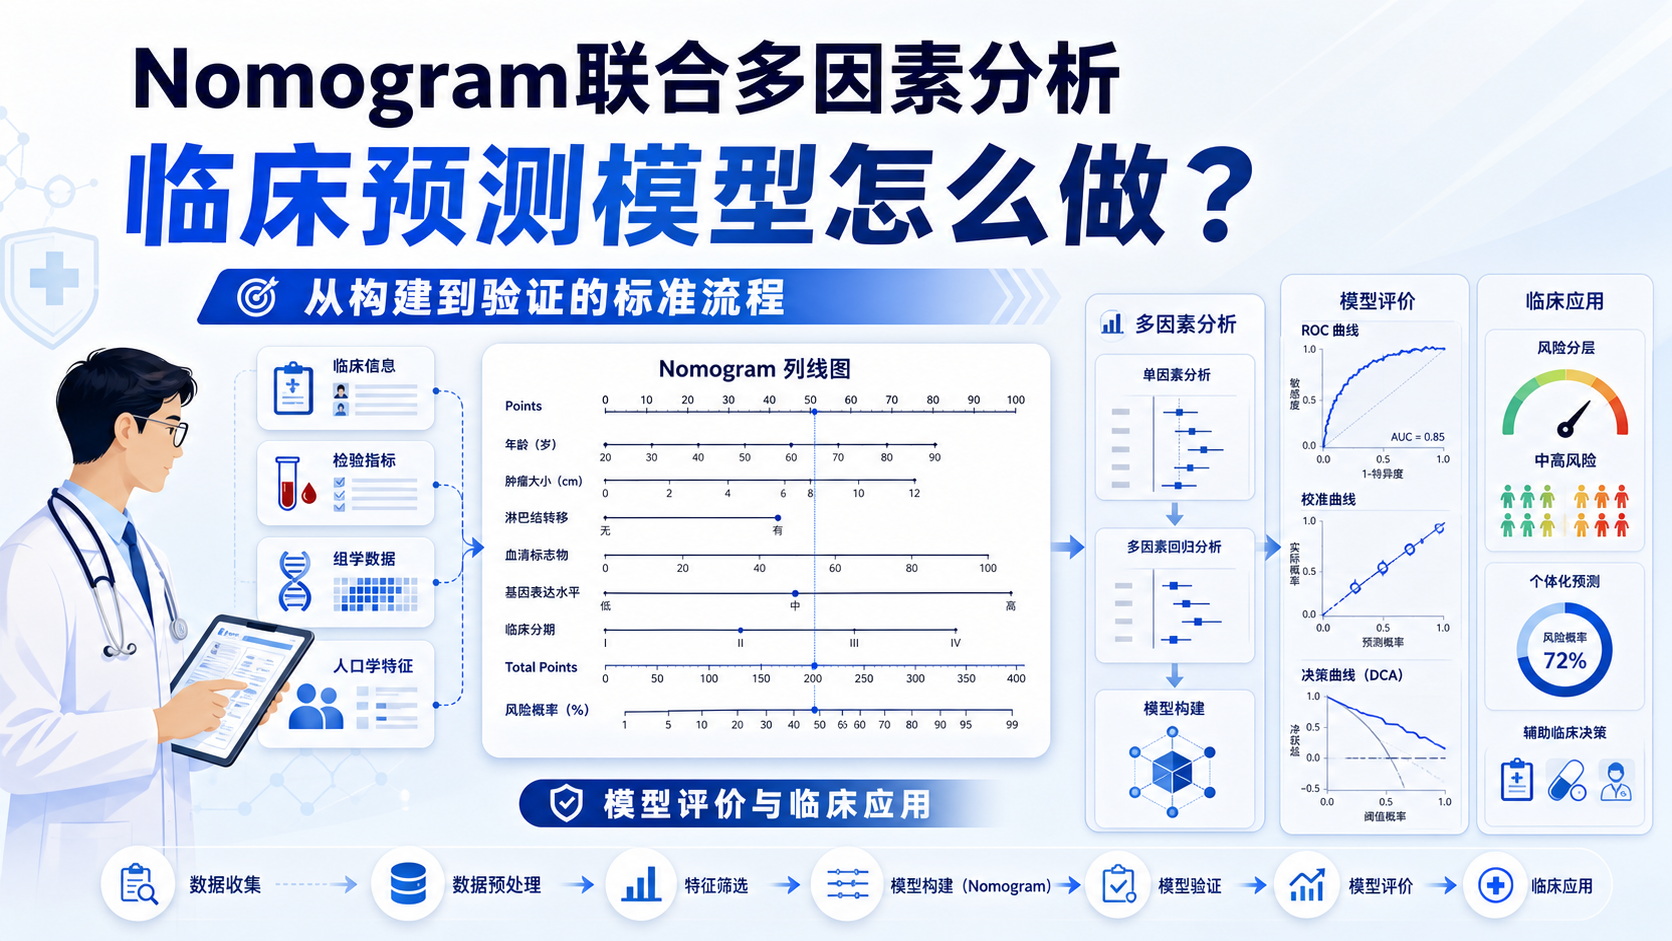
标准的列线图研究通常应包含:
- 单因素分析。
- 多因素回归分析。
- 列线图构建。
- ROC、校准曲线、DCA验证。
- 必要时进行bootstrap重复抽样。
如果只给出一张图,却没有验证体系,文章说服力会明显下降。
6.3 写作时要突出临床解释
医学读者最关心的是“这意味着什么”。
所以写作中不能只报数值,还要解释临床含义。
例如:
- 某因素分值更高,提示其对结局贡献更大。
- 总分升高,对应风险增加。
- 模型在验证集中仍保持稳定,提示可重复性较好。
好的列线图研究,应该让读者看完就知道如何用。
总结Conclusion
列线图绘制的核心,不是把统计结果做成一张图,而是把模型转化为可用于临床的预测工具。它依赖可靠的变量筛选、规范的回归建模,以及ROC、校准曲线和DCA的完整验证。对医学生、医生和科研人员来说,真正掌握列线图,意味着不仅能“建模”,还能“解释”和“应用”。
如果你希望系统提升预测模型研究效率,减少建模和制图中的重复摸索,可以关注解螺旋。借助更成熟的流程支持,你能更高效完成列线图绘制、模型验证与结果呈现,把时间留给真正重要的临床科研问题。
- 引言Introduction
- 1. 列线图是什么,为什么临床研究常用它
- 2. 列线图绘制前,模型必须先站得住
- 3. 列线图绘制的核心流程
- 4. 列线图绘制后,必须做三类验证
- 5. 列线图绘制常见问题与改进思路
- 6. 从方法到落地,如何提高列线图研究质量
- 总结Conclusion