20
 分享
引言Introduction
诊断试验看似简单,真正难点在于如何证明它“有用” 。医学生、医生和科研人员常会遇到同样的问题:新方法到底能不能替代金标准,指标怎么选,结果怎么解读。如果效能指标选错,研究结论可能完全偏离临床价值。
1. 诊断试验为什么必须看效能指标
1.1 诊断试验的核心不是“能不能测”,而是“测得准不准”
诊断试验是用某种技术手段,对疾病状态做出判断的一类研究。它的目标,不只是发现一个新方法,而是评价这个方法是否真实、可靠、值得临床采用 。
从研究逻辑看,诊断试验通常先有金标准,再用待评价方法去比对。金标准决定了研究对象是否被正确分类。 如果金标准选错,后面的灵敏度、特异度都会失真。
临床上,很多新方法之所以需要评价,是因为金标准往往存在现实限制。比如:
- 组织病理学虽然可靠,但有创。
- 某些检查耗时长,推广困难。
- 术前无法直接获得病理结果,只能先用影像学推测。
1.2 效能指标本质上回答三个问题
诊断试验的效能,通常可从三个层面理解:
- 真实性 ,也就是结果和金标准的一致程度。
- 可靠性 ,也就是重复检测时是否稳定。
- 收益 ,也就是是否真正改善临床决策。
在实际论文写作中,最常先讨论真实性。因为它直接决定一个方法能不能进入临床流程。没有真实性,后续收益和推广价值就缺乏基础。
2. 诊断试验效能指标的设计基础
2.1 先明确研究对象和金标准
一个规范的诊断试验,首先要定义清楚研究对象。通常是“可疑患者”或“拟诊人群”,而不是健康志愿者。这样才能更接近真实临床场景。
接着要设定金标准。金标准应尽量满足两点:
- 当前临床公认最可靠。
- 能明确区分有病与无病。
如果金标准本身不稳定,研究结果就会出现系统偏差。这类偏差会直接影响四格表的a、b、c、d分布。
2.2 分类变量和连续变量,分析方法不同
诊断试验中,待评价指标常见两类。
第一类是二分类变量。
例如阳性、阴性,适合直接构建四格表,计算灵敏度、特异度等。
第二类是连续变量。
例如血清学指标、蛋白水平、代谢物浓度等。此时通常需要先找截断值,再判断高于或低于该值时的诊断效果。ROC曲线是这类指标最常用的分析工具。
2.3 设计时要考虑临床可用性
一个指标即使统计上显著,也不一定适合临床。设计阶段就要考虑:
- 是否有创。
- 是否成本过高。
- 是否耗时过长。
- 是否容易在常规医院重复实施。
这也是为什么很多研究会同时比较多个方法。临床需要的不只是“更准”,还要“可实施”。
3. 诊断试验效能指标怎么解读
3.1 灵敏度与特异度是最基础的两个指标
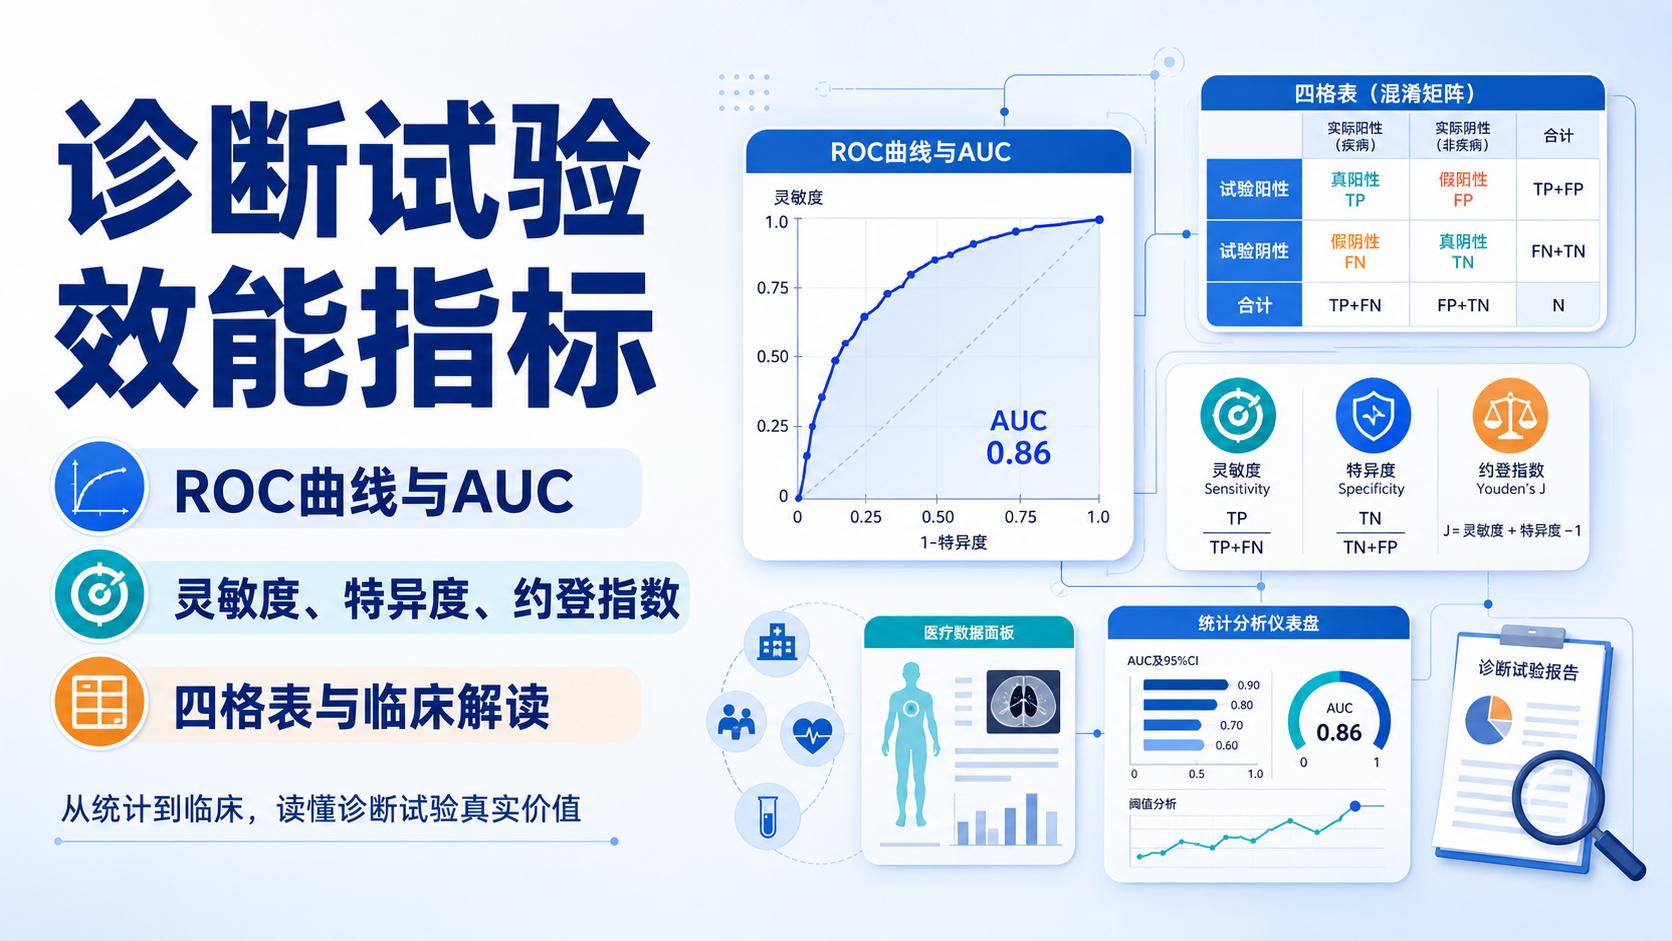
灵敏度 表示真正有病的人中,被试验正确识别为阳性的比例。它反映“发现病人”的能力。
特异度 表示真正无病的人中,被试验正确识别为阴性的比例。它反映“排除非病人”的能力。
这两个指标非常重要,但意义不同:
- 灵敏度高,适合筛查。
- 特异度高,适合确诊或排除误诊。
如果一个试验的灵敏度高但特异度低,可能漏诊少,但误诊多。反过来也是一样。临床上不能只看单一指标。
3.2 约登指数适合比较整体真实性
约登指数的计算公式是:
约登指数 = 灵敏度 + 特异度 - 1
它的范围在0到1之间。数值越大,说明试验整体区分病人与非病人的能力越强。
但要注意,约登指数不是万能指标。它不能替代临床判断。因为真实应用中,还要看:
- 检测成本。
- 操作流程。
- 患者接受度。
- 假阳性和假阴性的后果。
3.3 预测值受患病率影响,解读时必须结合场景
阳性预测值和阴性预测值更贴近临床沟通,因为它们回答的是:
- 检测阳性,真的有病概率多大。
- 检测阴性,真的没病概率多大。
但这两个值会受人群患病率影响 。同一个试验,在高危门诊和普通体检人群中,预测值可能完全不同。因此,论文解读时不能脱离研究场景。
4. ROC曲线与AUC:连续变量最重要的效能工具
4.1 为什么连续变量不能只看一个截断值
连续变量的难点在于,截断值不同,灵敏度和特异度会此消彼长。阈值设低了,灵敏度升高,特异度下降。阈值设高了,情况相反。
因此,不能只盯住一个点。ROC曲线的价值在于展示多个截断值下的综合表现。
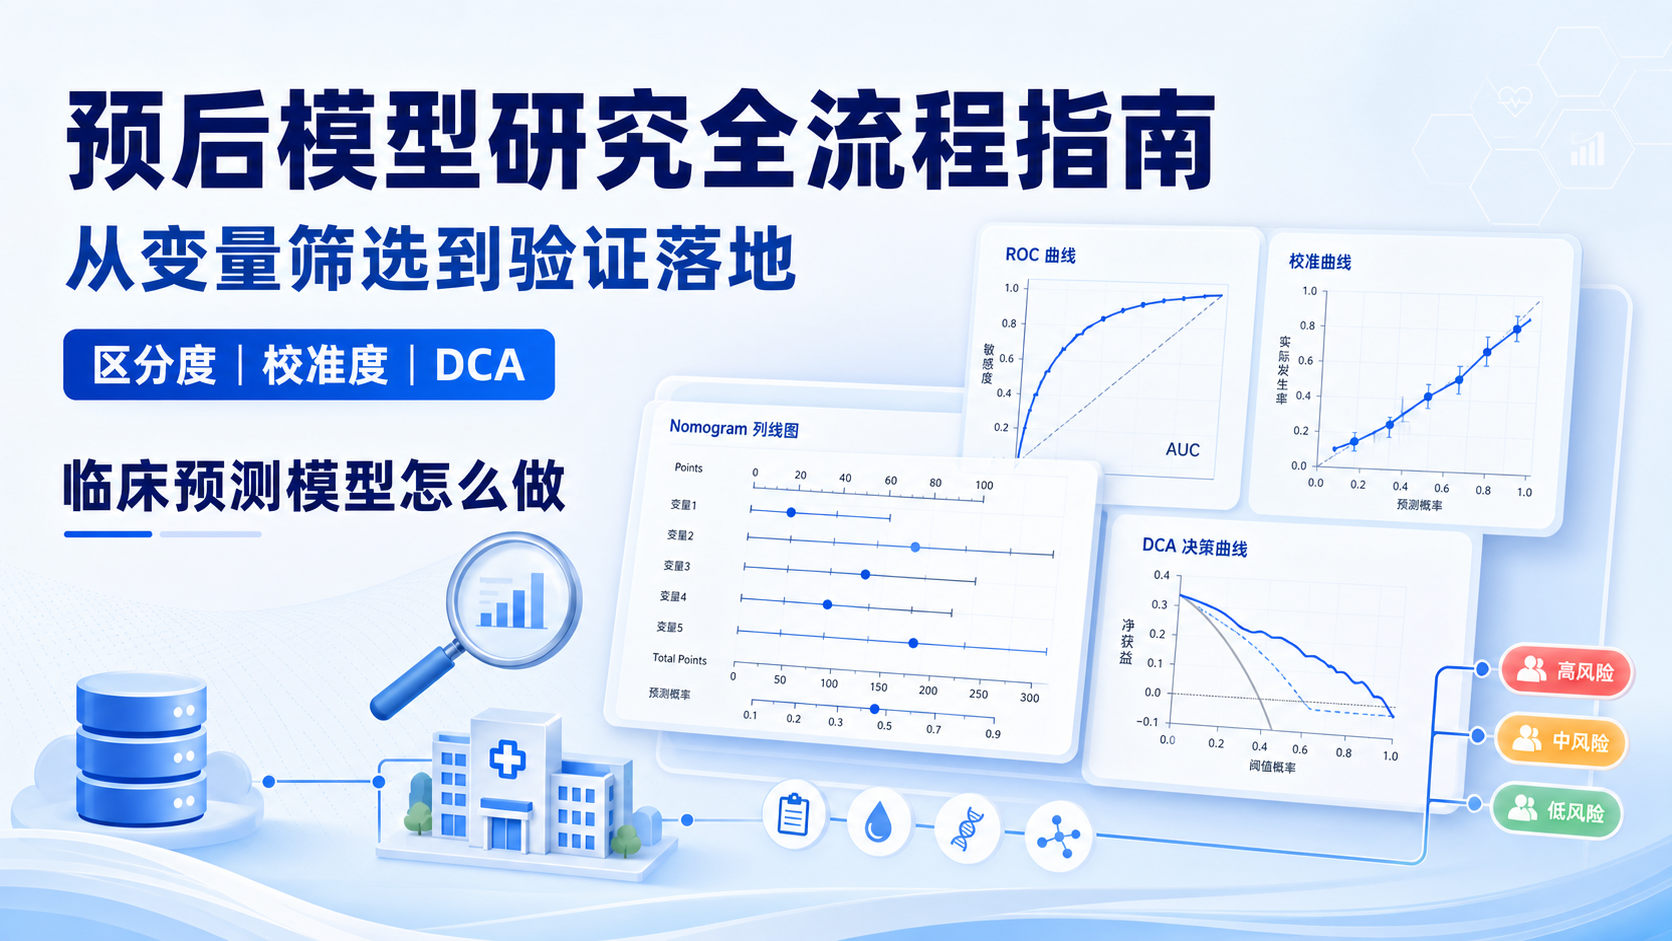
4.2 ROC曲线和AUC怎么理解
ROC曲线的纵坐标是灵敏度,横坐标是1减特异度。曲线越靠近左上角,诊断能力越强。
AUC,即曲线下面积,反映整体区分度:
- AUC = 0.5 ,接近随机猜测。
- AUC越接近1 ,诊断性能越好。
在方法学上,AUC比单一截断值更全面。它能帮助研究者比较不同检测方法的整体诊断能力。对于连续型诊断指标,AUC几乎是论文中的核心结果。
4.3 如何选择最佳截断值
常见做法是结合约登指数、临床代价和实际应用需求来选截断值。若偏向筛查,可优先提高灵敏度。若偏向确诊,可优先提高特异度。
论文中报告截断值时,建议同时写明:
- 截断值本身。
- 对应灵敏度。
- 对应特异度。
- 阳性预测值。
- 阴性预测值。
- AUC及其95%CI。
这样读者才能判断该指标是否真正适合临床落地。
5. 诊断试验结果在论文和临床中怎么用
5.1 四格表是分类变量研究的基础
对于二分类试验,四格表是最直观的结果表达方式。它把金标准和待评价方法交叉组合,形成四种情况:
- 真阳性。
- 假阳性。
- 假阴性。
- 真阴性。
基于四格表,才能进一步计算灵敏度、特异度、预测值和似然比。没有四格表,很多诊断指标都无从计算。
5.2 连续变量研究要重视统计质控
连续变量的诊断研究,常见问题包括:
- 截断值数据过拟合。
- 样本量不足。
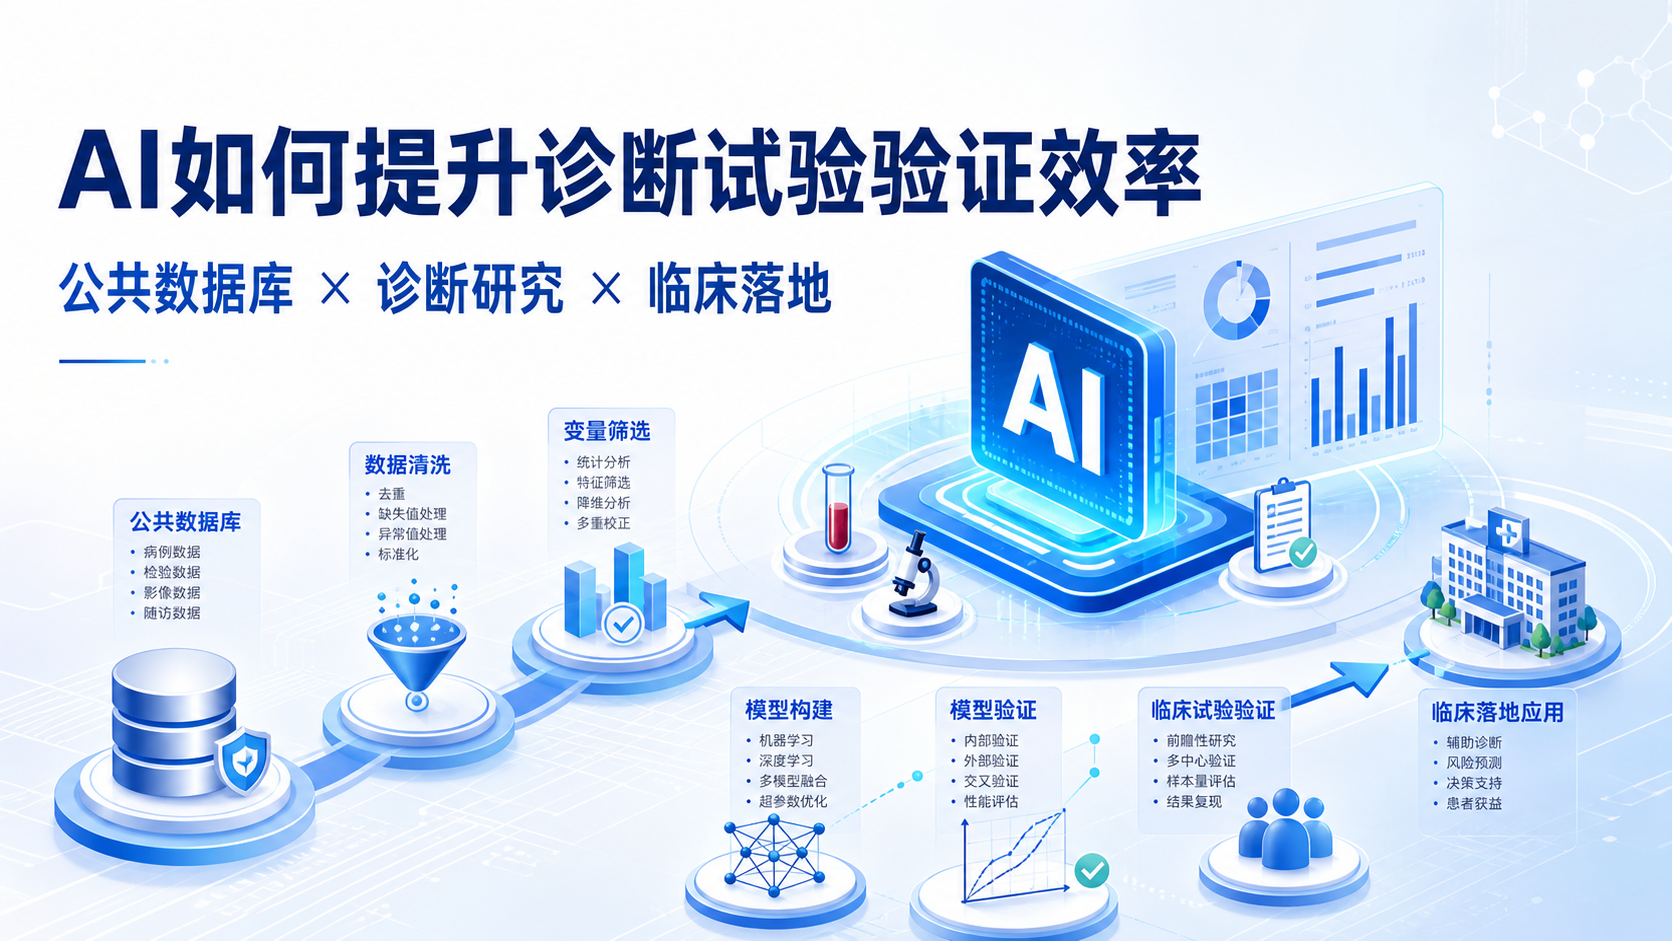
- 训练集和验证集混用。
- 缺少独立外部验证。
这些问题会导致AUC看起来很高,但实际临床效果一般。对于科研人员来说,“统计显著”不等于“临床可用” ,这是诊断研究最常见的误区之一。
5.3 临床实践中要看“适用场景”
诊断试验的最终目标,不是发表一组漂亮数字,而是优化临床路径。比如:
- 筛查场景,更适合高灵敏度。
- 确诊场景,更适合高特异度。
- 随访场景,更关注稳定性和重复性。
因此,评价一个指标时,必须把统计结果放回临床问题中。脱离场景的诊断指标,没有真正的临床解释力。
6. 诊断试验效能指标的常见误区
6.1 只看AUC,不看临床后果
AUC高,并不代表误诊代价低。某些疾病筛查中,假阳性会带来额外侵入性检查和焦虑;假阴性则可能延误治疗。效能指标必须与临床风险一起解读。
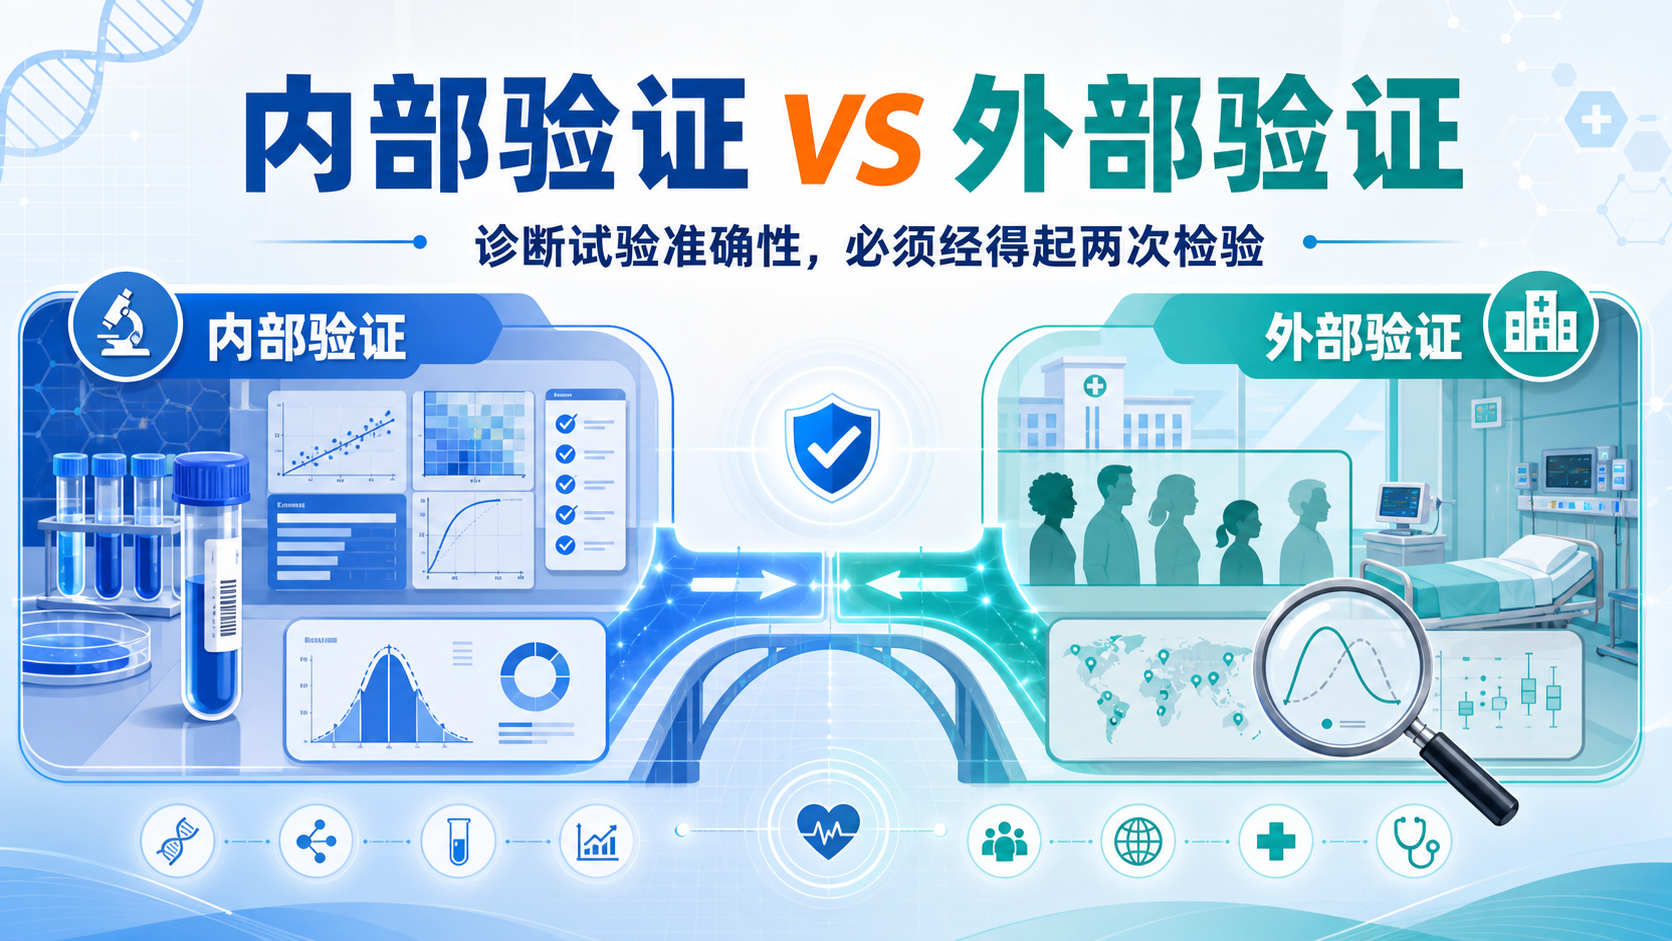
6.2 只看一个队列,不做验证
很多研究在单中心、单时间段完成,容易高估真实效果。更稳妥的做法是:
- 进行内部验证。
- 条件允许时做外部验证。
- 报告纳入和排除标准。
6.3 把统计结论直接等同于临床决策
诊断试验不是单纯的“分数竞赛”。真正的目标,是让医生更快、更准、更安全地决策。如果一个方法虽准确但成本过高、流程复杂,它仍可能难以推广。
总结Conclusion
诊断试验效能指标的核心,是回答一个临床问题:这个方法是否足够准确、稳定,并且值得应用。 对分类变量,应重点掌握四格表、灵敏度、特异度和约登指数。对连续变量,应重视ROC曲线、AUC和截断值选择。更重要的是,任何指标都要放回具体临床场景中解读。
如果你正在撰写诊断试验论文,或者需要系统梳理研究设计与统计指标,建议结合规范方法学工具进行整理。解螺旋 可以帮助你更高效地完成诊断试验设计、结果表达和论文优化,让你的研究更接近发表与转化的标准。
- 引言Introduction
- 1. 诊断试验为什么必须看效能指标
- 2. 诊断试验效能指标的设计基础
- 3. 诊断试验效能指标怎么解读
- 4. ROC曲线与AUC:连续变量最重要的效能工具
- 5. 诊断试验结果在论文和临床中怎么用
- 6. 诊断试验效能指标的常见误区
- 总结Conclusion