9
 分享
引言Introduction
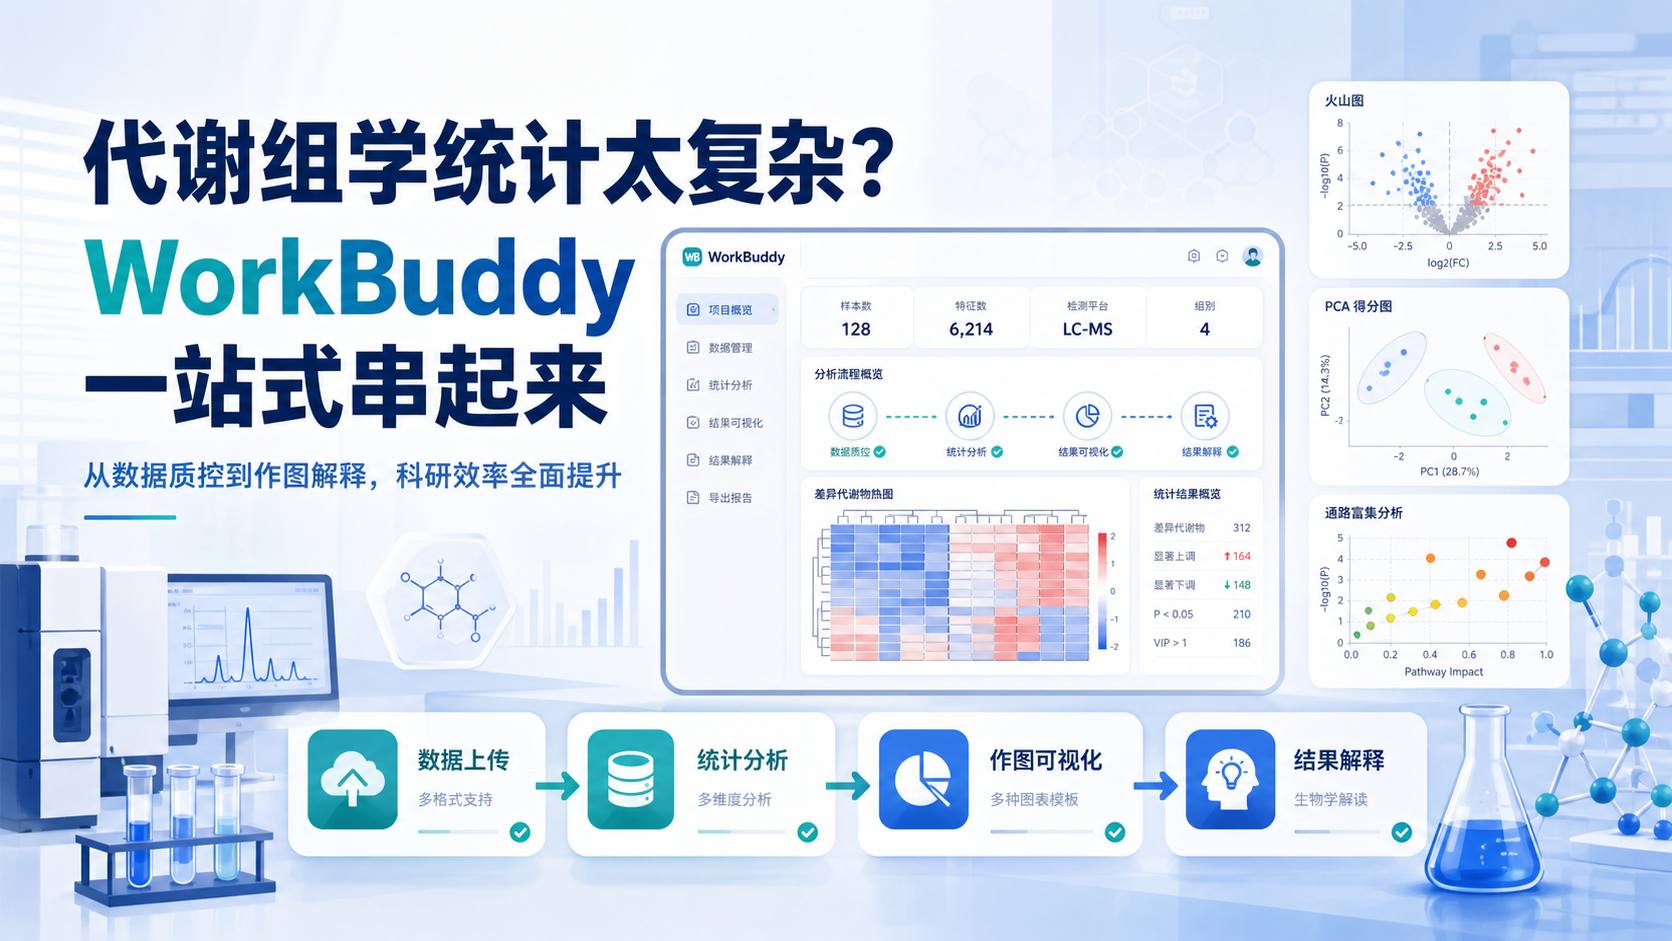
代谢组学统计常卡在三件事。数据格式不统一,方法选择多,结果解释又容易跑偏。对医学生、医生和科研人员来说,真正难的不是“有没有工具”,而是如何把统计流程做对、做完整、还能写进论文 。
1. 代谢组学统计为什么总是难
1.1 数据维度高,前处理要求严
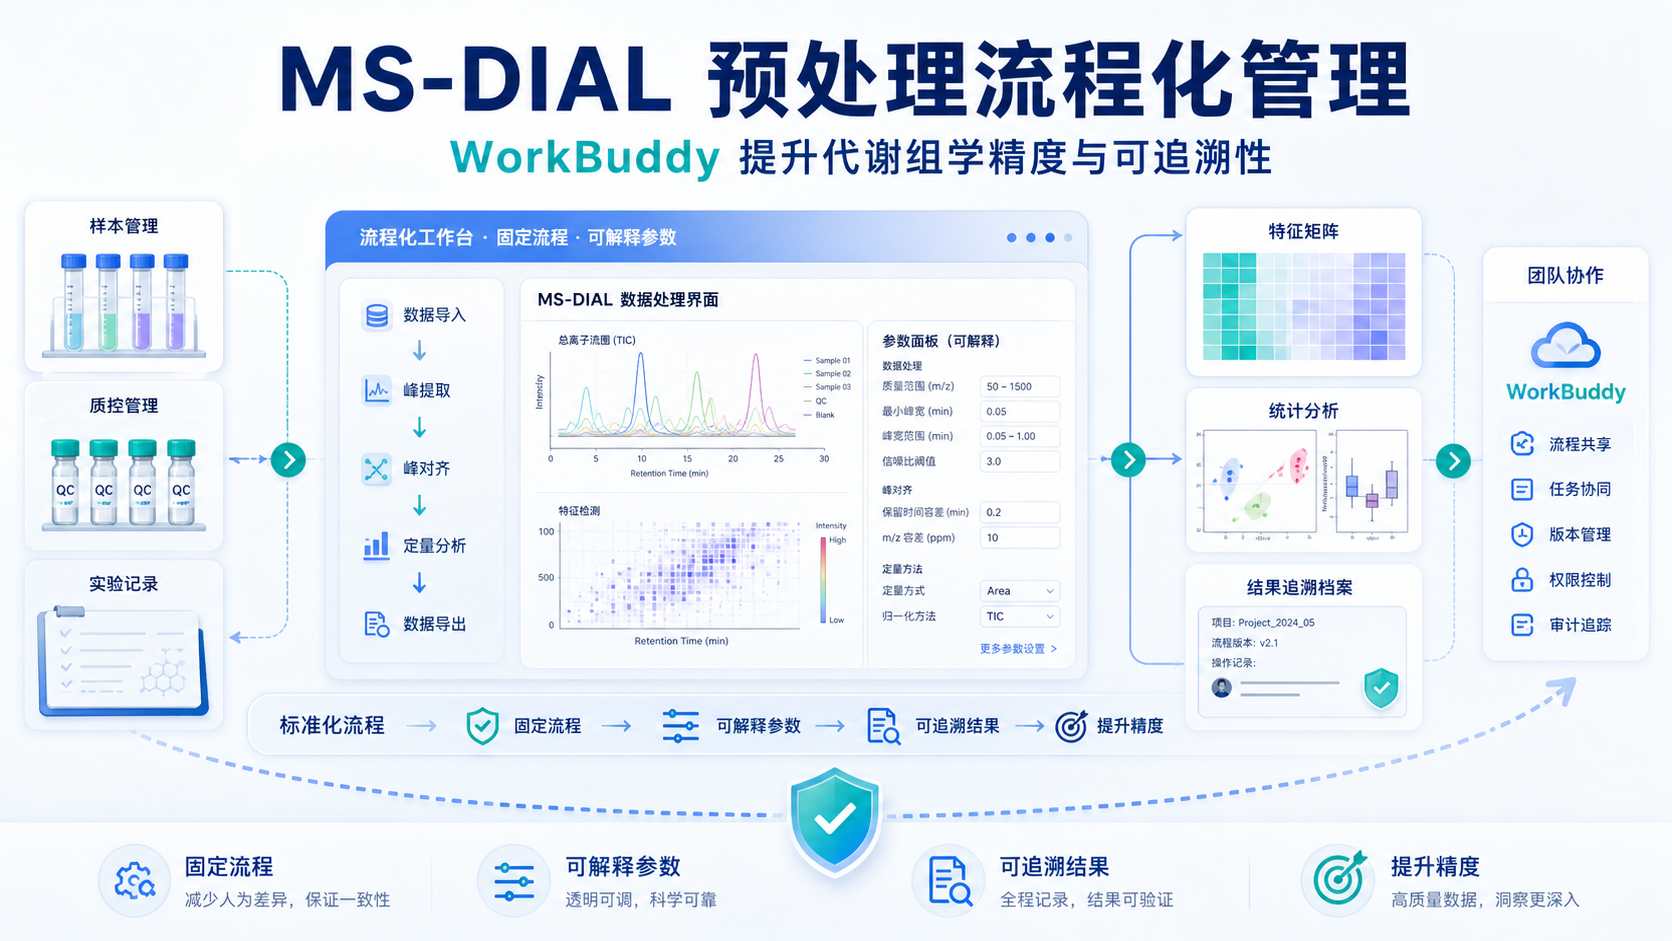
代谢组学数据通常包含数百到数千个代谢特征。不同批次、不同仪器、不同离子模式,都会带来缺失值、噪音和批次效应。如果前处理不到位,后面的差异分析和通路富集都会失真。
常见问题包括:
- 峰提取参数不一致。
- 缺失值填补方法选错。
- 归一化方式不匹配样本类型。
- 批次效应校正不到位。
这些问题看似基础,却直接决定结果可信度。很多研究不是统计方法不够高级,而是输入数据本身不够干净 。
1.2 方法多,但不是每一步都适合照搬
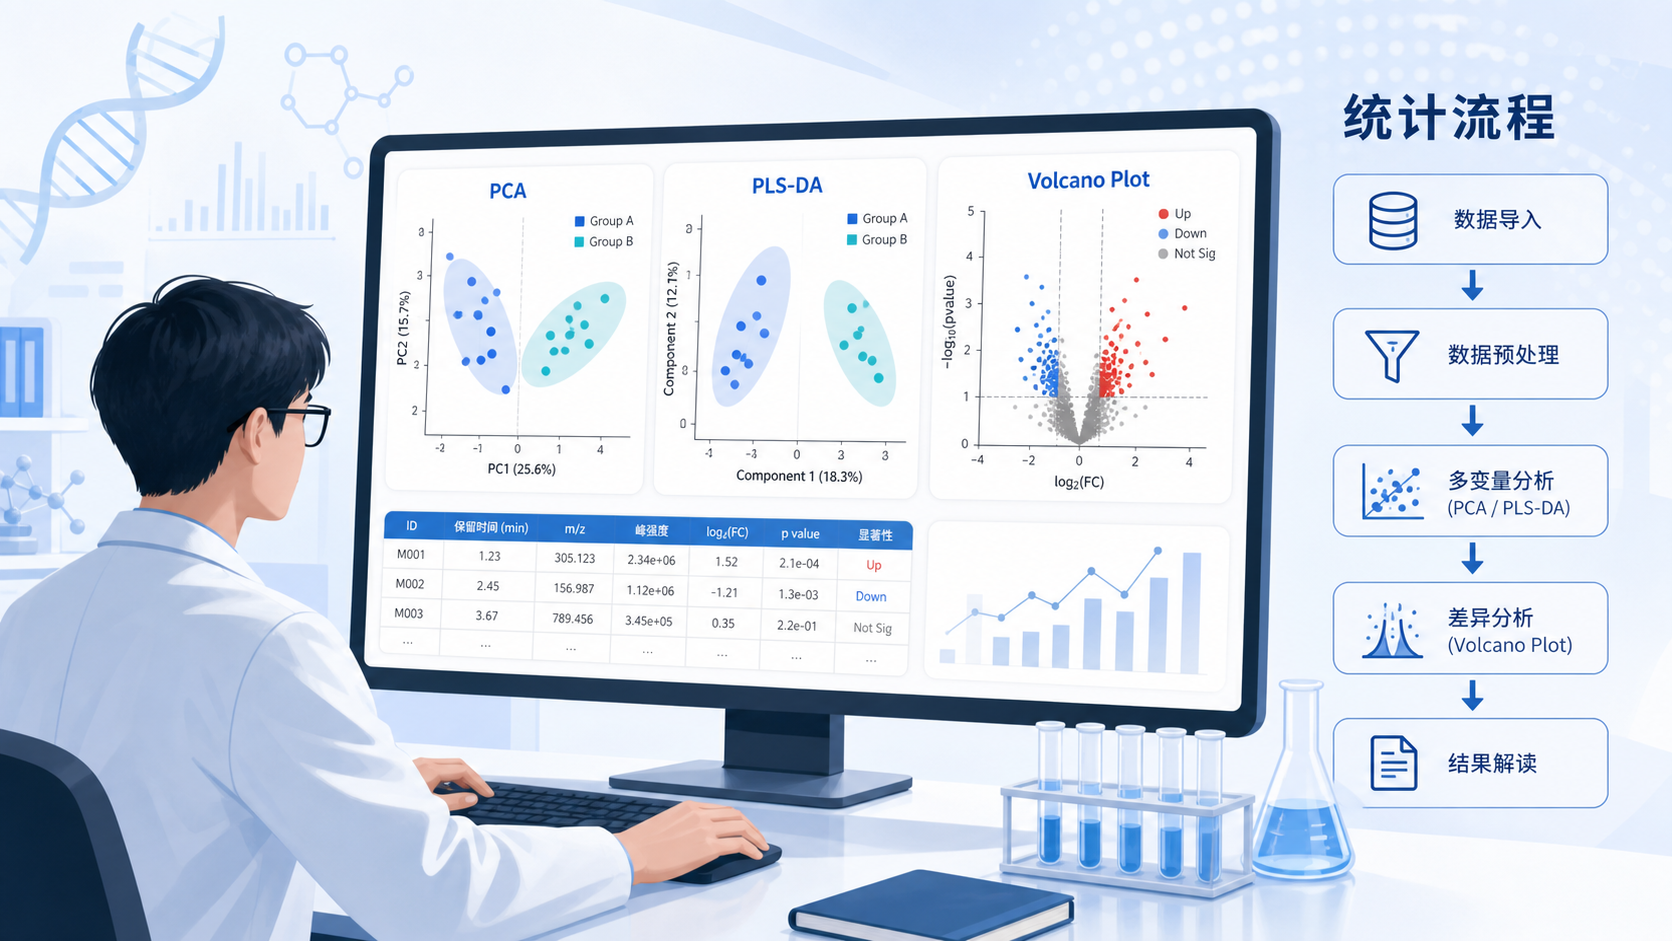
代谢组学统计常见流程包括 PCA、PLS-DA、OPLS-DA、差异代谢物筛选、火山图、聚类热图、KEGG 通路分析等。问题在于,每一种方法都有前提条件 。
例如:
- PCA 更适合观察整体分布和异常点。
- PLS-DA 适合分类,但容易过拟合,必须结合交叉验证。
- OPLS-DA 可以增强分组解释,但同样需要注意模型稳健性。
- 差异筛选不能只看 fold change,还要结合 P 值和 FDR。
如果流程是断裂的,结果就会出现“图很多,结论很弱”的情况。对论文审稿来说,这类问题很容易被质疑。
2. WorkBuddy如何把代谢组学统计流程串起来
2.1 从上传数据开始,减少重复劳动
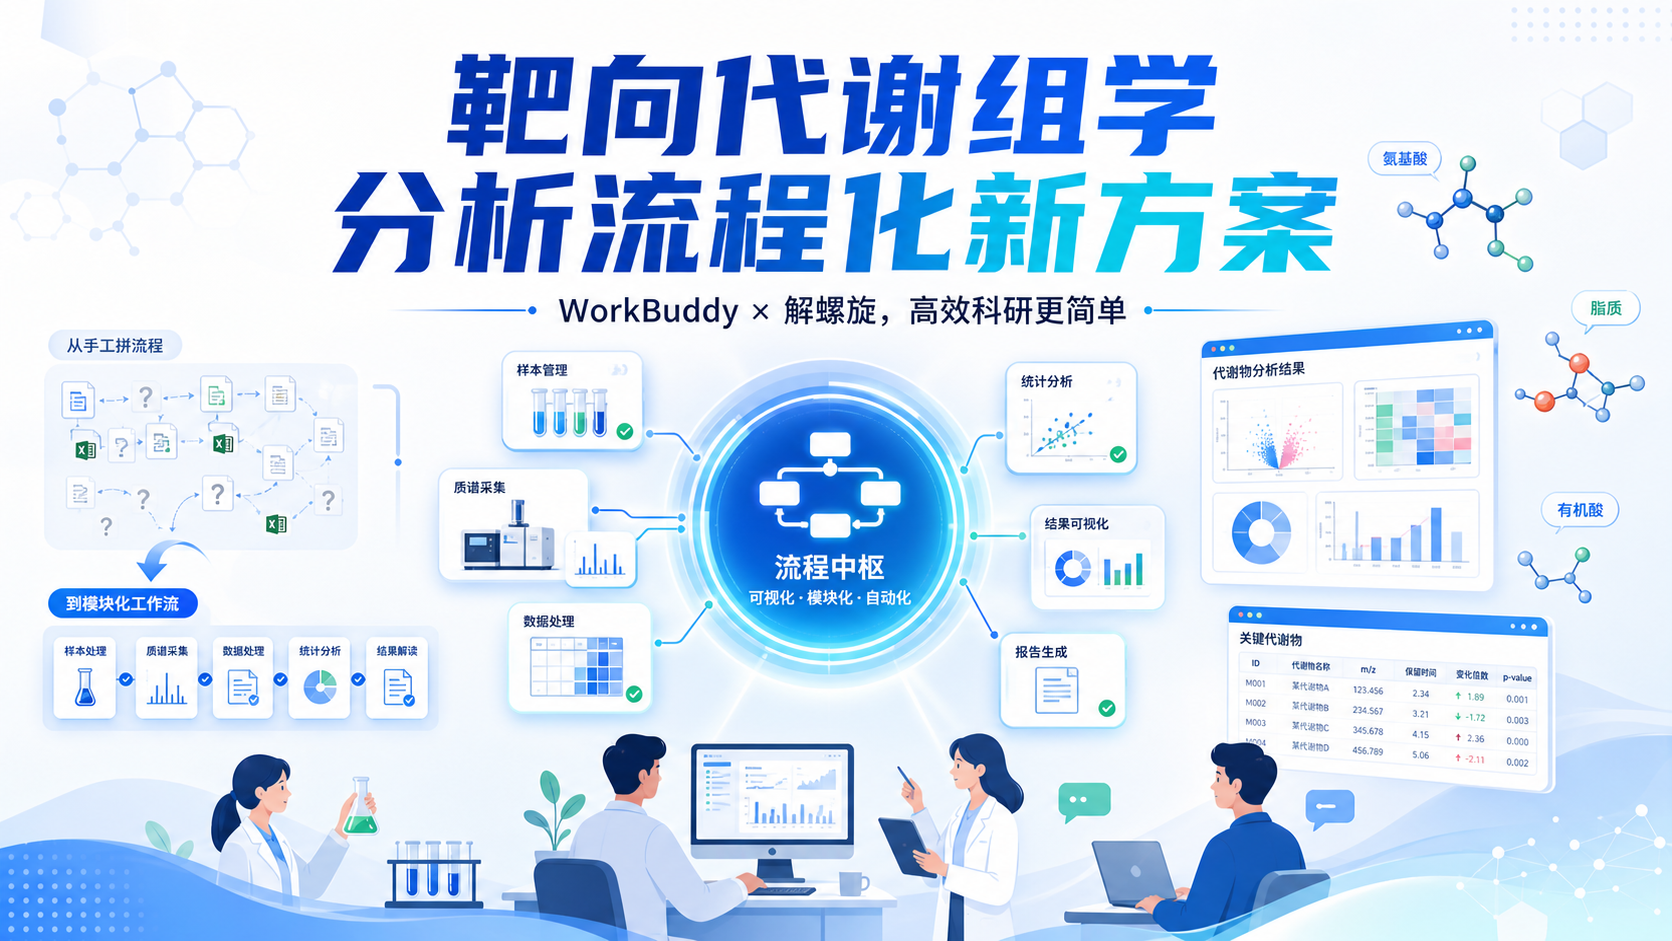
WorkBuddy的优势,不是单点功能,而是把代谢组学统计的关键步骤串成可执行流程 。对不熟悉代码的用户来说,这一点尤其重要。它更适合从“原始表格”直接进入“可解释结果”,减少来回切换工具的成本。
实际使用中,用户通常只需要准备规范化后的代谢组学矩阵、分组信息和必要注释。随后可以进入数据分析、可视化和结果解读环节。对于课程学习、课题初筛和论文预分析,这种一键化路径更高效。
2.2 统计、作图、解释可以在同一工作流完成
代谢组学统计最耗时的地方,不只是计算,而是“结果整理”。很多人做完分析后,还要手动拼图、补注释、改图例、写方法学描述。WorkBuddy的思路是把这些步骤前移。
它的价值体现在三个层面:
- 自动生成分析路径 ,减少漏步骤。
- 同步输出图表结果 ,方便直接整理进汇报或论文。
- 结合分析套路提炼 ,帮助用户理解每一步为何存在。
这对新手尤其友好。因为新手最怕的不是算不出来,而是算出来以后不知道下一步做什么。对有经验的研究者来说,它则能节省大量重复性操作,把时间留给科学问题本身。
2.3 不只给结果,还给后续研究方向
一个好的代谢组学统计方案,不能停留在差异代谢物列表。更关键的是,要把统计结果转化为研究假设、机制线索和后续实验设计 。这也是WorkBuddy比单纯分析工具更有价值的地方。
例如在代谢组学项目中,统计结果通常可以进一步延伸到:
- 关键代谢通路定位。
- 与临床分组或表型关联分析。
- 多组学联合分析。
- 候选标志物筛选。
- 后续验证实验设计。
也就是说,它不只是回答“差异在哪里”,还尽量帮助用户回答“为什么差异出现”和“下一步怎么验证”。这更符合真实科研工作流。
3. 代谢组学统计中最该关注的几个关键环节
3.1 先看数据质量,再谈模型
代谢组学统计的第一原则是先看数据质量。没有稳定的数据基础,再漂亮的模型也不可靠。建议优先检查以下指标:
- 缺失值比例。
- QC 样本聚集情况。
- 组内变异系数。
- 异常值和离群点。
- 批次效应是否明显。
如果 QC 样本在 PCA 图中明显分散,说明前处理或仪器稳定性可能存在问题。 这时应先回到数据清洗,而不是直接进入差异分析。
3.2 差异筛选要兼顾统计学和生物学意义
很多代谢组学项目会直接用 P 值和 fold change 选代谢物,但这还不够。更稳妥的做法是把统计显著性、效应量和生物学背景一起考虑。
常用判断逻辑包括:
- P 值控制显著性。
- FDR 控制多重比较错误。
- fold change 反映变化幅度。
- 通路一致性验证生物学合理性。
只有同时满足统计可靠和生物学可解释,差异代谢物才更适合进入后续验证。
3.3 可视化不是装饰,而是验证过程的一部分
在代谢组学统计里,图不是最后一步,而是质量控制的一部分。PCA、热图、火山图、S-plot、通路图,都是帮助判断结果是否稳定、是否有方向性的重要证据。
尤其在论文写作中,审稿人会重点看:
- 分组是否分离清楚。
- 样本是否存在明显离群。
- 筛选阈值是否合理。
- 富集结果是否与研究假说一致。
因此,好的图表不是“好看”,而是“能支持结论”。
4. 谁更适合用WorkBuddy做代谢组学统计
4.1 适合新手,也适合需要提效的老手
WorkBuddy并不是只服务于零基础用户。相反,它同时适合两类人群。
第一类是刚接触代谢组学统计的研究生和年轻医生。对他们来说,最大的难点是流程不熟,容易漏步骤。WorkBuddy可以把分析顺序、图表逻辑和结果表达串起来,降低入门门槛。
第二类是已经有经验、但任务量大的研究者。对他们来说,重复性工作最耗时间,比如数据整理、初步统计、图表输出和方法学框架搭建。一键化方案的意义,就是把时间从机械劳动中释放出来。
4.2 适合课题启动、论文初稿和组会汇报
代谢组学项目往往不是一次性完成。它要经历选题、预实验、正式分析、论文写作、返修和汇报多个阶段。WorkBuddy更适合这些高频场景。
你可以把它用于:
- 课题启动时的统计框架搭建。
- 文献阅读后的分析路径梳理。
- 初步数据分析和结果筛选。
- 论文图表与方法段落整理。
- 组会和答辩中的结果展示。
这种场景化应用,比单纯强调“功能多”更有实际价值。因为科研人员真正要的是可复用、可解释、可落地 的工作流。
总结Conclusion
代谢组学统计难,难在数据复杂,方法繁多,结果还必须可解释。真正高效的做法,不是盲目叠加工具,而是建立一条从数据处理到结果解释的完整流程。WorkBuddy的价值,就在于把代谢组学统计从分散操作变成一键化工作流。
如果你正在做代谢组学项目,想提升分析效率、减少重复劳动、让结果更快进入论文和课题设计,可以进一步了解解螺旋的WorkBuddy体系。它不仅能帮助你完成统计,更能把分析结果延伸为下一步研究方案。
- 引言Introduction
- 1. 代谢组学统计为什么总是难
- 2. WorkBuddy如何把代谢组学统计流程串起来
- 3. 代谢组学统计中最该关注的几个关键环节
- 4. 谁更适合用WorkBuddy做代谢组学统计
- 总结Conclusion