34
 分享
引言Introduction
T细胞表位预测正在成为疫苗设计、肿瘤新抗原筛选和个体化免疫治疗的关键环节。预测不准,会直接浪费实验成本,拉低候选表位命中率。 对医学生、医生和科研人员来说,真正的难点不只是找表位,而是如何在有限时间内提高预测效率与可靠性。
1. 为什么T细胞表位预测越来越重要
1.1 从“筛选抗原”走向“筛选可呈递表位”
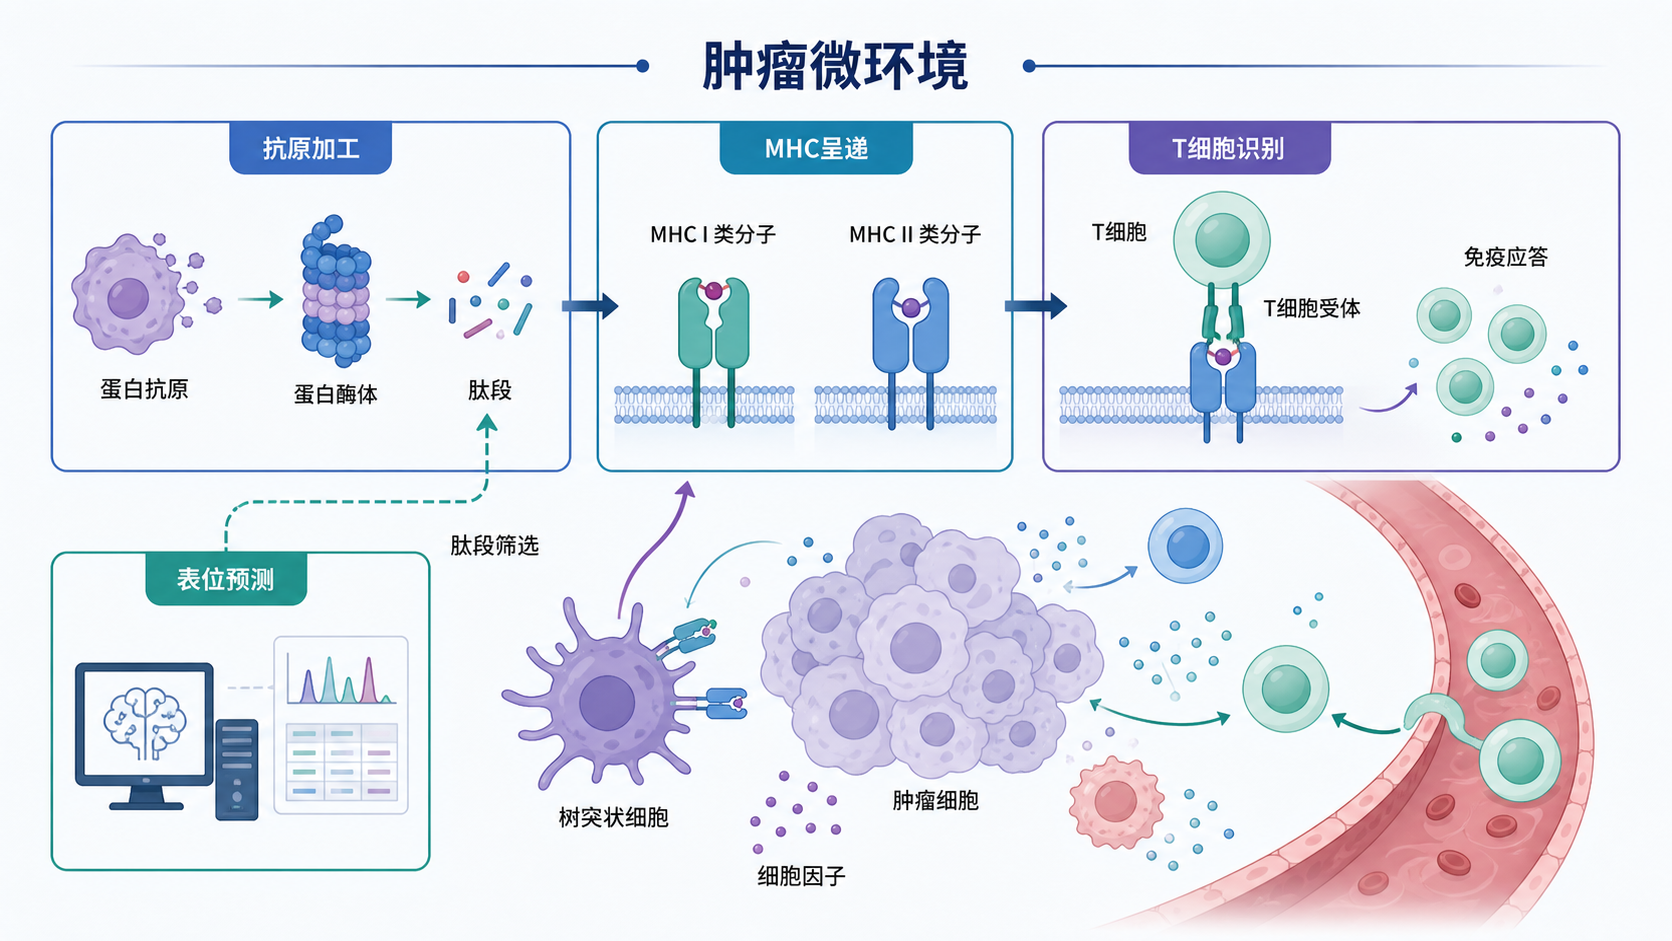
T细胞并不直接识别完整蛋白,而是识别由抗原加工后形成的肽段。
这些肽段需要经过MHC分子呈递,才能被T细胞受体识别。因此,真正具有免疫学意义的不是“是否有突变”,而是“是否能被加工、结合并呈递”。
这也是T细胞表位预测的核心价值。
它把候选抗原从“全蛋白层面”缩小到“可被T细胞识别的短肽层面”,从而显著提高后续实验验证效率。
1.2 在精准免疫治疗中的实际作用
T细胞表位预测已经广泛用于以下方向:
- 肿瘤新抗原筛选 ,用于个体化肿瘤疫苗设计。
- 感染性疾病疫苗研发 ,用于识别免疫原性更强的保护性表位。
- 自身免疫研究 ,用于分析异常免疫识别的潜在靶点。
- 免疫治疗分层 ,用于辅助判断哪些患者更可能从治疗中获益。
对临床转化而言,表位预测的意义在于缩短候选靶点筛选周期。
对科研而言,它决定了实验验证是否建立在合理的生物学基础上。
2. T细胞表位预测依赖哪些关键生物学环节
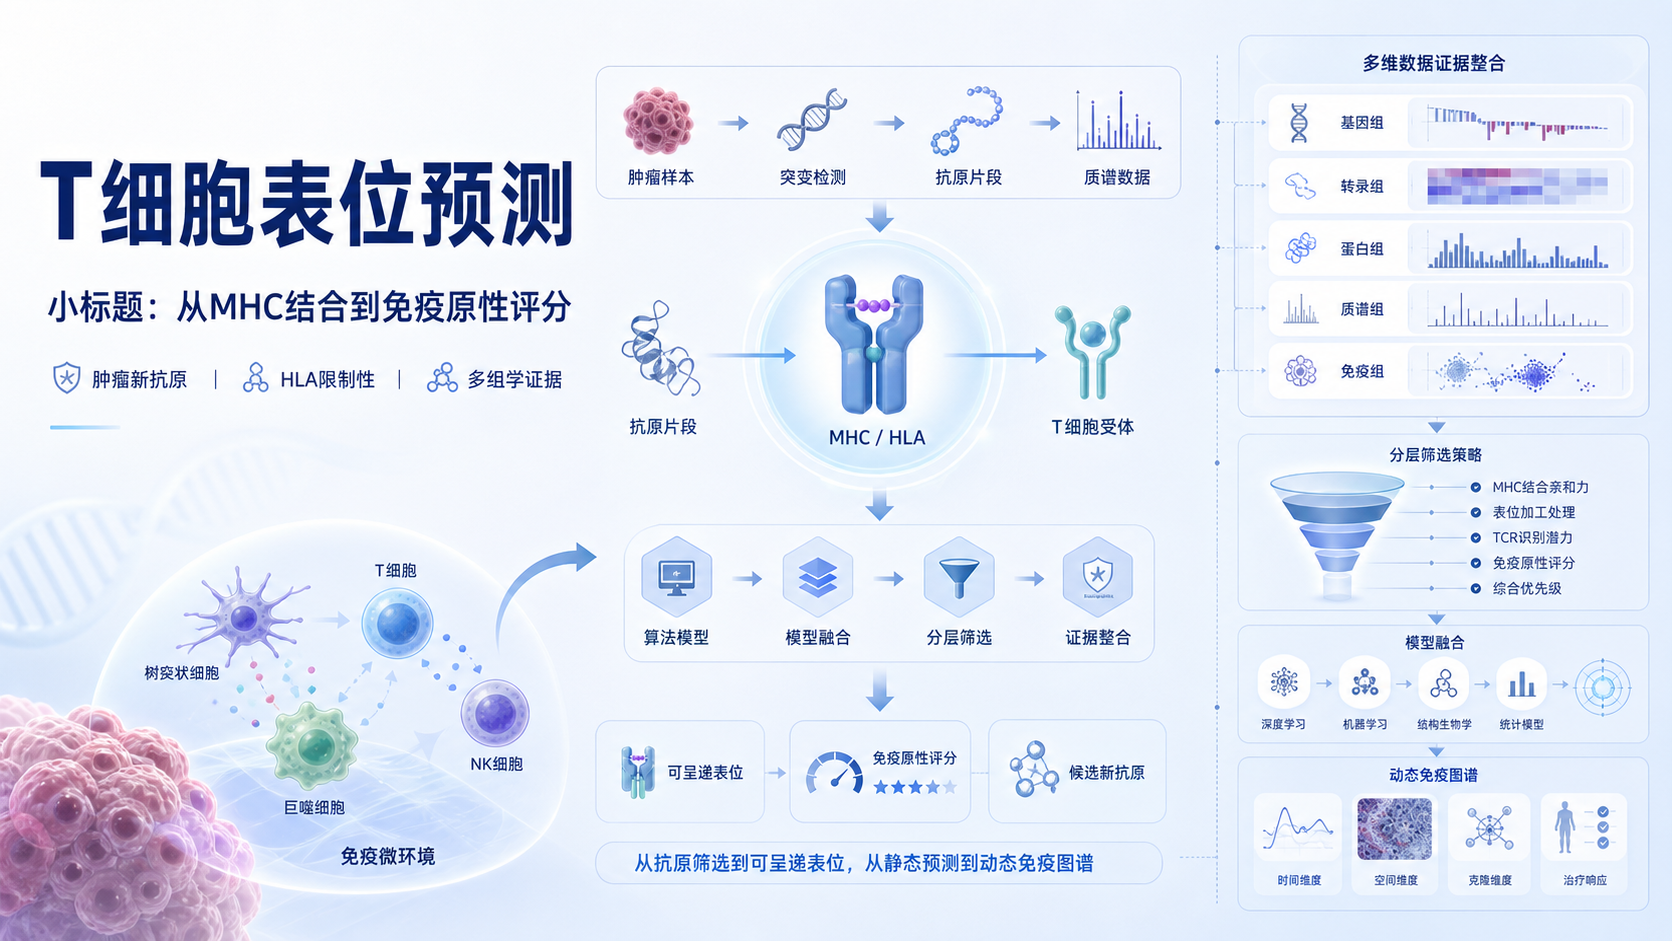
2.1 抗原加工、MHC结合和TCR识别是三个层次
一个高效的T细胞表位预测,不能只看MHC结合亲和力。
它至少涉及三个步骤:
- 蛋白水解加工 ,候选肽段是否能从母体蛋白中产生。
- MHC分子结合 ,肽段是否能稳定进入HLA结合槽。
- T细胞识别 ,呈递后的复合物是否真正触发免疫反应。
很多研究中,MHC高亲和力并不等于强免疫原性。
因为真实体内还受抗原加工效率、肽段稳定性、HLA表达水平和T细胞库等因素影响。
2.2 HLA限制性决定了预测必须个体化
T细胞表位具有明显的HLA限制性。
同一个肽段,在不同HLA背景的人群中,呈递能力可能完全不同。
这意味着:
- 肿瘤疫苗设计要匹配患者HLA型别。
- 人群疫苗研究要覆盖主流HLA等位基因。
- 预测模型需要结合具体HLA背景,而不是只看肽段序列。
如果忽略HLA分型,预测结果很难直接转化到真实临床场景。
3. 当前高效T细胞表位预测的主流方法
3.1 基于MHC结合预测的经典路线
这是最常见、也最成熟的方法。
其核心是根据肽段序列预测其与MHC I类或II类分子的结合能力。
常用输入包括:
- 肽段长度
- 氨基酸序列
- HLA等位基因类型
- 已知结合位点特征
这类方法速度快,适合大规模初筛。
但它的局限也很明确,只能说明“可能被呈递”,不能完全说明“必然有免疫原性”。
3.2 基于免疫原性评分的综合模型
近年来,研究者开始把更多因素纳入模型。
除了结合亲和力,还会考虑:
- 肽段在蛋白中的来源位置
- 是否来自突变位点
- 处理后形成的概率
- 与自身肽段的相似性
- 受体识别潜力
这类模型更接近真实免疫过程。
它的优势是更适合做优先级排序。
在候选表位数量很多时,综合模型通常比单一亲和力模型更有实用价值。
3.3 质谱免疫肽组学为预测提供“真实世界证据”
如果说计算预测回答的是“可能”,那么免疫肽组学回答的就是“已经发生”。
通过质谱直接检测HLA分子表面呈递的肽段,可以为预测模型提供实证数据。
它的意义主要有三点:
- 验证预测结果是否真实呈递。
- 发现经典算法遗漏的天然表位。
- 训练更贴近生物学现实的机器学习模型。
对高质量研究来说,计算预测和实验验证不应割裂。
最佳策略通常是先计算筛选,再用免疫肽组学或功能实验验证。
4. 如何提高T细胞表位预测的准确性
4.1 先做高质量输入数据控制
预测准确性很大程度上取决于输入数据质量。
常见问题包括:
- 突变检测假阳性
- 转录本表达不足
- HLA分型不准确
- 肽段长度设置不合理
如果输入本身有误,后续再复杂的模型也难以补救。
所以,预测前的数据清洗比很多人想象中更重要。
建议优先确认以下内容:
- 变异位点是否经过高置信度过滤。
- 目标基因是否有表达证据。
- HLA分型是否来源于可靠测序。
- 候选肽段是否符合MHC I或II的长度范围。
4.2 采用分层筛选策略
高效预测不是一次性“全靠模型解决”。
更合理的做法是分层筛选。
可参考以下步骤:
- 先按突变和表达筛选候选蛋白。
- 再预测MHC结合能力。
- 进一步评估加工和呈递可能性。
- 最后结合免疫原性和保守性排序。
这种方式能显著减少假阳性。
也更适合在肿瘤新抗原研究中提高实验资源利用率。
4.3 结合多组学证据提升可信度
单纯的序列预测仍然有限。
如果能结合以下信息,可信度会更高:
- RNA表达数据
- 蛋白质组学数据
- HLA免疫肽组学数据
- TCR测序数据
- 肿瘤微环境信息
多组学整合的本质,是把“理论可能”变成“生物学证据链”。
这对于发表高质量论文和推进转化研究都很关键。
5. 典型应用场景:肿瘤新抗原与免疫治疗
5.1 肿瘤新抗原筛选更依赖精准预测
肿瘤新抗原通常来源于体细胞突变。
并不是每个突变都能形成有效表位。
真正有价值的是那些能够被加工、呈递,并且被T细胞识别的突变肽。
因此,肿瘤新抗原筛选常常采用以下思路:
- 识别非同义突变。
- 预测突变肽与HLA的结合能力。
- 排除低表达或无转录证据候选。
- 优先保留高可信度高表达表位。
这类流程已经成为个体化肿瘤疫苗、TCR-T研发和免疫治疗伴随诊断的重要基础。
5.2 预测结果要服务于“可验证性”
一个好的候选表位,不只是分数高。
还要满足实验可验证、临床可解释、转化可推进。
因此,研究设计上建议优先关注:
- 预测分数高的候选肽。
- 来自驱动基因或克隆性突变的候选肽。
- 与肿瘤特异性更强、正常组织风险更低的候选肽。
高效预测的终点不是生成列表,而是筛出真正值得做实验的表位。
6. 未来趋势:从静态预测走向动态免疫图谱
6.1 单一算法正在被多模型融合取代
未来的T细胞表位预测,会越来越少依赖单一算法。
更可能的发展方向是:
- 融合机器学习和深度学习
- 融合免疫肽组学实证数据
- 融合HLA结构信息
- 融合TCR识别偏好
这意味着预测不再只是“算分”,而是构建更完整的免疫识别图谱。
模型越接近真实生物过程,临床可用性越高。
6.2 从预测表位到解释免疫微环境
对医学生和科研人员而言,更值得关注的是,表位预测正在与免疫微环境分析结合。
尤其在肿瘤研究中,表位是否被呈递,和肿瘤细胞抗原加工、免疫逃逸、T细胞浸润状态密切相关。
这使得T细胞表位预测不再是单独的生物信息学步骤。
它正在成为精准免疫治疗策略的一部分。
总结Conclusion
T细胞表位预测的核心,不是简单找出“高亲和力肽段”,而是在抗原加工、HLA呈递和T细胞识别三个层面同时提高命中率 。对肿瘤新抗原筛选、疫苗设计和免疫治疗分层而言,分层筛选、多组学整合和实验验证缺一不可。如果你希望把预测结果真正转化为可发表、可验证、可落地的研究流程,建议借助解螺旋的专业支持,系统提升表位筛选效率与研究质量。
- 引言Introduction
- 1. 为什么T细胞表位预测越来越重要
- 2. T细胞表位预测依赖哪些关键生物学环节
- 3. 当前高效T细胞表位预测的主流方法
- 4. 如何提高T细胞表位预测的准确性
- 5. 典型应用场景:肿瘤新抗原与免疫治疗
- 6. 未来趋势:从静态预测走向动态免疫图谱
- 总结Conclusion