34
 分享

引言Introduction
BCR克隆型分析看似只是“找相同序列”,实则决定了后续克隆扩增、免疫多样性和纵向追踪结论是否可靠。很多结果不一致,不是生物学差异,而是前处理、标准化和参数选择不统一。先把流程标准化,才有资格谈结论。 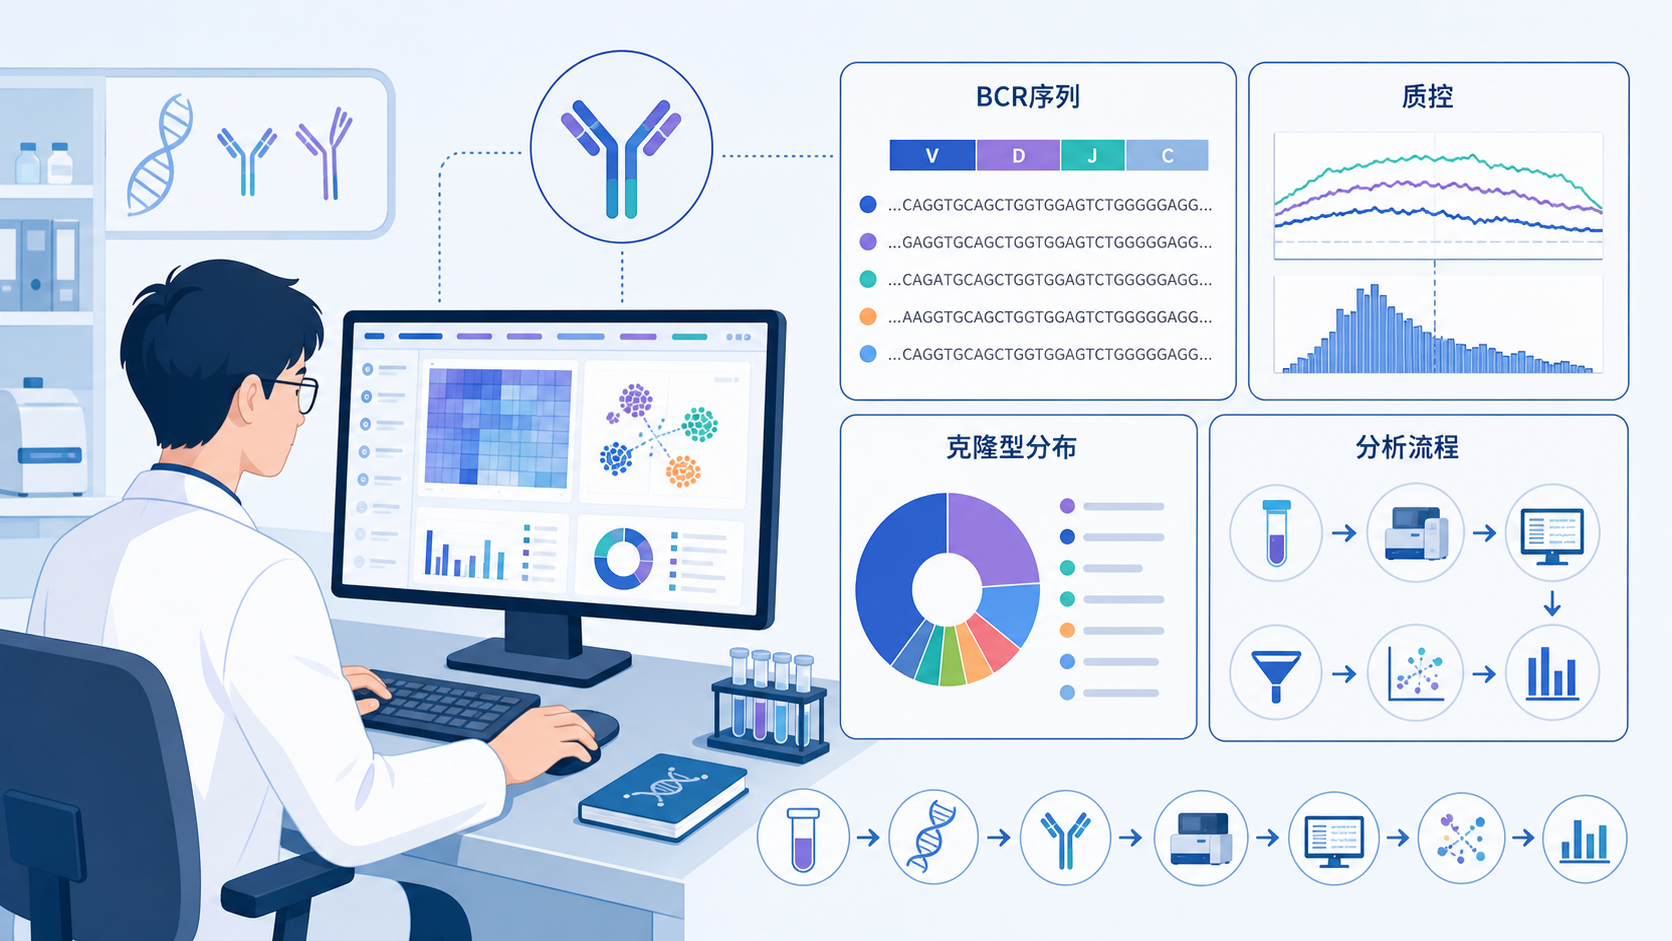
1. 为什么BCR克隆型分析必须先做标准化
1.1 原始数据不统一,结果就会漂移
BCR克隆型分析通常来自高通量免疫组库测序。不同批次、不同平台、不同建库策略,会带来读长、测序深度、错误率和重复率差异。如果不先标准化,克隆型频率、克隆扩增倍数和共享克隆比例都可能被技术噪音放大。
在实际分析中,最常见的问题有三类。
- 样本测序深度差异过大。
- 低质量序列未清理。
- 同一克隆型因比对或聚类规则不同而被拆分或合并。
这些问题会直接影响下游统计。尤其在比较病例组和对照组,或者治疗前后配对样本时,偏差会被误判为生物学信号。
1.2 标准化的目标不是“美化数据”
标准化的核心,是让不同样本在同一规则下可比。它不是把结果修得更好看,而是尽量减少技术层面的系统偏差。对于BCR克隆型分析,标准化重点包括质控、去冗余、统一注释和合理归一化。
这一步做得好,后面才可能准确回答三个问题。
- 哪些克隆型真正扩增。
- 哪些差异来自疾病状态。
- 哪些变化可用于纵向追踪。
2. BCR克隆型分析的标准化流程
2.1 先做样本质控,再决定是否保留
BCR分析不能直接上来就聚类。第一步应先看每个样本的测序质量、有效读段比例、链型分布和克隆覆盖情况。若一个样本有效序列数明显低于其他样本,或错误率异常高,就要优先排查。
常用的质控关注点包括。
- 总reads数。
- 去除低质量后保留比例。
- 可成功注释到V/D/J和CDR3的比例。
- 重复序列比例。
- 克隆型分布是否极度偏斜。
如果某个样本在多维指标上都明显偏离其他样本,通常应先剔除或单独标记,而不是直接参与主分析。 这和芯片数据里先做质量评估、排查离群样本的思路一致。
2.2 统一克隆型定义,是标准化的核心
BCR克隆型分析最关键的步骤,是明确“什么叫同一个克隆型”。不同研究会采用不同定义,常见维度包括。
- V基因相同。
- J基因相同。
- CDR3氨基酸序列相同,或高度相近。
- 是否要求重链单独分析,或联合轻链分析。
- 是否按VJ组合、CDR3长度或SHM水平进一步分层。
如果定义不统一,同一个数据集在不同软件里可能得到完全不同的克隆数。 所以在写方法学时,必须明确说明判定规则,不能只写“按默认参数分析”。
2.3 去冗余和错误纠正要尽早完成
免疫组库测序中,PCR扩增和测序错误会制造大量“假克隆型”。标准化流程应尽早做去冗余和错误纠正,避免把技术噪音当成真实克隆。
建议优先处理以下情况。
- 单碱基错配造成的近似重复序列。
- 低频、仅出现1到2次的可疑序列。
- 明显由PCR偏倚导致的高重复簇。
去冗余不是简单删掉低频序列,而是要结合序列相似性、UMI信息和文库设计来判断。 如果有UMI,优先用UMI校正;如果没有UMI,则要更依赖严格的质量过滤和克隆聚类规则。
3. 关键参数怎么选,才不会影响结论
3.1 克隆聚类阈值要和研究目的匹配
BCR克隆型分析里,最容易引发争议的就是聚类阈值。阈值过松,会把不同来源的B细胞误并为一个克隆型。阈值过严,则会把真实同源克隆拆碎。
常见做法包括。
- 精确匹配CDR3氨基酸序列。
- 允许一定错配比例。
- 结合V基因和J基因共同定义克隆。
如果研究重点是疫苗应答或肿瘤免疫中克隆扩增,通常更关注精确且保守的定义。若研究重点是谱系演化或亲缘关系,则会结合体细胞高频突变信息,使用更细化的层级划分。
结论很简单,参数没有绝对最优,只有是否与研究问题一致。
3.2 测序深度需要做归一化
不同样本的测序深度不一致,会直接影响克隆数、稀有克隆检出率和多样性指数。深度高的样本天然更容易发现更多克隆型。若不做归一化,比较就不公平。
常见处理方式有两类。
- 统一下采样到相同深度。
- 用相对丰度代替绝对计数。
前者更适合比较克隆多样性,后者更适合看克隆组成比例。如果目标是比较两个组的整体克隆结构,必须明确归一化方式,否则统计结论不稳。
3.3 多样性指标要选对
BCR克隆型分析常见的输出不只是“有哪些克隆型”,还包括多样性指数。不同指标回答的问题不同。
- Shannon指数,更强调丰富度和均匀度。
- Simpson指数,更强调优势克隆的集中程度。
- clonality,更适合描述扩增偏倚。
- rarefaction分析,更适合评估测序深度是否足够。
不要只看一个多样性值就下结论。 例如两个样本的Shannon指数相近,但一个样本可能存在少数超高频优势克隆,这在Simpson指数和clonality里会表现得很明显。
4. 结果解释时,哪些地方最容易出错
4.1 “克隆扩增”不等于“疾病特异”
看到某些克隆型频率升高,不应直接解释为疾病驱动。它可能来自感染史、疫苗接种、采样时间点差异,甚至仅仅是抽样偏倚。克隆扩增是现象,不是结论。
想提高解释力,建议同时查看。
- 配对样本变化趋势。
- 共享克隆型的持续性。
- V/J基因偏好。
- CDR3长度分布。
- 体细胞高频突变水平。
如果有临床信息,还应结合治疗方案、炎症状态和采样时间点进行解释。
4.2 交叉污染和批次效应必须排查
BCR分析对批次效应非常敏感。尤其在共享克隆比例异常高、多个样本出现高度相似主导克隆时,要警惕污染或条码混淆。
建议检查以下内容。
- 文库构建批次是否一致。
- 是否存在index hopping。
- 是否有阴性对照异常阳性。
- 同批样本是否出现相似的异常富集模式。
在发表前,至少要做一次批次效应和污染排查。 这一步能避免很多后期返工。
5. 一个更稳妥的分析模板
5.1 推荐的通用工作流
对医学生、医生和科研人员来说,BCR克隆型分析可以按以下顺序执行。
- 原始数据质控。
- 去接头、去低质读段。
- V/D/J注释与CDR3提取。
- 去冗余与错误纠正。
- 定义克隆型规则。
- 深度归一化。
- 计算多样性和克隆扩增指标。
- 做组间比较和可视化。
- 回到临床和实验背景解释结果。
这个流程的价值在于,它把“能跑出图”变成“能解释结论”。
5.2 写方法学时,必须交代清楚的参数
论文或标书里,建议至少写明以下信息。
- 测序平台和建库方法。
- 原始读段过滤标准。
- V/D/J比对软件和版本。
- CDR3定义规则。
- 克隆型聚类阈值。
- 是否使用UMI。
- 深度归一化策略。
- 多样性指标计算方式。
- 离群样本处理原则。
这些参数写不清,结果就很难复现。 对科研工作来说,可复现性本身就是可信度的一部分。
总结Conclusion
BCR克隆型分析的关键,不在于把图做出来,而在于把流程做标准。先质控,再定义克隆型,再去冗余、归一化和解释,才能减少技术偏差,提升结果可信度。如果你希望把复杂的免疫组库分析流程做得更规范,可以借助解螺旋的工具和流程化支持,快速完成前处理、参数梳理和结果整理。 这样既能提高效率,也更容易产出可复现、可发表的分析结论。
- 引言Introduction
- 1. 为什么BCR克隆型分析必须先做标准化
- 2. BCR克隆型分析的标准化流程
- 3. 关键参数怎么选,才不会影响结论
- 4. 结果解释时,哪些地方最容易出错
- 5. 一个更稳妥的分析模板
- 总结Conclusion