47
 分享
引言Introduction
BCR repertoire测序正在把B细胞免疫研究从“看总量”推进到“看克隆、看谱系、看亲和成熟”。但数据量大、噪声多、偏倚复杂,很多研究者拿到原始测序结果后,仍然难以快速判断该怎么分析、怎么解释、怎么写成文章。
1. BCR repertoire测序的核心价值
1.1 从序列到免疫信息
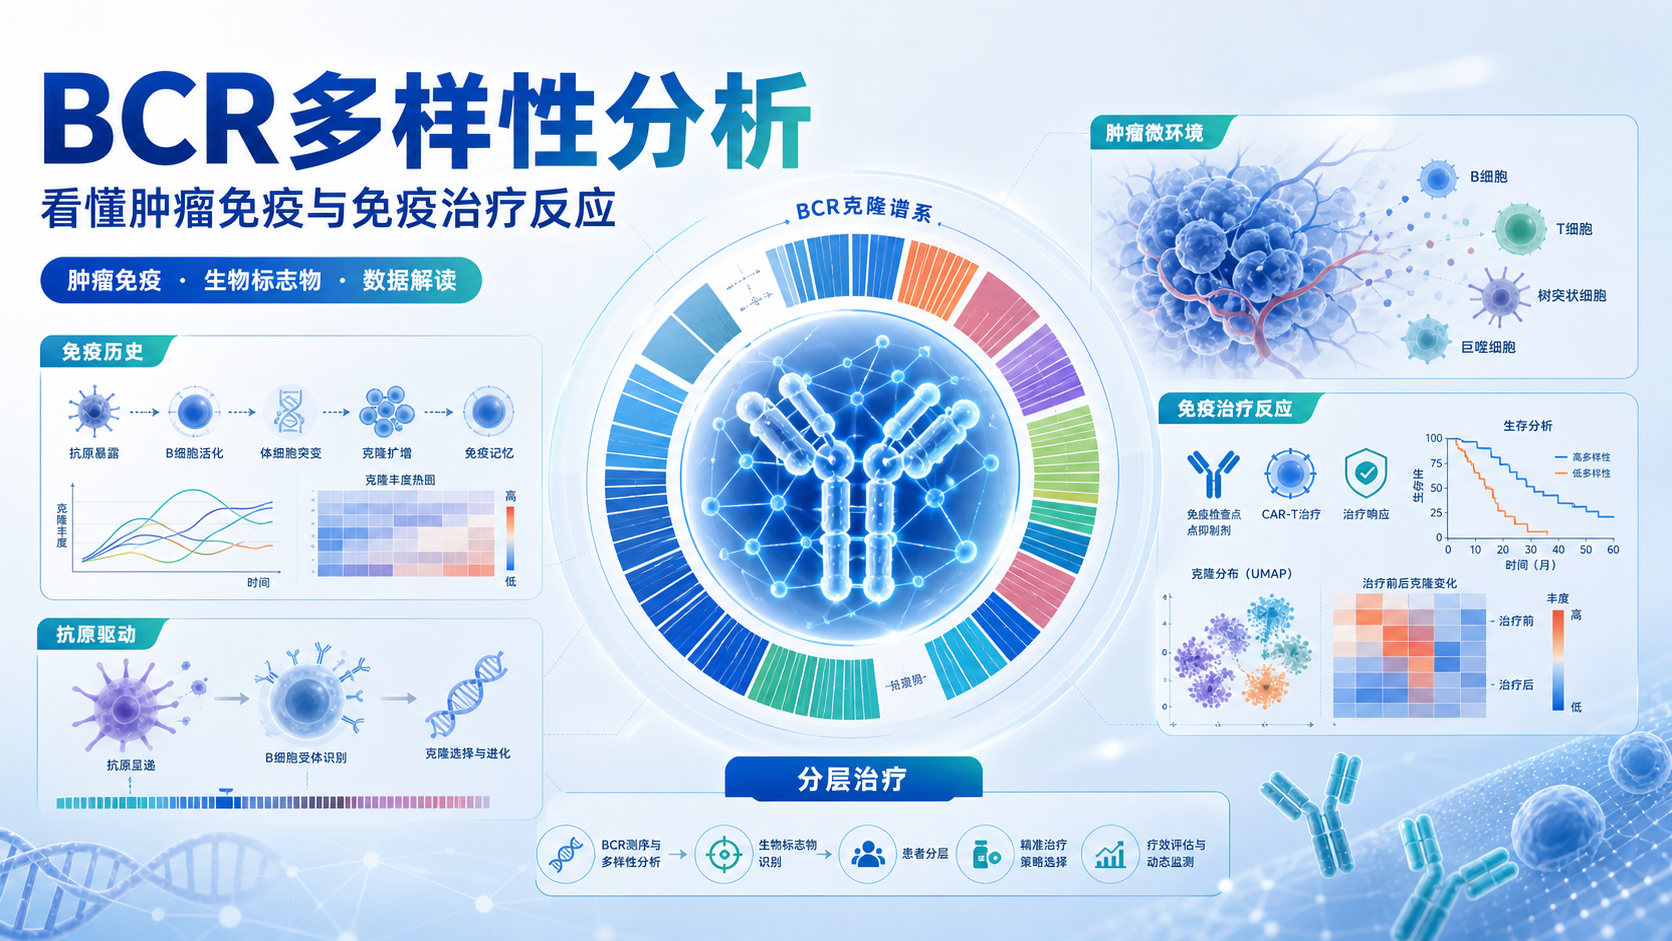
BCR repertoire测序关注的是B细胞受体的多样性变化。它不仅记录“有哪些序列”,还可以进一步解析克隆扩增、V(D)J基因使用偏好、CDR3特征、体细胞高频突变,以及类别转换后的免疫应答状态。
对医学生和科研人员来说,BCR repertoire测序的价值在于,它能把免疫现象转化为可量化的数据。 例如,感染、肿瘤、自身免疫病、疫苗应答,都可能在克隆扩增和突变模式上留下痕迹。
1.2 适合回答哪些科学问题
常见研究问题包括:
- 某一疾病是否存在特异性克隆扩增。
- 治疗前后,B细胞谱系是否发生重塑。
- 不同组织来源的BCR库是否存在共享克隆。
- 某些V基因家族是否呈现偏倚。
- CDR3长度、疏水性、突变负荷是否与结局相关。
如果研究目标是机制或生物标志物,BCR repertoire数据往往比单纯的细胞计数更有信息量。 它能直接反映抗原驱动的选择压力。
1.3 和常规转录组的区别
BCR repertoire测序不是普通表达谱分析。它的分析对象是重排后的免疫球蛋白序列,而不是基因表达矩阵。
因此,分析重点也不同:
- 是否能正确识别V、D、J片段。
- 是否能定义克隆型。
- 是否能评估多样性和克隆扩增。
- 是否能追踪谱系演化。
这类数据最怕把“序列分析”当成“表达分析”来处理。 方法选错,后面所有结论都会受影响。
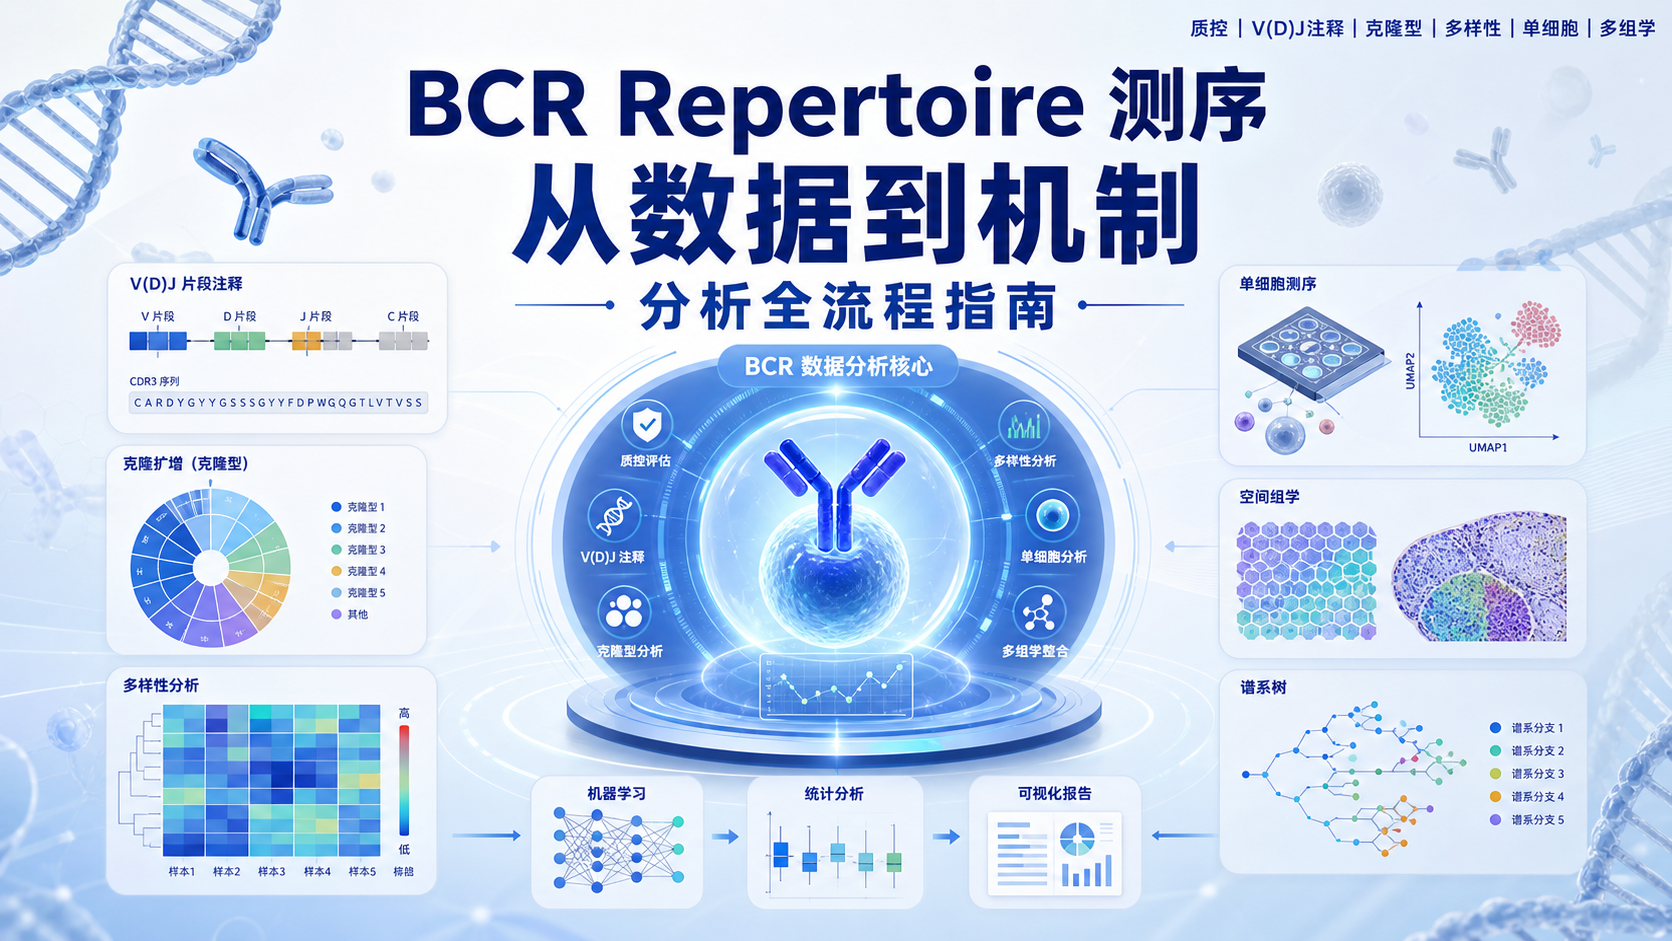
2. BCR repertoire测序的数据分析主线
2.1 质控是第一道门槛
原始数据分析的第一步不是出图,而是质控。BCR数据常见问题包括:
- 测序错误导致假阳性克隆。
- PCR扩增偏倚放大少数序列。
- 低质量碱基影响VDJ比对。
- 引物设计不佳造成片段缺失。
一般建议先检查Q30、接头污染、重复率和有效读段比例。 若采用UMI策略,还要确认UMI去重是否合理。对于高复杂度样本,去重过度会丢失真实克隆;去重不足则会夸大克隆频率。
2.2 V(D)J注释决定后续分析质量
BCR repertoire分析的核心环节是V(D)J比对和注释。常用思路是将测序读段与免疫球蛋白参考数据库进行匹配,识别:
- V基因
- D基因
- J基因
- CDR3区
- 同种型信息
注释是否准确,直接决定克隆定义是否可靠。 如果参考库版本落后,或者物种注释不完整,容易出现片段误分配,尤其是在相似V基因家族之间。
2.3 克隆型定义要统一
克隆型定义没有绝对统一标准,但分析前必须明确规则。常见做法是按以下信息组合定义克隆:
- 相同V和J基因。
- CDR3氨基酸序列相同或高度相似。
- 必要时再结合D基因和长度阈值。
克隆定义越严格,特异性越高,但会漏掉部分近缘克隆。 定义越宽松,灵敏度更高,但可能把不同克隆合并。
因此,论文中必须写清楚标准,不能只给出结果,不交代规则。
3. 关键分析指标与常用算法
3.1 多样性分析要看多个维度
BCR repertoire的多样性不能只看一个数。常用指标包括:
- Shannon index,反映丰富度和均匀度。
- Simpson index,强调优势克隆。
- Chao1,侧重稀有克隆估计。
- Pielou’s evenness,衡量均匀性。
如果样本之间测序深度不同,必须先做标准化或稀释处理。 否则,多样性差异可能只是测序深度差异,而不是生物学差异。
3.2 克隆扩增分析更接近疾病机制
克隆扩增是BCR研究中最常见也最有解释力的指标之一。通常可以从以下角度分析:
- Top clone占比。
- 克隆频率分布。
- 头部克隆集中度。
- 疾病组与对照组的扩增差异。
当少数克隆在样本中占据很高比例时,往往提示存在抗原驱动的选择。 但这一结论必须结合临床背景和实验验证,不能仅凭数据直接下结论。
3.3 突变与谱系分析适合回答“如何演化”
体细胞高频突变分析可以帮助判断B细胞是否经历亲和成熟。常见分析包括:
- 突变率分布。
- replacement/silent mutation比例。
- 谱系树构建。
- 祖先序列推断。
谱系分析尤其适合疫苗、感染和肿瘤免疫研究。 它能说明克隆不是静态存在,而是在选择压力下持续演化。
3.4 公共数据库和统计比较要谨慎
很多研究会整合公共BCR数据。但需要注意:
- 样本来源是否一致。
- 是否来自相同组织。
- 建库策略是否相同。
- 测序平台和读长是否一致。
- 是否使用相同的注释流程。
不同队列之间的BCR数据不能简单直接合并。 即使都是人类样本,若来源组织、测序深度和文库构建方法不同,也会引入明显批次效应。
4. 近年来的前沿方法与发展方向
4.1 单细胞BCR测序推动配对分析
单细胞技术让BCR分析进入“重链与轻链配对”阶段。相比传统bulk测序,单细胞数据能同时保留:
- 重链信息。
- 轻链信息。
- 细胞转录状态。
- 细胞亚群来源。
这让研究者能够把受体序列和功能表型真正联系起来。 例如,同一克隆在记忆B细胞、浆细胞中的分布差异,已经成为重要研究方向。
4.2 空间与多组学整合越来越重要
BCR repertoire不再只是独立分析。现在更常见的是与以下数据联合:
- scRNA-seq
- 空间转录组
- 免疫表型流式数据
- 临床结局数据
真正有价值的趋势,是把“序列变化”放回组织微环境中解释。 例如,在肿瘤局部是否存在特定B细胞亚群富集,是否与免疫治疗反应相关,这类问题更接近临床转化。
4.3 机器学习开始用于克隆识别与分类
随着样本量增加,机器学习和深度学习被用于:
- 克隆聚类。
- 抗原特异性预测。
- 结局分类。
- 疾病亚型识别。
但要注意,BCR数据维度高、样本异质性强,模型很容易过拟合。
如果没有独立验证集,模型结果的说服力通常有限。训练集和测试集必须分开,最好再做外部验证。
5. 研究设计中的常见坑
5.1 不要忽略文库和批次差异
BCR repertoire分析很容易受技术因素干扰。常见坑包括:
- 不同引物体系导致覆盖区域不同。
- PCR循环数不同带来扩增偏倚。
- 读长不足导致CDR3截断。
- 不同测序平台带来错误谱差异。
如果这些信息在方法学里没有交代清楚,结果就很难被审稿人信服。
5.2 样本量小,结论要克制
BCR研究中,单个样本往往就有大量序列,但这不等于生物学重复足够。
真正重要的是患者数和分组一致性,不是序列条数。
序列数很多,不代表统计学上就有高证据强度。
如果只有少量患者,结论应聚焦于趋势和假设生成,而不是过度外推。
5.3 生信流程要可复现
一个规范的BCR repertoire分析,至少应保留:
- 原始数据版本。
- 参考数据库版本。
- 质控参数。
- 克隆定义规则。
- 统计检验方法。
没有可复现流程,就很难支撑论文投稿和后续复核。 这也是很多团队在项目推进中最容易卡住的环节。
6. 面向实战的分析建议
6.1 一个推荐的分析顺序
可以按下面顺序推进:
- 原始数据质控。
- 去接头、去低质量读段。
- UMI去重或错误校正。
- V(D)J比对注释。
- 克隆型定义。
- 多样性与克隆扩增分析。
- 突变和谱系分析。
- 与临床或转录组联合解释。
这个顺序的好处是,先保证基础可靠,再做高阶生物学解释。
6.2 图表优先级怎么排
在论文或汇报中,建议优先展示:
- 克隆频率分布图。
- V/J基因使用偏好图。
- CDR3长度分布图。
- 多样性比较图。
- 共有克隆分析图。
- 谱系树或网络图。
这些图最能体现BCR repertoire的核心信息,也最容易让读者快速抓住结论。
6.3 让分析更快落地
对大多数团队来说,BCR repertoire测序真正的难点不是“有没有数据”,而是“能不能把数据变成可发表的结果”。这一步涉及流程、参数、统计和可视化,任何一个环节出错,都会拖慢项目进度。
如果你希望把BCR repertoire测序从原始数据快速推进到可解释的结果,解螺旋 可以提供更贴近科研场景的数据分析支持,帮助你减少试错时间,把精力集中到课题设计和结果验证上。
总结Conclusion
BCR repertoire测序已经不只是免疫组库的“看序列”工具,而是连接抗原驱动、克隆扩增、亲和成熟和临床表型的重要分析框架。要做好这类研究,关键在于质控、V(D)J注释、克隆定义、多样性评估和批次控制。只有流程清晰、参数明确、统计规范,结果才有发表和转化的价值。 如果你正在推进相关课题,或希望更高效地完成数据解析,可以考虑借助** 解螺旋**的专业支持,让分析更稳、更快、更接近科研目标。
- 引言Introduction
- 1. BCR repertoire测序的核心价值
- 2. BCR repertoire测序的数据分析主线
- 3. 关键分析指标与常用算法
- 4. 近年来的前沿方法与发展方向
- 5. 研究设计中的常见坑
- 6. 面向实战的分析建议
- 总结Conclusion